Learning from labelled examplesApprendre à partir d'exemples étiquetés
TRA2600 S5 · in classS5 · en classe
TRA6008 S1 · in classS1 · en classe
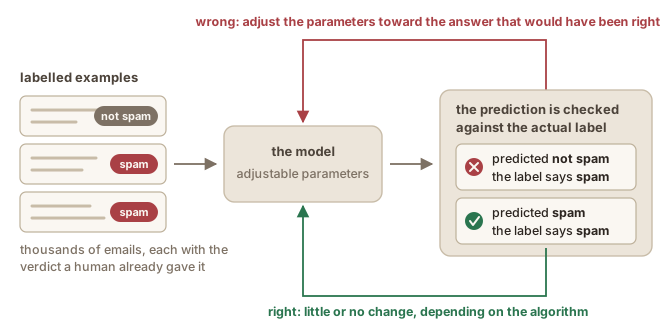
Suppose you want a system that sorts email into spam and not spam. The rule-based way is to describe spam: certain senders, certain words, too many links. The supervised way is to show the system ten thousand emails that a human already sorted, and let it work out the difference. Each email with its human verdict attached is a labelled example, and a collection of many labelled examples becomes training data.
Training then runs as a loop. The algorithm takes an example, predicts a label, and compares its prediction with the human label. A wrong prediction adjusts the model’s settings, a little, in the direction that would have made it right. A correct one changes little or nothing: some algorithms leave the settings exactly as they are, others nudge them toward answering the same way more confidently.The settings are the model’s parameters parameterparamètre de modèle machine learningapprentissage automatique A numerical value learned during a model's training and used in its computations.Valeur numérique apprise pendant l'entraînement d'un modèle et utilisée dans ses calculs. . How they are stored and adjusted is not covered in this module; the loop is the point here, not the arithmetic inside it (see also the From neural networks to large language models chapter) (voir aussi le chapitre Des réseaux de neurones aux grands modèles de langue). One pass through one email teaches almost nothing. Millions of passes through thousands of examples add up, and the predictions improve until they are good enough to use on email nobody has labelled.
Two consequences follow directly from this setup, and they will come back again and again in this collection:
- Everything is learned from the data, not from rules. The system reproduces the judgements in its training data, mistakes and blind spots included, and the data is the only way in: there is no rule to rewrite when it gets something wrong.
- The training data has to resemble the real job. A spam filter trained on English corporate email will stumble on French phishing. What the examples do not show, the model cannot learn.
Before anything can be learned, somebody has to decide what the algorithm looks at when it compares two emails.
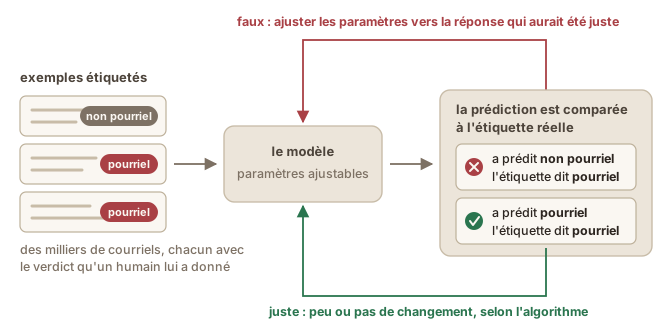
Supposons que vous vouliez un système qui trie les courriels entre pourriel et non pourriel. La façon à base de règles consiste à décrire le pourriel : certains expéditeurs, certains mots, trop de liens. La façon supervisée consiste à montrer au système dix mille courriels qu’un humain a déjà triés, et à le laisser dégager la différence. Chaque courriel accompagné du verdict humain est un exemple étiqueté, et un ensemble de nombreux exemples étiquetés devient des données d’entraînement.
L’entraînement se déroule alors en boucle. L’algorithme prend un exemple, prédit une étiquette et compare sa prédiction à celle de l’humain. Une prédiction fausse ajuste les réglages du modèle, un peu, dans la direction qui l’aurait rendue juste. Une prédiction juste ne change rien ou presque : certains algorithmes laissent les réglages exactement tels quels, d’autres les poussent à répondre pareil avec plus d’assurance.Ces réglages sont les paramètres parameterparamètre de modèle machine learningapprentissage automatique A numerical value learned during a model's training and used in its computations.Valeur numérique apprise pendant l'entraînement d'un modèle et utilisée dans ses calculs. du modèle. La façon dont ils sont stockés et ajustés n’est pas traitée dans ce module ; ce qui compte ici, c’est la boucle, pas l’arithmétique qui s’y trouve (see also the From neural networks to large language models chapter) (voir aussi le chapitre Des réseaux de neurones aux grands modèles de langue). Un passage sur un courriel n’apprend presque rien. Des millions de passages sur des milliers d’exemples s’accumulent, et les prédictions s’améliorent jusqu’à devenir assez bonnes pour des courriels que personne n’a étiquetés.
Deux conséquences découlent directement de ce fonctionnement, et elles reviendront sans cesse dans ce matériel :
- Tout s’apprend des données, pas de règles. Le système reproduit les jugements de ses données d’entraînement, erreurs et angles morts compris, et les données sont la seule porte d’entrée : il n’y a aucune règle à réécrire quand il se trompe.
- Les données d’entraînement doivent ressembler au travail réel. Un filtre antipourriel entraîné sur des courriels d’entreprise en anglais trébuchera sur de l’hameçonnage en français. Ce que les exemples ne montrent pas, le modèle ne peut pas l’apprendre.
Avant que quoi que ce soit puisse s’apprendre, quelqu’un doit décider ce que l’algorithme regarde quand il compare deux courriels.
Sources
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- Raschka, S. (2024). Machine Learning Q and AI. No Starch Press. https://nostarch.com/machine-learning-q-and-ai