The systems behind much of today’s language technology, including almost all
machine translation systems and chatbots with which you will interact, are
neural networks. The name suggests something brain-like, and the inspiration
is real, but loose: there are some similarities between artificial neural
networks and natural neural networks like our brain, but this does not go
beyond the very basics.
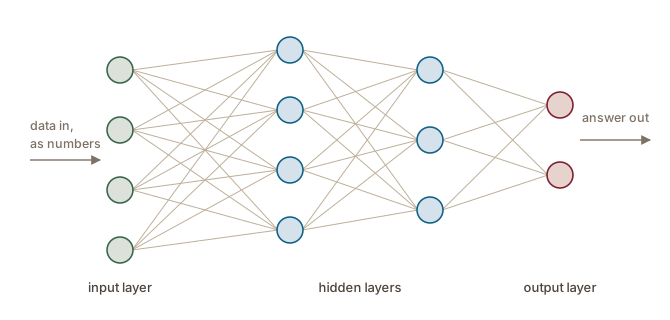
Figure 1. The standard picture of a neural network. Each circle is a unit, each line a weighted connection. Data enters on the left as numbers and comes out on the right as an answer.
The units are organized in layers. An input layer takes in the raw data as
numbers; one or more hidden layers transform it, step by step; an output
layer produces the answer, for example one value per possible category. When
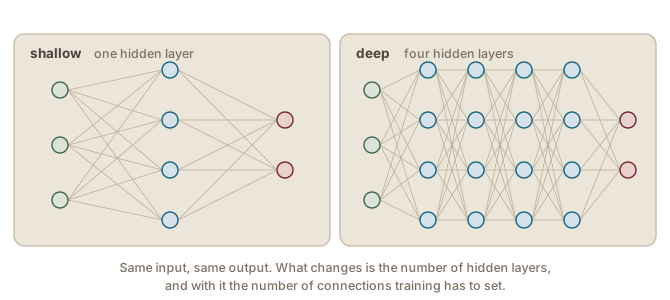
there are many hidden layers, the network is called deep, which is all that
the “deep” in deep learning means (LeCun et al., 2015).
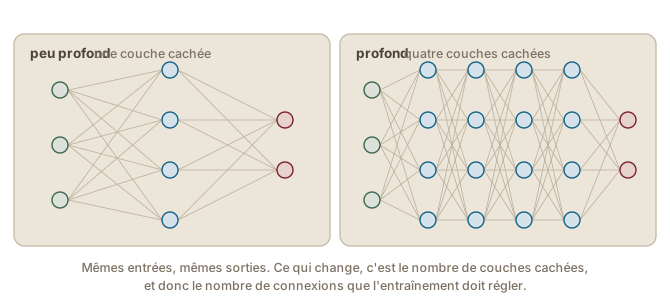
Figure 2. The same input and the same output, once with one hidden layer and once with four. Only the number of hidden layers changes.
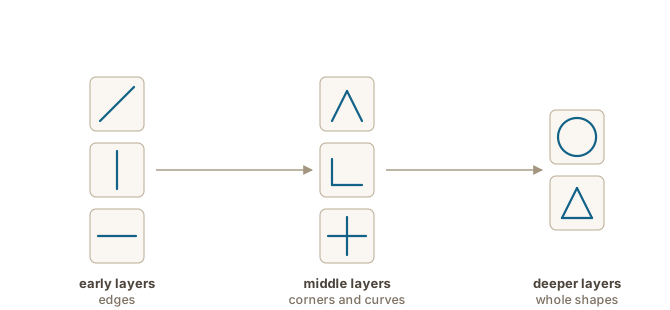
Depth is what lets a network build complex patterns out of simple ones. Early
layers pick up simple regularities in the raw input; later layers combine
those into larger ones. In image recognition, the classic illustration, first
edges, then shapes, then faces. For text the same principle applies, with one
catch: a network’s input layer takes numbers, so using one for language
requires a way to encode language as
numbers (see also the Language as numbers module) (voir aussi le module Le langage en nombres).
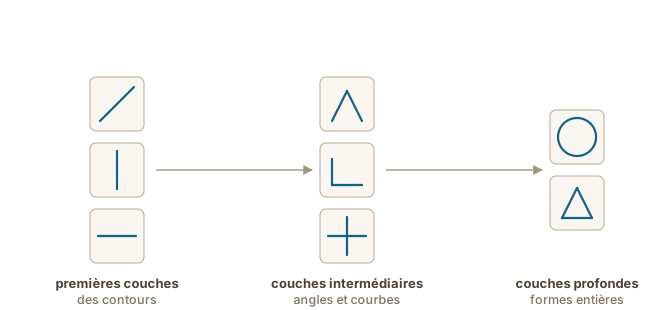
Figure 3. A schematic, not real network output: simple motifs in the early layers, combinations of them in the middle, closed shapes deeper in.
Written in English. The French version was automatically generated
and I have not revised it.
Rédigé en anglais. La version française a été
générée automatiquement et je ne l'ai pas révisée.
Updated 5 October 2026
Les systèmes derrière une bonne partie des technologies langagières
d’aujourd’hui, dont la quasi-totalité des systèmes de traduction automatique et
des agents conversationnels avec lesquels vous interagirez, sont des réseaux de
neurones. Le nom évoque quelque chose de cérébral, et l’inspiration est réelle,
mais lâche : il existe certaines ressemblances entre les réseaux de neurones
artificiels et les réseaux de neurones naturels comme notre cerveau, mais cela
ne va pas au-delà des bases.
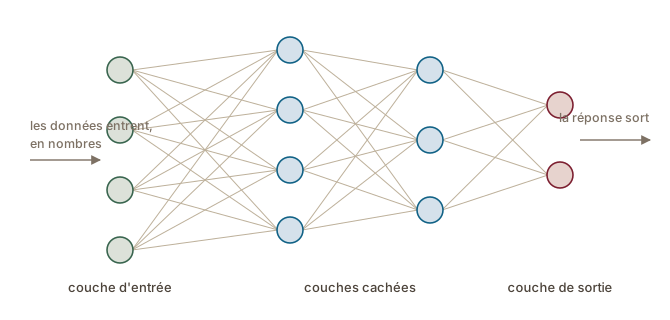
Figure 1. L'image habituelle d'un réseau de neurones. Chaque cercle est une unité, chaque trait une connexion pondérée. Les données entrent à gauche sous forme de nombres et la réponse sort à droite.
Les unités sont organisées en couches. Une couche d’entrée reçoit les données
brutes sous forme de nombres ; une ou plusieurs couches cachées les
transforment, étape par étape ; une couche de sortie produit la réponse, par
exemple une valeur par catégorie possible. Quand il y a beaucoup de couches
cachées, on dit que le réseau est profond, et c’est tout ce que veut dire le
« profond » d’apprentissage profond (LeCun et al., 2015).
Figure 2. Les mêmes entrées et les mêmes sorties, une fois avec une couche cachée et une fois avec quatre. Seul le nombre de couches cachées change.
C’est la profondeur qui permet à un réseau de construire des motifs complexes à
partir de motifs simples. Les premières couches relèvent des régularités
simples dans l’entrée brute ; les couches suivantes les combinent en motifs
plus grands. En reconnaissance d’images, l’illustration classique, d’abord des
contours, puis des formes, puis des visages. Pour le texte, le même principe
s’applique, avec une réserve : la couche d’entrée d’un réseau reçoit des
nombres, donc utiliser un réseau pour la langue demande une façon d’encoder la
langue en nombres (see also the Language as numbers module) (voir aussi le module Le langage en nombres).
Figure 3. Un schéma, et non la sortie réelle d'un réseau : des motifs simples dans les premières couches, leurs combinaisons au milieu, des formes fermées plus loin.
Written in English. The French version was automatically generated
and I have not revised it.
Rédigé en anglais. La version française a été
générée automatiquement et je ne l'ai pas révisée.
Mise à jour 5 octobre 2026