InferenceInférence
TRA6008 To read for S3À lire pour la S3
Inference vs. pretraining and fine-tuning
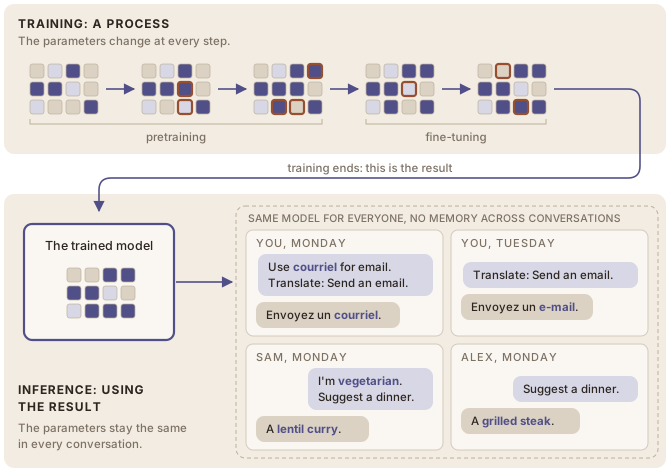
When you interact with a chatbot like Claude or ChatGPT, and you tell it to use courriel as the French equivalent of email instead of e-mail, the model will likely correctly use courriel for the remainder of that conversation, unless the conversation becomes very long (see also the context window page) (voir aussi la page La fenêtre contextuelle). However, when you open a new conversation, the model may use e-mail again, as if it had never seen your earlier instruction, unless it saved that instruction to its memory persistent memorymémoire persistante promptingrequêtes An AI assistant's ability to retain information from earlier interactions and retrieve relevant information in later conversations, allowing it to maintain continuity and personalize its responses across sessions.Capacité d'un assistant d'IA à retenir de l'information d'interactions antérieures et à en récupérer les éléments pertinents dans des conversations ultérieures, ce qui lui permet d'assurer une continuité et de personnaliser ses réponses d'une session à l'autre. (see also the Custom instructions, memory, projects and skills page, in the Using LLMs module) (voir aussi la page Instructions personnalisées, mémoire, projets et compétences, dans le module Utiliser les GML). LLMs large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. may learn a lot during pretraining and fine-tuning, but once they are done training and are deployed for use, they are no longer able to learn anything new. They can generally “remember” what was said within a conversation, but not across conversations.
During pretraining and fine-tuning, each round of training adjusts the model’s parameters a little. Once training is finished, those parameters are fixed and copied onto the computers that answer users’ requests. From then on, every request is processed with the same parameters, and processing it leaves them exactly as they were.
Where differences in answers come from
The model is the same for everyone, and using it does not change it. The answers people get can still differ, from one person to the next and from one day to the next, for four separate reasons.
- Chance. The model does not always give the same answer to the same input. It chooses each token with an element of chance, so asking the same question twice can give two different answers (see also the LLMs are non-deterministic page) (voir aussi la page Les GML ne sont pas déterministes).
- Your prompt. The answer depends on your exact prompt promptrequête promptingrequêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. . A different wording, a different order or one more sentence of context can lead to a different answer (see also the Prompting chapter, in the Using LLMs module) (voir aussi le chapitre Formulation de requêtes, dans le module Utiliser les GML).
- The system around the model. The model is used inside a larger system, and that system adds to what the model receives. Before your question reaches it, the service can add hidden instructions from the provider (a system prompt system promptrequête générative système promptingrequêtes An instruction supplied to a language model before or alongside the user's input that establishes the model's role, task, behavioural rules, tone, or other context for the interaction.Instruction fournie à un modèle de langue avant l'entrée de l'utilisateur, ou en parallèle, qui établit le rôle du modèle, sa tâche, ses règles de conduite, son ton ou d'autres éléments de contexte pour l'interaction. ), your saved instructions and memory, and the content of files or web searches; filters can also check what goes in and what comes out. This surrounding software, called the harness harnessappareillage agentsagents The software around a language model that turns it into a working system. It determines what the model receives and which tools it may use, carries out the actions the model requests, and passes the results back to it.Logiciel qui entoure un modèle de langue et en fait un système opérationnel. Il détermine ce que le modèle reçoit et quels outils il peut utiliser, exécute les actions que le modèle demande et lui transmet les résultats. , differs from one product to the next, so the same model can answer differently in two different products.
- The model itself. The model you reach is not always the same model. Providers release new models, sometimes as a new generation, as when OpenAI released GPT-6 Astra in September 2026, and sometimes as an update to a model that keeps its name, as with the April 2025 update to GPT-4o in ChatGPT (OpenAI, 2025). A provider also offers several models at the same time, at different speeds and prices, such as Claude Haiku, Sonnet, Opus and Fable at Anthropic, or GPT-5.6 Luna, Terra and Sol and GPT-6 Astra at OpenAI, and some services choose one of them for you, question by question (see also the Families, generations and tiers page, in the Using LLMs module) (voir aussi la page Familles, générations et niveaux, dans le module Utiliser les GML).
L’inférence par rapport au préentraînement et à l’affinage
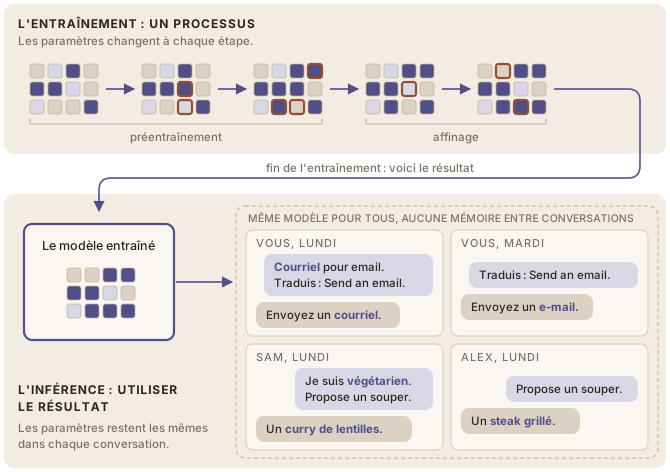
Quand vous échangez avec un agent conversationnel comme Claude ou ChatGPT et que vous lui demandez d’employer courriel plutôt que e-mail comme équivalent français d’email, le modèle utilisera probablement courriel correctement pendant le reste de la conversation, à moins que celle-ci ne devienne très longue (see also the context window page) (voir aussi la page La fenêtre contextuelle). Si vous ouvrez une nouvelle conversation, en revanche, le modèle risque d’employer de nouveau e-mail, comme s’il n’avait jamais vu votre consigne, à moins de l’avoir enregistrée dans sa mémoire persistent memorymémoire persistante promptingrequêtes An AI assistant's ability to retain information from earlier interactions and retrieve relevant information in later conversations, allowing it to maintain continuity and personalize its responses across sessions.Capacité d'un assistant d'IA à retenir de l'information d'interactions antérieures et à en récupérer les éléments pertinents dans des conversations ultérieures, ce qui lui permet d'assurer une continuité et de personnaliser ses réponses d'une session à l'autre. (see also the Custom instructions, memory, projects and skills page, in the Using LLMs module) (voir aussi la page Instructions personnalisées, mémoire, projets et compétences, dans le module Utiliser les GML). Les grands modèles de langue large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. (GML) peuvent apprendre beaucoup pendant le préentraînement et l’affinage, mais une fois leur entraînement terminé et leur mise en service faite, ils ne peuvent plus rien apprendre de nouveau. Ils peuvent généralement « se souvenir » de ce qui a été dit au cours d’une conversation, mais pas d’une conversation à l’autre.
Pendant le préentraînement et l’affinage, chaque cycle d’entraînement ajuste un peu les paramètres du modèle. Une fois l’entraînement terminé, ces paramètres sont figés et copiés sur les ordinateurs qui répondent aux requêtes. À partir de là, chaque requête est traitée avec les mêmes paramètres, et ce traitement les laisse exactement tels qu’ils étaient.
D’où viennent les différences entre les réponses
Le modèle est le même pour tout le monde, et l’utiliser ne le modifie pas. Les réponses obtenues peuvent pourtant varier d’une personne à l’autre et d’un jour à l’autre, pour quatre raisons distinctes.
- Le hasard. Le modèle ne donne pas toujours la même réponse à la même entrée. Il choisit chaque jeton avec une part de hasard, si bien que poser deux fois la même question peut donner deux réponses différentes (see also the LLMs are non-deterministic page) (voir aussi la page Les GML ne sont pas déterministes).
- Votre requête. La réponse dépend de la formulation exacte de votre requête promptrequête promptingrequêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. . Une autre formulation, un autre ordre ou une phrase de contexte de plus peuvent mener à une autre réponse (see also the Prompting chapter, in the Using LLMs module) (voir aussi le chapitre Formulation de requêtes, dans le module Utiliser les GML).
- Le système autour du modèle. Le modèle est utilisé à l’intérieur d’un système plus large, qui ajoute des éléments à ce que le modèle reçoit. Avant que votre question ne lui parvienne, le service peut y ajouter des instructions cachées du fournisseur (une requête générative système system promptrequête générative système promptingrequêtes An instruction supplied to a language model before or alongside the user's input that establishes the model's role, task, behavioural rules, tone, or other context for the interaction.Instruction fournie à un modèle de langue avant l'entrée de l'utilisateur, ou en parallèle, qui établit le rôle du modèle, sa tâche, ses règles de conduite, son ton ou d'autres éléments de contexte pour l'interaction. ), vos instructions enregistrées et votre mémoire, ainsi que le contenu de fichiers ou de recherches sur le Web ; des filtres peuvent aussi vérifier ce qui entre et ce qui sort. Ce logiciel qui entoure le modèle, appelé appareillage harnessappareillage agentsagents The software around a language model that turns it into a working system. It determines what the model receives and which tools it may use, carries out the actions the model requests, and passes the results back to it.Logiciel qui entoure un modèle de langue et en fait un système opérationnel. Il détermine ce que le modèle reçoit et quels outils il peut utiliser, exécute les actions que le modèle demande et lui transmet les résultats. (angl. harness), varie d’un produit à l’autre, si bien que le même modèle peut répondre différemment dans deux produits.
- Le modèle lui-même. Le modèle que vous utilisez n’est pas toujours le même. Les fournisseurs publient de nouveaux modèles, parfois sous la forme d’une nouvelle génération, comme GPT-6 Astra, lancé par OpenAI en septembre 2026, et parfois sous la forme d’une mise à jour d’un modèle qui garde son nom, comme la mise à jour de GPT-4o dans ChatGPT en avril 2025 (OpenAI, 2025). Un fournisseur propose aussi plusieurs modèles en même temps, à des vitesses et à des prix différents, comme Claude Haiku, Sonnet, Opus et Fable chez Anthropic, ou GPT-5.6 Luna, Terra et Sol et GPT-6 Astra chez OpenAI, et certains services choisissent l’un d’eux pour vous, question par question (see also the Families, generations and tiers page, in the Using LLMs module) (voir aussi la page Familles, générations et niveaux, dans le module Utiliser les GML).
Sources
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- OpenAI (2025). Expanding on what we missed with sycophancy. OpenAI (blog), 2 May 2025. https://openai.com/index/expanding-on-sycophancy/
Sources
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- OpenAI (2025). Expanding on what we missed with sycophancy. OpenAI (blog), 2 mai 2025. https://openai.com/index/expanding-on-sycophancy/