Counting words: types and tokensCompter les mots : types et occurrences
TRA2600 S5 · in classS5 · en classe
Two ways to count the words
The sentence Le chat voit le chien, et le chien voit le chat. has eleven words if you count every word as you read it, and five if you count each distinct word once: le four times, chat, chien and voit twice each, et once. Counting the comma and the full stop as well gives thirteen and seven. The occurrences are called tokens, the distinct forms are called types, as shown in Figure 1figure 1.
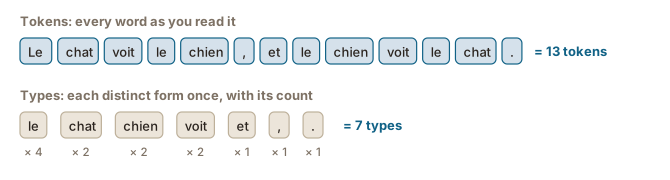
The two counts answer different questions, and so does the ratio between them, the number of types divided by the number of tokens, called the type-token ratio. The table below gives examples of each in use.
| Count | What it tells you | Examples of use |
|---|---|---|
| Tokens | How long a text is | The word count a translation or an article is quoted on; the size of a corpus; frequencies per million tokens, which make corpora of different sizes comparable (see also the Absolute and relative frequencies page, in the Corpus analysis module) (voir aussi la page Fréquences absolues et relatives, dans le module L'analyse de corpus) |
| Types | How many different words a text uses | A frequency list, the first thing a concordancer shows about a corpus, with one row per type and its number of tokens; the list of words a program works from, which has to cover the types it will be given (see also the Why not simply use words or characters? page, in the Language as numbers module) (voir aussi la page Pourquoi ne pas simplement prendre les mots ou les caractères ?, dans le module Le langage en nombres) |
| Type-token ratio | How much a text repeats itself | Comparing how varied the vocabulary of two texts is, for instance a machine translation machine translation (MT)traduction automatique (TA) translationtraduction The use of a computer system to produce content in a target language that conveys content expressed in a source language.Utilisation d'un système informatique pour produire, dans une langue cible, un contenu qui rend un contenu exprimé dans une langue source. and a human translation of the same source |
Vanmassenhove et al. (2019, 2021) found machine translations less varied than human translations of the same texts: frequent words became more frequent and rare words rarer.Both studies used statistical and neural systems the authors trained on European Parliament proceedings, English with French and Spanish, in 2019 and 2021. Less varied is not necessarily worse: in a technical text, naming the same thing the same way throughout is what you want (Vanmassenhove et al., 2021). Chatbot output can go the other way: essays written by ChatGPT were more varied than essays by human writers (Kendro et al., 2026).Thirty essays each from ChatGPT-3.5, ChatGPT-4, o4-mini and GPT-4.5 on one argumentative prompt of the TOEFL, against 240 writers of English as a first or second language, from high school to doctoral level.
The ratio depends on length
A short text has a high type-token ratio, a whole book a much lower one, and a large corpus lower still, as the table below shows.The Gettysburg Address was counted here on the Bliss copy, by word form as the corpora were, so cat and cats would be two types; capitals were ignored and punctuation left out. Jurafsky and Martin do not say how capitals and punctuation were treated in each corpus. Keeping capitals would give the address 142 types instead of 138.
| Text | Types | Tokens | Types per 1,000 tokens |
|---|---|---|---|
| The Gettysburg Address (Lincoln, 1863) | 138 | 271 | 509 |
| Shakespeare’s works | 29 thousand | 884 thousand | 33 |
| Brown corpus | 38 thousand | 1 million | 38 |
| Corpus of Contemporary American English (COCA) | 2 million | 440 million | 4.5 |
This happens with any text. The more of it you count, the more types you find, but ever more slowly, since the common words keep recurring and new words become rarer; the relation is known as Herdan’s law or Heaps’ law (Jurafsky & Martin, 2026, p. 4). A type-token ratio therefore only compares texts of a similar length, and studies that compare texts of different lengths use measures designed to depend less on it (Vanmassenhove et al., 2019).
Word counts differ from tool to tool
A word count is the number of tokens a tool finds, so two tools can give two different counts for the same document. The difference has two sources:
- The rules of the tool. Whether l’opéra or doesn’t counts as one word or two, whether peut-être and 1 000 000 stay whole, whether punctuation counts at all: each tool makes these decisions in its own way (see also the Hard cases for tokenization page) (voir aussi la page Les cas difficiles de la segmentation).
- The text the tool counts. A document contains more than its running text, for instance footnotes, text boxes, headers, the alternative text of images or the hidden parts of a web page. One tool counts them, another leaves them out, and a word processor may count them only when a setting asks it to.
A translation is often quoted and paid by the word, so a count is worth comparing with the one the other party’s tool gives before relying on it.
Deux façons de compter les mots
La phrase Le chat voit le chien, et le chien voit le chat. compte onze mots si l’on compte chaque mot au fil de la lecture, et cinq si l’on ne compte qu’une fois chaque mot distinct : le quatre fois, chat, chien et voit deux fois chacun, et une fois. En comptant aussi la virgule et le point, on obtient treize et sept. Les apparitions s’appellent des occurrences, les formes distinctes des types, comme le montre la Figure 1figure 1.
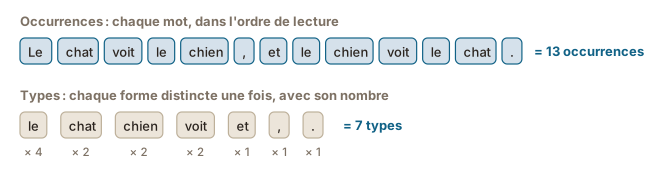
Les deux comptes répondent à des questions différentes, tout comme le rapport entre eux, le nombre de types divisé par le nombre d’occurrences, appelé rapport types/occurrences (angl. type-token ratio). Le tableau ci-dessous donne des exemples d’usage de chacun.
| Compte | Ce qu’il indique | Exemples d’usage |
|---|---|---|
| Occurrences | La longueur d’un texte | Le nombre de mots sur lequel se calcule le prix d’une traduction ou d’un article ; la taille d’un corpus ; les fréquences par million d’occurrences, qui rendent comparables des corpus de tailles différentes (see also the Absolute and relative frequencies page, in the Corpus analysis module) (voir aussi la page Fréquences absolues et relatives, dans le module L'analyse de corpus) |
| Types | Le nombre de mots différents qu’emploie un texte | Une liste de fréquences, la première chose qu’un concordancier montre d’un corpus, avec une ligne par type et son nombre d’occurrences ; la liste de mots avec laquelle travaille un programme, qui doit couvrir les types qu’on lui soumettra (see also the Why not simply use words or characters? page, in the Language as numbers module) (voir aussi la page Pourquoi ne pas simplement prendre les mots ou les caractères ?, dans le module Le langage en nombres) |
| Rapport types/occurrences | La tendance d’un texte à se répéter | Comparer la variété du vocabulaire de deux textes, par exemple une traduction automatique machine translation (MT)traduction automatique (TA) translationtraduction The use of a computer system to produce content in a target language that conveys content expressed in a source language.Utilisation d'un système informatique pour produire, dans une langue cible, un contenu qui rend un contenu exprimé dans une langue source. et une traduction humaine du même texte source |
Vanmassenhove et al. (2019, 2021) ont constaté que des traductions automatiques étaient moins variées que des traductions humaines des mêmes textes : les mots fréquents devenaient plus fréquents, et les mots rares, plus rares.Les deux études portaient sur des systèmes statistiques et neuronaux que les auteurs avaient entraînés sur les débats du Parlement européen, entre l’anglais et le français ou l’espagnol, en 2019 et 2021. Moins varié ne veut pas forcément dire moins bon : dans un texte technique, nommer la même chose de la même façon d’un bout à l’autre est précisément ce qu’on cherche (Vanmassenhove et al., 2021). Les textes produits par un agent conversationnel peuvent aller dans l’autre sens : des dissertations écrites par ChatGPT étaient plus variées que celles de rédacteurs humains (Kendro et al., 2026).Trente dissertations par modèle, de ChatGPT-3.5, ChatGPT-4, o4-mini et GPT-4.5, sur un même sujet argumentatif du TOEFL, comparées à celles de 240 personnes qui écrivent l’anglais comme première ou seconde langue, du secondaire au doctorat.
Le rapport dépend de la longueur
Un texte court a un rapport types/occurrences élevé, un livre entier un rapport bien plus bas, et un grand corpus un rapport plus bas encore, comme le montre le tableau ci-dessous.Le discours de Gettysburg a été compté ici sur la copie Bliss, par forme de mot comme les corpus, si bien que cat et cats seraient deux types ; les majuscules ont été ignorées et la ponctuation laissée de côté. Jurafsky et Martin ne précisent pas comment les majuscules et la ponctuation ont été traitées dans chaque corpus. En gardant les majuscules, le discours compterait 142 types au lieu de 138.
| Texte | Types | Occurrences | Types pour 1 000 occurrences |
|---|---|---|---|
| Le discours de Gettysburg (Lincoln, 1863) | 138 | 271 | 509 |
| Les œuvres de Shakespeare | 29 000 | 884 000 | 33 |
| Le corpus Brown | 38 000 | 1 million | 38 |
| Corpus of Contemporary American English (COCA) | 2 millions | 440 millions | 4,5 |
C’est le cas de tout texte. Plus on en compte, plus on y trouve de types, mais de plus en plus lentement, puisque les mots courants reviennent sans cesse et que les mots nouveaux se raréfient ; cette relation s’appelle la loi de Herdan ou loi de Heaps (Jurafsky & Martin, 2026, p. 4). Un rapport types/occurrences ne compare donc que des textes de longueur semblable, et les études qui comparent des textes de longueurs différentes emploient des mesures conçues pour en dépendre moins (Vanmassenhove et al., 2019).
Le nombre de mots varie d’un outil à l’autre
Un nombre de mots est le nombre d’occurrences qu’un outil trouve ; deux outils peuvent donc donner deux nombres différents pour un même document. La différence a deux sources :
- Les règles de l’outil. Que l’opéra ou doesn’t compte pour un mot ou pour deux, que peut-être et 1 000 000 restent entiers, que la ponctuation compte ou non : chaque outil tranche ces questions à sa façon (see also the Hard cases for tokenization page) (voir aussi la page Les cas difficiles de la segmentation).
- Le texte que l’outil compte. Un document contient plus que son texte courant, par exemple des notes de bas de page, des zones de texte, des en-têtes, le texte de remplacement des images ou les parties cachées d’une page Web. Un outil les compte, un autre les laisse de côté, et un traitement de texte peut ne les compter que si un réglage le demande.
Une traduction est souvent chiffrée et payée au mot : avant de se fier à un nombre de mots, mieux vaut le comparer à celui que donne l’outil de l’autre partie.
Sources
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- Kendro, K., Maloney, J., & Jarvis, S. (2026). Do Large Language Models Produce Texts With “Human-Like” Lexical Diversity? Evidence From Four ChatGPT Models. International Journal of Applied Linguistics, 36(3), 2822–2834. https://doi.org/10.1111/ijal.70115
- Vanmassenhove, E., Shterionov, D., & Gwilliam, M. (2021). Machine Translationese: Effects of Algorithmic Bias on Linguistic Complexity in Machine Translation. Proceedings of the 16th Conference of the European Chapter of the Association for Computational Linguistics: Main Volume, 2203–2213. https://doi.org/10.18653/v1/2021.eacl-main.188
- Vanmassenhove, E., Shterionov, D., & Way, A. (2019). Lost in Translation: Loss and Decay of Linguistic Richness in Machine Translation. Proceedings of Machine Translation Summit XVII: Research Track, 222–232. https://aclanthology.org/W19-6622/