Labelled examples are one way to learn, and the one this chapter follows,
because it is the clearest and the most common. Two other families complete
the standard picture.
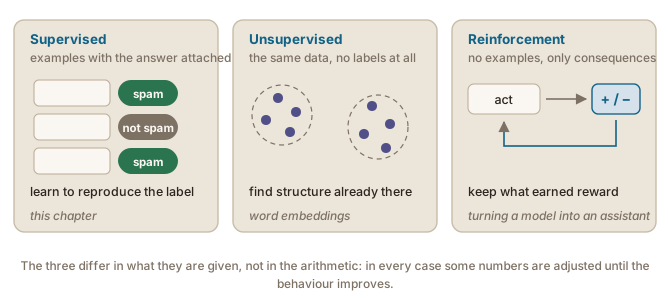
Figure 7. The three families differ in what they are given: examples with answers, data with no answers, or consequences of acting.
Unsupervised learning unsupervised learning apprentissage non supervisé machine learning apprentissage automatique A machine-learning approach that seeks patterns or structure in data without being given a target label or expected output for each training example. Approche d'apprentissage automatique qui cherche des régularités ou des structures dans les données sans recevoir d'étiquette cible ni de sortie attendue pour chaque exemple d'entraînement. works on data
with no labels at all. There is no right answer to compare against; instead
the algorithm looks for structure that is already in the data, such as groups
of similar items. Given thousands of translation-agency invoices, an
unsupervised method might discover that they fall into clusters by client
type, without anyone having defined the clusters beforehand. Where it matters most for
language, word embeddings are learned from raw text, with no human labelling
anything (see also the Word embeddings chapter, in the Language as numbers module) (voir aussi le chapitre Plongements lexicaux , dans le module Le langage en nombres ) .
machine learning apprentissage automatique Definition Définition · unsupervised learning apprentissage non supervisé · fr: apprentissage non supervisé · en : unsupervised learning
A machine-learning approach that seeks patterns or structure in data without being given a target label or expected output for each training example. Approche d'apprentissage automatique qui cherche des régularités ou des structures dans les données sans recevoir d'étiquette cible ni de sortie attendue pour chaque exemple d'entraînement. (Vassilev et al., 2025 ; Grobelnik et al., 2024 )
Notes Remarques It is used for tasks such as grouping similar examples, detecting anomalies, reducing dimensionality and estimating the distribution of data. This does not mean that no people are involved: people still select and prepare the data, choose the algorithm and decide how to interpret and validate the resulting patterns. Self-supervised learning is sometimes grouped under unsupervised learning because it starts with unlabelled data; it is useful to distinguish them, since self-supervised learning automatically constructs prediction targets while unsupervised learning in the narrower sense looks for structure without such input-target pairs. Elle sert à des tâches comme regrouper des exemples semblables, détecter des anomalies, réduire la dimensionnalité et estimer la distribution des données. Cela ne signifie pas qu'aucun humain n'intervient : des personnes choisissent et préparent les données, sélectionnent l'algorithme et décident comment interpréter et valider les régularités obtenues. L'apprentissage autosupervisé est parfois rangé sous l'apprentissage non supervisé parce qu'il part de données non étiquetées ; il est utile de les distinguer, puisque l'apprentissage autosupervisé construit automatiquement des cibles de prédiction, alors que l'apprentissage non supervisé au sens strict cherche des structures sans de telles paires entrée-cible.
Reinforcement learning reinforcement learning (RL) apprentissage par renforcement (AR) machine learning apprentissage automatique A type of machine learning in which an agent learns how to act by receiving rewards or penalties in response to its actions, with the aim of maximizing its overall reward. Type d'apprentissage automatique dans lequel un agent apprend à agir en recevant des récompenses ou des pénalités en réponse à ses actions, avec l'objectif de maximiser sa récompense globale. learns from
trial and error. The system acts, receives a reward or a penalty, and adjusts
toward what earned reward. No example shows it the right action; it has to
find out. This family powers game-playing systems, and it is part of how a raw language
model is turned into a usable assistant (see also the LLM lifecycle module) (voir aussi le module Cycle de vie des GML ) .
machine learning apprentissage automatique Definition Définition · reinforcement learning (RL) apprentissage par renforcement (AR) · fr: apprentissage par renforcement · en : reinforcement learning
A type of machine learning in which an agent learns how to act by receiving rewards or penalties in response to its actions, with the aim of maximizing its overall reward. Type d'apprentissage automatique dans lequel un agent apprend à agir en recevant des récompenses ou des pénalités en réponse à ses actions, avec l'objectif de maximiser sa récompense globale. (Jurafsky & Martin, 2026, p. 219 )
Notes Remarques In language-model post-training, generated responses are evaluated by a reward signal, and the model is adjusted to make responses receiving higher rewards more likely. Dans le postentraînement des modèles de langue, les réponses générées sont évaluées par un signal de récompense et le modèle est ajusté pour rendre plus probables les réponses les mieux récompensées.
Where do today's language models fit?
Large language models large language model (LLM) grand modèle de langue (GML) language models modèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters. Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. blur the first two categories. Their training task,
predicting the next word, needs no human labels, which sounds unsupervised;
yet every next word in the text is its own right answer, which works like
supervision. This in-between setup is called
self-supervised learning self-supervised learning apprentissage autosupervisé machine learning apprentissage automatique A machine-learning approach in which the targets used for training are created automatically from the structure or content of the training data, rather than being supplied as separate human-written labels. Approche d'apprentissage automatique dans laquelle les cibles servant à l'entraînement sont créées automatiquement à partir de la structure ou du contenu des données, plutôt que fournies sous forme d'étiquettes rédigées par des humains. , and it is
treated properly where those models are built (see also the LLM lifecycle module) (voir aussi le module Cycle de vie des GML ) .
Written in English. The French version was automatically generated
and I have not revised it.
Rédigé en anglais. La version française a été
générée automatiquement et je ne l'ai pas révisée.
Updated 10 September 2026
Les exemples étiquetés sont une façon d’apprendre, celle que suit ce
chapitre, parce qu’elle est la plus claire et la plus répandue. Deux autres
familles complètent le tableau habituel.
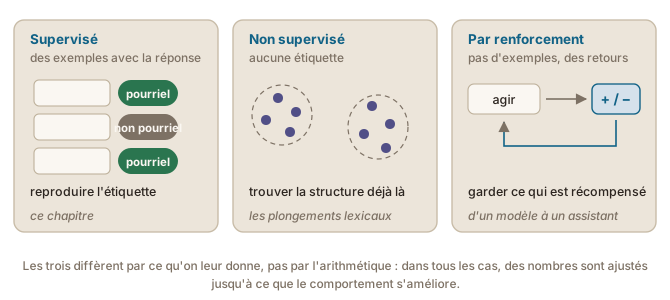
Figure 7. Les trois familles diffèrent par ce qu'on leur donne : des exemples avec les réponses, des données sans réponses, ou les conséquences de leurs actions.
L’apprentissage non supervisé unsupervised learning apprentissage non supervisé machine learning apprentissage automatique A machine-learning approach that seeks patterns or structure in data without being given a target label or expected output for each training example. Approche d'apprentissage automatique qui cherche des régularités ou des structures dans les données sans recevoir d'étiquette cible ni de sortie attendue pour chaque exemple d'entraînement. travaille
sur des données sans aucune étiquette. Il n’y a pas de bonne réponse à
laquelle se comparer ; l’algorithme cherche plutôt une structure déjà présente
dans les données, par exemple des groupes d’éléments semblables. Devant des
milliers de factures d’agences de traduction, une méthode non supervisée
pourrait découvrir qu’elles se regroupent par type de client, sans que
personne ait défini ces groupes à l’avance. Là où cela compte le plus pour la
langue, les plongements lexicaux s’apprennent à partir de texte brut, sans que
personne n’étiquette
quoi que ce soit (see also the Word embeddings chapter, in the Language as numbers module) (voir aussi le chapitre Plongements lexicaux , dans le module Le langage en nombres ) .
machine learning apprentissage automatique Definition Définition · unsupervised learning apprentissage non supervisé · fr: apprentissage non supervisé · en : unsupervised learning
A machine-learning approach that seeks patterns or structure in data without being given a target label or expected output for each training example. Approche d'apprentissage automatique qui cherche des régularités ou des structures dans les données sans recevoir d'étiquette cible ni de sortie attendue pour chaque exemple d'entraînement. (Vassilev et al., 2025 ; Grobelnik et al., 2024 )
Notes Remarques It is used for tasks such as grouping similar examples, detecting anomalies, reducing dimensionality and estimating the distribution of data. This does not mean that no people are involved: people still select and prepare the data, choose the algorithm and decide how to interpret and validate the resulting patterns. Self-supervised learning is sometimes grouped under unsupervised learning because it starts with unlabelled data; it is useful to distinguish them, since self-supervised learning automatically constructs prediction targets while unsupervised learning in the narrower sense looks for structure without such input-target pairs. Elle sert à des tâches comme regrouper des exemples semblables, détecter des anomalies, réduire la dimensionnalité et estimer la distribution des données. Cela ne signifie pas qu'aucun humain n'intervient : des personnes choisissent et préparent les données, sélectionnent l'algorithme et décident comment interpréter et valider les régularités obtenues. L'apprentissage autosupervisé est parfois rangé sous l'apprentissage non supervisé parce qu'il part de données non étiquetées ; il est utile de les distinguer, puisque l'apprentissage autosupervisé construit automatiquement des cibles de prédiction, alors que l'apprentissage non supervisé au sens strict cherche des structures sans de telles paires entrée-cible.
L’apprentissage par renforcement reinforcement learning (RL) apprentissage par renforcement (AR) machine learning apprentissage automatique A type of machine learning in which an agent learns how to act by receiving rewards or penalties in response to its actions, with the aim of maximizing its overall reward. Type d'apprentissage automatique dans lequel un agent apprend à agir en recevant des récompenses ou des pénalités en réponse à ses actions, avec l'objectif de maximiser sa récompense globale.
apprend par essais et erreurs. Le système agit, reçoit une récompense ou une
pénalité, et s’ajuste vers ce qui a été récompensé. Aucun exemple ne lui
montre la bonne action ; il doit la trouver. Cette famille fait fonctionner
les systèmes qui jouent à des jeux, et elle fait partie de la façon dont un
modèle de langue brut devient un assistant
utilisable (see also the LLM lifecycle module) (voir aussi le module Cycle de vie des GML ) .
machine learning apprentissage automatique Definition Définition · reinforcement learning (RL) apprentissage par renforcement (AR) · fr: apprentissage par renforcement · en : reinforcement learning
A type of machine learning in which an agent learns how to act by receiving rewards or penalties in response to its actions, with the aim of maximizing its overall reward. Type d'apprentissage automatique dans lequel un agent apprend à agir en recevant des récompenses ou des pénalités en réponse à ses actions, avec l'objectif de maximiser sa récompense globale. (Jurafsky & Martin, 2026, p. 219 )
Notes Remarques In language-model post-training, generated responses are evaluated by a reward signal, and the model is adjusted to make responses receiving higher rewards more likely. Dans le postentraînement des modèles de langue, les réponses générées sont évaluées par un signal de récompense et le modèle est ajusté pour rendre plus probables les réponses les mieux récompensées.
Où se situent les modèles de langue d'aujourd'hui ?
Les grands modèles de langue large language model (LLM) grand modèle de langue (GML) language models modèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters. Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. brouillent
les deux premières catégories. Leur tâche d’entraînement, prédire le mot
suivant, ne demande aucune étiquette humaine, ce qui a l’air non supervisé ;
pourtant, chaque mot suivant du texte est sa propre bonne réponse, ce qui
fonctionne comme une supervision. Ce montage intermédiaire s’appelle
l’apprentissage autosupervisé self-supervised learning apprentissage autosupervisé machine learning apprentissage automatique A machine-learning approach in which the targets used for training are created automatically from the structure or content of the training data, rather than being supplied as separate human-written labels. Approche d'apprentissage automatique dans laquelle les cibles servant à l'entraînement sont créées automatiquement à partir de la structure ou du contenu des données, plutôt que fournies sous forme d'étiquettes rédigées par des humains. , et
il est traité comme il se doit là où ces modèles sont
construits (see also the LLM lifecycle module) (voir aussi le module Cycle de vie des GML ) .
Written in English. The French version was automatically generated
and I have not revised it.
Rédigé en anglais. La version française a été
générée automatiquement et je ne l'ai pas révisée.
Mise à jour 10 septembre 2026