Rule-based systemsLes systèmes à base de règles
TRA2600 S5 · in classS5 · en classe
TRA6008 OptionalFacultatif
Rules written by people
A rule-based system automates a task by applying rules that people wrote down.
Two examples of simple rule-based systems are:
- a grammar checker:
a singular subject followed by a plural verb ⇒ flag the sentence - a date converter:
four digits, a hyphen, two digits, a hyphen, two digits ⇒ a date; reorder the parts
Every piece of the system’s behaviour was specified by a human, which is why this is called the deductive approach: general rules first, applied to each new case. Figure 1figure 1 shows one such rule applied to two sentences.
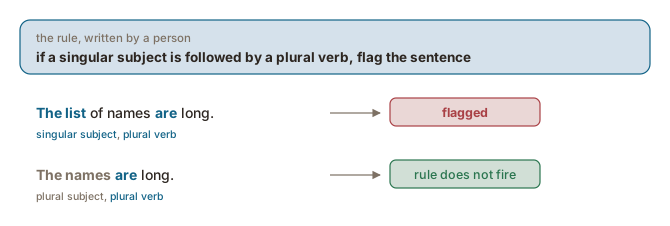
For language, the rule writers were often linguists. Early machine translation machine translation (MT)traduction automatique (TA) translationtraduction The use of a computer system to produce content in a target language that conveys content expressed in a source language.Utilisation d'un système informatique pour produire, dans une langue cible, un contenu qui rend un contenu exprimé dans une langue source. systems, spelling and grammar checkers, and the first dialogue systems were built from thousands of grammatical rules, dictionary entries and transformation patterns, each written and maintained by hand.
The text a rule can see
A rule can only test what the program can observe in the text. The date converter’s rule is written in characters, digits and hyphens, which any program can read. The grammar checker’s rule assumes that the program already knows which words form the subject, whether it is singular and which word is the verb, and none of that is written in the text: it takes part-of-speech tagging part-of-speech tagging (POS tagging)étiquetage morphosyntaxique NLPTAL The task of taking a sequence of tokenized words and a tagset, and assigning to each word one tag naming its grammatical class, such as noun or verb.Tâche qui consiste à prendre une suite de mots segmentés et un jeu d'étiquettes, puis à attribuer à chaque mot une étiquette nommant sa classe grammaticale, par exemple nom ou verbe. and parsing first, each a task of its own. Writing a rule therefore starts by translating what a person notices into something a program can measure.
Strengths and weaknesses
Rule-based systems are still in use, and Figure 2figure 2 sums up why, and why the field moved on. In a narrow, well-defined domain they are precise, every decision can be traced to a rule a person can read and fix, and they need no data. Against real language, which is ambiguous ambiguityambiguïté linguisticslinguistique The property of a stretch of language that allows more than one interpretation.Propriété d'un segment de langue qui autorise plus d'une interprétation. , variable and full of exceptions, the rule set keeps growing without ever covering everything, and every new language or text type means starting over (see also the Why language is hard chapter, in the Language as numbers module) (voir aussi le chapitre Pourquoi le langage est difficile, dans le module Le langage en nombres).
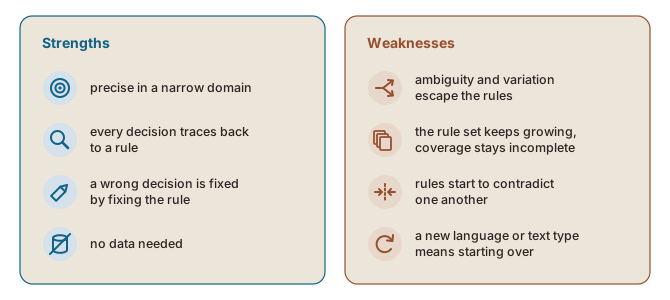
By the late 1980s, the weaknesses had pushed the field toward another way of building systems, in which the patterns are found in data instead of written as rules.
Des règles écrites par des personnes
Un système à base de règles automatise une tâche en appliquant des règles que des personnes ont écrites.
Voici deux exemples de systèmes simples à base de règles :
- un correcteur grammatical :
un sujet singulier suivi d’un verbe pluriel ⇒ signaler la phrase - un convertisseur de dates :
quatre chiffres, un trait d’union, deux chiffres, un trait d’union, deux chiffres ⇒ une date ; réordonner les parties
Chaque élément du comportement du système a été spécifié par une personne, et c’est pourquoi on parle d’approche déductive : des règles générales d’abord, appliquées à chaque nouveau cas. La Figure 1figure 1 montre une telle règle appliquée à deux phrases.
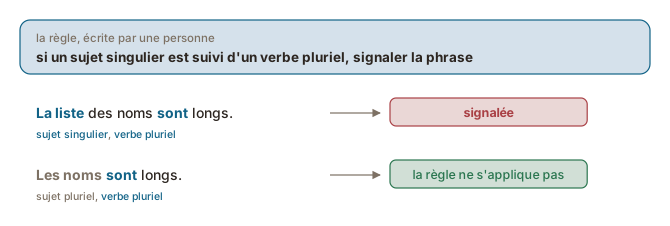
Pour la langue, les auteurs de règles étaient souvent des linguistes. Les premiers systèmes de traduction automatique machine translation (MT)traduction automatique (TA) translationtraduction The use of a computer system to produce content in a target language that conveys content expressed in a source language.Utilisation d'un système informatique pour produire, dans une langue cible, un contenu qui rend un contenu exprimé dans une langue source. , les correcteurs orthographiques et grammaticaux et les premiers systèmes de dialogue étaient faits de milliers de règles grammaticales, d’entrées de dictionnaire et de schémas de transformation, chacun écrit et maintenu à la main.
Le texte vu par une règle
Une règle ne peut tester que ce que le programme observe dans le texte. La règle du convertisseur de dates est écrite en caractères, en chiffres et en traits d’union, que n’importe quel programme sait lire. Celle du correcteur grammatical suppose que le programme sait déjà quels mots forment le sujet, si celui-ci est singulier et quel mot est le verbe, et rien de tout cela n’est écrit dans le texte : il faut d’abord un étiquetage morphosyntaxique part-of-speech tagging (POS tagging)étiquetage morphosyntaxique NLPTAL The task of taking a sequence of tokenized words and a tagset, and assigning to each word one tag naming its grammatical class, such as noun or verb.Tâche qui consiste à prendre une suite de mots segmentés et un jeu d'étiquettes, puis à attribuer à chaque mot une étiquette nommant sa classe grammaticale, par exemple nom ou verbe. et une analyse syntaxique, deux tâches à part entière. Écrire une règle commence donc par traduire ce qu’une personne remarque en quelque chose qu’un programme peut mesurer.
Points forts et points faibles
Les systèmes à base de règles servent encore, et la Figure 2figure 2 résume pourquoi, et pourquoi le domaine s’en est détourné. Dans un domaine étroit et bien défini, ils sont précis, chaque décision remonte à une règle qu’une personne peut lire et corriger, et ils n’ont besoin d’aucune donnée. Face à la langue réelle, ambiguë ambiguityambiguïté linguisticslinguistique The property of a stretch of language that allows more than one interpretation.Propriété d'un segment de langue qui autorise plus d'une interprétation. , variable et pleine d’exceptions, l’ensemble de règles ne cesse de grossir sans jamais tout couvrir, et chaque nouvelle langue ou chaque nouveau type de texte oblige à recommencer (see also the Why language is hard chapter, in the Language as numbers module) (voir aussi le chapitre Pourquoi le langage est difficile, dans le module Le langage en nombres).
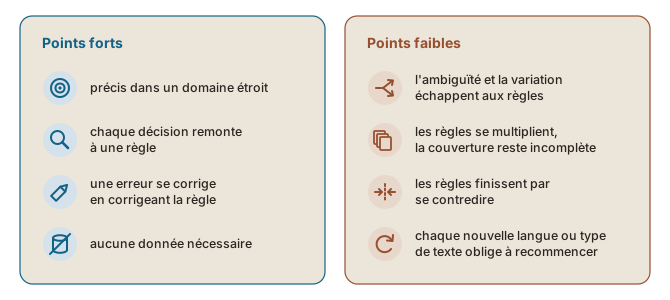
À la fin des années 1980, ces faiblesses avaient poussé le domaine vers une autre façon de construire les systèmes, où les régularités sont trouvées dans des données au lieu d’être écrites sous forme de règles.
Sources
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Sources
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/