Word classes and part-of-speech tagsetsClasses de mots et jeux d'étiquettes morphosyntaxiques
TRA2600 S5 · in classS5 · en classe
A label for every word
In the sentence Mary loves reading books, you can say of every word what kind of word it is: a proper noun, a verb, another verb, a noun. Part-of-speech tagging does this automatically for every word of a text, and the result is written with a tag after each word: Mary/PROPN loves/VERB reading/VERB books/NOUN.
The task takes a text that has already been cut into words (see also the Tokenization (including an example of the rule-based approach) chapter) (voir aussi le chapitre La segmentation en unités lexicales (y compris un exemple d'approche à base de règles)) and gives each of them exactly one tag (Jurafsky & Martin, 2026). It is rarely the end of a pipeline and almost always a step in one: a concordancer uses the tags to let you search for all the nouns after a given verb, and a grammar checker uses them, among other information, to check that a verb agrees with its subject.
Open and closed classes
The classes themselves are older than computers. Grammars have sorted words into nouns, verbs, adjectives and the rest for two millennia, and the classes are defined by how a word behaves with its neighbours and by the endings it takes, not by what it means: a noun is a word that can follow a determiner and take a plural, whatever it refers to (Jurafsky & Martin, 2026).
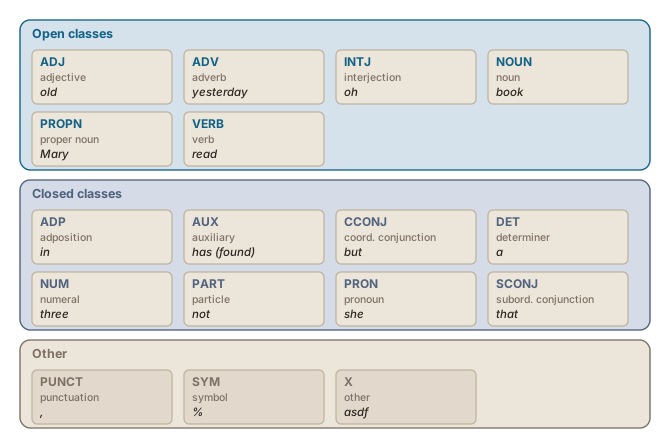
Classes come in two kinds. Nouns, verbs, adjectives and adverbs are open classes: new members appear all the time, as selfie and to google did. Determiners, pronouns, prepositions and conjunctions are closed classes: a few dozen words each, rarely added to, very frequent, and doing the structural work of a sentence (Jurafsky & Martin, 2026). Figure 1figure 1 shows the seventeen classes of the tagset that Universal Dependencies, a large collection of annotated corpora, uses for more than a hundred languages (de Marneffe et al., 2021).
Tagsets differ
Those seventeen tags are one choice among many. A tagset is a decision about how finely to cut the classes, and different projects have cut them very differently.
The table below sets some of them side by side, from the seventeen universal tags to sets that fold number, tense, case or gender into the tag.The French and Dutch counts were checked on 6 October 2026 at their sources: TreeTagger’s French tagset, the label list of a CamemBERT tagger trained on the French Treebank, and the documentation of the Spoken Dutch Corpus.
| Tagset | Language | Tags | What the extra tags record |
|---|---|---|---|
| Universal Dependencies | more than a hundred languages | 17 | n.a.; number, tense and gender are expressed as separate features per word |
| Penn Treebank | English | 45 | Singular against plural nouns, past tense against past participle, and so on |
| TreeTagger | French | 33 | Verb tenses and moods, pronoun types |
| French Treebank (used by a CamemBERT tagger) | French | 29 | Verb moods, pronoun types |
| MULTITAG | French | about 1 500 | Gender and number, and for verbs mood and tense, folded into the tag (Allauzen & Bonneau-Maynard, 2008) |
| Spoken Dutch Corpus (CGN) | Dutch | 316 | Number, gender, case, tense and more, folded into the tag |
| Tagsets for Czech, Hungarian, Turkish | languages with rich morphology | 4 to 10 times an English set | Case, number and gender (Jurafsky & Martin, 2026) |
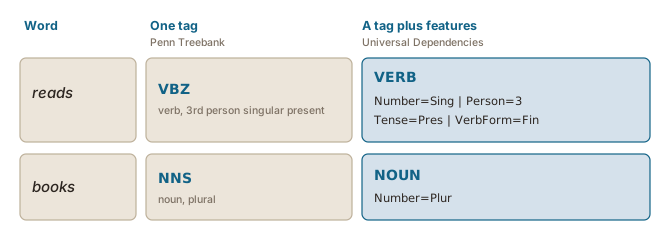
The information does not disappear when the tagset is small; it is encoded elsewhere. Universal Dependencies keeps its seventeen tags and records number, tense or gender as separate features attached to the word (de Marneffe et al., 2021), where a larger tagset folds them into the tag itself. Figure 2figure 2 shows the two conventions on two English words. When you read the output of a tagger, the first thing to find out is which tagset it used, since ADJ in one and JJ in another may be the same class, and NN in one may be two classes in another.
Une étiquette pour chaque mot
Dans la phrase Marie adore lire des livres, vous pouvez dire de chaque mot de quel type de mot il s’agit : un nom propre, un verbe, un autre verbe, un déterminant, un nom. L’étiquetage morphosyntaxique fait la même chose automatiquement pour chaque mot d’un texte, et le résultat s’écrit avec une étiquette après chaque mot : Marie/PROPN adore/VERB lire/VERB des/DET livres/NOUN.
La tâche prend un texte déjà découpé en mots (see also the Tokenization (including an example of the rule-based approach) chapter) (voir aussi le chapitre La segmentation en unités lexicales (y compris un exemple d'approche à base de règles)) et donne à chacun exactement une étiquette (Jurafsky & Martin, 2026). Elle est rarement le bout d’une chaîne de traitement et presque toujours une étape à l’intérieur : un concordancier se sert des étiquettes pour vous laisser chercher tous les noms qui suivent un verbe donné, et un correcteur grammatical s’en sert, entre autres informations, pour vérifier qu’un verbe s’accorde avec son sujet.
Classes ouvertes et classes fermées
Les classes elles-mêmes sont plus anciennes que les ordinateurs. Les grammaires répartissent les mots en noms, verbes, adjectifs et ainsi de suite depuis deux millénaires, et les classes se définissent par le comportement d’un mot avec ses voisins et par les terminaisons qu’il prend, non par ce qu’il veut dire : un nom est un mot qui peut suivre un déterminant et prendre un pluriel, quoi qu’il désigne (Jurafsky & Martin, 2026).
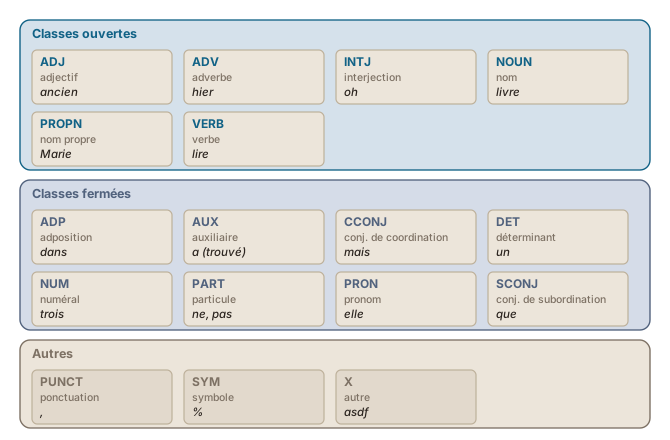
Il y a deux sortes de classes. Les noms, les verbes, les adjectifs et les adverbes forment des classes ouvertes : de nouveaux membres y entrent sans cesse, comme courriel et télécharger. Les déterminants, les pronoms, les prépositions et les conjonctions forment des classes fermées : quelques dizaines de mots chacune, rarement enrichies, très fréquentes, et qui font le travail structurel de la phrase (Jurafsky & Martin, 2026). La Figure 1figure 1 montre les dix-sept classes du jeu d’étiquettes qu’utilise Universal Dependencies, une vaste collection de corpus annotés, pour plus de cent langues (de Marneffe et al., 2021).
Les jeux d’étiquettes diffèrent
Ces dix-sept étiquettes sont un choix parmi d’autres. Un jeu d’étiquettes est une décision sur la finesse du découpage des classes, et les projets l’ont tranchée de façons très différentes.
Le tableau ci-dessous en met quelques-uns côte à côte, des dix-sept étiquettes universelles aux jeux qui intègrent le nombre, le temps, le cas ou le genre dans l’étiquette.Les chiffres pour le français et le néerlandais ont été vérifiés le 6 octobre 2026 à leur source : le jeu d’étiquettes français de TreeTagger, la liste d’étiquettes d’un étiqueteur CamemBERT entraîné sur le French Treebank, et la documentation du Spoken Dutch Corpus.
| Jeu d’étiquettes | Langue | Étiquettes | Ce que consignent les étiquettes supplémentaires |
|---|---|---|---|
| Universal Dependencies | plus de cent langues | 17 | sans objet ; le nombre, le temps et le genre sont exprimés par des traits distincts, mot par mot |
| Penn Treebank | anglais | 45 | Nom singulier ou pluriel, passé ou participe passé, etc. |
| TreeTagger | français | 33 | Temps et modes du verbe, types de pronoms |
| French Treebank (utilisé par un étiqueteur CamemBERT) | français | 29 | Modes du verbe, types de pronoms |
| MULTITAG | français | environ 1 500 | Genre et nombre, et pour les verbes mode et temps, intégrés à l’étiquette (Allauzen & Bonneau-Maynard, 2008) |
| Spoken Dutch Corpus (CGN) | néerlandais | 316 | Nombre, genre, cas, temps et plus, intégrés à l’étiquette |
| Jeux pour le tchèque, le hongrois, le turc | langues à morphologie riche | 4 à 10 fois un jeu anglais | Cas, nombre et genre (Jurafsky & Martin, 2026) |
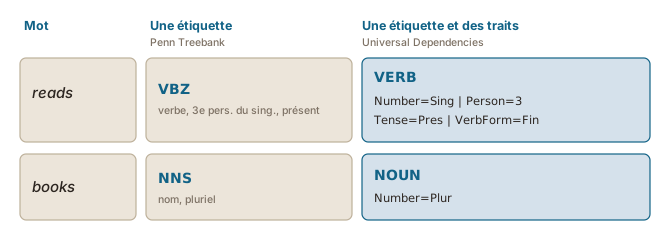
L’information ne disparaît pas quand le jeu d’étiquettes est petit : elle est codée ailleurs. Universal Dependencies garde ses dix-sept étiquettes et consigne le nombre, le temps ou le genre sous forme de traits distincts attachés au mot (de Marneffe et al., 2021), là où un jeu plus grand les intègre à l’étiquette elle-même. La Figure 2figure 2 montre les deux conventions sur deux mots anglais, puisque le Penn Treebank est un jeu d’étiquettes pour l’anglais. Quand vous lisez la sortie d’un étiqueteur, la première chose à vérifier est le jeu d’étiquettes utilisé : ADJ dans l’un et JJ dans un autre peuvent être la même classe, et NN dans l’un peut correspondre à deux classes dans un autre.
Sources
- Allauzen, A., & Bonneau-Maynard, H. (2008). Training and Evaluation of POS Taggers on the French MULTITAG Corpus. Proceedings of the Sixth International Conference on Language Resources and Evaluation (LREC'08), Marrakech, 3373–3377. https://aclanthology.org/L08-1368/
- de Marneffe, M.-C., Manning, C. D., Nivre, J., & Zeman, D. (2021). Universal Dependencies. Computational Linguistics, 47(2), 255–308. https://doi.org/10.1162/coli_a_00402
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/