FeaturesLes attributs
TRA2600 S5 · in classS5 · en classe
TRA6008 S1 · in classS1 · en classe
Algorithms cannot read emails the way humans do: they need numbers. So each example has to be described as a set of measurable properties: how long the message is, whether the sender is in your address book (typically encoded as 1 if yes, 0 if no), how many links it contains, whether the words win, free or miracle appear. Each such property is a feature.
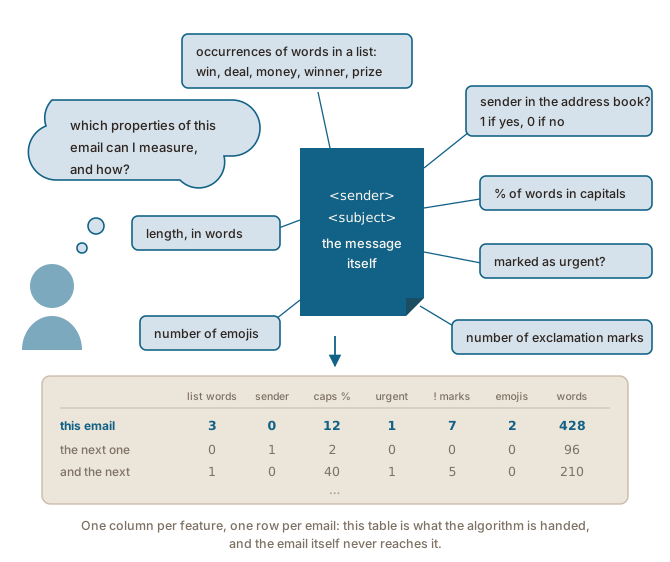
In traditional machine learning, choosing the features is human work, and it is where most of the craft goes. Someone has to guess which properties distinguish spam from ordinary mail, work out how to turn each one into a number, test the result, and go back for better features when the model disappoints. The guesses are hypotheses about the problem, and bad ones cap what any algorithm can achieve.
The strength of this recipe, features plus labels plus the loop, is that it can weigh hundreds of weak signals at once, which no hand-written rule set manages. Its ceiling is the features themselves: the model can only be as observant as the properties someone thought to measure. That ceiling is what neural networks later removed, by learning the features too (see also the From neural networks to large language models chapter) (voir aussi le chapitre Des réseaux de neurones aux grands modèles de langue).
Les algorithmes ne lisent pas les courriels comme les humains : il leur faut des nombres. Chaque exemple doit donc être décrit par un ensemble de propriétés mesurables : la longueur du message, la présence de l’expéditeur dans votre carnet d’adresses (encodée en général par 1 si oui, 0 si non), le nombre de liens, la présence des mots gagner, gratuit ou miracle. Chacune de ces propriétés est un attribut.
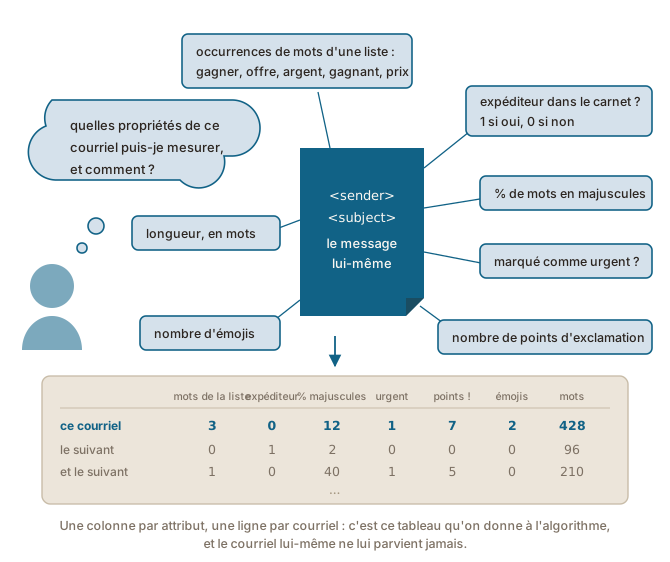
En apprentissage automatique traditionnel, le choix des attributs est un travail humain, et c’est là que passe l’essentiel du métier. Quelqu’un doit deviner quelles propriétés distinguent le pourriel du courrier ordinaire, trouver comment transformer chacune en nombre, tester le résultat et repartir en chercher de meilleures quand le modèle déçoit. Ces suppositions sont des hypothèses sur le problème, et les mauvaises plafonnent ce que n’importe quel algorithme peut atteindre.
La force de cette recette, des attributs plus des étiquettes plus la boucle, est de pouvoir peser des centaines de signaux faibles à la fois, ce qu’aucun ensemble de règles écrites à la main ne réussit. Son plafond, ce sont les attributs eux-mêmes : le modèle ne peut être plus observateur que les propriétés que quelqu’un a pensé à mesurer. Ce plafond, ce sont les réseaux de neurones qui l’ont levé plus tard, en apprenant aussi les attributs (see also the From neural networks to large language models chapter) (voir aussi le chapitre Des réseaux de neurones aux grands modèles de langue).
Sources
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- Raschka, S. (2024). Machine Learning Q and AI. No Starch Press. https://nostarch.com/machine-learning-q-and-ai