Ways of evaluatingLes façons d'évaluer
TRA2600 OptionalFacultatif
TRA6008 OptionalFacultatif
Four ways to evaluate
The output of a system can be evaluated in several ways. The first table below gives four of them, with the kinds of system each is typically used for. The first way compares the output with answers prepared in advance, while in the other three, people judge the output itself.
Figure 2figure 2 applies the four ways to one machine translation.
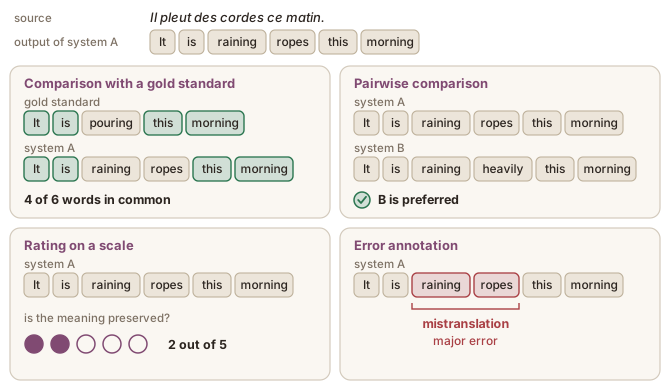
Each way has its benefits and its costs, which the second table sets out.
| Way of evaluating | Benefits | Costs and risks |
|---|---|---|
| Comparison with a gold standard | the same evaluation can be repeated, and reused for every new system at no extra cost | the result depends on one gold standard, where other answers could be correct (Basile et al., 2021); a public gold standard can end up in the training data of the systems it tests (Sainz et al., 2023) |
| Pairwise comparison | an easy judgement to make, which shows directly which of two systems is preferred | it says which output is better, but not how good either is, or why; every new system needs new judgements |
| Rating on a scale | a quality level for each output, on each criterion | people apply a scale differently, so raters need clear criteria and training (Jurafsky & Martin, 2026) |
| Error annotation | it shows which errors a system makes and where | slow and expensive, because it takes experts (Kocmi et al., 2024a) |
Pairwise comparison is the method behind the public rankings of chatbots (see also the Human preference rankings page, in the Using LLMs module) (voir aussi la page Les classements fondés sur les préférences humaines, dans le module Utiliser les GML). Rating and error annotation are the main ways of evaluating translations by hand, with schemes such as Multidimensional Quality Metrics (MQM) and Error Span Annotation (ESA) (see also the Evaluating machine translation chapter) (voir aussi le chapitre Évaluation de la traduction automatique).
People and automatic measures
A judgement can come from a person or from an automatic measure. The table below compares three cases.
| Judge | Benefits | Costs and risks |
|---|---|---|
| People | the most trusted form of evaluation for systems that produce text (Howcroft et al., 2020) | slow and expensive (Jurafsky & Martin, 2026); the result depends on who judges and on how the criteria are defined |
| An automatic measure that compares the output with a gold standard | fast and cheap, so it can be repeated for every system | only useful as far as it agrees with the judgements of people |
| A large language model large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. as judge (Zheng et al., 2023) | fast and cheap; it can judge an output with no gold standard to compare it with | its judgements have biases of their own, so they also have to be checked against those of people |
Two findings show how much the judgements of people depend on the way they are collected:
- Who judges. When professional translators annotated the errors in the output of machine translation machine translation (MT)traduction automatique (TA) translationtraduction The use of a computer system to produce content in a target language that conveys content expressed in a source language.Utilisation d'un système informatique pour produire, dans une langue cible, un contenu qui rend un contenu exprimé dans une langue source. systems, the systems were ranked very differently from the ranking that crowd workers had produced (Freitag et al., 2021).
- How the criteria are defined. In two decades of papers on text generation, the quality criteria had very different names and definitions from one paper to the next, and reports often left out how the evaluation was done, so the results are hard to compare (Howcroft et al., 2020).
An automatic measure is checked by comparing its scores with the judgements of people on the same outputs (see also the Benchmarks and test sets page) (voir aussi la page Tests de performances et jeux de test).
Intrinsic and extrinsic evaluation
An evaluation can judge the output of a system, or what happens when the system is used (Jurafsky & Martin, 2026):
- Intrinsic evaluation judges the output itself. The four ways above are intrinsic.
- Extrinsic evaluation measures the effect of the system on a task, for
instance:
- for a translation system, how much a translator has to change in the output before it is correct;
- for a term extractor, how much time the list of candidates saves the person who builds a termbase termbasebase terminologique terminologyterminologie A database of terminological entries organized by concept, grouping the terms of several languages with metadata such as definitions, domains and usage status.Base de données d'entrées terminologiques organisée par concept, contenant les termes de plusieurs langues et des métadonnées comme des définitions, des domaines et des marques d'usage. .
An extrinsic evaluation is the only way to know whether a system helps with the task at hand, but it is often very expensive (Jurafsky & Martin, 2026).
Choosing a way of evaluating
The way of evaluating depends on the question and on the available resources.
The question, for instance:
- to find out which of two chatbots or translation systems people prefer, a pairwise comparison;
- to find out whether a translation is good enough to use, and what is wrong with it, a rating or an error annotation;
- to compare many systems, or to follow one system from one version to the next, a comparison with a gold standard (see also the gold standard page) (voir aussi la page L'étalon de référence).
The resources, for instance:
- Time and money. Judgements by people cost more than an automatic measure, and they have to be paid for again for every new system (Jurafsky & Martin, 2026).
- Expertise. Error annotation takes experts, who are not available for every language (Kocmi et al., 2024a).
- An existing gold standard. Where none exists for the task, the domain and the language, making one is the first cost of the evaluation.
An evaluation often combines several ways, for instance a score against a gold standard for every system and an error annotation for the best ones.
Quatre façons d’évaluer
La sortie d’un système peut être évaluée de plusieurs façons. Le premier tableau ci-dessous en présente quatre, avec les types de systèmes pour lesquels chacune est habituellement utilisée. La première façon compare la sortie avec des réponses préparées à l’avance, tandis que dans les trois autres, des personnes jugent la sortie elle-même.
La Figure 2figure 2 applique les quatre façons à une même traduction automatique.
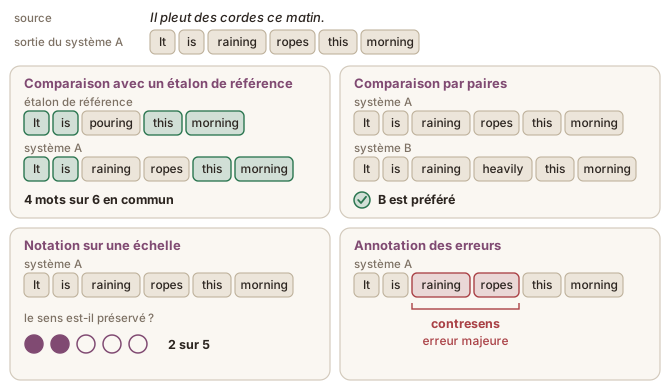
Chaque façon a ses avantages et ses coûts, que présente le deuxième tableau.
| Façon d’évaluer | Avantages | Coûts et risques |
|---|---|---|
| Comparaison avec un étalon de référence | la même évaluation peut être répétée, et réutilisée pour chaque nouveau système sans coût supplémentaire | le résultat dépend d’un seul étalon de référence, alors que d’autres réponses pourraient être correctes (Basile et al., 2021) ; un étalon de référence public peut se retrouver dans les données d’entraînement des systèmes qu’il sert à tester (Sainz et al., 2023) |
| Comparaison par paires | un jugement facile à poser, qui montre directement lequel de deux systèmes est préféré | elle dit quelle sortie est la meilleure, mais pas à quel point chacune est bonne, ni pourquoi ; chaque nouveau système demande de nouveaux jugements |
| Notation sur une échelle | un niveau de qualité pour chaque sortie, pour chaque critère | les personnes n’appliquent pas une échelle de la même façon, de sorte que les évaluateurs ont besoin de critères clairs et d’une formation (Jurafsky & Martin, 2026) |
| Annotation des erreurs | elle montre quelles erreurs un système commet et à quel endroit | lente et coûteuse, parce qu’elle demande des spécialistes (Kocmi et al., 2024a) |
La comparaison par paires est la méthode derrière les classements publics d’agents conversationnels (see also the Human preference rankings page, in the Using LLMs module) (voir aussi la page Les classements fondés sur les préférences humaines, dans le module Utiliser les GML). La notation et l’annotation des erreurs sont les principales façons d’évaluer des traductions à la main, avec des grilles comme Multidimensional Quality Metrics (MQM) et Error Span Annotation (ESA) (see also the Evaluating machine translation chapter) (voir aussi le chapitre Évaluation de la traduction automatique).
Les personnes et les mesures automatiques
Un jugement peut venir d’une personne ou d’une mesure automatique. Le tableau ci-dessous compare trois cas.
| Juge | Avantages | Coûts et risques |
|---|---|---|
| Des personnes | la forme d’évaluation qui inspire le plus confiance pour les systèmes qui produisent du texte (Howcroft et al., 2020) | lent et coûteux (Jurafsky & Martin, 2026) ; le résultat dépend de qui juge et de la façon dont les critères sont définis |
| Une mesure automatique qui compare la sortie à un étalon de référence | rapide et peu coûteuse, de sorte qu’elle peut être répétée pour chaque système | utile seulement dans la mesure où elle concorde avec les jugements de personnes |
| Un grand modèle de langue large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. comme juge (Zheng et al., 2023) | rapide et peu coûteux ; il peut juger une sortie sans étalon de référence auquel la comparer | ses jugements ont leurs propres biais, de sorte qu’ils doivent eux aussi être vérifiés par rapport à ceux de personnes |
Deux constats montrent à quel point les jugements de personnes dépendent de la façon dont ils sont recueillis :
- Qui juge. Quand des traducteurs professionnels ont annoté les erreurs dans la sortie de systèmes de traduction automatique machine translation (MT)traduction automatique (TA) translationtraduction The use of a computer system to produce content in a target language that conveys content expressed in a source language.Utilisation d'un système informatique pour produire, dans une langue cible, un contenu qui rend un contenu exprimé dans une langue source. , le classement des systèmes a été très différent de celui qu’avaient produit des travailleurs recrutés sur une plateforme de production participative (Freitag et al., 2021).
- Comment les critères sont définis. Dans vingt ans d’articles sur la génération de texte, les critères de qualité avaient des noms et des définitions très différents d’un article à l’autre, et les comptes rendus omettaient souvent de dire comment l’évaluation avait été menée, de sorte que les résultats sont difficiles à comparer (Howcroft et al., 2020).
Une mesure automatique est vérifiée en comparant ses scores aux jugements de personnes sur les mêmes sorties (see also the Benchmarks and test sets page) (voir aussi la page Tests de performances et jeux de test).
Évaluation intrinsèque et évaluation extrinsèque
Une évaluation peut juger la sortie d’un système, ou les effets de l’utilisation du système (Jurafsky & Martin, 2026) :
- L’évaluation intrinsèque juge la sortie elle-même. Les quatre façons ci-dessus sont intrinsèques.
- L’évaluation extrinsèque mesure l’effet du système sur une tâche, par
exemple :
- pour un système de traduction, ce qu’un traducteur doit modifier dans la sortie pour qu’elle soit correcte ;
- pour un extracteur de termes, le temps que la liste de candidats fait gagner à la personne qui construit une base terminologique termbasebase terminologique terminologyterminologie A database of terminological entries organized by concept, grouping the terms of several languages with metadata such as definitions, domains and usage status.Base de données d'entrées terminologiques organisée par concept, contenant les termes de plusieurs langues et des métadonnées comme des définitions, des domaines et des marques d'usage. .
Une évaluation extrinsèque est la seule façon de savoir si un système aide à accomplir la tâche visée, mais elle est souvent très coûteuse (Jurafsky & Martin, 2026).
Choisir une façon d’évaluer
La façon d’évaluer dépend de la question et des ressources disponibles.
La question, par exemple :
- pour savoir lequel de deux agents conversationnels ou de deux systèmes de traduction les gens préfèrent, une comparaison par paires ;
- pour savoir si une traduction est assez bonne pour être utilisée, et ce qui ne va pas, une notation ou une annotation des erreurs ;
- pour comparer de nombreux systèmes, ou pour suivre un système d’une version à la suivante, une comparaison avec un étalon de référence (see also the gold standard page) (voir aussi la page L'étalon de référence).
Les ressources, par exemple :
- Le temps et l’argent. Les jugements de personnes coûtent plus cher qu’une mesure automatique, et il faut les payer de nouveau pour chaque nouveau système (Jurafsky & Martin, 2026).
- L’expertise. L’annotation des erreurs demande des spécialistes, qui ne sont pas disponibles pour toutes les langues (Kocmi et al., 2024a).
- Un étalon de référence existant. Lorsqu’il n’en existe aucun pour la tâche, le domaine et la langue, en créer un est le premier coût de l’évaluation.
Une évaluation combine souvent plusieurs façons, par exemple un score par rapport à un étalon de référence pour chaque système et une annotation des erreurs pour les meilleurs.
Sources
- Basile, V., Fell, M., Fornaciari, T., Hovy, D., Paun, S., Plank, B., et al. (2021). We Need to Consider Disagreement in Evaluation. Proceedings of the 1st Workshop on Benchmarking: Past, Present and Future. https://doi.org/10.18653/v1/2021.bppf-1.3
- Freitag, M., Foster, G., Grangier, D., Ratnakar, V., Tan, Q., & Macherey, W. (2021). Experts, Errors, and Context: A Large-Scale Study of Human Evaluation for Machine Translation. Transactions of the Association for Computational Linguistics, 9, 1460–1474. https://doi.org/10.1162/tacl_a_00437
- Howcroft, D. M., Belz, A., Clinciu, M.-A., Gkatzia, D., Hasan, S. A., Mahamood, S., et al. (2020). Twenty Years of Confusion in Human Evaluation: NLG Needs Evaluation Sheets and Standardised Definitions. Proceedings of the 13th International Conference on Natural Language Generation, 169–182. https://doi.org/10.18653/v1/2020.inlg-1.23
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- Kocmi, T., Zouhar, V., Avramidis, E., Grundkiewicz, R., Karpinska, M., Popović, M., et al. (2024a). Error Span Annotation: A Balanced Approach for Human Evaluation of Machine Translation. Proceedings of the Ninth Conference on Machine Translation (WMT 2024), 1440–1453. https://doi.org/10.18653/v1/2024.wmt-1.131
- Sainz, O., Campos, J., García-Ferrero, I., Etxaniz, J., Lopez de Lacalle, O., & Agirre, E. (2023). NLP Evaluation in Trouble: On the Need to Measure LLM Data Contamination for Each Benchmark. Findings of the Association for Computational Linguistics: EMNLP 2023, 10776–10787. https://doi.org/10.18653/v1/2023.findings-emnlp.722
- Zheng, L., Chiang, W.-L., Sheng, Y., Zhuang, S., Wu, Z., Zhuang, Y., et al. (2023). Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena. Advances in Neural Information Processing Systems 36 (NeurIPS 2023), Datasets and Benchmarks Track. https://proceedings.neurips.cc/paper_files/paper/2023/hash/91f18a1287b398d378ef22505bf41832-Abstract-Datasets_and_Benchmarks.html