The token gap between languagesL'écart de jetons entre les langues
TRA6008 OptionalFacultatif
Where the bias comes from
You have seen how a tokenizer tokenization²jetonisation² language modelsmodèles de langue The process of converting text into an ordered sequence of tokens that a language model can process.Processus de conversion d'un texte en une séquence ordonnée de jetons qu'un modèle de langue peut traiter. builds its vocabulary vocabularyvocabulaire language modelsmodèles de langue The fixed set of tokens that a tokenizer and language model can recognize and represent.Ensemble fixe des jetons qu'un segmenteur et un modèle de langue peuvent reconnaître et représenter. : byte-pair encoding byte-pair encoding (BPE)encodage par paires d'octets language modelsmodèles de langue A subword tokenization method that learns a vocabulary from training text by repeatedly joining frequently occurring adjacent characters or bytes.Méthode de segmentation sous-lexicale qui apprend un vocabulaire à partir d'un texte d'entraînement en fusionnant de façon répétée les caractères ou octets adjacents fréquents. merges the character sequences that were frequent in the text it was trained on (see also the Tokenization chapter) (voir aussi le chapitre Jetonisation). That text is mostly English. So the sequences that became whole tokens are, for the most part, English words, and a French or Dutch word has to be rebuilt from fragments. The difference arises in the tokenizer, before the model has read anything.
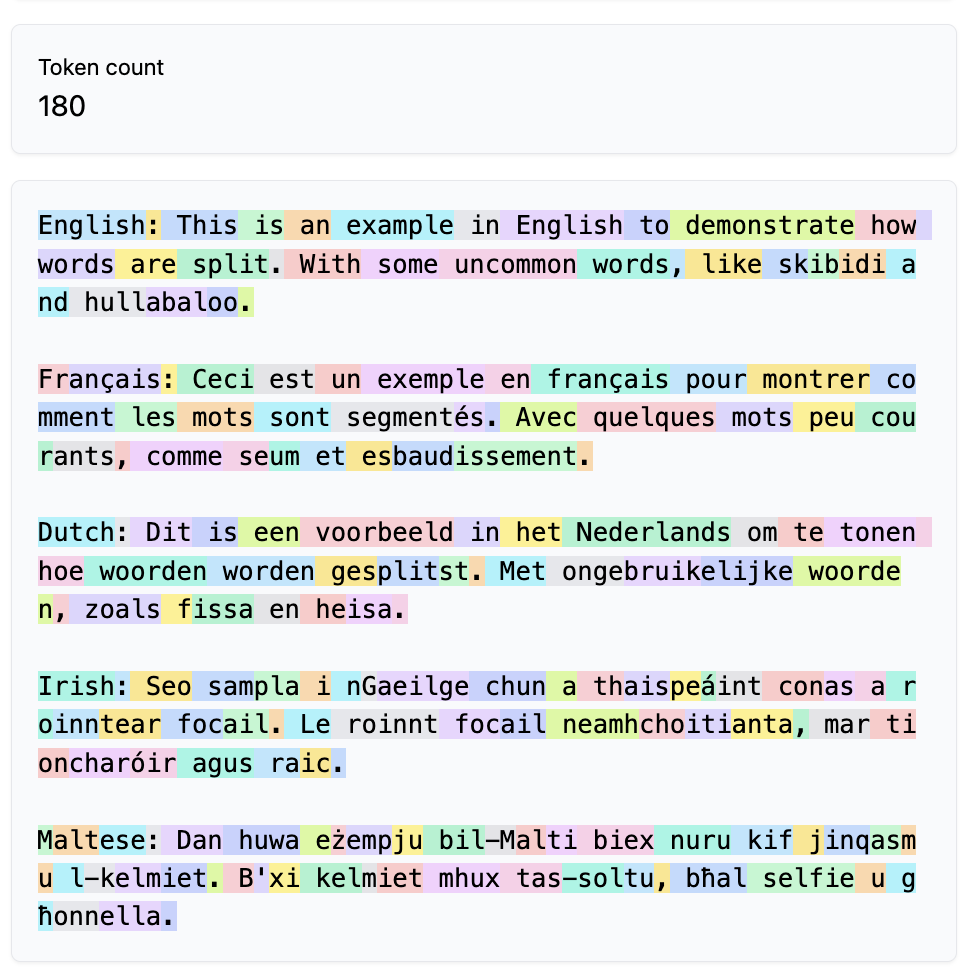
The sentences in the capture were written with two uncommon words each, so the gap they show is at the wide end. A longer text gives a smaller one, and the vocabulary makes a difference too.
Measured across two hundred languages
Petrov et al. (2023) measured the gap across 200 languages, on the same sentences translated by people into each of them, and the table below repeats their measurement on those sentences and adds the vocabulary OpenAI released in 2024, which GPT-4o and GPT-5 use. Every number is a multiple of the English count for the same 1,012 sentences: 1.37 means 37 % more than English, 7.93 means almost eight times as many.How the table was made: on 11 September 2026, the 1,012 sentences of the FLORES-200 test set test setjeu de données de test machine learningapprentissage automatique A portion of a dataset held back from both model training and model selection and used to evaluate the final model.Portion d'un jeu de données tenue à l'écart tant de l'entraînement que de la sélection du modèle et servant à évaluer le modèle final. Son but est d'estimer la performance du modèle achevé sur de nouvelles données issues de la tâche ou de la population visée. (NLLB Team et al., 2024), the parallel corpus parallel corpuscorpus parallèle corporacorpus A corpus of texts in one language together with their translations into one or more other languages, usually aligned sentence by sentence so that each segment can be viewed next to its equivalent.Corpus de textes dans une langue accompagnés de leurs traductions vers une ou plusieurs autres langues, généralement alignés phrase par phrase de façon à afficher chaque segment en regard de son équivalent. Petrov et al. used, were run through OpenAI’s tiktoken library under its three vocabularies, r50k_base (GPT-2, 2019), cl100k_base (GPT-4, 2022) and o200k_base (GPT-4o, 2024), and each language’s count was divided by the English one. The two older columns reproduce Petrov et al.’s Table 1 to within 0.02. Words are counted on spaces, which Chinese and Shan do not use.
| Language | Words, × English | Tokens, GPT-2 (2019), × English | Tokens, GPT-4 (2022), × English | Tokens, GPT-4o and GPT-5 (2024), × English |
|---|---|---|---|---|
| Portuguese | 1.07 | 1.93 | 1.48 | 1.23 |
| Dutch | 1.05 | 1.98 | 1.60 | 1.25 |
| German | 0.99 | 2.14 | 1.59 | 1.31 |
| French | 1.17 | 2.00 | 1.61 | 1.37 |
| Arabic | 0.90 | 4.36 | 3.03 | 1.38 |
| Chinese | 3.15 | 1.87 | 1.25 | |
| Shan | 18.69 | 14.98 | 7.93 |
As the results in the table show, English always remains considerably cheaper. Each new vocabulary has narrowed the gap, but none has closed it: under the 2024 vocabulary French still costs 37 % more tokens than English for the same content, and Shan eight times more. Petrov et al. (2023) also found the gap in tokenizers that were deliberately trained to be multilingual, so it is not a quirk of one company’s vocabulary. Nor is the narrowing guaranteed to continue: OpenAI has not said which vocabulary GPT-6 uses, so as of 11 September 2026 nothing can be measured for it, and a new vocabulary can also cost more, as Anthropic’s own documentation says of the tokenizer introduced with Claude Opus 4.7, which produces about 30 % more tokens than its predecessor on the same text.
The word column shows that part of the French gap is French itself, which takes more words than English to say the same thing; the rest is the tokenizer cutting those words into more pieces. German comes out with slightly fewer words than English because of how the language is built: where English writes a compound as two or three words, German writes one, and each of those long words is then cut into several tokens. Chinese and Shan have no word count at all, because both are written without spaces between words, so the concept of a “word” is too different there to be comparable (see also the Tokenization (including an example of the rule-based approach) chapter, in the Classical NLP module) (voir aussi le chapitre La segmentation en unités lexicales (y compris un exemple d'approche à base de règles), dans le module TAL classique).
Consequences of less efficient tokenization
Petrov et al. (2023) name three consequences, each with a direct impact for users:
- Money. A service reached through an API application programming interface (API)interface de programmation d'application (API) computinginformatique A standardized interface that allows software applications to communicate by sending requests and receiving responses, without needing to know how the other application works internally.Interface normalisée qui permet à des applications logicielles de communiquer en envoyant des demandes et en recevant des réponses, sans avoir à connaître le fonctionnement interne de l'autre application. charges by the token, so the same request costs more in a language that is cut into more pieces.
- Time. Processing time grows with the number of tokens.
- Space. The context window context windowfenêtre contextuelle language modelsmodèles de langue "The amount of input (like text) that an AI system can process at one time during a task. Think of it as a model's short-term memory. A model can only consider so much text when generating its next response, and once the conversation exceeds its context window, the model starts 'forgetting' prior responses." (Stanford HAI).Quantité d'entrée (du texte, par exemple) qu'un système d'IA peut traiter à la fois pendant une tâche ; en quelque sorte, la mémoire à court terme du modèle. Un modèle ne peut considérer qu'une quantité limitée de texte pour générer sa prochaine réponse et, quand la conversation dépasse sa fenêtre contextuelle, il commence à « oublier » les réponses antérieures (d'après Stanford HAI, traduction libre). is a fixed number of tokens, so a text that fits in English may not fit in its translation.
A fourth consequence is not in their list, but has since also been proven:
- Quality. A token that is a whole word, or a meaningful piece of one, gives the model a better unit to build its representations on than a fragment cut by frequency, so a language whose words are broken into fragments is harder to learn from. Training the same model with tokenizers that compress text more or less shows the correlation: the more compact the tokenization, the better the model performs afterwards, most clearly on generation tasks (Goldman et al., 2024). The same is true across languages. Ali et al. (2024) trained the same LLM on English, German, French, Italian and Spanish twice, once with an English-centric tokenizer and once with a tokenizer built for all five languages. With the English-centric tokenizer, the model performed markedly worse in the four other languages, and its training cost up to 68 % more, because every non-English text was longer.
The token gap is one of several ways the dominance of English in the training data training setjeu de données d'entraînement machine learningapprentissage automatique The portion of a dataset used to train a machine-learning model.Portion d'un jeu de données servant à entraîner un modèle d'apprentissage automatique. affects every other language (see also the Bias chapter, in the Critical issues with LLMs module) (voir aussi le chapitre Biais, dans le module Enjeux critiques des GML).
D’où vient l’écart
Vous avez vu comment un segmenteur tokenization²jetonisation² language modelsmodèles de langue The process of converting text into an ordered sequence of tokens that a language model can process.Processus de conversion d'un texte en une séquence ordonnée de jetons qu'un modèle de langue peut traiter. construit son vocabulaire vocabularyvocabulaire language modelsmodèles de langue The fixed set of tokens that a tokenizer and language model can recognize and represent.Ensemble fixe des jetons qu'un segmenteur et un modèle de langue peuvent reconnaître et représenter. : l’encodage par paires d’octets byte-pair encoding (BPE)encodage par paires d'octets language modelsmodèles de langue A subword tokenization method that learns a vocabulary from training text by repeatedly joining frequently occurring adjacent characters or bytes.Méthode de segmentation sous-lexicale qui apprend un vocabulaire à partir d'un texte d'entraînement en fusionnant de façon répétée les caractères ou octets adjacents fréquents. fusionne les suites de caractères qui étaient fréquentes dans les textes sur lesquels il a été entraîné (see also the Tokenization chapter) (voir aussi le chapitre Jetonisation). Ces textes sont surtout en anglais. Les suites devenues des jetons entiers sont donc, pour la plupart, des mots anglais, et un mot français ou néerlandais doit être reconstruit à partir de fragments. L’écart naît dans le segmenteur, avant que le modèle ait lu quoi que ce soit.
Les phrases de la capture ont été écrites avec deux mots peu courants chacune, de sorte que l’écart qu’elles montrent est dans le haut de la fourchette. Un texte plus long en donne un plus petit, et le vocabulaire fait aussi une différence.
Mesuré sur deux cents langues
Petrov et al. (2023) ont mesuré l’écart sur 200 langues, sur les mêmes phrases traduites par des personnes dans chacune d’elles, et le tableau ci-dessous reprend leur mesure sur ces phrases en y ajoutant le vocabulaire publié par OpenAI en 2024, celui de GPT-4o et de GPT-5. Chaque nombre est un multiple du compte anglais pour les mêmes 1 012 phrases : 1,37 veut dire 37 % de plus que l’anglais, 7,93 presque huit fois plus.Comment le tableau a été fait : le 11 septembre 2026, les 1 012 phrases du jeu de test test setjeu de données de test machine learningapprentissage automatique A portion of a dataset held back from both model training and model selection and used to evaluate the final model.Portion d'un jeu de données tenue à l'écart tant de l'entraînement que de la sélection du modèle et servant à évaluer le modèle final. Son but est d'estimer la performance du modèle achevé sur de nouvelles données issues de la tâche ou de la population visée. FLORES-200 (NLLB Team et al., 2024), le corpus parallèle parallel corpuscorpus parallèle corporacorpus A corpus of texts in one language together with their translations into one or more other languages, usually aligned sentence by sentence so that each segment can be viewed next to its equivalent.Corpus de textes dans une langue accompagnés de leurs traductions vers une ou plusieurs autres langues, généralement alignés phrase par phrase de façon à afficher chaque segment en regard de son équivalent. utilisé par Petrov et al., ont été passées dans la bibliothèque tiktoken d’OpenAI sous ses trois vocabulaires, r50k_base (GPT-2, 2019), cl100k_base (GPT-4, 2022) et o200k_base (GPT-4o, 2024), et le compte de chaque langue a été divisé par celui de l’anglais. Les deux colonnes les plus anciennes reproduisent le tableau 1 de Petrov et al. à 0,02 près. Les mots sont comptés sur les espaces, que le chinois et le shan n’utilisent pas.
| Langue | Mots, × anglais | Jetons, GPT-2 (2019), × anglais | Jetons, GPT-4 (2022), × anglais | Jetons, GPT-4o et GPT-5 (2024), × anglais |
|---|---|---|---|---|
| Portugais | 1,07 | 1,93 | 1,48 | 1,23 |
| Néerlandais | 1,05 | 1,98 | 1,60 | 1,25 |
| Allemand | 0,99 | 2,14 | 1,59 | 1,31 |
| Français | 1,17 | 2,00 | 1,61 | 1,37 |
| Arabe | 0,90 | 4,36 | 3,03 | 1,38 |
| Chinois | 3,15 | 1,87 | 1,25 | |
| Shan | 18,69 | 14,98 | 7,93 |
Comme le montrent les résultats du tableau, l’anglais reste toujours nettement moins cher. Chaque nouveau vocabulaire a réduit l’écart, mais aucun ne l’a comblé : sous le vocabulaire de 2024, le français coûte encore 37 % de jetons de plus que l’anglais pour le même contenu, et le shan huit fois plus. Petrov et al. (2023) ont aussi trouvé l’écart dans des segmenteurs entraînés délibérément pour être multilingues ; ce n’est donc pas une particularité du vocabulaire d’une seule entreprise. Rien ne garantit non plus que le rétrécissement continue : OpenAI n’a pas dit quel vocabulaire GPT-6 utilise, si bien qu’au 11 septembre 2026 rien ne peut être mesuré pour lui, et un nouveau vocabulaire peut aussi coûter plus cher, comme la documentation d’Anthropic le dit du segmenteur introduit avec Claude Opus 4.7, qui produit environ 30 % de jetons de plus que son prédécesseur sur le même texte.
La colonne des mots montre qu’une partie de l’écart du français tient au français lui-même, qui prend plus de mots que l’anglais pour dire la même chose ; le reste vient du segmenteur, qui découpe ces mots en plus de morceaux. L’allemand ressort avec un peu moins de mots que l’anglais à cause de la façon dont la langue est construite : là où l’anglais écrit un mot composé en deux ou trois mots, l’allemand en écrit un seul, et chacun de ces longs mots est ensuite découpé en plusieurs jetons. Le chinois et le shan n’ont pas de compte de mots du tout, parce que les deux s’écrivent sans espaces entre les mots, de sorte que la notion de « mot » y est trop différente pour être comparable (see also the Tokenization (including an example of the rule-based approach) chapter, in the Classical NLP module) (voir aussi le chapitre La segmentation en unités lexicales (y compris un exemple d'approche à base de règles), dans le module TAL classique).
Conséquences d’une jetonisation moins efficace
Petrov et al. (2023) nomment trois conséquences, chacune avec un effet direct pour les utilisateurs :
- L’argent. Un service atteint par une interface de programmation d’application application programming interface (API)interface de programmation d'application (API) computinginformatique A standardized interface that allows software applications to communicate by sending requests and receiving responses, without needing to know how the other application works internally.Interface normalisée qui permet à des applications logicielles de communiquer en envoyant des demandes et en recevant des réponses, sans avoir à connaître le fonctionnement interne de l'autre application. (API) facture au jeton ; la même demande coûte donc plus cher dans une langue découpée en plus de morceaux.
- Le temps. Le temps de traitement croît avec le nombre de jetons.
- L’espace. La fenêtre contextuelle context windowfenêtre contextuelle language modelsmodèles de langue "The amount of input (like text) that an AI system can process at one time during a task. Think of it as a model's short-term memory. A model can only consider so much text when generating its next response, and once the conversation exceeds its context window, the model starts 'forgetting' prior responses." (Stanford HAI).Quantité d'entrée (du texte, par exemple) qu'un système d'IA peut traiter à la fois pendant une tâche ; en quelque sorte, la mémoire à court terme du modèle. Un modèle ne peut considérer qu'une quantité limitée de texte pour générer sa prochaine réponse et, quand la conversation dépasse sa fenêtre contextuelle, il commence à « oublier » les réponses antérieures (d'après Stanford HAI, traduction libre). est un nombre fixe de jetons ; un texte qui tient en anglais peut donc ne pas tenir dans sa traduction.
Une quatrième conséquence ne figure pas dans leur liste, mais a depuis été démontrée elle aussi :
- La qualité. Un jeton qui est un mot entier, ou un morceau de mot porteur de sens, donne au modèle une meilleure unité sur laquelle construire ses représentations qu’un fragment découpé selon la fréquence ; une langue dont les mots sont brisés en fragments est donc plus difficile à apprendre. Entraîner le même modèle avec des segmenteurs qui compriment plus ou moins le texte montre la corrélation : plus la jetonisation est compacte, mieux le modèle se comporte ensuite, le plus nettement sur les tâches de génération (Goldman et al., 2024). La même chose vaut d’une langue à l’autre. Ali et al. (2024) ont entraîné le même GML sur l’anglais, l’allemand, le français, l’italien et l’espagnol deux fois, une fois avec un segmenteur centré sur l’anglais et une fois avec un segmenteur construit pour les cinq langues. Avec le segmenteur centré sur l’anglais, le modèle s’est montré nettement moins bon dans les quatre autres langues, et son entraînement a coûté jusqu’à 68 % de plus, parce que chaque texte non anglais était plus long.
L’écart de jetons est l’une des façons dont la domination de l’anglais dans les données d’entraînement training setjeu de données d'entraînement machine learningapprentissage automatique The portion of a dataset used to train a machine-learning model.Portion d'un jeu de données servant à entraîner un modèle d'apprentissage automatique. touche toutes les autres langues (see also the Bias chapter, in the Critical issues with LLMs module) (voir aussi le chapitre Biais, dans le module Enjeux critiques des GML).
Sources
- Ali, M., Fromm, M., Thellmann, K., Rutmann, R., Lübbering, M., et al. (2024). Tokenizer Choice For LLM Training: Negligible or Crucial?. Findings of the Association for Computational Linguistics: NAACL 2024, 3907–3924. https://aclanthology.org/2024.findings-naacl.247/
- Goldman, O., Caciularu, A., Eyal, M., Cao, K., Szpektor, I., & Tsarfaty, R. (2024). Unpacking Tokenization: Evaluating Text Compression and its Correlation with Model Performance. Findings of the Association for Computational Linguistics: ACL 2024, 2274–2286. https://aclanthology.org/2024.findings-acl.134/
- NLLB Team, Costa-jussà, M. R., Cross, J., Çelebi, O., Elbayad, M., et al. (2024). Scaling neural machine translation to 200 languages. Nature, 630, 841–846. https://doi.org/10.1038/s41586-024-07335-x
- Petrov, A., La Malfa, E., Torr, P., & Bibi, A. (2023). Language Model Tokenizers Introduce Unfairness Between Languages. Advances in Neural Information Processing Systems 36 (NeurIPS 2023). https://proceedings.neurips.cc/paper_files/paper/2023/hash/74bb24dca8334adce292883b4b651eda-Abstract-Conference.html