What natural language processing doesCe que fait le traitement automatique de la langue
TRA2600 S5 · in classS5 · en classe
The field behind the tools you use
Your word processor underlines a misspelled word. Your phone proposes the rest of the word you are typing. A search engine returns pages that say what you asked in other words. A video gets subtitles in a language its speakers do not know. Behind each of these is a program that takes human language as its input, as text or as speech, and does something with it. The field that builds such programs is natural language processing.
Two neighbouring names, computational linguistics computational linguistics (CL)linguistique informatique NLPTAL The interdisciplinary study of human language from a computational perspective, including the development of computational models of linguistic phenomena.Étude interdisciplinaire du langage humain dans une perspective computationnelle, y compris l'élaboration de modèles computationnels des phénomènes linguistiques. and language technology language technologytechnologie langagière NLPTAL The field that builds usable tools and services out of the computational processing of human language, such as machine translation systems, terminology tools, speech interfaces and writing aids. By extension, the term also names those tools themselves.Domaine consacré à la conception d'outils et de services utilisables à partir du traitement informatique de la langue humaine : systèmes de traduction automatique, outils terminologiques, interfaces vocales, aides à la rédaction. Par extension, le terme désigne aussi ces outils eux-mêmes. , cover much the same field with a different emphasis (see also the NLP and its neighbours page, in the Foundations of AI & NLP module) (voir aussi la page Le TAL et ses voisins, dans le module Fondements de l'IA et du TAL).
A field organized in tasks
For most of the history of the field, a program could not be asked to “understand a text”. It could be asked to do one defined thing with it, and over the decades the field has settled on a set of such things, called tasks. A task has a defined input and a defined output. For named entity recognition named entity recognition (NER)reconnaissance d'entités nommées (REN) NLPTAL The task of finding the spans of a text that are proper names, and labelling the category, most often a person, a location or an organization.Tâche qui consiste à repérer dans un texte les segments qui sont des noms propres, et à en étiqueter la catégorie, le plus souvent une personne, un lieu ou une organisation. , the input is a text and the output is the list of stretches that are proper names, each with its type. For machine translation machine translation (MT)traduction automatique (TA) translationtraduction The use of a computer system to produce content in a target language that conveys content expressed in a source language.Utilisation d'un système informatique pour produire, dans une langue cible, un contenu qui rend un contenu exprimé dans une langue source. , the input is a sentence in one language and the output is a sentence in another. A precisely defined output makes it possible to say whether a program did the task well, and to compare two programs on it (see also the Evaluation foundations chapter, in the Evaluating language technology module) (voir aussi le chapitre Fondements de l'évaluation, dans le module L'évaluation des technologies langagières).
Tasks that read a text and return something found in it, or a label for it, are grouped under natural language understanding (NLU; in French, compréhension du langage naturel). Tasks that produce new text are grouped under natural language generation (NLG; génération automatique de textes, GAT). Tasks on speech take spoken language in or give it out (Figure 1figure 1).
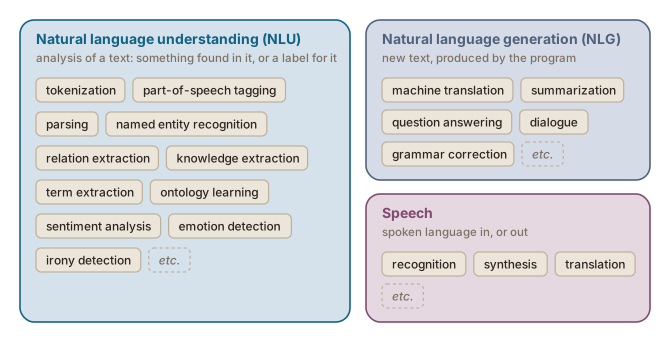
The two groups overlap: a translation system has to read before it writes, and a chatbot does both at every turn.
Tasks inside everyday tools
Most of these tasks are already in the tools you use, where you do not see them as tasks:
- the spelling checker and the grammar checker in a word processor;
- the segmentation segmentationsegmentation CAT toolsTAO The operation of dividing translatable content into segments, which correspond roughly to sentences, titles and other separate text elements.Opération qui consiste à diviser le contenu à traduire en segments, qui correspondent plus ou moins aux phrases, aux titres et aux autres éléments textuels séparés. of a document into sentences and the terminology checks of a CAT tool computer-assisted translation (CAT)traduction assistée par ordinateur (TAO) CAT toolsTAO Software that assists a human translator during the translation process, commonly by dividing texts into segments and providing functions such as translation-memory retrieval, terminology management, consistency checks and file management.Logiciel qui assiste un traducteur humain pendant le processus de traduction, généralement en divisant les textes en segments et en offrant des fonctions comme la recherche en mémoire de traduction, la gestion terminologique, les vérifications de cohérence et la gestion des fichiers. (see also the Wordfast: quality assurance and delivery chapter, in the CAT tools module) (voir aussi le chapitre Wordfast : assurance de la qualité et livraison, dans le module Outils de TAO);
- the lemmatized word lists and the searches by grammatical class of a concordancer (see also the Corpus analysis module) (voir aussi le module L'analyse de corpus);
- the dictation that types what you say (see also the Speech technology module) (voir aussi le module Les technologies de la parole);
- machine translation itself, and the extraction of terms from a text or a collection of documents (see also the Automatic term extraction (from rules to large language models) chapter) (voir aussi le chapitre Extraction automatique de termes (des règles aux grands modèles de langue)).
Before large language models large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. , every one of these tasks raised the same question: how do you turn something people do by intuition into something a program can measure?
Le domaine derrière les outils du quotidien
Votre traitement de texte souligne un mot mal orthographié. Votre téléphone propose la fin du mot que vous tapez. Un moteur de recherche renvoie des pages qui disent ce que vous avez demandé en d’autres mots. Une vidéo reçoit des sous-titres dans une langue que ses locuteurs ne connaissent pas. Derrière chacun de ces cas se trouve un programme qui prend la langue humaine en entrée, à l’écrit ou à l’oral, et en fait quelque chose. Le domaine qui conçoit ces programmes est le traitement automatique de la langue.
Deux noms voisins, la linguistique informatique computational linguistics (CL)linguistique informatique NLPTAL The interdisciplinary study of human language from a computational perspective, including the development of computational models of linguistic phenomena.Étude interdisciplinaire du langage humain dans une perspective computationnelle, y compris l'élaboration de modèles computationnels des phénomènes linguistiques. et les technologies langagières language technologytechnologie langagière NLPTAL The field that builds usable tools and services out of the computational processing of human language, such as machine translation systems, terminology tools, speech interfaces and writing aids. By extension, the term also names those tools themselves.Domaine consacré à la conception d'outils et de services utilisables à partir du traitement informatique de la langue humaine : systèmes de traduction automatique, outils terminologiques, interfaces vocales, aides à la rédaction. Par extension, le terme désigne aussi ces outils eux-mêmes. , désignent à peu près le même domaine, avec un accent différent (see also the NLP and its neighbours page, in the Foundations of AI & NLP module) (voir aussi la page Le TAL et ses voisins, dans le module Fondements de l'IA et du TAL).
Un domaine organisé en tâches
Pendant la plus grande partie de l’histoire du domaine, on ne pouvait pas demander à un programme de « comprendre un texte ». On pouvait lui demander de faire une chose définie avec ce texte, et, au fil des décennies, le domaine s’est fixé un ensemble de ces choses, appelées tâches. Une tâche a une entrée et une sortie définies. Pour la reconnaissance d’entités nommées named entity recognition (NER)reconnaissance d'entités nommées (REN) NLPTAL The task of finding the spans of a text that are proper names, and labelling the category, most often a person, a location or an organization.Tâche qui consiste à repérer dans un texte les segments qui sont des noms propres, et à en étiqueter la catégorie, le plus souvent une personne, un lieu ou une organisation. , l’entrée est un texte et la sortie, la liste des passages qui sont des noms propres, chacun avec son type. Pour la traduction automatique machine translation (MT)traduction automatique (TA) translationtraduction The use of a computer system to produce content in a target language that conveys content expressed in a source language.Utilisation d'un système informatique pour produire, dans une langue cible, un contenu qui rend un contenu exprimé dans une langue source. , l’entrée est une phrase dans une langue et la sortie, une phrase dans une autre. Une sortie définie avec précision permet de dire si un programme a bien accompli la tâche et de comparer deux programmes sur celle-ci (see also the Evaluation foundations chapter, in the Evaluating language technology module) (voir aussi le chapitre Fondements de l'évaluation, dans le module L'évaluation des technologies langagières).
Les tâches qui lisent un texte et renvoient quelque chose qui s’y trouve, ou une étiquette qui le décrit, sont regroupées sous la compréhension du langage naturel (angl. natural language understanding, NLU). Les tâches qui produisent un texte nouveau relèvent de la génération automatique de textes (GAT, angl. natural language generation, NLG). Les tâches sur la parole prennent la langue orale en entrée ou la produisent (Figure 1figure 1).
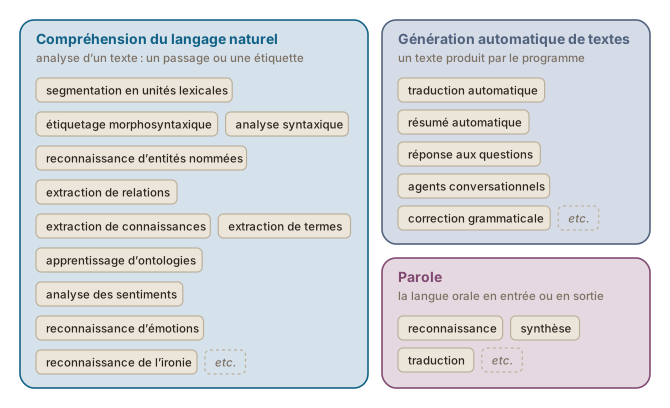
Les deux groupes se recoupent : un système de traduction doit lire avant d’écrire, et un agent conversationnel fait les deux à chaque échange.
Des tâches dans les outils du quotidien
La plupart de ces tâches se trouvent déjà dans les outils que vous utilisez, où vous ne les voyez pas comme des tâches :
- le correcteur orthographique et le correcteur grammatical d’un traitement de texte ;
- la segmentation segmentationsegmentation CAT toolsTAO The operation of dividing translatable content into segments, which correspond roughly to sentences, titles and other separate text elements.Opération qui consiste à diviser le contenu à traduire en segments, qui correspondent plus ou moins aux phrases, aux titres et aux autres éléments textuels séparés. d’un document en phrases et les vérifications terminologiques d’un outil de TAO computer-assisted translation (CAT)traduction assistée par ordinateur (TAO) CAT toolsTAO Software that assists a human translator during the translation process, commonly by dividing texts into segments and providing functions such as translation-memory retrieval, terminology management, consistency checks and file management.Logiciel qui assiste un traducteur humain pendant le processus de traduction, généralement en divisant les textes en segments et en offrant des fonctions comme la recherche en mémoire de traduction, la gestion terminologique, les vérifications de cohérence et la gestion des fichiers. (see also the Wordfast: quality assurance and delivery chapter, in the CAT tools module) (voir aussi le chapitre Wordfast : assurance de la qualité et livraison, dans le module Outils de TAO) ;
- les listes de mots lemmatisés et les recherches par catégorie grammaticale d’un concordancier (see also the Corpus analysis module) (voir aussi le module L'analyse de corpus) ;
- la dictée qui tape ce que vous dites (see also the Speech technology module) (voir aussi le module Les technologies de la parole) ;
- la traduction automatique elle-même, et l’extraction de termes d’un texte ou d’un ensemble de documents (see also the Automatic term extraction (from rules to large language models) chapter) (voir aussi le chapitre Extraction automatique de termes (des règles aux grands modèles de langue)).
Avant les grands modèles de langue large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. (GML), chacune de ces tâches posait la même question : comment transformer ce que les gens font par intuition en quelque chose qu’un programme peut mesurer ?
Sources
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Sources
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/