Families, generations and tiersFamilles, générations et niveaux
TRA6008 S3 · in classS3 · en classe
Choice 1: provider and model family
When you open ChatGPT rather than Claude or Gemini, you have already chosen a family of models: one provider’s models, trained on that provider’s data and shaped by its fine-tuning fine-tuningaffinage machine learningapprentissage automatique Further training of a pretrained model on new data to adapt it for a particular task, domain, or intended behaviour.Poursuite de l'entraînement d'un modèle préentraîné sur un jeu de données généralement plus restreint et spécialisé, afin de l'adapter à une tâche ou à un domaine particulier. . Models of different families differ in tone, in what they decline and in what they are good at.
Almost every provider offers a single family, so choosing a family is choosing a provider. Performance is only one of the things that decide it:
- performance on the tasks you have;
- price;
- privacy and confidentiality: what the provider may do with your text (see also the Training, retention and privacy settings page) (voir aussi la page Entraînement, conservation et paramètres de confidentialité);
- the company: your opinion of it and of how it behaves.
Who leads the field
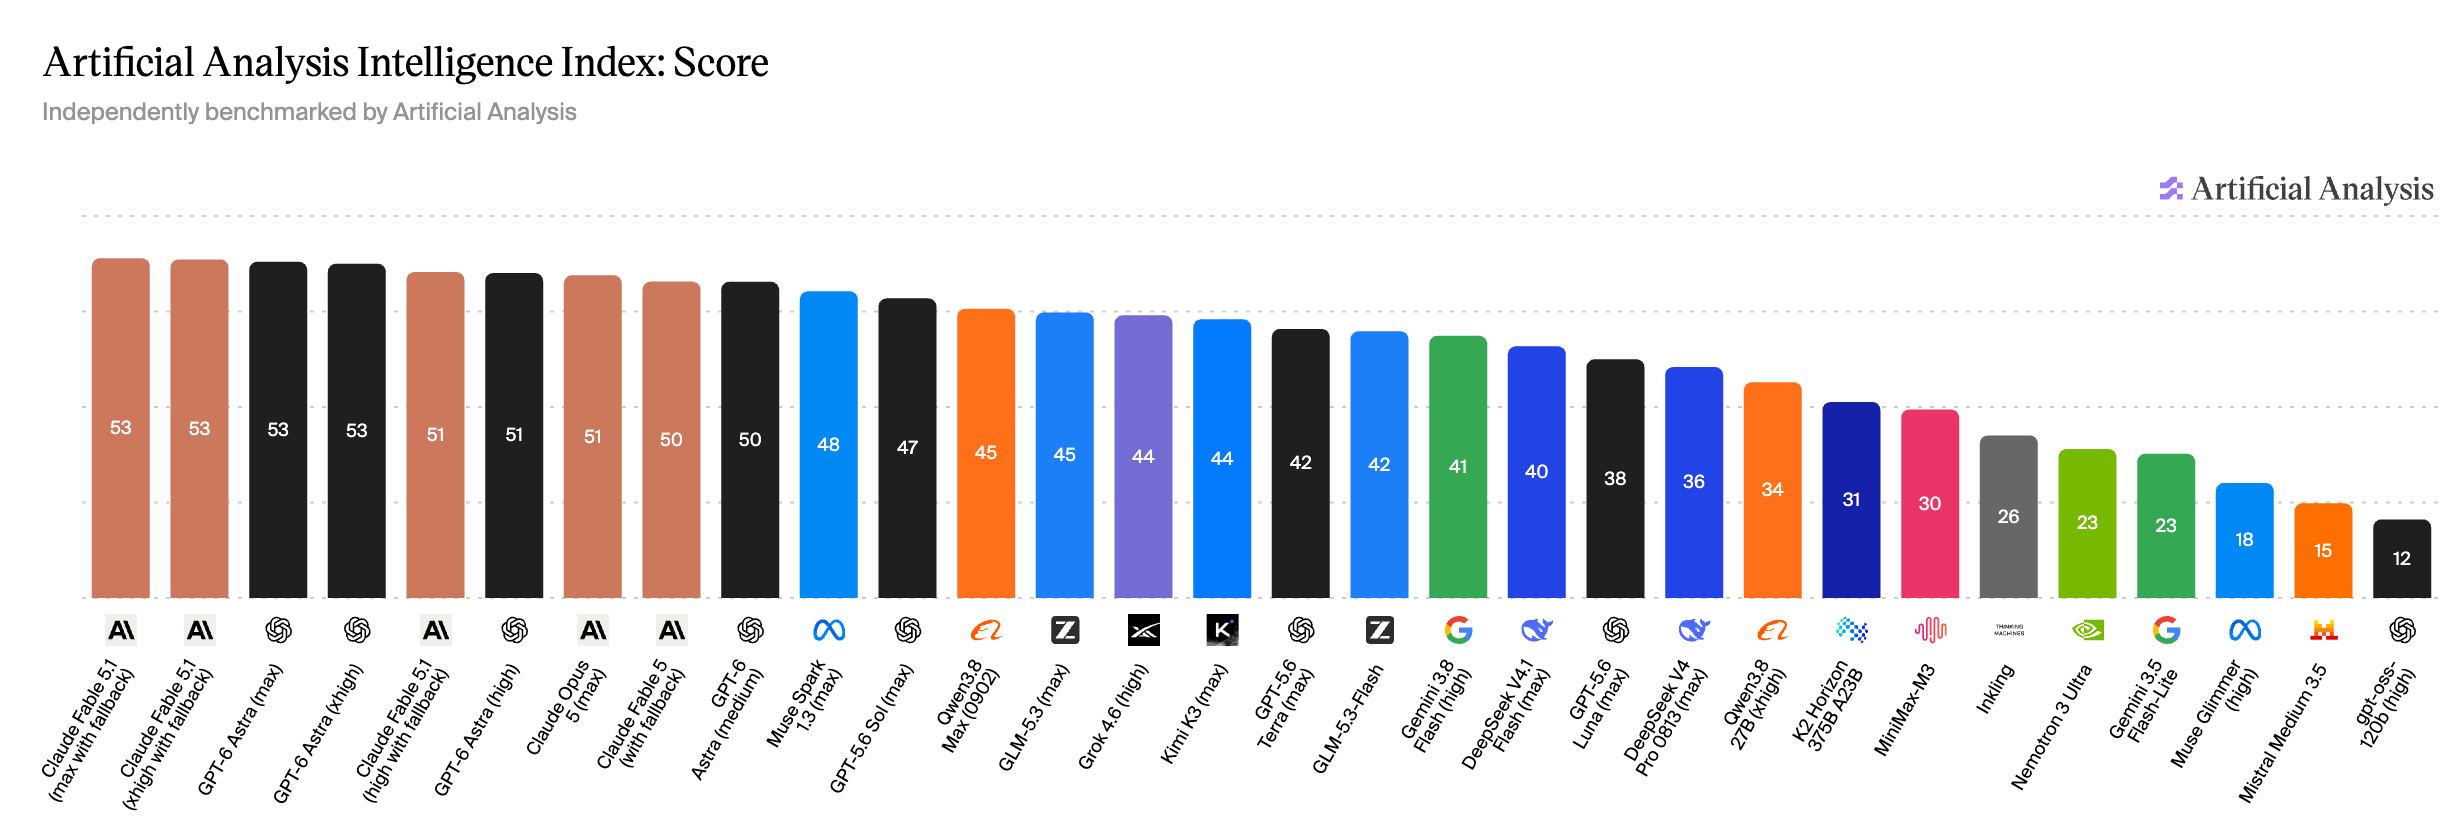
At the time of writing, two providers lead the field, Anthropic and OpenAI, and no other provider offers models at quite the same level. On 17 September 2026, for instance, the nine highest scores on the Artificial Analysis Intelligence Index all went to Anthropic and OpenAI models (Figure 1figure 1). The index combines ten demanding tests that the company runs itself.Artificial Analysis, Artificial Analysis Intelligence Index, version 4.3, read 17 September 2026: “a composite benchmark aggregating ten challenging evaluations”, covering mathematics, science, coding and reasoning, “conducted independently by Artificial Analysis”.
A ranking of this kind comes with two caveats:
- It is a snapshot. It changes with every release, and the index page shows the current one.
- The top is not always needed. For many tasks, a model a little behind the leaders also gives good results (see also the LLM leaderboards chapter) (voir aussi le chapitre Les classements de GML).
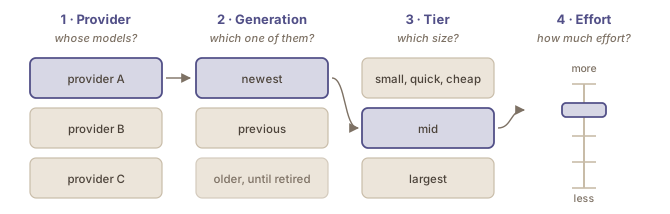
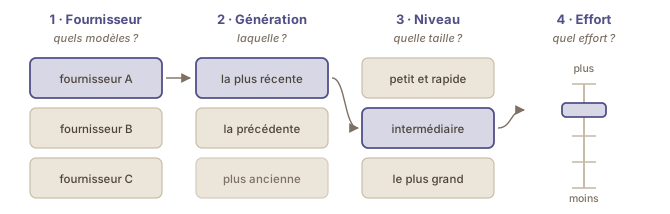
Once you have selected a provider, there are further choices to make, and the provider may make some of them for you. Figure 2figure 2 shows all four. The generation and the tier are discussed below, and effort has a page of its own (see also the Execution “effort” page) (voir aussi la page L'« effort » d'exécution).
Choice 2: generation (if more than one is offered)
A family is a succession of models rather than one model, and the succession is not always tidy: OpenAI, for instance, released GPT-4.5 before GPT-4.1 (Figure 3figure 3).
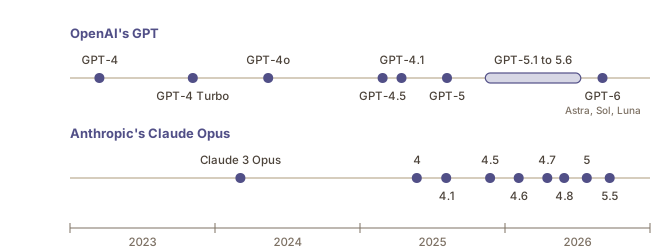
Releases have also come ever closer together. Fourteen months passed between Claude 3 Opus and Claude Opus 4; after that, Anthropic released seven more Opus models in sixteen months, and OpenAI went from GPT-5.1 to GPT-5.6 in eight. What you read about a model therefore goes out of date sooner than it used to.
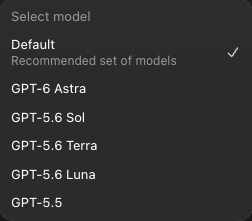
Older generations usually stay available for a while, so the list you choose from mixes generations with tiers.
Two things are relevant to keep in mind regarding these generations:
- Anything you read about a named model is about one generation. A study that tested GPT-4, or a colleague’s verdict on a model retired last year, may describe something no longer running anywhere.
- Tier names are often used across generations. The same word names a different model each time, so a claim about Claude Opus or about Claude Sonnet means something only with the generation attached. Write down the exact model name and the date whenever you rely on a result.
Choice 3: tier
Inside one generation, providers often offer several models of different sizes, for example:
- a small one, quick and cheap;
- one or two in between;
- the largest, which answers the most slowly and costs the most, in money, in waiting and in energy (see also the Environmental impact chapter, in the Critical issues with LLMs module) (voir aussi le chapitre Impact environnemental, dans le module Enjeux critiques des GML), and does best on work that is hard.
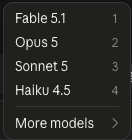
In a model list, generations and tiers appear side by side (Figure 4figure 4 and Figure 5figure 5). Whether you can pick the tier yourself depends on the product and on your plan, which is set out beside the effort settings (see also the Execution “effort” page) (voir aussi la page L'« effort » d'exécution). This page only describes the choices; which tier suits which task is a separate question (see also the Which model for which task page) (voir aussi la page Quel modèle pour quelle tâche).
Which of these choices changes the most
Most people choose the family once, keep whatever tier and effort they are given and never look at the rest. Any of the four choices can change your results considerably, and which one counts most depends on the task and on the models available at the time.
If you use these tools regularly and are sometimes disappointed with the results, it is worth experimenting with the tier and with the effort level reasoning efforteffort de raisonnement language modelsmodèles de langue A setting that controls how much computation a model spends on an answer, which in practice means how many tokens it generates.Paramètre qui détermine la quantité de calcul qu'un modèle consacre à une réponse, c'est-à-dire, en pratique, le nombre de jetons qu'il génère. , even if you do not want to switch providers.
Choix 1 : fournisseur et famille de modèles
Lorsque vous ouvrez ChatGPT plutôt que Claude ou Gemini, vous avez déjà choisi une famille de modèles : les modèles d’un fournisseur, entraînés sur les données de ce fournisseur et façonnés par son affinage fine-tuningaffinage machine learningapprentissage automatique Further training of a pretrained model on new data to adapt it for a particular task, domain, or intended behaviour.Poursuite de l'entraînement d'un modèle préentraîné sur un jeu de données généralement plus restreint et spécialisé, afin de l'adapter à une tâche ou à un domaine particulier. . Les modèles de familles différentes diffèrent par le ton, par ce qu’ils refusent de faire et par ce qu’ils font bien.
Presque tous les fournisseurs proposent une seule famille : choisir la famille revient donc à choisir le fournisseur. La performance des modèles n’est qu’un des éléments de ce choix :
- la performance sur vos tâches ;
- le prix ;
- la protection de la vie privée et la confidentialité : ce que le fournisseur peut faire de votre texte (see also the Training, retention and privacy settings page) (voir aussi la page Entraînement, conservation et paramètres de confidentialité) ;
- l’entreprise : ce que vous pensez d’elle et de sa conduite.
Qui domine le domaine
Au moment d’écrire ces lignes, deux fournisseurs dominent le domaine, Anthropic et OpenAI, et aucun autre ne propose de modèles tout à fait du même niveau. Le 17 septembre 2026, par exemple, les neuf meilleurs scores de l’Artificial Analysis Intelligence Index revenaient tous à des modèles d’Anthropic et d’OpenAI (Figure 1figure 1). L’indice combine dix tests exigeants menés par l’entreprise elle-même.Artificial Analysis, Artificial Analysis Intelligence Index, version 4.3, consulté le 17 septembre 2026 : « a composite benchmark aggregating ten challenging evaluations », qui porte sur les mathématiques, les sciences, la programmation et le raisonnement, avec des évaluations « conducted independently by Artificial Analysis ».
Un tel classement appelle deux réserves :
- Il ne vaut qu’au moment où il est consulté. Il change à chaque nouvelle version, et la page de l’indice présente le classement à jour.
- Le sommet n’est pas toujours nécessaire. Pour bien des tâches, un modèle un peu en retrait des meilleurs donne aussi de bons résultats (see also the LLM leaderboards chapter) (voir aussi le chapitre Les classements de GML).
Une fois le fournisseur choisi, il reste d’autres choix à faire, et le fournisseur peut en faire certains à votre place. La Figure 2figure 2 montre les quatre. La génération et le niveau sont présentés plus bas, et l’effort a sa propre page (see also the Execution “effort” page) (voir aussi la page L'« effort » d'exécution).
Choix 2 : génération (si plusieurs sont proposées)
Une famille est une succession de modèles plutôt qu’un seul modèle, et cette succession n’est pas toujours ordonnée : OpenAI, par exemple, a publié GPT-4.5 avant GPT-4.1 (Figure 3figure 3).
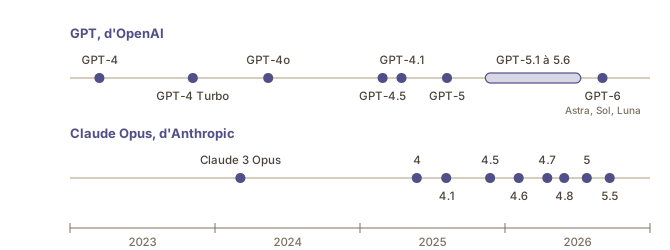
Les nouvelles versions paraissent aussi de plus en plus rapprochées. Quatorze mois ont séparé Claude 3 Opus de Claude Opus 4 ; Anthropic a ensuite publié sept autres modèles Opus en seize mois, et OpenAI est passée de GPT-5.1 à GPT-5.6 en huit mois. Ce que vous lisez sur un modèle est donc dépassé plus vite qu’auparavant.
Les anciennes générations restent généralement disponibles pendant un certain temps, si bien que la liste proposée mélange générations et niveaux.
Deux choses sont à garder à l’esprit au sujet de ces générations :
- Tout ce que vous lisez sur un modèle nommé porte sur une seule génération. Une étude qui a testé GPT-4, ou l’avis d’un collègue sur un modèle retiré l’an dernier, peut décrire quelque chose qui ne fonctionne plus nulle part.
- Les noms de niveaux sont souvent repris d’une génération à l’autre. Le même mot désigne chaque fois un modèle différent : une affirmation sur Claude Opus ou sur Claude Sonnet n’a de sens que si la génération est précisée. Notez le nom exact du modèle et la date dès qu’un résultat compte.
Choix 3 : niveau
Dans une même génération, les fournisseurs proposent souvent plusieurs modèles de tailles différentes, par exemple :
- un petit modèle, rapide et économique ;
- un ou deux intermédiaires ;
- le plus grand, qui répond le plus lentement et coûte le plus cher, en argent, en attente et en énergie (see also the Environmental impact chapter, in the Critical issues with LLMs module) (voir aussi le chapitre Impact environnemental, dans le module Enjeux critiques des GML), et qui réussit le mieux les tâches difficiles.
Dans une liste de modèles, générations et niveaux apparaissent côte à côte (Figure 4figure 4 et Figure 5figure 5). La possibilité de choisir vous-même le niveau dépend du produit et de votre forfait, présentés avec les réglages d’effort (see also the Execution “effort” page) (voir aussi la page L'« effort » d'exécution). Cette page décrit seulement les choix ; savoir quel niveau convient à quelle tâche est une autre question (see also the Which model for which task page) (voir aussi la page Quel modèle pour quelle tâche).
Lequel de ces choix change le plus les résultats
La plupart des gens choisissent la famille une fois, gardent le niveau et l’effort qu’on leur attribue et ne regardent jamais le reste. Pourtant, chacun des quatre choix peut changer considérablement vos résultats, et celui qui compte le plus dépend de la tâche et des modèles disponibles à ce moment-là.
Si vous utilisez ces outils régulièrement et que les résultats vous déçoivent parfois, il vaut la peine d’essayer d’autres niveaux et d’autres niveaux d’effort reasoning efforteffort de raisonnement language modelsmodèles de langue A setting that controls how much computation a model spends on an answer, which in practice means how many tokens it generates.Paramètre qui détermine la quantité de calcul qu'un modèle consacre à une réponse, c'est-à-dire, en pratique, le nombre de jetons qu'il génère. , même si vous ne souhaitez pas changer de fournisseur.
Sources
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Sources
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/