Predicting the next wordPrédire le mot suivant
TRA6008 S2 · in classS2 · en classe
Autocomplete
Type Good into a message on your phone. Your keyboard will suggest the next words it predicts to be most likely: morning, night, luck. Add one letter, Good m, and the list narrows to morning. Nothing in the keyboard understands what you are writing. It is answering a single question: given the words already typed, which word is likely to come next?
Your keyboard answers from something small. The older way is a frequency table: the keyboard has counted which words followed Good, in the text it was built from and in your own past messages, and suggests the most frequent one. Current keyboards run a small neural network neural network (NN)réseau de neurones (RNA) machine learningapprentissage automatique A machine-learning model composed of interconnected layers of small computational units.Modèle d'apprentissage automatique composé de couches interconnectées de petites unités de calcul. instead, with a vocabulary of around ten thousand words and about a megabyte of storage on the phone (Hard et al., 2018). Either way it looks one or two words behind the cursor.
Click Figure 1figure 1 to test the quality of the autocomplete on my phone.
The same question with more behind it
Compare the results from the autocomplete in Figure 1figure 1 with what we have come to expect from large language models (LLMs) like ChatGPT, Claude, Gemini, etc.
To understand the difference in quality, consider these important differences:
- LLMs are far bigger. The keyboard’s model is around a million adjustable numbers, small enough to sit on the phone in your hand. LLMs have billions of them, and they run on hardware you never see.
- LLMs learned from far more text, written by other people. Your keyboard learned from a modest word list and from your own past messages. LLMs are trained on a very large and varied collection of text. Their vocabulary, their phrasing and their factual associations all come from there.
- LLMs read far more of what you already typed. Where the keyboard uses the last word or two, they take thousands of tokens of preceding text into account, so a pronoun twenty sentences back can still affect what they predict now.
- LLMs represent each word far more richly, and not the same way twice. Both turn words into word embeddings word embeddingplongement lexical embeddingsplongements A learned numerical representation of a word as a short, dense vector, meaning a list of numbers.Représentation numérique apprise d'un mot sous la forme d'un vecteur dense et court, c'est-à-dire une liste de nombres. , vectors of numbers standing for a word (see also the Word embeddings chapter, in the Language as numbers module) (voir aussi le chapitre Plongements lexicaux, dans le module Le langage en nombres). The keyboard’s are about ninety-six numbers long and fixed once, so bank is the same vector in every sentence you type. An LLM’s run to thousands of numbers and are recomputed for the sentence at hand by the attention mechanism attention mechanismmécanisme d'attention deep learningapprentissage profond A "method in neural networks that helps a model focus on the most relevant parts of the input when producing an output. For example, when translating a sentence, it 'pays attention' to the words that matter most for the next translated word, which improves accuracy and handling of long sequences." (Stanford HAI).Méthode utilisée dans les réseaux de neurones pour aider un modèle à se concentrer sur les parties les plus pertinentes de l'entrée au moment de produire une sortie. Par exemple, lors de la traduction d'une phrase, le modèle « prête attention » aux mots qui comptent le plus pour le prochain mot traduit, ce qui améliore la précision et le traitement des longues séquences (d'après Stanford HAI, traduction libre). , which decides which of the earlier words matter for the word being predicted now (see also the Attention & transformers chapter, in the Language as numbers module) (voir aussi le chapitre Attention et transformeurs, dans le module Le langage en nombres).
One objective to solve many tasks
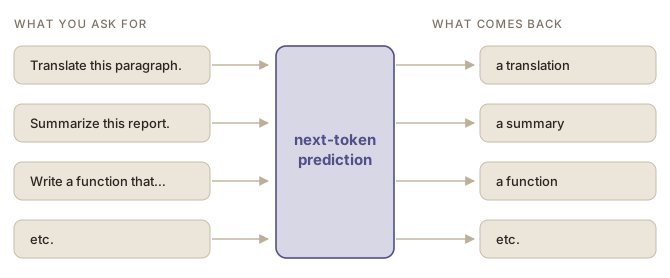
While LLMs are trained just to predict the next most probable token, that single objective manages to create systems that are good at many tasks. This is quite different from the previous generation of NLP natural language processing (NLP)traitement automatique de la langue (TAL) NLPTAL An interdisciplinary field that develops and studies computational methods for analyzing, processing, and generating human language.Domaine interdisciplinaire qui développe et étudie des méthodes computationnelles pour analyser, traiter et générer le langage humain. systems, where we had more specialized dedicated tools per task. Instead of one translation model, one summarizing model, one code completion model, we now have one giant LLM able to do it all.
La saisie automatique
Tapez Good dans un message sur votre téléphone. Votre clavier vous proposera les mots qu’il juge les plus probables ensuite : morning, night, luck. Ajoutez une lettre, Good m, et la liste se réduit à morning. Rien dans le clavier ne comprend ce que vous écrivez. Il répond à une seule question : étant donné les mots déjà tapés, quel mot a le plus de chances de suivre ?
Votre clavier répond à partir de quelque chose de petit. La façon la plus ancienne est une table de fréquences : le clavier a compté quels mots suivaient Good, dans le texte à partir duquel il a été construit et dans vos propres messages, et il suggère le plus fréquent. Les claviers actuels font plutôt tourner un petit réseau de neurones neural network (NN)réseau de neurones (RNA) machine learningapprentissage automatique A machine-learning model composed of interconnected layers of small computational units.Modèle d'apprentissage automatique composé de couches interconnectées de petites unités de calcul. , avec un vocabulaire d’environ dix mille mots et près d’un mégaoctet de stockage sur le téléphone (Hard et al., 2018). Dans les deux cas, il regarde un mot ou deux avant le curseur.
Cliquez sur Figure 1figure 1 pour tester la qualité de la saisie automatique sur mon téléphone.
La même question, avec bien plus derrière
Comparez les résultats de la saisie automatique de Figure 1figure 1 avec ce que nous avons pris l’habitude d’attendre des grands modèles de langue (GML) comme ChatGPT, Claude, Gemini, etc.
Pour comprendre la différence de qualité, voici les différences importantes :
- Les GML sont bien plus gros. Le modèle du clavier compte environ un million de nombres ajustables, assez peu pour tenir dans le téléphone que vous avez en main. Les GML en ont des milliards, et ils tournent sur du matériel que vous ne voyez jamais.
- Les GML ont appris sur bien plus de texte, écrit par d’autres. Votre clavier a appris à partir d’une liste de mots modeste et de vos propres messages. Les GML sont entraînés sur une collection de textes très vaste et très variée. Leur vocabulaire, leurs tournures et leurs associations factuelles viennent tous de là.
- Les GML lisent bien plus de ce que vous avez déjà tapé. Là où le clavier se sert du dernier mot ou des deux derniers, ils prennent en compte des milliers de jetons de texte précédent, si bien qu’un pronom vingt phrases plus haut peut encore influer sur ce qu’ils prédisent maintenant.
- Les GML représentent chaque mot bien plus richement, et jamais deux fois de la même façon. Les deux transforment les mots en plongements lexicaux word embeddingplongement lexical embeddingsplongements A learned numerical representation of a word as a short, dense vector, meaning a list of numbers.Représentation numérique apprise d'un mot sous la forme d'un vecteur dense et court, c'est-à-dire une liste de nombres. , des vecteurs de nombres qui tiennent lieu de mot (see also the Word embeddings chapter, in the Language as numbers module) (voir aussi le chapitre Plongements lexicaux, dans le module Le langage en nombres). Ceux du clavier font environ quatre-vingt-seize nombres et sont fixés une fois pour toutes, de sorte que bank est le même vecteur dans toutes les phrases que vous tapez. Ceux d’un GML vont jusqu’à des milliers de nombres et sont recalculés pour la phrase en cours par le mécanisme d’attention attention mechanismmécanisme d'attention deep learningapprentissage profond A "method in neural networks that helps a model focus on the most relevant parts of the input when producing an output. For example, when translating a sentence, it 'pays attention' to the words that matter most for the next translated word, which improves accuracy and handling of long sequences." (Stanford HAI).Méthode utilisée dans les réseaux de neurones pour aider un modèle à se concentrer sur les parties les plus pertinentes de l'entrée au moment de produire une sortie. Par exemple, lors de la traduction d'une phrase, le modèle « prête attention » aux mots qui comptent le plus pour le prochain mot traduit, ce qui améliore la précision et le traitement des longues séquences (d'après Stanford HAI, traduction libre). , qui décide quels mots précédents comptent pour le mot en train d’être prédit (see also the Attention & transformers chapter, in the Language as numbers module) (voir aussi le chapitre Attention et transformeurs, dans le module Le langage en nombres).
Un seul objectif pour résoudre de nombreuses tâches
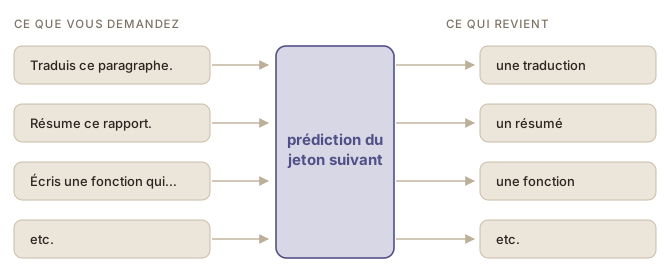
Alors que les GML sont entraînés uniquement à prédire le jeton suivant le plus probable, cet objectif unique parvient à créer des systèmes qui sont bons dans de nombreuses tâches. C’est très différent de la génération précédente de systèmes de TAL natural language processing (NLP)traitement automatique de la langue (TAL) NLPTAL An interdisciplinary field that develops and studies computational methods for analyzing, processing, and generating human language.Domaine interdisciplinaire qui développe et étudie des méthodes computationnelles pour analyser, traiter et générer le langage humain. , où l’on avait des outils spécialisés et dédiés, un par tâche. Au lieu d’un modèle de traduction, d’un modèle de résumé, d’un modèle de complétion de code, nous avons maintenant un seul GML géant capable de tout faire.
Sources
- Hard, A., Rao, K., Mathews, R., Ramaswamy, S., Beaufays, F., Augenstein, S., Eichner, H., Kiddon, C., & Ramage, D. (2018). Federated Learning for Mobile Keyboard Prediction. arXiv:1811.03604. https://arxiv.org/abs/1811.03604
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/