Which languages, and how unevenlyQuelles langues, et dans quelles proportions
TRA6008 To read for S3À lire pour la S3
How much of a corpus is English
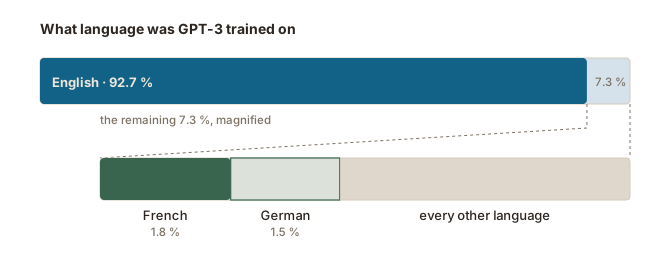
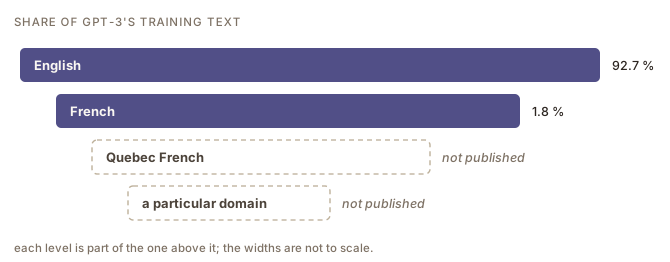
Xu et al. (2025) surveyed the corpora behind multilingual models and found several, GPT-3 among them, trained on text more than 90 % English. For GPT-3 their figures are 92.7 % English, 1.8 % French, 1.5 % German and 5.9 % everything else.
French, the second language on that list, is one of the best-served languages in the world, and it still accounts for under a fiftieth of what the model read.
There are many attempts at broadening language coverage, either in multilingual models that include more data in other languages, or in models dedicated to a single other language than English. Qwen3, released in 2025, was trained on text in 119 languages and dialects, against 29 for the model it replaced (Yang et al., 2025b). The reporting has not kept pace: almost no model in use publishes its shares, which is why GPT-3 is still the example anyone can quote precisely.
Part of this reflects the web, which is itself skewed toward English. The rest is decisions:
- which crawls to include;
- which quality filters to apply, since a filter trained on English rates other languages badly;
- whether to spend effort on languages that would each add little volume.
Joshi et al. (2020) documented how uneven the resources are across the world’s languages, with a small number well provided for and the great majority having almost nothing available at all.
Why this matters for translation
A general claim about what “an LLM” can do is not portable across languages. A model that drafts fluent English may be noticeably weaker in your other working language, and weaker again in a variety of that language: Quebec French rather than metropolitan French, a regional term, a domain where the local usage differs.
Volume is not the only factor. Models trained on many languages do better in a well-resourced language than models trained on that language alone, and they align best between English and the languages closest to it, which puts French in a comparatively good position on both counts. The benefit has a limit the field calls the curse of multilinguality: at a fixed model size, supporting more languages costs each of them (Xu et al., 2025).
This is a reason to test rather than assume. A model’s fluency is not evidence about its accuracy, and it is least reliable in exactly the places where you would be checking hardest anyway.
A second penalty, in tokens
The imbalance reaches the tokenizer tokenization²jetonisation² language modelsmodèles de langue The process of converting text into an ordered sequence of tokens that a language model can process.Processus de conversion d'un texte en une séquence ordonnée de jetons qu'un modèle de langue peut traiter. as well, and the tokenizer passes it on to everyone who uses the model. Because its subword vocabulary is learned mostly from English text, the same sentence costs more tokens in most other languages, and Petrov et al. (2023) measured differences large enough to matter. More tokens for the same content means three things at once:
- a smaller effective context window context windowfenêtre contextuelle language modelsmodèles de langue "The amount of input (like text) that an AI system can process at one time during a task. Think of it as a model's short-term memory. A model can only consider so much text when generating its next response, and once the conversation exceeds its context window, the model starts 'forgetting' prior responses." (Stanford HAI).Quantité d'entrée (du texte, par exemple) qu'un système d'IA peut traiter à la fois pendant une tâche ; en quelque sorte, la mémoire à court terme du modèle. Un modèle ne peut considérer qu'une quantité limitée de texte pour générer sa prochaine réponse et, quand la conversation dépasse sa fenêtre contextuelle, il commence à « oublier » les réponses antérieures (d'après Stanford HAI, traduction libre). , so less room for the document you are working on;
- slower responses;
- a larger bill, where a service charges by the token (see also the Consequences of tokenization chapter, in the Language as numbers module) (voir aussi le chapitre Conséquences de la jetonisation, dans le module Le langage en nombres).
Quelle part d’un corpus est en anglais
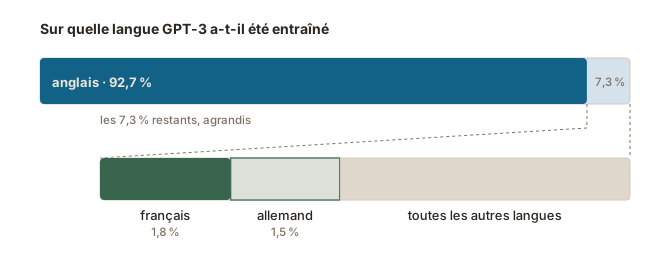
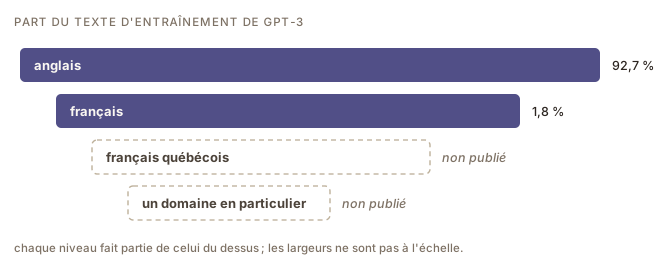
Xu et al. (2025) ont recensé les corpus derrière les modèles multilingues et en ont trouvé plusieurs, dont GPT-3, entraînés sur du texte anglais à plus de 90 %. Pour GPT-3, leurs chiffres sont 92,7 % d’anglais, 1,8 % de français, 1,5 % d’allemand et 5,9 % pour tout le reste.
Le français, deuxième langue de cette liste, est l’une des mieux servies au monde, et il ne représente pourtant pas un cinquantième de ce que le modèle a lu.
Les tentatives d’élargir la couverture linguistique sont nombreuses, soit dans des modèles multilingues qui intègrent davantage de données dans d’autres langues, soit dans des modèles consacrés à une seule autre langue que l’anglais. Qwen3, paru en 2025, a été entraîné sur du texte dans 119 langues et dialectes, contre 29 pour le modèle qu’il remplace (Yang et al., 2025b). La publication des chiffres n’a pas suivi : presque aucun modèle en usage ne publie ses proportions, et c’est pourquoi GPT-3 reste l’exemple que l’on peut citer avec précision.
Cela tient en partie au Web, lui-même orienté vers l’anglais. Le reste tient à des décisions :
- quelles explorations inclure ;
- quels filtres de qualité appliquer, puisqu’un filtre entraîné sur de l’anglais note mal les autres langues ;
- s’il vaut la peine de consacrer des efforts à des langues qui n’ajouteraient chacune que peu de volume.
Joshi et al. (2020) ont documenté à quel point les ressources sont inégales entre les langues du monde, un petit nombre étant bien pourvues et la grande majorité n’ayant presque rien de disponible.
Pourquoi cela compte en traduction
Une affirmation générale sur ce que « un GML » sait faire ne se transporte pas d’une langue à l’autre. Un modèle qui rédige un anglais fluide peut être nettement plus faible dans votre autre langue de travail, et plus faible encore dans une variété de cette langue : le français québécois plutôt que le français hexagonal, un terme régional, un domaine où l’usage local diffère.
Le volume n’est pas le seul facteur. Les modèles entraînés sur de nombreuses langues font mieux dans une langue bien pourvue que les modèles entraînés sur cette seule langue, et ils alignent le mieux l’anglais et les langues qui en sont les plus proches, ce qui place le français en assez bonne position sur les deux plans. L’avantage a une limite que le domaine appelle la malédiction du multilinguisme : à taille de modèle fixe, prendre en charge plus de langues coûte à chacune d’elles (Xu et al., 2025).
C’est une raison de tester plutôt que de présumer. La fluidité d’un modèle ne renseigne pas sur son exactitude, et elle est la moins fiable précisément là où vous vérifieriez le plus attentivement de toute façon.
Une seconde pénalité, en jetons
Le déséquilibre atteint aussi le segmenteur tokenization²jetonisation² language modelsmodèles de langue The process of converting text into an ordered sequence of tokens that a language model can process.Processus de conversion d'un texte en une séquence ordonnée de jetons qu'un modèle de langue peut traiter. , et le segmenteur le transmet à quiconque utilise le modèle. Comme son vocabulaire de sous-mots est appris surtout sur du texte anglais, la même phrase coûte plus de jetons dans la plupart des autres langues, et Petrov et al. (2023) ont mesuré des écarts assez grands pour compter. Plus de jetons pour le même contenu, cela veut dire trois choses à la fois :
- une fenêtre contextuelle context windowfenêtre contextuelle language modelsmodèles de langue "The amount of input (like text) that an AI system can process at one time during a task. Think of it as a model's short-term memory. A model can only consider so much text when generating its next response, and once the conversation exceeds its context window, the model starts 'forgetting' prior responses." (Stanford HAI).Quantité d'entrée (du texte, par exemple) qu'un système d'IA peut traiter à la fois pendant une tâche ; en quelque sorte, la mémoire à court terme du modèle. Un modèle ne peut considérer qu'une quantité limitée de texte pour générer sa prochaine réponse et, quand la conversation dépasse sa fenêtre contextuelle, il commence à « oublier » les réponses antérieures (d'après Stanford HAI, traduction libre). effective plus petite, donc moins de place pour le document sur lequel vous travaillez ;
- des réponses plus lentes ;
- une facture plus élevée, là où un service facture au jeton (see also the Consequences of tokenization chapter, in the Language as numbers module) (voir aussi le chapitre Conséquences de la jetonisation, dans le module Le langage en nombres).
Sources
- Brown, T. B., Mann, B., Ryder, N., Subbiah, M., Kaplan, J., Dhariwal, P., et al. (2020). Language Models are Few-Shot Learners. Advances in Neural Information Processing Systems 33 (NeurIPS 2020). https://proceedings.neurips.cc/paper/2020/hash/1457c0d6bfcb4967418bfb8ac142f64a-Abstract.html
- Joshi, P., Santy, S., Budhiraja, A., Bali, K., & Choudhury, M. (2020). The State and Fate of Linguistic Diversity and Inclusion in the NLP World. Proceedings of the 58th Annual Meeting of the Association for Computational Linguistics. https://aclanthology.org/2020.acl-main.560/
- Petrov, A., La Malfa, E., Torr, P., & Bibi, A. (2023). Language Model Tokenizers Introduce Unfairness Between Languages. Advances in Neural Information Processing Systems 36 (NeurIPS 2023). https://proceedings.neurips.cc/paper_files/paper/2023/hash/74bb24dca8334adce292883b4b651eda-Abstract-Conference.html
- Xu, Y., Hu, L., Zhao, J., Qiu, Z., Xu, K., Ye, Y., & Gu, H. (2025). A survey on multilingual large language models: corpora, alignment, and bias. Frontiers of Computer Science, 19(11), 1911362. https://doi.org/10.1007/s11704-024-40579-4
- Yang, A., Li, A., Yang, B., et al. (Qwen Team) (2025b). Qwen3 Technical Report. arXiv:2505.09388 (preprint). https://arxiv.org/abs/2505.09388