How much text a model readsQuelle quantité de texte lit un modèle
TRA6008 S2 · in classS2 · en classe
How much text goes into one model
The dataset assembled to train GPT-3 came to 499 billion tokens, of which the model saw 300 billion during training (Brown et al., 2020). A few years later, Chinchilla was trained on 1.4 trillion (Hoffmann et al., 2022). The published figures have gone on climbing since: 15.6 trillion tokens for Llama 3.1 in 2024 (Grattafiori et al., 2024), 36 trillion for Qwen3 in 2025 (Yang et al., 2025b).These are the figures that were published. OpenAI’s report on GPT-4 says it gives “no further details about the architecture (including model size), hardware, training compute, dataset construction, training method, or similar” (OpenAI, 2023), and the other large providers say no more, so the size of the models most people use today is a matter of estimate rather than record.
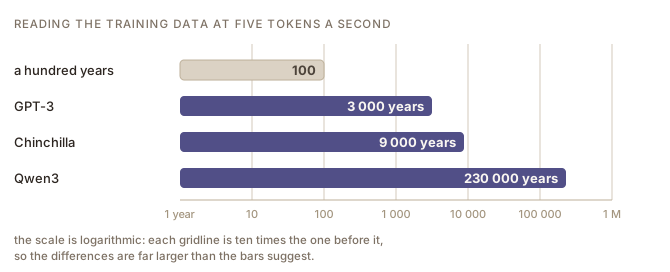
Those figures mean very little on their own, so here is a comparison to try to get a better grasp:
Reading at roughly five tokens a second, without stopping to eat or sleep, 1.4 trillion tokens would take somewhere near nine thousand years. Qwen3’s 36 trillion would take about two hundred and thirty thousand.
How the amounts have grown
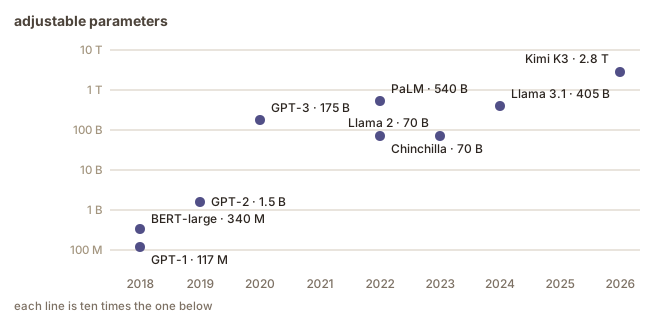
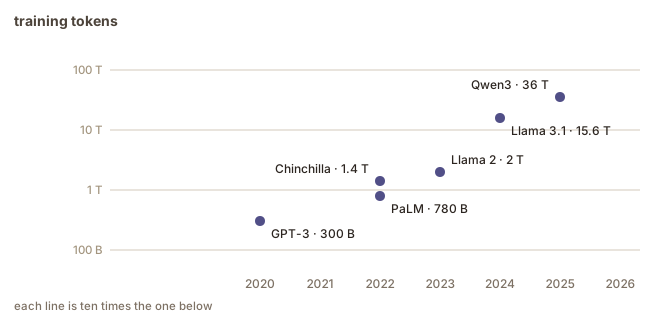
The growth went into the text rather than into the model. Chinchilla and Llama 2 are smaller models than GPT-3 and were trained on several times more text, after Hoffmann et al. (2022) showed that for a given amount of computation a smaller model trained on more data does better (see also the Pretraining chapter) (voir aussi le chapitre Préentraînement).
Neither figure describes the best-known models after 2023, because their builders stopped publishing the figures. Everything plotted here comes from the open-weight models open-weight modelmodèle à poids ouverts AIIA An AI model whose trained parameters, commonly called weights, are made available for others to download.Modèle d'IA dont les paramètres entraînés, appelés poids, sont offerts au téléchargement. ; the scale of the closed ones is a matter of outside estimate (Epoch AI, 2026).
Quelle quantité de texte entre dans un modèle
Le jeu de données réuni pour entraîner GPT-3 comptait 499 milliards de jetons, dont le modèle a vu 300 milliards pendant l’entraînement (Brown et al., 2020). Quelques années plus tard, Chinchilla était entraîné sur 1 400 milliards (Hoffmann et al., 2022). Les chiffres publiés n’ont cessé de grimper depuis : 15 600 milliards de jetons pour Llama 3.1 en 2024 (Grattafiori et al., 2024), 36 000 milliards pour Qwen3 en 2025 (Yang et al., 2025b).Ce sont là les chiffres qui ont été publiés. Le rapport d’OpenAI sur GPT-4 précise qu’il ne donne « aucun détail supplémentaire sur l’architecture (y compris la taille du modèle), le matériel, le calcul d’entraînement, la construction du jeu de données, la méthode d’entraînement ou autre » (OpenAI, 2023), et les autres grands fournisseurs n’en disent pas davantage. La taille des modèles que la plupart des gens utilisent aujourd’hui relève donc de l’estimation plutôt que du fait établi.
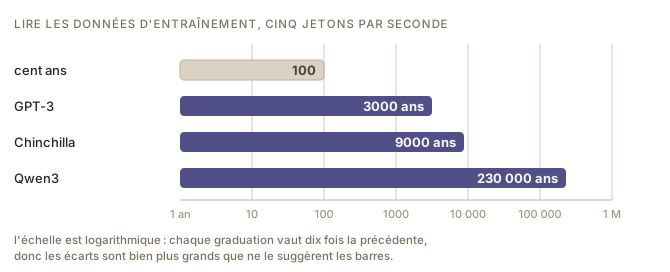
Ces chiffres ne veulent pas dire grand-chose en eux-mêmes ; voici donc une comparaison pour tenter de mieux les saisir :
À raison d’environ cinq jetons par seconde, sans s’arrêter pour manger ni pour dormir, 1 400 milliards de jetons prendraient près de neuf mille ans. Les 36 000 milliards de Qwen3 en prendraient environ deux cent trente mille.
Comment les quantités ont augmenté
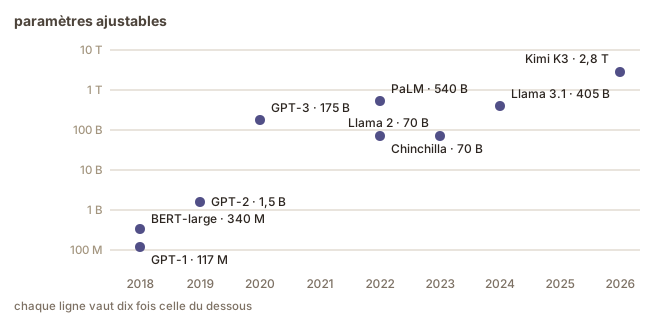
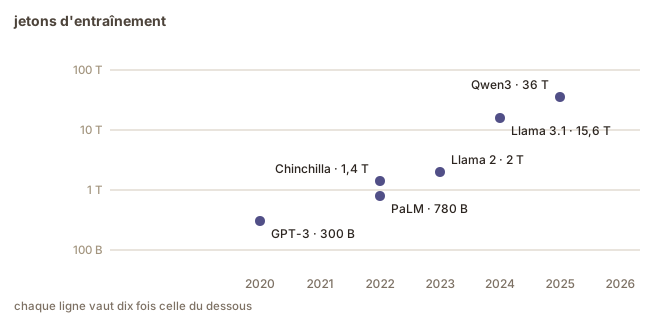
La croissance est allée au texte plutôt qu’au modèle. Chinchilla et Llama 2 sont des modèles plus petits que GPT-3 et ont été entraînés sur plusieurs fois plus de texte, après que Hoffmann et al. (2022) ont montré qu’à quantité de calcul donnée, un modèle plus petit entraîné sur plus de données fait mieux (see also the Pretraining chapter) (voir aussi le chapitre Préentraînement).
Ni l’une ni l’autre figure ne décrit les modèles les plus connus après 2023, parce que ceux qui les construisent ont cessé d’en publier les chiffres. Tout ce qui est représenté ici vient des modèles à poids ouverts open-weight modelmodèle à poids ouverts AIIA An AI model whose trained parameters, commonly called weights, are made available for others to download.Modèle d'IA dont les paramètres entraînés, appelés poids, sont offerts au téléchargement. ; l’échelle des modèles fermés relève de l’estimation externe (Epoch AI, 2026).
Sources
- Brown, T. B., Mann, B., Ryder, N., Subbiah, M., Kaplan, J., Dhariwal, P., et al. (2020). Language Models are Few-Shot Learners. Advances in Neural Information Processing Systems 33 (NeurIPS 2020). https://proceedings.neurips.cc/paper/2020/hash/1457c0d6bfcb4967418bfb8ac142f64a-Abstract.html
- Chowdhery, A., Narang, S., Devlin, J., Bosma, M., Mishra, G., Roberts, A., et al. (2023). PaLM: Scaling Language Modeling with Pathways. Journal of Machine Learning Research, 24(240), 1–113. https://jmlr.org/papers/v24/22-1144.html
- Devlin, J., Chang, M.-W., Lee, K., & Toutanova, K. (2019). BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding. Proceedings of the 2019 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies, Volume 1 (Long and Short Papers). https://doi.org/10.18653/v1/N19-1423
- Epoch AI (2026). Data on AI models. Online database, CC BY, epoch.ai (retrieved 9 September 2026). https://epoch.ai/data/ai-models
- Grattafiori, A., Dubey, A., Jauhri, A., Pandey, A., Kadian, A., et al. (2024). The Llama 3 Herd of Models. arXiv:2407.21783 (preprint). https://arxiv.org/abs/2407.21783
- Hoffmann, J., Borgeaud, S., Mensch, A., Buchatskaya, E., Cai, T., Rutherford, E., et al. (2022). An empirical analysis of compute-optimal large language model training. Advances in Neural Information Processing Systems 35 (NeurIPS 2022). https://proceedings.neurips.cc/paper_files/paper/2022/hash/c1e2faff6f588870935f114ebe04a3e5-Abstract-Conference.html
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- Kimi Team (2026). Kimi K3: Open Frontier Intelligence. arXiv:2607.24653 (preprint). https://arxiv.org/abs/2607.24653
- OpenAI (2023). GPT-4 Technical Report. arXiv:2303.08774 (preprint). https://arxiv.org/abs/2303.08774
- Radford, A., Wu, J., Child, R., Luan, D., Amodei, D., & Sutskever, I. (2019). Language Models are Unsupervised Multitask Learners. OpenAI. https://cdn.openai.com/better-language-models/language_models_are_unsupervised_multitask_learners.pdf
- Touvron, H., Martin, L., Stone, K., Albert, P., Almahairi, A., Babaei, Y., et al. (2023). Llama 2: Open Foundation and Fine-Tuned Chat Models. arXiv:2307.09288 (preprint). https://arxiv.org/abs/2307.09288
- Yang, A., Li, A., Yang, B., et al. (Qwen Team) (2025b). Qwen3 Technical Report. arXiv:2505.09388 (preprint). https://arxiv.org/abs/2505.09388
Sources
- Brown, T. B., Mann, B., Ryder, N., Subbiah, M., Kaplan, J., Dhariwal, P., et al. (2020). Language Models are Few-Shot Learners. Advances in Neural Information Processing Systems 33 (NeurIPS 2020). https://proceedings.neurips.cc/paper/2020/hash/1457c0d6bfcb4967418bfb8ac142f64a-Abstract.html
- Chowdhery, A., Narang, S., Devlin, J., Bosma, M., Mishra, G., Roberts, A., et al. (2023). PaLM: Scaling Language Modeling with Pathways. Journal of Machine Learning Research, 24(240), 1–113. https://jmlr.org/papers/v24/22-1144.html
- Devlin, J., Chang, M.-W., Lee, K., & Toutanova, K. (2019). BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding. Proceedings of the 2019 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies, Volume 1 (Long and Short Papers). https://doi.org/10.18653/v1/N19-1423
- Epoch AI (2026). Data on AI models. Online database, CC BY, epoch.ai (retrieved 9 septembre 2026). https://epoch.ai/data/ai-models
- Grattafiori, A., Dubey, A., Jauhri, A., Pandey, A., Kadian, A., et al. (2024). The Llama 3 Herd of Models. arXiv:2407.21783 (preprint). https://arxiv.org/abs/2407.21783
- Hoffmann, J., Borgeaud, S., Mensch, A., Buchatskaya, E., Cai, T., Rutherford, E., et al. (2022). An empirical analysis of compute-optimal large language model training. Advances in Neural Information Processing Systems 35 (NeurIPS 2022). https://proceedings.neurips.cc/paper_files/paper/2022/hash/c1e2faff6f588870935f114ebe04a3e5-Abstract-Conference.html
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- Kimi Team (2026). Kimi K3: Open Frontier Intelligence. arXiv:2607.24653 (preprint). https://arxiv.org/abs/2607.24653
- OpenAI (2023). GPT-4 Technical Report. arXiv:2303.08774 (preprint). https://arxiv.org/abs/2303.08774
- Radford, A., Wu, J., Child, R., Luan, D., Amodei, D., & Sutskever, I. (2019). Language Models are Unsupervised Multitask Learners. OpenAI. https://cdn.openai.com/better-language-models/language_models_are_unsupervised_multitask_learners.pdf
- Touvron, H., Martin, L., Stone, K., Albert, P., Almahairi, A., Babaei, Y., et al. (2023). Llama 2: Open Foundation and Fine-Tuned Chat Models. arXiv:2307.09288 (preprint). https://arxiv.org/abs/2307.09288
- Yang, A., Li, A., Yang, B., et al. (Qwen Team) (2025b). Qwen3 Technical Report. arXiv:2505.09388 (preprint). https://arxiv.org/abs/2505.09388