Features for languageLes attributs pour la langue
TRA2600 S5 · in classS5 · en classe
TRA6008 S1 · in classS1 · en classe
What does a feature look like when the examples are words rather than emails? Take named entity recognition named entity recognition (NER)reconnaissance d'entités nommées (REN) NLPTAL The task of finding the spans of a text that are proper names, and labelling the category, most often a person, a location or an organization.Tâche qui consiste à repérer dans un texte les segments qui sont des noms propres, et à en étiqueter la catégorie, le plus souvent une personne, un lieu ou une organisation. as an example. This is an NLP task where the goal is to label named entities automatically: names of people, places, organizations, and so on (see also the Named entity recognition: one task up close page, in the Classical NLP module) (voir aussi la page La reconnaissance d'entités nommées : une tâche vue de près, dans le module TAL classique). Useful features for a word include: does it start with a capital letter, is it the first word of the sentence, does it appear in a list of known first names, what word comes just before it (Mr., in, at), and what suffix it ends with (-town, -land, -ville). With a training corpus corpuscorpus corporacorpus A collection of written texts, speech recordings or transcribed language assembled for analysis or use in language technology (plural: corpora).Ensemble de textes écrits, d'enregistrements de parole ou de langue transcrite réuni pour l'analyse ou pour les technologies langagières. where the entities have been labelled by hand, and those features calculated for every word, the algorithm can learn which patterns in the data go with a name.
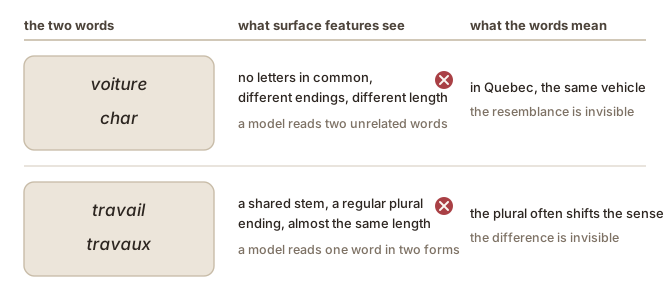
Though you can do some impressive things with feature engineering, these systems tend to all hit the same wall. Features like suffixes and capitalization describe the form of a word. They say nothing about what it means. To a feature-based model, voiture and char are simply two different sequences of letters, though in Quebec both can mean car; travail (work) and travaux (roadworks) look like the singular and plural of one word, though the plural often shifts the meaning. The way past the wall was to stop describing words by hand-picked properties and let a system learn, from how words are used, a numerical representation of the words themselves (see also the Language as numbers module) (voir aussi le module Le langage en nombres).
À quoi ressemble un attribut quand les exemples sont des mots plutôt que des courriels ? Prenons la reconnaissance d’entités nommées named entity recognition (NER)reconnaissance d'entités nommées (REN) NLPTAL The task of finding the spans of a text that are proper names, and labelling the category, most often a person, a location or an organization.Tâche qui consiste à repérer dans un texte les segments qui sont des noms propres, et à en étiqueter la catégorie, le plus souvent une personne, un lieu ou une organisation. comme exemple. C’est une tâche de TAL dont le but est d’étiqueter automatiquement les entités nommées : noms de personnes, de lieux, d’organisations, et ainsi de suite (see also the Named entity recognition: one task up close page, in the Classical NLP module) (voir aussi la page La reconnaissance d'entités nommées : une tâche vue de près, dans le module TAL classique). Des attributs utiles pour un mot : commence-t-il par une majuscule, est-il le premier mot de la phrase, figure-t-il dans une liste de prénoms connus, quel mot le précède immédiatement (M., à, chez), et par quel suffixe se termine-t-il (-ville, -bourg, -ac). Avec un corpus corpuscorpus corporacorpus A collection of written texts, speech recordings or transcribed language assembled for analysis or use in language technology (plural: corpora).Ensemble de textes écrits, d'enregistrements de parole ou de langue transcrite réuni pour l'analyse ou pour les technologies langagières. d’entraînement où les entités ont été étiquetées à la main, et ces attributs calculés pour chaque mot, l’algorithme peut apprendre quels motifs des données vont avec un nom.
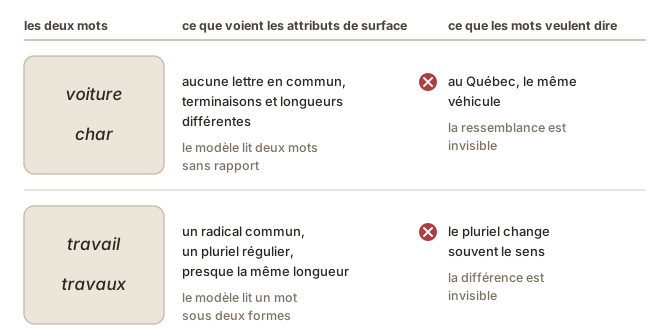
On peut faire des choses impressionnantes avec l’ingénierie des attributs, et pourtant ces systèmes butent tous sur le même mur. Des attributs comme les suffixes et les majuscules décrivent la forme d’un mot. Ils ne disent rien de ce qu’il veut dire. Pour un modèle fondé sur des attributs, voiture et char sont simplement deux suites de lettres différentes, alors qu’au Québec les deux peuvent désigner le même véhicule ; travail et travaux ont l’air du singulier et du pluriel d’un même mot, alors que le pluriel en change souvent le sens. Pour passer le mur, il a fallu cesser de décrire les mots par des propriétés choisies à la main et laisser un système apprendre, à partir de la façon dont les mots sont employés, une représentation numérique des mots eux-mêmes (see also the Language as numbers module) (voir aussi le module Le langage en nombres).
Sources
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Sources
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/