A number for each wordUn nombre par mot
TRA6008 To read for S2À lire pour la S2
If words have to become numbers, the obvious first move is a list: a dictionary with its entries numbered.
angelic = 1
ape     = 2
apple   = 3
ardour  = 4
...
zany    = 99,997
zeal    = 99,998
zebra   = 99,999
Every word now has a number, and the conversion is trivial in both directions. But, as Figure 1figure 1 shows, there are three specific issues, where such numbers miss some essential part of what would make them useful.
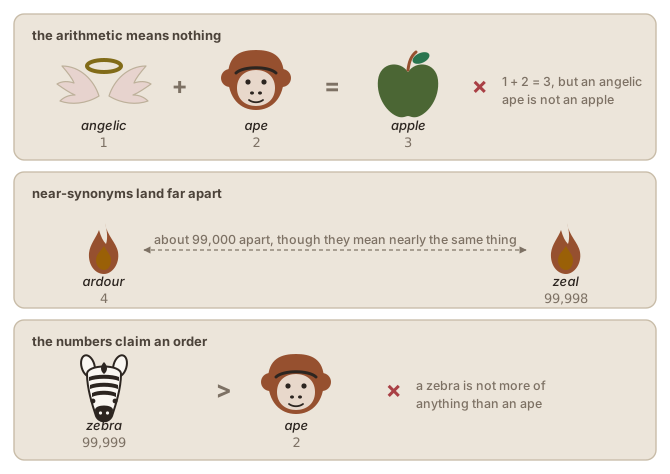
- Arithmetic on these numbers is meaningless. One plus two is three, so an angelic (1) ape (2) makes an apple (3)? Any calculation a system performs on the codes manipulates alphabetical position, which has nothing to do with what the words mean.
- The numbers place related words no closer than unrelated ones. Ardour (4) and zeal (99,998) are near-synonyms sitting about 99,000 apart, farther from each other than either is from apple. A translation system needs exactly the opposite: words with similar meanings should have similar representations.
- A single number per word smuggles in an ordering. 99,999 is bigger than 2, but zebra is not more of anything than ape. A model fed these codes risks attaching meaning to the size of the number, where the only thing behind it is alphabetical order.
Si les mots doivent devenir des nombres, le premier réflexe est d’en faire une liste : un dictionnaire dont les entrées sont numérotées.
ananas = 1
ange   = 2
animal = 3
ardeur = 4
...
zapper = 99 997
zèbre  = 99 998
zèle   = 99 999
Chaque mot a maintenant un nombre, et la conversion se fait sans effort dans les deux sens. Mais, comme le montre la Figure 1figure 1, trois problèmes précis apparaissent, où de tels nombres passent à côté de ce qui les rendrait utiles.
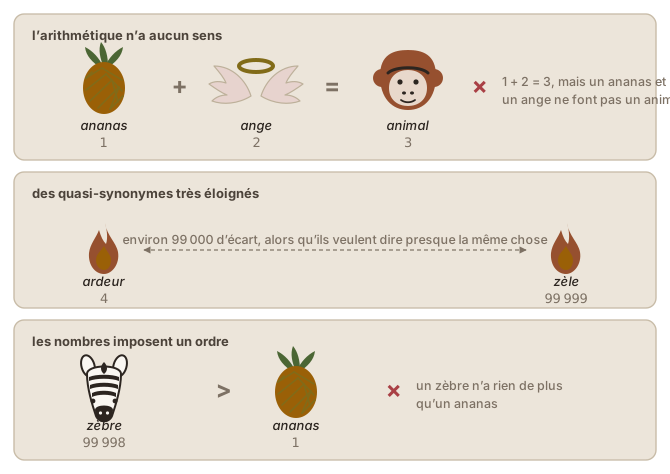
- L’arithmétique sur ces nombres n’a aucun sens. Un plus deux font trois : un ananas (1) et un ange (2) donneraient donc un animal (3) ? Tout calcul effectué sur ces codes manipule une position alphabétique, qui n’a rien à voir avec le sens des mots.
- Les nombres ne rapprochent pas les mots apparentés plus que les mots sans rapport. Ardeur (4) et zèle (99 999) sont des quasi-synonymes séparés par environ 99 000, plus loin l’un de l’autre que chacun ne l’est d’animal. Un système de traduction a besoin exactement de l’inverse : des mots de sens proches devraient avoir des représentations proches.
- Un seul nombre par mot introduit un ordre en douce. 99 998 est plus grand que 1, mais un zèbre n’a rien de plus qu’un ananas. Un modèle nourri de ces codes risque de prêter un sens à la taille du nombre, alors que la seule chose derrière elle est l’ordre alphabétique.
Sources
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Sources
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/