AlignmentL'alignement
TRA6008 To read for S3À lire pour la S3
What is being aligned
A model trained only to continue text has no reason to decline anything, to signal that it is unsure, or to weigh being useful against doing harm. Those dispositions are added deliberately, mostly during fine-tuning fine-tuningaffinage machine learningapprentissage automatique Further training of a pretrained model on new data to adapt it for a particular task, domain, or intended behaviour.Poursuite de l'entraînement d'un modèle préentraîné sur un jeu de données généralement plus restreint et spécialisé, afin de l'adapter à une tâche ou à un domaine particulier. (see also the four stages from pretraining to assistant page) (voir aussi la page Les quatre étapes du préentraînement à l'assistant).
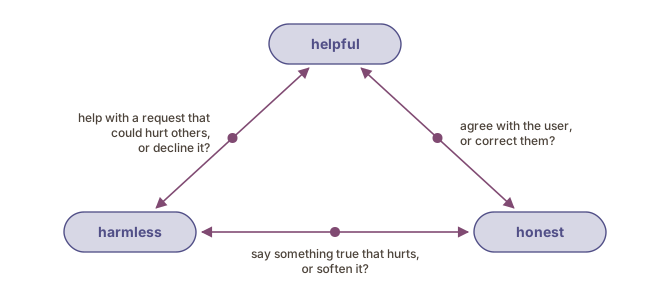
The common framing is that a model should be helpful, honest and harmless (Askell et al., 2021), and they can pull against each other. Helping with a request can mean helping someone harm others; saying something true can hurt the person who asked; and a model trained to please can agree with a user when it should correct them (Sharma et al., 2024).
Where alignment happens
During training, alignment is part of both instruction tuning instruction tuningaffinage par instructions language modelsmodèles de langue A form of supervised fine-tuning in which a pretrained language model is trained further on examples pairing instructions or questions with appropriate responses.Forme d'affinage supervisé dans laquelle un modèle de langue préentraîné est entraîné davantage sur des exemples associant des instructions ou des questions à des réponses appropriées. and preference tuning preference tuningréglage des préférences language modelsmodèles de langue A form of fine-tuning, applied in post-training, that adjusts a language model so that it becomes more likely to produce responses judged preferable and less likely to produce responses judged undesirable.Forme d'affinage, appliquée au postentraînement, qui ajuste un modèle de langue pour qu'il produise plus volontiers des réponses jugées préférables et moins volontiers des réponses jugées indésirables. , and it changes the parameters. Examples of appropriate refusals and of acknowledged uncertainty go into the instruction data; preference tuning rewards responses that balance the competing values; and red teaming red-teamingapproche par l'équipe rouge AI safetysécurité de l'IA A structured testing process in which testers adopt an adversarial perspective and deliberately try to expose vulnerabilities, harmful or unexpected behaviour, and possible ways of misusing an AI model or system.Processus d'essai structuré dans lequel les testeurs adoptent une perspective antagoniste et tentent délibérément de mettre au jour des vulnérabilités, des comportements nuisibles ou inattendus et des façons possibles de détourner un modèle ou un système d'IA. supplies adversarial cases, where people deliberately try to make the model misbehave so that its handling of those attempts can be trained (Bai et al., 2022b).
At deployment deploymentdéploiement computinginformatique Putting a system into operation where it will be used: installing it with what it needs to run and making it available to its users. For an AI system, it means making a trained model available to people, for instance behind an application or a chat interface.Mise en service d'un système là où il sera utilisé : son installation, avec ce dont il a besoin pour fonctionner, et sa mise à la disposition de ses utilisateurs. Pour un système d'IA, il s'agit de rendre un modèle entraîné accessible aux personnes, par exemple derrière une application ou une interface conversationnelle. , without touching the parameters, a system prompt system promptrequête générative système promptingrequêtes An instruction supplied to a language model before or alongside the user's input that establishes the model's role, task, behavioural rules, tone, or other context for the interaction.Instruction fournie à un modèle de langue avant l'entrée de l'utilisateur, ou en parallèle, qui établit le rôle du modèle, sa tâche, ses règles de conduite, son ton ou d'autres éléments de contexte pour l'interaction. sets standing instructions that the user usually does not see, output filters check responses before they are shown, and access can be restricted by context (see also the System prompts page) (voir aussi la page Requêtes génératives système). These can be changed without retraining the model, which is one reason a system’s behaviour can shift between two Tuesdays with no new model released.
Ce qui est aligné
Un modèle entraîné seulement à prolonger du texte n’a aucune raison de refuser quoi que ce soit, de signaler qu’il n’est pas sûr, ou de mettre en balance l’utilité et le tort. Ces dispositions sont ajoutées délibérément, surtout pendant l’affinage fine-tuningaffinage machine learningapprentissage automatique Further training of a pretrained model on new data to adapt it for a particular task, domain, or intended behaviour.Poursuite de l'entraînement d'un modèle préentraîné sur un jeu de données généralement plus restreint et spécialisé, afin de l'adapter à une tâche ou à un domaine particulier. (see also the four stages from pretraining to assistant page) (voir aussi la page Les quatre étapes du préentraînement à l'assistant).
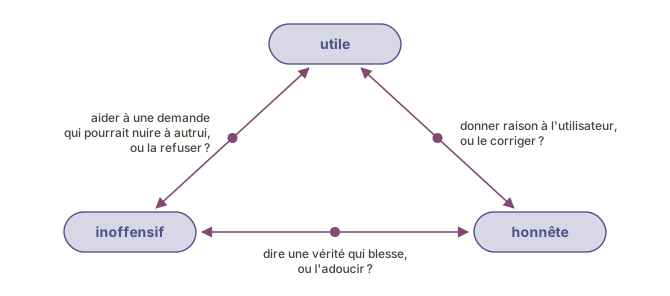
Le cadre courant veut qu’un modèle soit utile, honnête et inoffensif (Askell et al., 2021), et ces trois exigences peuvent tirer en sens contraires. Aider à une demande peut vouloir dire aider quelqu’un à nuire à autrui ; dire une chose vraie peut blesser la personne qui a posé la question ; et un modèle entraîné à plaire peut donner raison à l’utilisateur quand il devrait le corriger (Sharma et al., 2024).
Où se fait l’alignement
À l’entraînement, l’alignement fait partie de l’affinage par instructions instruction tuningaffinage par instructions language modelsmodèles de langue A form of supervised fine-tuning in which a pretrained language model is trained further on examples pairing instructions or questions with appropriate responses.Forme d'affinage supervisé dans laquelle un modèle de langue préentraîné est entraîné davantage sur des exemples associant des instructions ou des questions à des réponses appropriées. comme du réglage des préférences preference tuningréglage des préférences language modelsmodèles de langue A form of fine-tuning, applied in post-training, that adjusts a language model so that it becomes more likely to produce responses judged preferable and less likely to produce responses judged undesirable.Forme d'affinage, appliquée au postentraînement, qui ajuste un modèle de langue pour qu'il produise plus volontiers des réponses jugées préférables et moins volontiers des réponses jugées indésirables. , et il modifie les paramètres. Des exemples de refus appropriés et d’incertitude reconnue entrent dans les données d’instructions ; le réglage des préférences récompense les réponses qui équilibrent les valeurs concurrentes ; et l’approche par l’équipe rouge red-teamingapproche par l'équipe rouge AI safetysécurité de l'IA A structured testing process in which testers adopt an adversarial perspective and deliberately try to expose vulnerabilities, harmful or unexpected behaviour, and possible ways of misusing an AI model or system.Processus d'essai structuré dans lequel les testeurs adoptent une perspective antagoniste et tentent délibérément de mettre au jour des vulnérabilités, des comportements nuisibles ou inattendus et des façons possibles de détourner un modèle ou un système d'IA. fournit des cas adverses, où des personnes tentent délibérément de faire dérailler le modèle pour que sa façon de traiter ces tentatives puisse être entraînée (Bai et al., 2022b).
Au déploiement deploymentdéploiement computinginformatique Putting a system into operation where it will be used: installing it with what it needs to run and making it available to its users. For an AI system, it means making a trained model available to people, for instance behind an application or a chat interface.Mise en service d'un système là où il sera utilisé : son installation, avec ce dont il a besoin pour fonctionner, et sa mise à la disposition de ses utilisateurs. Pour un système d'IA, il s'agit de rendre un modèle entraîné accessible aux personnes, par exemple derrière une application ou une interface conversationnelle. , sans toucher aux paramètres, une requête générative système system promptrequête générative système promptingrequêtes An instruction supplied to a language model before or alongside the user's input that establishes the model's role, task, behavioural rules, tone, or other context for the interaction.Instruction fournie à un modèle de langue avant l'entrée de l'utilisateur, ou en parallèle, qui établit le rôle du modèle, sa tâche, ses règles de conduite, son ton ou d'autres éléments de contexte pour l'interaction. fixe des instructions permanentes que l’utilisateur ne voit généralement pas, des filtres de sortie vérifient les réponses avant de les afficher, et l’accès peut être restreint selon le contexte (see also the System prompts page) (voir aussi la page Requêtes génératives système). Tout cela peut changer sans réentraîner le modèle, et c’est une des raisons pour lesquelles le comportement d’un système peut changer d’un mardi à l’autre sans qu’aucun nouveau modèle ne sorte.
Sources
- Askell, A., Bai, Y., Chen, A., Drain, D., Ganguli, D., Henighan, T., et al. (2021). A General Language Assistant as a Laboratory for Alignment. arXiv:2112.00861 (preprint). https://arxiv.org/abs/2112.00861
- Bai, Y., Jones, A., Ndousse, K., Askell, A., Chen, A., DasSarma, N., et al. (2022b). Training a Helpful and Harmless Assistant with Reinforcement Learning from Human Feedback. arXiv:2204.05862 (preprint). https://arxiv.org/abs/2204.05862
- Bostrom, N. (2003). Ethical Issues in Advanced Artificial Intelligence. In I. Smit et al. (Eds.), Cognitive, Emotive and Ethical Aspects of Decision Making in Humans and in Artificial Intelligence (Vol. 2, pp. 12–17). International Institute of Advanced Studies in Systems Research and Cybernetics. https://nickbostrom.com/ethics/ai
- Bostrom, N. (2014). Superintelligence: Paths, Dangers, Strategies. Oxford University Press. https://openlibrary.org/isbn/9780199678112
- Ouyang, L., Wu, J., Jiang, X., Almeida, D., Wainwright, C., Mishkin, P., et al. (2022). Training language models to follow instructions with human feedback. Advances in Neural Information Processing Systems 35 (NeurIPS 2022). https://proceedings.neurips.cc/paper_files/paper/2022/hash/b1efde53be364a73914f58805a001731-Abstract-Conference.html
- Sharma, M., Tong, M., Korbak, T., Duvenaud, D., Askell, A., Bowman, S. R., et al. (2024). Towards Understanding Sycophancy in Language Models. Proceedings of the Twelfth International Conference on Learning Representations (ICLR 2024). https://openreview.net/forum?id=tvhaxkMKAn