Normalizing text to reduce variationNormaliser un texte pour réduire la variation
TRA2600 S5 · in classS5 · en classe
Fewer types for the same text
Once a text is cut into tokens, many of its types are the same word in different clothes: Le and le, colour and color, livre and livres, ” and «. For many purposes these should count as one. Making them one is normalization.
The point is to reduce the number of types while keeping what the task needs. A frequency list that keeps Le and le apart splits the count of one of the most frequent words in two. A search for chien that does not find chiens misses every plural. A comparison of two lists of terms in which one list is in lowercase and the other is not finds no matches at all.
Normalizing and filtering
Normalization is one of two ways to reduce the number of types, and the two are easy to confuse because both leave a shorter list. The table below sets out how they differ: in what happens to the occurrences.
| What happens to a type | What happens to its tokens | Examples | |
|---|---|---|---|
| Normalizing | It is merged with other types into one form | All of them are kept, counted under that one form | Lowercasing, removing accents, lemmatization |
| Filtering | It is removed | They are removed with it, so there are fewer tokens | Dropping stop words, punctuation, numbers or rare words |
Information retrieval treats them as two separate steps (Manning et al., 2008, §2.2.2–2.2.3). A count should say which of the two was applied: after normalizing, the text is still all there; after filtering, part of it is gone.
A filter many tools offer is a list of stop words, the words that occur in every text and tell you little about its subject.
Dropping them is useful when the subject is what you are after and useless when the grammar is.
An example on a Dutch corpus
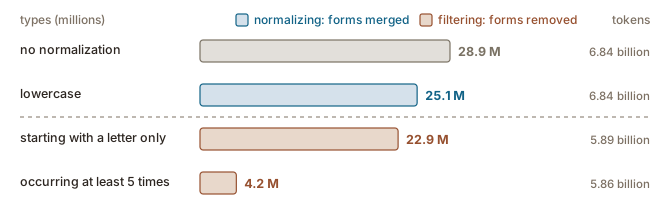
The effect on a corpus corpuscorpus corporacorpus A collection of written texts, speech recordings or transcribed language assembled for analysis or use in language technology (plural: corpora).Ensemble de textes écrits, d'enregistrements de parole ou de langue transcrite réuni pour l'analyse ou pour les technologies langagières. is large, and Figure 1figure 1 shows one normalization followed by two filters on a web corpus of Dutch of 6.8 billion tokens.
- Putting everything in lowercase normalizes. It removes almost four million types and leaves the number of tokens exactly as it was: every occurrence is still there, written in fewer ways.
- Keeping only the types that start with a letter filters. It removes two million more types and almost a billion tokens, because punctuation marks, numbers and symbols are few types but occur everywhere.
- Keeping only the types that occur at least five times filters too. It removes 18.7 million types but only about 30 million tokens, under 1 % of the corpus, since each of those types occurs at most four times.
Four million types remain of the original twenty-nine.The token and word counts are Sketch Engine’s own statistics for nlTenTen20, a crawl of the Dutch web from 2020 (6 836 979 371 tokens, 5 890 009 964 words); the type counts come from my word lists on that corpus, with each filter added in turn. The 5.89 billion tokens left after the second filter are the corpus’s word count, since Sketch Engine counts as a word every token that starts with a letter (Sketch Engine glossary, “word”, read 6 October 2026).
The usual normalizations
The table below lists normalizations that tools commonly offer, with what each one changes and what it can cost.
| Operation | Example | What it loses |
|---|---|---|
| Case folding, everything in lowercase | Le, LE, le become le | The capital that tells Pierre from pierre, or a sentence start from a name |
| Removing accents | été, ete become ete | The difference between cote, côte, côté and coté |
| Unifying quotation marks and apostrophes | «, ”, „ become ”; ’ and ’ become ’ | Nothing, in most tasks |
| Unifying numbers | 10 000 and 10.000 become 10000; or every number becomes one placeholder, so 2026, 3,5 and 10 000 are all NUM | The thousands convention that told you the language; with a placeholder, the value itself |
| Expanding contractions | don’t becomes do not; du becomes de le | The written form, which a search then no longer finds |
| Unifying spelling variants | colour and color become color | The variety that told you where the text was written |
| Lemmatization | livre, livres become livre; allons, allait become aller | The number, tense and person of each occurrence |
Expanding contractions
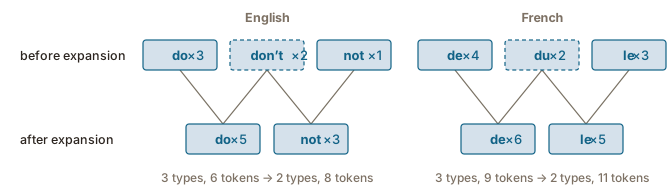
Expanding contractions is the one normalization in the table that adds tokens, since one written word becomes two.
- In English, don’t becomes do not, I’m becomes I am and won’t becomes will not.
- In French, du becomes de le, au becomes à le and aux becomes à les; c’est, which a tokenizer usually cuts into c’ and est, becomes ce est.
It is still a normalization, because nothing is removed: the number of types falls while the number of tokens rises, as Figure 2figure 2 shows. After it, don’t and do not are the same form, and the negation in don’t, won’t or isn’t is counted with every other not. In French, the types du, au and aux disappear: the preposition in them is counted under de or à, and the article under le or les. Some expansions need a decision first: it’s is it is in it’s raining and it has in it’s been raining.
The line between this and tokenization is not sharp. Cutting doesn’t into does and n’t only cuts what is written, which is tokenization; writing n’t as not, or du as de le, changes the letters, which is normalization. Many tools do both in one step, and the list of tokenization rules built for French in the tokenization chapter ends with one that turns au, du and des into two words (see also the Tokenizing a text with rules page) (voir aussi la page Segmenter un texte avec des règles).
The forms an expansion produces are not always real words: ce est and de le are not French. They are there so that a tagger can label the pronoun and the verb, or the preposition and the article, separately. The annotated corpus of the part-of-speech tagging chapter shows the tokenization side of the same choice: it cuts can’t into ca and n’t, the form English tagsets expect, and ca is not an English word either (see also the Practice: tagging watch with probabilities page) (voir aussi la page Exercices : étiqueter montre avec des probabilités).
Choosing what to normalize and filter
Every normalization and every filter loses something, and the loss is only acceptable if the task does not need what was lost. Lowercasing is right for a frequency list and wrong for finding proper names. Removing accents is right for a rough search and wrong for French, where a and à are two words. Dropping stop words is right for finding the topic of a text and wrong for tagging its grammar. So both are chosen per task, and the choice should be stated, because a count or a score made after one set of normalizations and filters is not comparable to a count made after another.
Moins de types pour le même texte
Une fois un texte découpé en occurrences, beaucoup de ses types sont le même mot sous des habits différents : Le et le, colour et color, livre et livres, ” et «. Pour bien des usages, ils devraient compter pour un. Les ramener à une seule forme, c’est la normalisation.
Le but est de réduire le nombre de types tout en gardant ce dont la tâche a besoin. Une liste de fréquences qui sépare Le et le coupe en deux le décompte de l’un des mots les plus fréquents. Une recherche de chien qui ne trouve pas chiens manque tous les pluriels. Une comparaison de deux listes de termes, l’une en minuscules et l’autre non, ne trouve aucune correspondance.
Normaliser et filtrer
La normalisation est l’une des deux façons de réduire le nombre de types, et on confond facilement les deux, puisque l’une comme l’autre donne une liste plus courte. Le tableau ci-dessous montre en quoi elles diffèrent : dans ce qu’il advient des occurrences.
| Ce que devient un type | Ce que deviennent ses occurrences | Exemples | |
|---|---|---|---|
| Normaliser | Il est fusionné avec d’autres types en une seule forme | Elles sont toutes gardées, comptées sous cette forme | Mise en minuscules, suppression des accents, lemmatisation |
| Filtrer | Il est supprimé | Elles disparaissent avec lui : il y a moins d’occurrences | Suppression des mots vides, de la ponctuation, des nombres ou des mots rares |
La recherche d’information en fait deux étapes distinctes (Manning et al., 2008, §2.2.2–2.2.3). Un décompte devrait préciser laquelle des deux a été appliquée : après une normalisation, le texte est encore là en entier ; après un filtrage, une partie a disparu.
Un filtre que proposent beaucoup d’outils est une liste de mots vides, les mots qui apparaissent dans tous les textes et en disent peu sur leur sujet.
Les supprimer est utile quand on s’intéresse au sujet d’un texte, et inutile quand on s’intéresse à sa grammaire.
Un exemple sur un corpus néerlandais
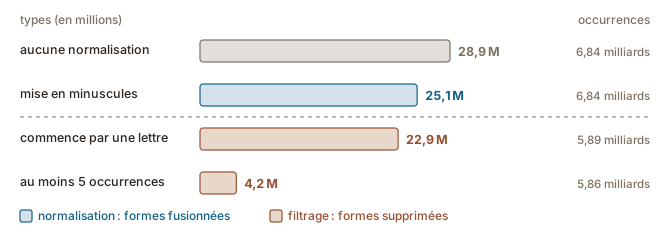
L’effet sur un corpus corpuscorpus corporacorpus A collection of written texts, speech recordings or transcribed language assembled for analysis or use in language technology (plural: corpora).Ensemble de textes écrits, d'enregistrements de parole ou de langue transcrite réuni pour l'analyse ou pour les technologies langagières. est important, et la Figure 1figure 1 montre une normalisation suivie de deux filtres sur un corpus du Web néerlandais de 6,8 milliards d’occurrences.
- La mise en minuscules normalise. Elle supprime près de quatre millions de types et laisse le nombre d’occurrences exactement tel quel : chaque occurrence est toujours là, écrite de moins de façons.
- Ne garder que les types qui commencent par une lettre est un filtre. Il supprime deux millions de types de plus et près d’un milliard d’occurrences, parce que les signes de ponctuation, les nombres et les symboles sont peu nombreux comme types, mais apparaissent partout.
- Ne garder que les types qui apparaissent au moins cinq fois est aussi un filtre. Il supprime 18,7 millions de types, mais seulement 30 millions d’occurrences environ, moins de 1 % du corpus, puisque chacun de ces types apparaît au plus quatre fois.
Il reste quatre millions de types sur les vingt-neuf du départ.Les nombres d’occurrences et de mots sont les statistiques de Sketch Engine pour nlTenTen20, une collecte du Web néerlandais de 2020 (6 836 979 371 occurrences, 5 890 009 964 mots) ; les nombres de types viennent de mes listes de mots sur ce corpus, en ajoutant chaque filtre l’un après l’autre. Les 5,89 milliards d’occurrences qui restent après le deuxième filtre correspondent au nombre de mots du corpus, puisque Sketch Engine compte comme mot toute occurrence qui commence par une lettre (glossaire de Sketch Engine, « word », consulté le 6 octobre 2026).
Les normalisations courantes
Le tableau ci-dessous présente des normalisations que les outils proposent souvent, avec ce que chacune change et ce qu’elle peut coûter.
| Opération | Exemple | Ce qu’elle fait perdre |
|---|---|---|
| Mise en minuscules | Le, LE, le deviennent le | La majuscule qui distingue Pierre de pierre, ou un début de phrase d’un nom |
| Suppression des accents | été, ete deviennent ete | La différence entre cote, côte, côté et coté |
| Uniformisation des guillemets et des apostrophes | «, ”, „ deviennent ” ; ’ et ’ deviennent ’ | Rien, pour la plupart des tâches |
| Uniformisation des nombres | 10 000 et 10.000 deviennent 10000 ; ou bien chaque nombre est remplacé par un même symbole, de sorte que 2026, 3,5 et 10 000 deviennent tous NUM | La convention des milliers, qui indiquait la langue ; avec un symbole, la valeur elle-même |
| Décomposition des contractions | don’t devient do not ; du devient de le | La forme écrite, qu’une recherche ne trouve plus |
| Uniformisation des variantes orthographiques | colour et color deviennent color | La variété, qui indiquait où le texte a été écrit |
| Lemmatisation | livre, livres deviennent livre ; allons, allait deviennent aller | Le nombre, le temps et la personne de chaque occurrence |
Décomposer les contractions
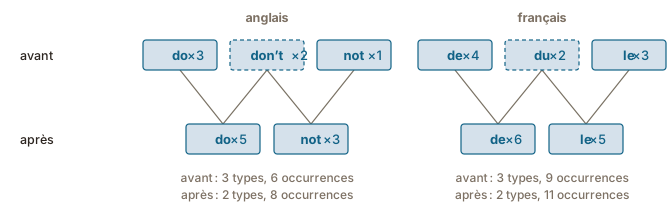
La décomposition des contractions est la seule normalisation du tableau qui ajoute des occurrences, puisqu’un mot écrit en devient deux.
- En anglais, don’t devient do not, I’m devient I am et won’t devient will not.
- En français, du devient de le, au devient à le et aux devient à les ; c’est, qu’un segmenteur coupe d’ordinaire en c’ et est, devient ce est.
C’est tout de même une normalisation, puisque rien n’est supprimé : le nombre de types baisse pendant que le nombre d’occurrences augmente, comme le montre la Figure 2figure 2. Après la décomposition, don’t et do not sont la même forme, et la négation de don’t, won’t ou isn’t est comptée avec tous les autres not. En français, les types du, au et aux disparaissent : leur préposition est comptée sous de ou à, et leur article sous le ou les. Certaines décompositions demandent d’abord de trancher : it’s vaut it is dans it’s raining et it has dans it’s been raining.
La frontière avec la segmentation en unités lexicales n’est pas nette. Couper doesn’t en does et n’t ne fait que couper ce qui est écrit, c’est de la segmentation ; écrire n’t sous la forme not, ou du sous la forme de le, change les lettres, c’est de la normalisation. Beaucoup d’outils font les deux en une seule étape, et la liste de règles de segmentation construite pour le français dans le chapitre sur la segmentation se termine par une règle qui transforme au, du et des en deux mots (see also the Tokenizing a text with rules page) (voir aussi la page Segmenter un texte avec des règles).
Les formes qu’une décomposition produit ne sont pas toujours de vrais mots : ce est et de le ne sont pas du français. Elles servent à ce qu’un étiqueteur puisse étiqueter séparément le pronom et le verbe, ou la préposition et l’article. Le corpus annoté du chapitre sur l’étiquetage morphosyntaxique a été normalisé de cette façon, c’est pourquoi il contient la phrase mais ce est vrai (see also the Practice: tagging watch with probabilities page) (voir aussi la page Exercices : étiqueter montre avec des probabilités).
Choisir ce qu’on normalise et ce qu’on filtre
Toute normalisation et tout filtrage font perdre quelque chose, et la perte n’est acceptable que si la tâche n’a pas besoin de ce qui a été perdu. La mise en minuscules convient à une liste de fréquences, mais pas à la recherche de noms propres. La suppression des accents convient à une recherche approximative, mais pas au français, où a et à sont deux mots. La suppression des mots vides convient pour trouver le sujet d’un texte, mais pas pour en étiqueter la grammaire. On les choisit donc selon la tâche, et ce choix devrait être indiqué, parce qu’un décompte ou un score obtenu après un ensemble de normalisations et de filtres n’est pas comparable à un décompte obtenu après un autre.
Sources
- Jurafsky, D., & Martin, J. H. (2024). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft of 20 August 2024, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/ed3bookaug20_2024.pdf
- Manning, C. D., Raghavan, P., & Schütze, H. (2008). Introduction to Information Retrieval. Cambridge University Press. https://nlp.stanford.edu/IR-book/information-retrieval-book.html
Sources
- Jurafsky, D., & Martin, J. H. (2024). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft of 20 août 2024, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/ed3bookaug20_2024.pdf
- Manning, C. D., Raghavan, P., & Schütze, H. (2008). Introduction to Information Retrieval. Cambridge University Press. https://nlp.stanford.edu/IR-book/information-retrieval-book.html