Checking the answerVérifier la réponse
TRA6008 S3 · in classS3 · en classe
What to check
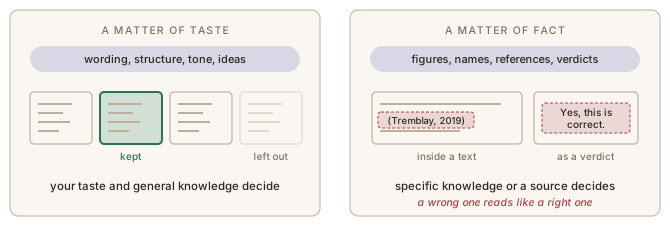
Some of what a model gives you is a matter of taste: the wording of a draft, the tone of an email, a list of possible titles (Figure 1figure 1). Your own taste and general knowledge are enough to judge it. Other parts are a matter of fact, with an exact answer that takes specific knowledge to check: a name, a figure, a reference, or a verdict such as whether a translation says what the original says. A wrong fact reads exactly like a right one, however plausible and confident the answer around it (see also the Hallucinations chapter, in the Critical issues with LLMs module) (voir aussi le chapitre Les fabulations de l'IA, dans le module Enjeux critiques des GML). So unless you already know the answer, decide which facts you will check.
What each check can and cannot do
| Check | What it helps with | Its limits |
|---|---|---|
| Put a document with the information in the context | the answer is more likely to be right about what the document says | no guarantee: the model can still misquote the document, misread it, or read more into it than it says |
| Turn on web search and open the sources it cites | the answer is based on pages you can read | the same limits, and the pages themselves may be unreliable, so you also judge the sources |
| Ask the same model the same question again, in a new conversation | if the two answers differ, you know there is a problem | a model can easily be wrong the same way twice |
| Ask a second model | a mistake only one of the two makes shows up as a disagreement | both can make the same mistake, for instance a widely repeated misconception |
| Ask the model to check its answer | a second pass that may catch some errors | no guarantee: unless it can search, it has nothing new to consult, and it can be confidently wrong again |
| Ask for the case against, for instance “list what a demanding reviewer would object to” | brings out weaknesses that a model prone to sycophancy sycophancycomplaisance de l'IA AI safetysécurité de l'IA The tendency of a language model trained on human preferences to agree with the user, revise a correct answer under challenge, or flatter, partly because agreement was rated well during training.Tendance d'un modèle de langue entraîné sur des préférences humaines à abonder dans le sens de l'utilisateur, à revenir sur une réponse correcte quand on la conteste ou à flatter, en partie parce que l'accord a été bien noté pendant l'entraînement. rarely mentions on its own | the objections are generated too, and can be invented or miss the real problem |
| Ask the model how it reached the answer | more intermediate steps that you can check one by one | the explanation is not necessarily how the answer was actually produced, and any step can be wrong |
| Try the model on a case whose answer you already know | shows whether it handles this kind of task at all | a later case can still go wrong |
| Look the fact up yourself in a reliable source | the only check that does not depend on a model | it takes time, so keep it for the important facts |
Every check but the last goes through a model, so it can fail the way the answer did. A rerun is still useful: answers whose meaning varies from one run to the next are a measurable sign of invented content (Farquhar et al., 2024) (see also the LLMs are non-deterministic page, in the LLM lifecycle module) (voir aussi la page Les GML ne sont pas déterministes, dans le module Cycle de vie des GML). It is worth its cost for one claim you need to trust, but running the same question again by reflex adds to the energy a model uses (see also the Putting it in proportion page, in the Critical issues with LLMs module) (voir aussi la page Remettre en proportion, dans le module Enjeux critiques des GML).
Quoi vérifier
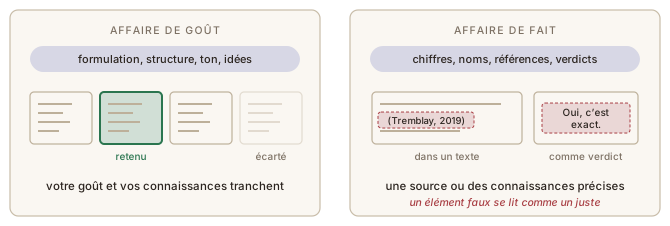
Une partie de ce qu’un modèle vous donne relève du goût : la formulation d’un brouillon, le ton d’un courriel, une liste de titres possibles (Figure 1figure 1). Votre goût et vos connaissances générales suffisent à en juger. D’autres éléments relèvent du fait, avec une réponse exacte qui demande des connaissances précises : un nom, un chiffre, une référence, ou un verdict, par exemple si une traduction dit bien ce que dit l’original. Un fait faux se lit exactement comme un fait juste, aussi plausible et assurée que soit la réponse qui l’entoure (see also the Hallucinations chapter, in the Critical issues with LLMs module) (voir aussi le chapitre Les fabulations de l'IA, dans le module Enjeux critiques des GML). À moins de déjà connaître la réponse, décidez donc quels faits vous allez vérifier.
Ce que chaque vérification peut et ne peut pas faire
| Vérification | Ce qu’elle apporte | Ses limites |
|---|---|---|
| Mettre dans le contexte un document contenant l’information | la réponse a plus de chances d’être juste sur ce que dit le document | aucune garantie : le modèle peut mal citer le document, le lire de travers ou lui faire dire plus qu’il ne dit |
| Activer la recherche web et ouvrir les sources citées | la réponse s’appuie sur des pages que vous pouvez lire | les mêmes limites, et les pages elles-mêmes peuvent être peu fiables : vous jugez aussi les sources |
| Reposer la même question au même modèle, dans une nouvelle conversation | si les deux réponses diffèrent, vous savez qu’il y a un problème | un modèle peut très bien se tromper deux fois de la même façon |
| Poser la question à un deuxième modèle | une erreur que l’un des deux seulement commet apparaît comme un désaccord | les deux peuvent commettre la même erreur, par exemple une idée fausse très répandue |
| Demander au modèle de vérifier sa réponse | un deuxième passage qui attrape parfois des erreurs | aucune garantie : sauf s’il peut chercher, il n’a rien de nouveau à consulter, et il peut se tromper de nouveau avec assurance |
| Demander ce qu’on pourrait objecter, par exemple « liste ce qu’un évaluateur exigeant reprocherait à ce texte » | fait ressortir des faiblesses qu’un modèle porté à la complaisance sycophancycomplaisance de l'IA AI safetysécurité de l'IA The tendency of a language model trained on human preferences to agree with the user, revise a correct answer under challenge, or flatter, partly because agreement was rated well during training.Tendance d'un modèle de langue entraîné sur des préférences humaines à abonder dans le sens de l'utilisateur, à revenir sur une réponse correcte quand on la conteste ou à flatter, en partie parce que l'accord a été bien noté pendant l'entraînement. mentionne rarement de lui-même | les objections aussi sont générées : elles peuvent être inventées ou passer à côté du vrai problème |
| Demander au modèle comment il est arrivé à sa réponse | des étapes intermédiaires que vous pouvez vérifier une à une | l’explication ne correspond pas forcément à la façon dont la réponse a été produite, et chaque étape peut être fausse |
| Essayer le modèle sur un cas dont vous connaissez déjà la réponse | montre s’il se débrouille avec ce genre de tâche | un cas suivant peut quand même mal tourner |
| Chercher vous-même l’information dans une source fiable | la seule vérification qui ne dépend pas d’un modèle | elle prend du temps : gardez-la pour les faits qui comptent |
Toutes les vérifications sauf la dernière passent par un modèle : elles peuvent échouer comme la réponse a échoué. Reposer la question reste utile : des réponses dont le sens varie d’une exécution à l’autre sont un signe mesurable de contenu inventé (Farquhar et al., 2024) (see also the LLMs are non-deterministic page, in the LLM lifecycle module) (voir aussi la page Les GML ne sont pas déterministes, dans le module Cycle de vie des GML). Cela vaut son coût pour une affirmation à laquelle vous devez vous fier, mais reposer la même question par réflexe ajoute à l’énergie que consomme un modèle (see also the Putting it in proportion page, in the Critical issues with LLMs module) (voir aussi la page Remettre en proportion, dans le module Enjeux critiques des GML).
Sources
- Farquhar, S., Kossen, J., Kuhn, L., & Gal, Y. (2024). Detecting hallucinations in large language models using semantic entropy. Nature, 630(8017), 625–630. https://doi.org/10.1038/s41586-024-07421-0
Sources
- Farquhar, S., Kossen, J., Kuhn, L., & Gal, Y. (2024). Detecting hallucinations in large language models using semantic entropy. Nature, 630(8017), 625–630. https://doi.org/10.1038/s41586-024-07421-0