The training loop: predict, compare, adjustLa boucle d'entraînement : prédire, comparer, ajuster
TRA6008 To read for S3À lire pour la S3
What pretraining is
Once the training data has been prepared and a tokenizer tokenization²jetonisation² language modelsmodèles de langue The process of converting text into an ordered sequence of tokens that a language model can process.Processus de conversion d'un texte en une séquence ordonnée de jetons qu'un modèle de langue peut traiter. is ready, you can start training the next-word predictors by having them do exactly that: try to predict the next word, and get better at it. For a large language model, that step is called pretraining.
What one training step does
Pretraining works the way supervised learning does (see also the From rules to machine learning chapter, in the Foundations of AI & NLP module) (voir aussi le chapitre Des règles à l'apprentissage automatique, dans le module Fondements de l'IA et du TAL), with one difference that makes the scale possible.
A stretch of text is taken from the corpus. The model is shown the beginning and asked which token comes next. It produces its probabilities, and those get compared against the token that actually came next. If the right token was given a low probability, the parameters are adjusted so that the same context would push that token a little higher next time.
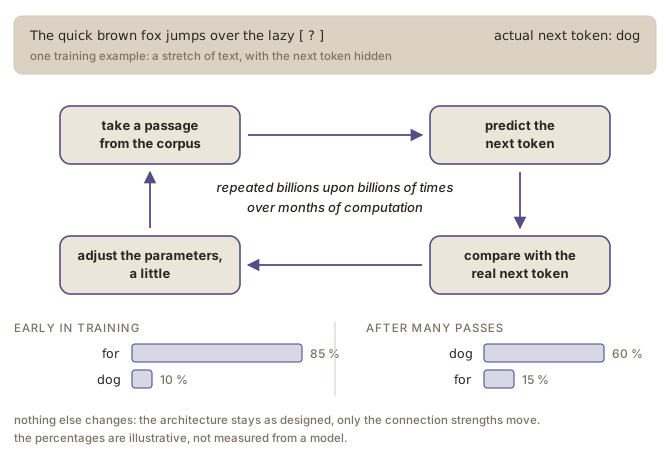
Each adjustment is tiny. A usable model comes out of their number, across a corpus of trillions of tokens.
Why the corpus needs no labels
Pretraining is affordable at all because the corpus needs no annotation. Every position in every sentence is a ready-made exercise: cover the next token, predict it, uncover it, compare. The text is both the question and the answer key, so a trillion tokens of raw web text can be trained on without anyone marking up a single example.
That arrangement has a name. Training on labels a person wrote is supervised learning; finding structure in data with no answers at all is unsupervised learning unsupervised learningapprentissage non supervisé machine learningapprentissage automatique A machine-learning approach that seeks patterns or structure in data without being given a target label or expected output for each training example.Approche d'apprentissage automatique qui cherche des régularités ou des structures dans les données sans recevoir d'étiquette cible ni de sortie attendue pour chaque exemple d'entraînement. ; taking the answers from the data itself, as with next-word prediction, is neither: that is self-supervised learning.
The human decisions are concentrated in assembling the corpus and deciding what goes into it. The training itself is one arithmetic step repeated until the budget runs out.
Ce qu’est le préentraînement
Une fois les données d’entraînement préparées et un tokenizer tokenization²jetonisation² language modelsmodèles de langue The process of converting text into an ordered sequence of tokens that a language model can process.Processus de conversion d'un texte en une séquence ordonnée de jetons qu'un modèle de langue peut traiter. prêt, vous pouvez commencer à entraîner les prédicteurs du mot suivant en leur faisant faire exactement cela : essayer de prédire le mot suivant, et s’y améliorer. Pour un grand modèle de langue, cette étape s’appelle le préentraînement.
Ce que fait une étape d’entraînement
Le préentraînement fonctionne comme l’apprentissage supervisé que vous avez déjà rencontré (see also the From rules to machine learning chapter, in the Foundations of AI & NLP module) (voir aussi le chapitre Des règles à l'apprentissage automatique, dans le module Fondements de l'IA et du TAL), à une différence près, et c’est elle qui rend cette échelle possible.
On prend un passage du corpus. On montre le début au modèle et on lui demande quel jeton vient ensuite. Il produit ses probabilités, qui sont comparées au jeton qui suivait réellement. Si le bon jeton a reçu une probabilité faible, les paramètres sont ajustés de sorte que le même contexte pousse ce jeton un peu plus haut la prochaine fois.
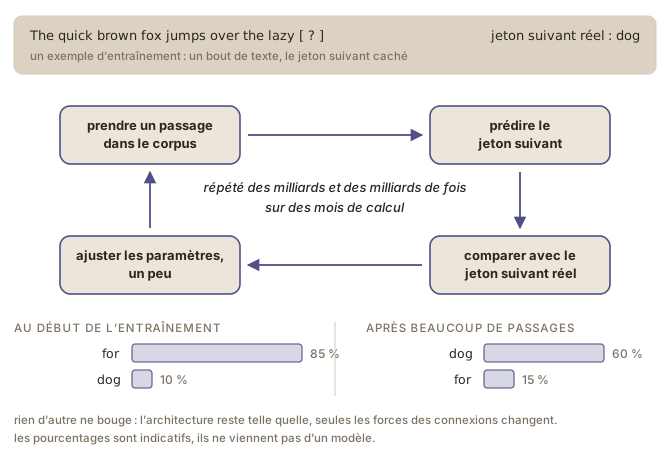
Chaque ajustement est minuscule. Un modèle utilisable naît de leur nombre, sur un corpus de milliers de milliards de jetons.
Pourquoi le corpus n’a pas besoin d’étiquettes
Le préentraînement n’est abordable que parce que le corpus n’a besoin d’aucune annotation. Chaque position de chaque phrase est un exercice tout prêt : cacher le jeton suivant, le prédire, le découvrir, comparer. Le texte est à la fois la question et le corrigé, si bien qu’on peut entraîner un modèle sur mille milliards de jetons de texte brut tiré du Web sans que personne n’annote un seul exemple.
Cette façon de faire a un nom. Entraîner sur des étiquettes écrites par une personne, c’est l’apprentissage supervisé ; trouver des structures dans des données sans aucune réponse, c’est l’apprentissage non supervisé unsupervised learningapprentissage non supervisé machine learningapprentissage automatique A machine-learning approach that seeks patterns or structure in data without being given a target label or expected output for each training example.Approche d'apprentissage automatique qui cherche des régularités ou des structures dans les données sans recevoir d'étiquette cible ni de sortie attendue pour chaque exemple d'entraînement. ; prendre les réponses dans les données elles-mêmes, comme le fait la prédiction du mot suivant, n’est ni l’un ni l’autre : c’est l’apprentissage autosupervisé.
Les décisions humaines se concentrent dans la constitution du corpus et le choix de ce qui y entre. L’entraînement lui-même est une seule opération arithmétique, répétée jusqu’à épuisement du budget.
Sources
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Sources
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/