PrintedImprimé le·aylart.github.io/learn·
CC BY-NC 4.0
🔒 TRA2600 · Practical informationTRA2600 · Informations pratiquesis course material (TRA2600). Open it on the site to include it here.est réservé au cours (TRA2600). Ouvrez-le sur le site pour l'inclure ici.
Bienvenue dans TRA2600. Tout ce qui concerne le cours se trouve ici, tenu à
jour tout au long du trimestre.
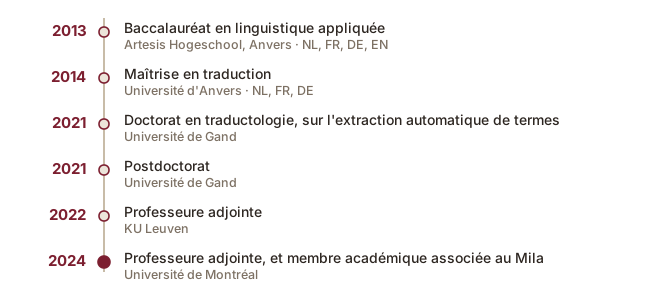
Qui je suis
Je m’appelle Ayla Rigouts Terryn.
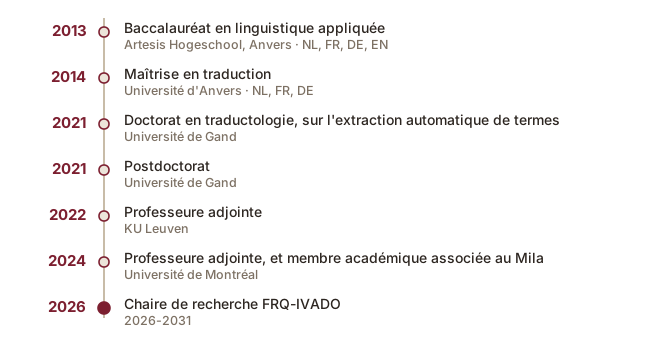
Figure 1. Mon parcours.
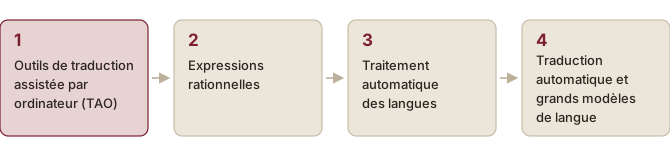
Ce que fait ce cours
Vous utilisez déjà des outils de traduction, et probablement aussi des outils
d’intelligence artificielle. TRA2600 vise à ce que vous compreniez comment ils
fonctionnent et comment on les évalue, plutôt que d’en rester à une utilisation
de surface. Cette compréhension vous rend plus efficace, et elle vous permet de
juger quel outil convient à une tâche, à quel moment l’employer, et quand
vous en passer.
Figure 2. Les cinq blocs du trimestre, dans l'ordre.
La première séance
Nous commençons par faire connaissance : un tour de table, et quelques
questions sur les outils que vous avez déjà utilisés et sur ce que vous pensez
de l’intelligence artificielle aujourd’hui. Il n’y a pas de bonne réponse à ces
questions, et vos réponses nous resserviront en fin de trimestre, au débat du
9 décembre 2026.
La séance se poursuit avec :
le plan de cours et le calendrier ;
une visite de ce site ;
les mémoires de traduction ;
l’installation de Wordfast, en fin de séance.
This page is only available in French.
Course outlinePlan de cours
Description officielle
Approfondissement des connaissances et exploitation des outils informatiques
utilisés en traduction, en terminologie et en localisation. Ateliers
pratiques.
Introduction
Ce cours a pour but d’approfondir la maîtrise des outils technologiques qui
transforment la pratique de la traduction. À travers des activités théoriques
et pratiques, les étudiants et étudiantes découvriront l’état de l’art dans le
domaine des technologies de la traduction, développeront des compétences
pratiques pour utiliser ces outils de manière efficace et réfléchie, et
apprendront à s’adapter à un domaine en constante évolution.
Ce cours s’inscrit dans la continuité de TRA1600 et approfondit les
connaissances acquises. Les étudiants et étudiantes développeront des
compétences avancées en outils de traduction assistée par ordinateur (TAO),
découvriront les fondements du traitement automatique des langues (TAL) et
apprendront à utiliser et à évaluer de manière critique les technologies
fondées sur les grands modèles de langue (GML).
Objectifs généraux
Familiariser les étudiants et étudiantes avec l’état de l’art des technologies
de la traduction : leur offrir une vue d’ensemble des outils disponibles, de
leurs fonctions principales et de leurs limites, afin qu’ils comprennent ce
qu’ils peuvent attendre de ces technologies dans un environnement
professionnel.
Former des utilisateurs et utilisatrices compétents des outils technologiques
les plus pertinents : initier les étudiants et étudiantes à la pratique des
outils essentiels, avec une progression du concret vers l’abstrait : d’abord
maîtriser les outils dans des contextes pratiques, puis comprendre les
fondements théoriques qui permettent une utilisation critique et adaptable.
Développer une capacité à évaluer et à apprendre les technologies de manière
autonome : enseigner aux étudiants et étudiantes à évaluer de manière critique
les nouvelles technologies, à comprendre leurs implications et à s’adapter aux
évolutions rapides du domaine, afin de garantir leur pertinence
professionnelle sur le long terme.
Objectifs spécifiques
À la fin du cours, vous devriez être en mesure de :
utiliser efficacement les outils de traduction assistée par ordinateur (TAO) ;
utiliser les expressions rationnelles (regex) dans des contextes pertinents
pour la traduction ;
comprendre les concepts clés du TAL et l’évolution des technologies
langagières ;
évaluer les technologies de traduction à l’aide de méthodes et de métriques
appropriées ;
exploiter les grands modèles de langue de manière efficace et critique ;
développer une réflexion critique et argumentée sur la place de
l’intelligence artificielle dans les professions langagières.
This page is only available in French.
Calendar and structureCalendrier et structure
Quand a lieu le cours
Les séances ont lieu le mercredi, de 15 h 30 à 18 h 30. Treize séances de
cours, plus l’examen final, qui a lieu le mercredi 16 décembre 2026 dans la même case
horaire.
Chaque bloc a son évaluation.
Les séances
Le tableau donne tous les mercredis du trimestre, y compris ceux sans cours,
pour que les interruptions soient visibles. Les séances teintées portent une
évaluation.
Séance
Date
Sujet
1
2 septembre 2026
Introduction ; TAO : mémoires de traduction et installation de Wordfast
2
9 septembre 2026
Wordfast : premier projet et balises ; les formats d'échange
3
16 septembre 2026
Wordfast : balises et traduction automatique, puis alignement
4
23 septembre 2026
Wordfast : assurance de la qualité et livraison, sur le projet d'un autre traducteur
30 septembre 2026 · Pas de cours (Journée nationale de la vérité et de la réconciliation)
5
7 octobre 2026
TAL 1 : des règles aux grands modèles de langue ; segmentation et étiquetage morphosyntaxique
6
14 octobre 2026
Examen de mi-session sur la TAO (en classe, sur ordinateur)
21 octobre 2026 · Pas de cours (période d'activités libres)
7
28 octobre 2026
Terminologie : conférence invitée de Kim Lacroix
8
4 novembre 2026
Examen sur les expressions rationnelles, en début de séance ; TAL 2 : extraction terminologique ; lancement du travail pratique
9
11 novembre 2026
TAL 3 : évaluation
10
18 novembre 2026
Traduction automatique (atelier) et son évaluation
11
25 novembre 2026
Grands modèles de langue 1
12
2 décembre 2026
Grands modèles de langue 2
13
9 décembre 2026
Débat noté ; synthèse
14
16 décembre 2026
Examen final
Les deux semaines sans cours
le 30 septembre 2026, Journée nationale de la vérité et de la réconciliation ;
le 21 octobre 2026, pendant la période d’activités libres.
Le parcours sur les expressions rationnelles prend la place de la séance du
21 octobre 2026 et se travaille pour le reste en parallèle des séances. La page
Le parcours d’expressions
rationnelles donne le
rythme prévu, les dates et le fonctionnement de l’examen.
In classEn classeLa séance 1 porte sur les mémoires de traduction et se termine par l'installation de Wordfast. Les séances 2 à 4 se font avec le logiciel ouvert : le premier projet à la séance 2 ; un bref retour sur les formats d'échange, puis les balises et l'alignement à la séance 3 ; l'assurance de la qualité et la livraison à la séance 4, sur le projet d'un autre traducteur que vous reprenez. Pendant les exercices, vous travaillez seul, mais je suis là.
Outside classHors classeL'écosystème de la TAO avant la séance 2, les pages sur les formats d'échange avant la séance 3. Avant la séance 4, vous vous assurez de comprendre tout ce que vous avez fait dans Wordfast jusque-là. Ce projet, commencé à la séance 4, se termine à la maison : c'est la préparation à l'examen du 14 octobre 2026. Le reste du temps hors classe va au parcours d'expressions rationnelles.
In classEn classeAucune séance : seul l'examen sur papier a lieu en classe, en début de séance, le 4 novembre 2026.
Outside classHors classeTout le parcours, en ligne et seul, à votre rythme. Rythme recommandé : le chapitre 1 pour la séance 3, le chapitre 2 pour la séance 4, le chapitre 3 pendant la semaine sans séance de septembre, et les deux derniers après l'examen de mi-session.
In classEn classeLa séance 5 pose les principes du TAL. La conférence de Kim Lacroix, à la séance 7, montre le métier. La séance 8 réunit ces principes dans l'extraction terminologique et lance le travail pratique, et la séance 9 porte sur l'évaluation, avec le calcul de l'accord inter-annotateurs en classe.
Outside classHors classeLa théorie se lit avant la séance, ce qui laisse le temps de travailler en classe. Le travail pratique se fait en deux temps : l'identification des termes, lancée à la séance 8 et remise au début de la séance 9, puis l'accord et l'évaluation des outils, remis le 29 novembre 2026.
4Séance 10
Traduction automatique
In classEn classeUn atelier de traduction automatique et de son évaluation.
Outside classHors classeLa théorie de la traduction automatique se lit avant la séance, qui est un atelier.
5Séances 11 à 13
Grands modèles de langue
In classEn classeDeux séances sur les grands modèles de langue, puis le débat noté et la synthèse à la séance 13. L'examen final a lieu le 16 décembre 2026.
Outside classHors classeLa préparation du débat : les équipes, les motions et les positions sont annoncées le 25 novembre 2026.
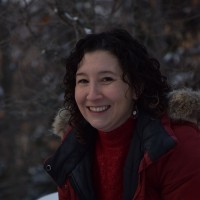
La conférence invitée
Kim Lacroix, terminologue au Bureau de la traduction, vient à la séance 7. Elle
parlera de son travail et de la place qu’y prennent les technologies.
Figure 3. Kim Lacroix, terminologue au Bureau de la traduction.
Elle arrive juste avant le travail pratique, lancé à la séance 8 : la
conférence montre à quoi ressemble la terminologie comme métier, chez le plus
gros employeur du domaine au pays.
Son contenu fait partie de la matière du cours au même titre que le reste, et
il est évaluable à l’examen final.
This page is only available in French.
EvaluationÉvaluation
Les composantes et leur poids
Composante
Pondération
Format
Date
Examen de mi-session (TAO)
25 %
En classe, sur ordinateur
14 octobre 2026
Examen sur les expressions rationnelles
15 %
Sur papier, en classe
4 novembre 2026
Travail sur l’extraction terminologique
15 %
À remettre en deux temps
11 novembre 2026 et 29 novembre 2026
Questionnaires de préparation
5 %
En ligne, cinq questionnaires à 1 % chacun
Au fil de la session
Débat noté
5 %
En classe
9 décembre 2026
Examen final
35 %
Sur papier, en classe
16 décembre 2026
Ce que couvre chaque évaluation
Examen de mi-session · 25 %
Il est pratique : vous travaillez dans Wordfast, sur ordinateur, pendant la
séance. Il porte sur tout le bloc 1, y compris la lecture sur les formats
d’échange et le chapitre sur l’alignement.
Examen sur les expressions rationnelles · 15 %
Il a lieu en début de séance le
4 novembre 2026, sur papier. Ses questions reprennent les exercices du parcours en
ligne. La page Le parcours d’expressions
rationnelles
détaille comment il est construit et comment il est corrigé.
Travail sur l’extraction terminologique · 15 %
Il comporte une composante de comparaison avec un ou une partenaire, mais
l’évaluation reste individuelle. Il se fait en deux temps : la liste de termes
individuelle est à remettre au début de la séance 9, le 11 novembre 2026, le
travail complet le 29 novembre 2026. La première moitié, l’identification des
termes, est lancée à la séance 8, après le premier cours sur l’extraction
terminologique. Vous n’avez rien à faire pour ce travail avant la séance 8 : d’ici là,
l’examen de mi-session sur Wordfast et le parcours d’expressions
rationnelles passent en premier.
Questionnaires de préparation · 5 %
Ce sont des questionnaires en ligne à remplir avant certaines séances. Il y en
a cinq, et chacun compte pour 1 %.
Débat noté · 5 %
Il porte sur l’intelligence artificielle et la traduction. Les positions sont
assignées, et l’évaluation est individuelle : elle porte sur la qualité de
l’argumentation et sur la mobilisation des notions du cours, jamais sur la
position défendue.
Examen final · 35 %
Il est écrit, sur papier, en classe. Il porte sur le bloc 3, les bases du
traitement automatique des langues et l’extraction terminologique, sur le bloc
4, la traduction automatique, sur le bloc 5, les grands modèles de langue, ainsi
que sur la conférence invitée en terminologie. Après la période d’activités libres
d’octobre, je publie des exemples de questions, pour que vous sachiez à quels
types de questions vous attendre et que vous puissiez vous préparer.
Les dates des évaluations
Élément
Date
Chapitre 1 du parcours regex, date recommandée
mercredi 16 septembre 2026
Chapitre 2 du parcours regex, date recommandée
mercredi 23 septembre 2026
Examen de mi-session sur la TAO
mercredi 14 octobre 2026
Examen sur les expressions rationnelles
mercredi 4 novembre 2026, début de séance
Liste de termes individuelle
mercredi 11 novembre 2026, début de séance
Équipes, motions et positions du débat
mercredi 25 novembre 2026
Travail terminologique complet
dimanche 29 novembre 2026, 23 h 59
Débat noté
mercredi 9 décembre 2026
Examen final
mercredi 16 décembre 2026
Correction et retards
Pour tout travail évalué, des points pourront être retranchés pour les fautes
de langue, avec un maximum de 20 % de la note totale.
Les retards seront pénalisés à hauteur de 20 % par jour de retard, sauf en cas
de circonstances exceptionnelles justifiées. Les délais sont communiqués dès
le début du cours, et il est attendu que les travaux soient remis à temps.
This page is only available in French.
Permitted resourcesRessources autorisées
Examen de mi-session sur la TAO
Cet examen évalue ce que vous savez faire avec un outil, donc tout ce qui
vous aiderait dans un vrai mandat est permis : vos notes, ce site, la
documentation de Wordfast, le web, la traduction automatique, un grand modèle
de langue.
Une seule interdiction : communiquer avec d’autres personnes, sous
n’importe quelle forme, pendant toute la durée de l’examen. Un document
partagé, une messagerie, un forum, un fil de classe et le fait de demander à
quelqu’un de chercher pour vous en font partie.
La limite est simple : un outil peut vous répondre, une personne non.
Examen sur les expressions rationnelles
Sur papier, sans aucune ressource : ni notes, ni appareil, ni testeur en ligne.
Vous écrivez les expressions à la main.
Examen final
Sur papier, sans aucune ressource.
Travail sur l’extraction terminologique
Les ressources permises sont précisées dans les consignes du travail, qui vous
sont remises à la séance 8.
This page is only available in French.
Mid-session exam: format and gradingExamen de mi-session : format et évaluation
Ce que vous faites
L’examen évalue ce que vous savez faire avec un outil, pas ce que vous pouvez
en réciter. Vous travaillez dans Wordfast pendant la séance, sur une tâche du
même genre que celles des séances 2 à 4, et vous traduisez du français vers
l’anglais comme dans tout le parcours.
Votre portable ou un poste du laboratoire, comme vous préférez.
Je suis présente pendant tout l’examen. Si vous êtes bloqué,
demandez-moi : je décide sur le coup s’il s’agit d’un problème du logiciel,
auquel cas je vous aide, ou de quelque chose que vous devriez pouvoir
résoudre vous-même.
Le chapitre sur l’alignement et les formats d’échange sont matière d’examen au
même titre que le reste, même s’ils ne passent qu’une fois en classe.
L’évaluation
Critère
Points
A. Mise en place : importation du projet, sans ressource d’un projet précédent ; ajout du document ; alignement et importation de la mémoire ; liste de blocage
12
B. Révision de la partie déjà traduite : erreurs repérées et corrigées
26
C. Traduction du reste : complétude, correspondances vérifiées, balises, traduction automatique utilisée et relue
21
D. Ressources : glossaire et mémoire corrigés
10
E. Livraison : documents exportés, paquet valide, mémoire exportée, ressources créées nommées selon la convention du cours
11
F. Journal de bord
20
La répartition des 100 points.
La traduction n’est pas notée dans le détail
Vous n’êtes pas évalué sur la finesse de votre traduction. Deux choses
comptent : ce qu’un lecteur attentif aurait vu, et ce que Wordfast vous aurait
signalé si vous l’aviez laissé faire.
Ce que vous avez le droit d’utiliser
Tout ce qui vous aiderait dans un vrai mandat, sauf la communication avec
d’autres personnes. La page Ressources
autorisées donne la
règle complète et ce qu’elle couvre.
This page is only available in French.
The regular expressions pathLe parcours d'expressions rationnelles
Vos marques de progression ne sont enregistrées nulle part
Le site n’a pas de comptes et ne conserve rien sur un serveur. Quand vous
réussissez un exercice, la marque est écrite dans la mémoire de votre
navigateur, sur cet ordinateur-là. Vous la perdez si vous effacez vos
données de navigation, si vous passez à un autre appareil, ou si vous
travaillez en navigation privée.
Deux conséquences :
votre progression ne vous suit pas d’un ordinateur à l’autre ;
je ne vois rien. Aucune trace de votre travail ne me parvient, donc personne
ne peut « avoir fait le parcours » de mon point de vue, et personne ne peut
non plus être pénalisé pour ne pas l’avoir fait.
Comment l’examen est construit
L’examen reprend les exercices du parcours. Une question peut être un
exercice tel quel, ou le même exercice avec un texte de test un peu différent.
Les questions à choix multiples de l’examen sont du même niveau de difficulté
que celles du parcours. Les questions où vous écrivez une expression combinent
au plus deux ou trois notions à la fois.
Toutes les expressions de l’examen s’appliquent avec les drapeaux gmu, comme
partout dans le parcours. Vous n’avez jamais à les écrire : il faut
comprendre ce qu’ils font, pas les produire.
Comment il est corrigé
Une expression qui fonctionne donne la note de passage. La note parfaite
exige la forme idiomatique, par exemple + plutôt que {1,} ou \d
plutôt que [0-9]. Le parcours signale ces formes courtes à mesure, et le
chapitre de récapitulation les reprend.
Le rythme recommandé du parcours
Le parcours est en ligne et vous pouvez commencer quand vous voulez. Je vous
recommande de lire le chapitre 1 pour la séance 3, le 16 septembre 2026, et de
faire le chapitre 2 pour la séance 4, le 23 septembre 2026. Ce ne sont pas des
échéances, mais commencer tôt évite de tout reporter à la fin du trimestre. Le
chapitre 3 se travaille pendant la semaine sans séance de septembre, et les deux
derniers après l’examen de mi-session, un chapitre par semaine.
Chapitre
Date recommandée
1. Pourquoi les expressions rationnelles
pour la séance 3, le 16 septembre 2026
2. Décrire des caractères
pour la séance 4, le 23 septembre 2026
3. Décrire des positions
semaine du 28 septembre 2026, sans séance le 30 septembre 2026
4. Répétition et groupes
semaine du 19 octobre 2026, relâche
5. Récapitulation et pratique
semaine du 26 octobre 2026
Aucune de ces dates n’est une échéance : c’est un rythme recommandé, calculé
pour que le parcours soit fini une semaine avant l’examen du 4 novembre 2026. Rien ne
vous empêche d’aller plus vite.
This page is only available in French.
Autonomy and expectationsAutonomie et attentes
L’autonomie fait partie de la matière
Un des objectifs de ce cours est de vous rendre suffisamment à l’aise avec la
technologie pour explorer des outils par vous-même. À certains moments, en
classe ou dans les travaux, je vous demanderai de réaliser une tâche que je
n’ai pas expliquée en détail.
C’est voulu. La technologie change trop vite pour que la maîtrise d’un seul
logiciel suffise : ce que je veux, c’est que vous soyez à l’aise et efficaces
avec la technologie en général, ce qui suppose de savoir parfois trouver par
vous-mêmes comment accomplir une tâche précise.
Cherchez donc d’abord : le menu, la documentation de l’outil, une recherche en
ligne, un essai sur un fichier de test. Se tromper sur un fichier d’exercice ne
coûte rien.
Se préparer avant la séance
Il y a presque chaque semaine quelque chose à faire avant le cours suivant : une
lecture, un exercice, un questionnaire. Je l’annonce à la fin de la séance, et
la date figure au calendrier.
Ce travail n’est pas toujours ramassé ni noté. Il compte quand même : les
séances supposent qu’il est fait, elles commencent souvent par deux ou trois
questions rapides pour vérifier qu’on peut passer à la pratique, et le reste de
la journée s’appuie dessus. Le faire aide beaucoup ; ne pas le faire se paie
pendant la séance, puis à l’examen.
Je préfère de loin vous aider quand vous êtes bloqués et que je peux encore
faire quelque chose, plutôt que de découvrir à la correction qu’une notion
n’avait pas été comprise, quand il ne me reste qu’à retirer des points. Si je
vais trop vite ou si quelque chose n’est pas clair, demandez : il y a de bonnes
chances que vous ne soyez pas la seule personne dans ce cas.
Cela dit, nous sommes à l’université, et j’attends une certaine autonomie. Si
la réponse se trouve clairement dans le matériel du cours, je ne me sentirai
pas obligée de la répéter dans un courriel. Dans le doute,
demandez.
This page is only available in French.
Availability and feedbackDisponibilités et rétroaction
Me joindre
Il n’y a pas de permanence fixe. Vous pouvez toujours venir me parler avant ou
après la séance, ainsi que pendant la pause : c’est le moyen le plus rapide
d’obtenir une réponse.
Par courriel, comptez un à deux jours ouvrables. Je ne réponds pas les fins de
semaine ni les jours fériés, ce qui vaut la peine d’être pris en compte quand
une échéance tombe un dimanche soir : une question posée le vendredi trouve
réponse, une question posée le dimanche à 22 h non.
Si une question demande plus qu’un échange de courriels, demandez-moi un
rendez-vous.
Vos retours sur le cours
Signalez-moi les difficultés et les suggestions au fur et à mesure. Je préfère
apprendre qu’il y a un problème tant qu’il est encore possible d’y remédier,
plutôt qu’après coup, quand il est trop tard pour agir.
Cela vaut aussi pour ce site : le bouton en bas de chaque page sert à me
signaler une erreur, un lien mort ou un passage incompréhensible.
This page is only available in French.
Where to find whatOù trouver quoi
Sur ce site
Toute l’information sur le cours est publiée sur ce site.
Le contenu du cours : les chapitres, les parcours en ligne, les exercices, le
glossaire, les informations pratiques que vous êtes en train de lire. C’est ici
que vous venez pour apprendre quelque chose ou pour vérifier une consigne.
Le site est public en grande partie ; les pages propres au cours, comme
celle-ci, demandent le mot de passe du cours. La page Comment ce site
fonctionne explique la structure, les profils et les cadenas.
Sur StudiUM
Tout ce qui vous concerne personnellement, puisque ce site n’a pas de comptes
personnels : les annonces, les remises de travaux, les questionnaires de
préparation et vos notes. C’est là que vous déposez un fichier et que vous
consultez un résultat. StudiUM renvoie ici pour le contenu.
This page is only available in French.
IntegrityIntégrité
Dans ce cours en particulier
Ce cours porte sur des outils qui produisent du texte, ce qui rend la limite
moins évidente qu’ailleurs. Elle est fixée par évaluation, et par écrit : un
grand modèle de langue est permis à l’examen de mi-session et interdit aux
deux examens sur papier, où rien n’est permis. La page Ressources
autorisées
donne le détail pour chaque évaluation ; c’est elle qui fait foi.
Deux choses ne changent jamais. Le travail que vous remettez doit être le vôtre,
même quand un outil a servi à le produire. Et si vous ne savez pas si quelque
chose est permis, demandez-le avant plutôt qu’après.
This page is only available in French.
🔒 TRA2600 · Installing WordfastTRA2600 · Installer Wordfastis course material (TRA2600). Open it on the site to include it here.est réservé au cours (TRA2600). Ouvrez-le sur le site pour l'inclure ici.
Une licence Wordfast Pro personnelle, d’un an et sans frais, obtenue pour ce
cours-ci. Elle est associée à votre adresse de l’UdeM et couvre tout le
trimestre, avec de la marge. Elle donne aussi accès à Wordfast Anywhere, la
version qui s’utilise dans un navigateur.
Elle est distincte des licences installées sur les postes du département, qui
viennent du département et servent aux cours qui en ont besoin. Les deux
existent en parallèle : la licence personnelle vous suit sur votre propre
ordinateur, celles du département restent sur les postes.
À l’échéance, Wordfast offre un rabais étudiant si vous voulez continuer. Rien
ne vous y oblige, et le cours ne suppose aucun achat.
Où l’installer
Vous avez le choix. Les postes du département ont Wordfast Pro installé, et
tout ce que le cours demande peut se faire là. Une installation sur votre propre
ordinateur reste plus commode pour les exercices à faire à la maison, entre deux
séances, et c’est ce que je vous recommande.
L’installation se fait en classe le 2 septembre 2026, avec de l’aide sur place. Ce
qui n’est pas terminé se finit chez vous, avec ces pages. C’est à vous de vous
assurer d’avoir un outil qui fonctionne avant la séance 2.
This page is only available in French.
Downloading Wordfast ProTélécharger Wordfast Pro
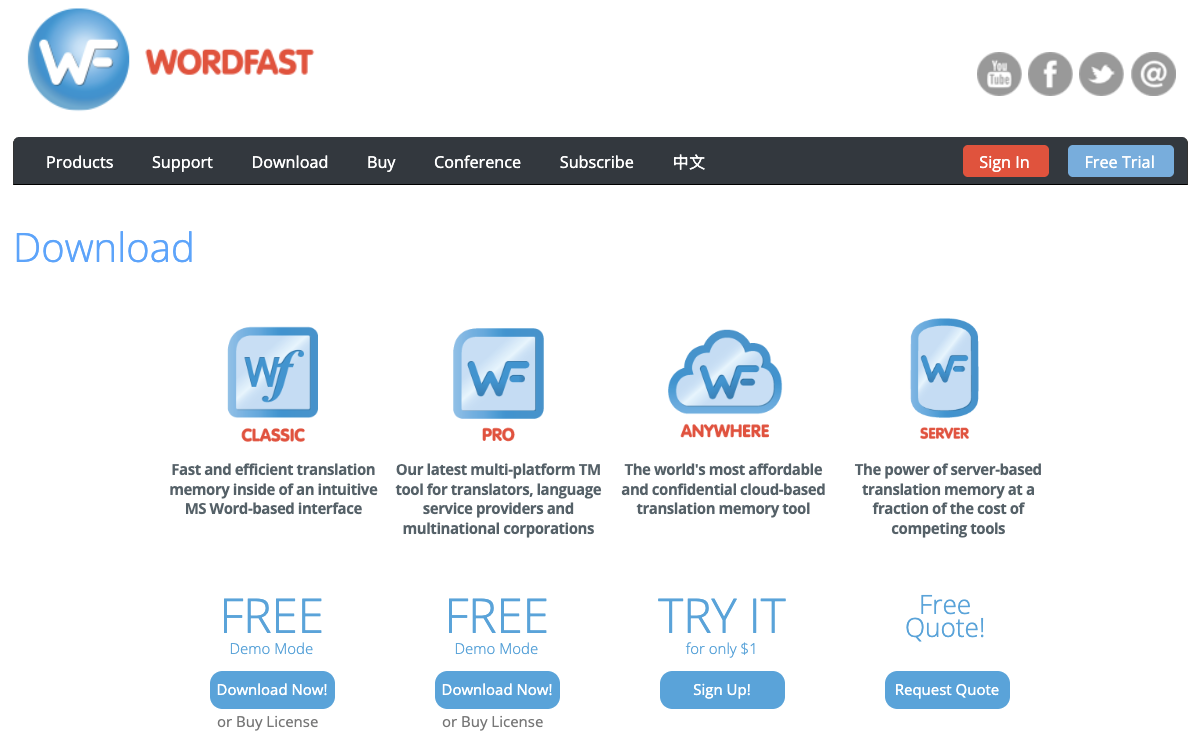
Rendez-vous sur wordfast.com et ouvrez la page
« Download ». Quatre produits y figurent côte à côte.
Figure 1. La page de téléchargement de wordfast.com. Le produit du cours est Wordfast Pro, la deuxième colonne.
Celui qui nous intéresse est le deuxième, Wordfast Pro. Les trois autres ne
servent pas dans ce cours :
Classic est l’ancienne version, qui fonctionne à l’intérieur de Microsoft
Word ;
Anywhere est la version qui s’exécute dans un navigateur, sans rien
installer. Votre licence y donne accès et elle peut dépanner, mais les
séances se donnent dans Pro ;
Server est un produit d’entreprise.
Sous Wordfast Pro, cliquez sur « Download Now! ». Le téléchargement démarre
sans achat : le mot « FREE » de cette colonne désigne le mode démonstration,
et c’est votre clé d’activation qui transformera cette installation en version
complète.
This page is only available in French.
Installing the softwareInstaller le logiciel
Télécharger le bon fichier
Le bouton « Download Now! » de la colonne Wordfast Pro ouvre la liste des
systèmes. Prenez celui de la machine sur laquelle vous installez.
Figure 2. Les trois systèmes proposés sous Wordfast Pro.
Une fois le fichier téléchargé, l’installation ne demande aucun choix
particulier : acceptez les valeurs proposées et laissez l’installateur se
terminer.
Sur Windows
Le fichier est un .exe. Ouvrez-le et suivez les écrans. Windows peut afficher
un avertissement SmartScreen pour un programme téléchargé sur le web : passez
par « Informations complémentaires », puis « Exécuter quand même ».
Gardez l’emplacement d’installation proposé, dans Program Files.
Sur macOS
Le fichier est un .dmg. Ouvrez-le, puis glissez l’icône de Wordfast Pro dans
le dossier Applications, comme pour n’importe quelle application Mac.
Au premier lancement, macOS bloque les applications qui ne viennent pas de
l’App Store. Le message dit que le développeur ne peut pas être vérifié. Passez
par Réglages Système, section Confidentialité et sécurité : un bouton
« Ouvrir quand même » y apparaît, sous le message qui vient de s’afficher. Le
blocage ne se produit qu’une fois.
Un mot sur l’emplacement
Installez le logiciel là où l’installateur le propose. La question de
l’emplacement se pose surtout pour vos projets, pas pour l’application, et elle
revient au premier chapitre du parcours Wordfast : vos dossiers de projets ne
doivent pas se trouver dans OneDrive, Dropbox ou Google Drive. La
synchronisation modifie les fichiers pendant que le logiciel les tient ouverts,
ce qui donne des mémoires abîmées et des projets qui refusent de s’ouvrir.
This page is only available in French.
Activating your licenceActiver votre licence
En deux temps
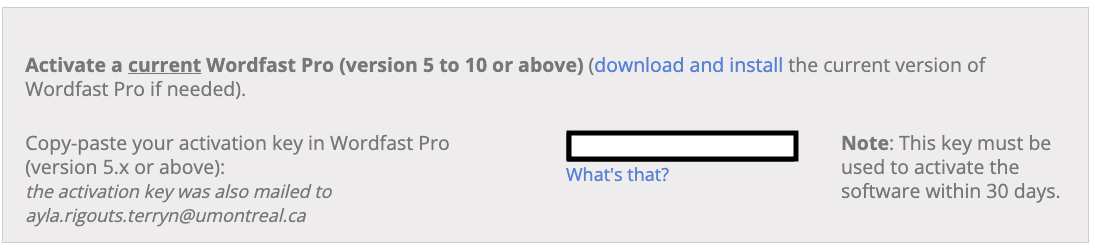
L’activation se déroule en deux temps. Vous récupérez d’abord une clé sur le
site de Wordfast, puis vous la donnez au logiciel. La clé est un texte à copier
et coller, alors gardez les deux fenêtres ouvertes.
Étape 1. Se connecter à son compte
Vous n’avez reçu aucun courriel, et c’est normal : votre compte existe déjà
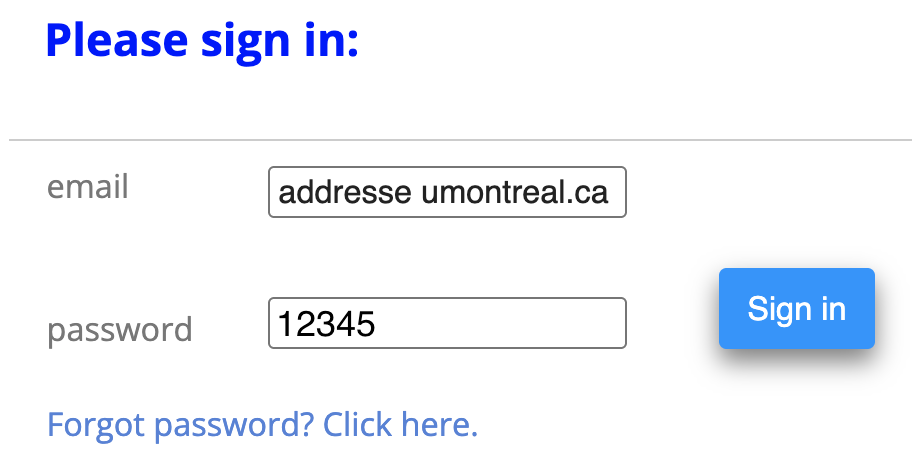
sur wordfast.com, créé avec votre adresse de l’UdeM et le mot de passe 12345.
Sur wordfast.com, cliquez sur « Sign In », en haut
à droite.
Figure 3. La connexion se fait avec votre adresse de l'UdeM et le mot de passe 12345, à changer une fois entré.
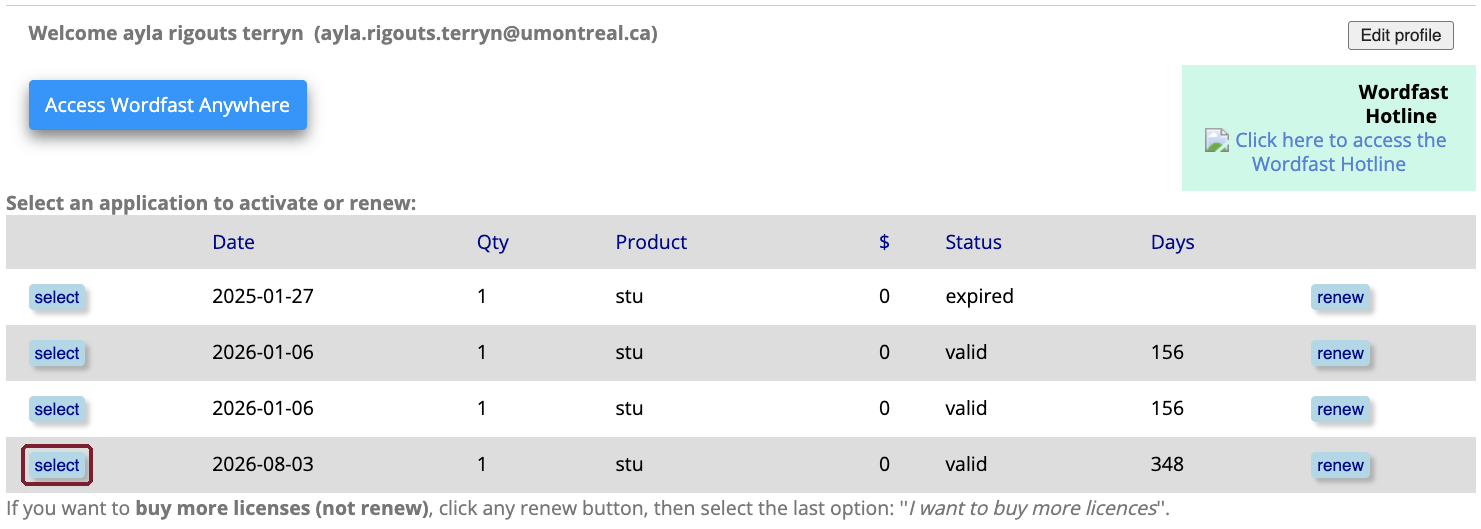
Figure 4. Ma page en montre plusieurs ; la vôtre n'en montre qu'une, sauf si vous avez déjà eu Wordfast Pro sur votre adresse de l'UdeM. Cliquez sur « select » à sa gauche.
Étape 3. Obtenir la clé
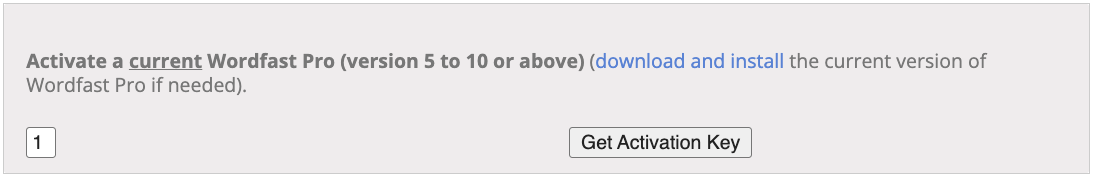
Laissez la quantité à 1 et cliquez sur « Get Activation Key ».
La clé s’affiche dans le même encadré. Elle vous est aussi envoyée par
courriel, à votre adresse de l’UdeM : si vous perdez la page, la clé est dans
votre boîte de réception.
Figure 6. La clé apparaît dans le champ. Elle est aussi envoyée par courriel.
Étape 4. Coller la clé dans Wordfast Pro
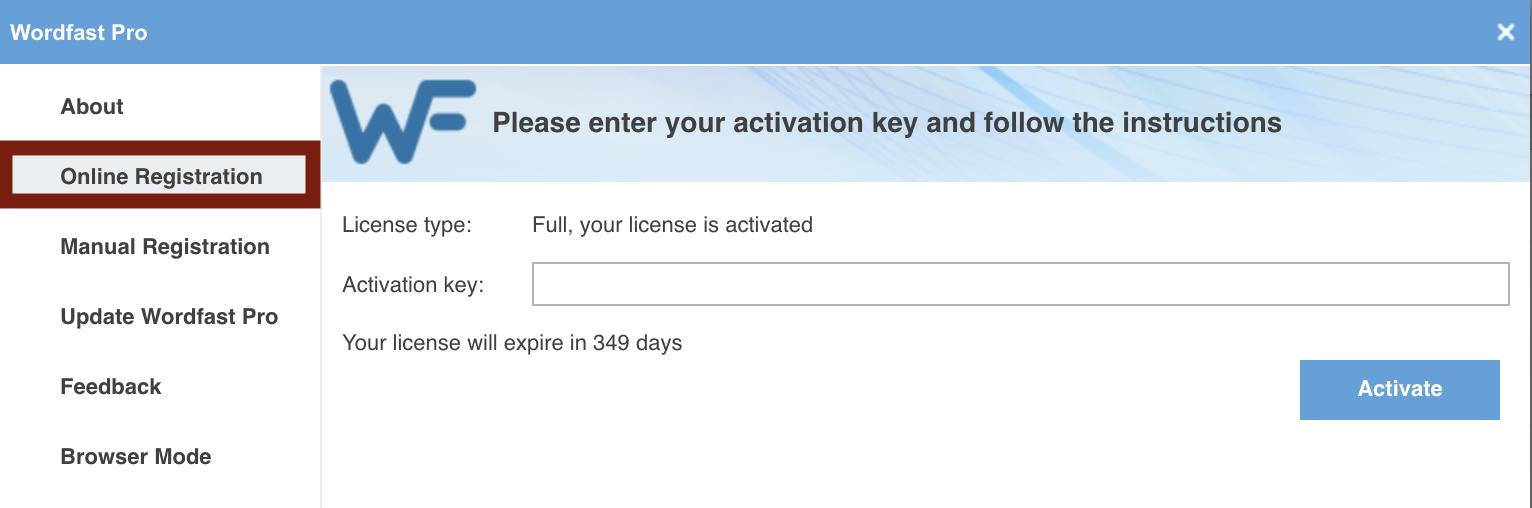
Ouvrez Wordfast Pro. Cliquez sur le logo Wordfast, en haut à gauche de la
fenêtre, et choisissez « Online Registration ».
Figure 7. La fenêtre d'enregistrement. Après activation, « License type » indique une licence complète et le nombre de jours restants s'affiche sous le champ.
Collez la clé dans le champ « Activation key », puis cliquez sur « Activate ».
La confirmation est à lire dans cette même fenêtre : « License type » passe à
une licence complète, et une ligne indique combien de jours il reste. Si le
type de licence reste en mode démonstration, l’activation n’a pas fonctionné.
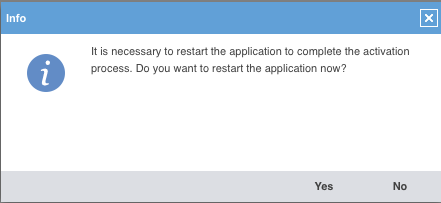
Étape 5. Redémarrer
Wordfast demande de redémarrer pour terminer l’activation : répondez oui.
This page is only available in French.
First launchPremier lancement
Le premier démarrage est long
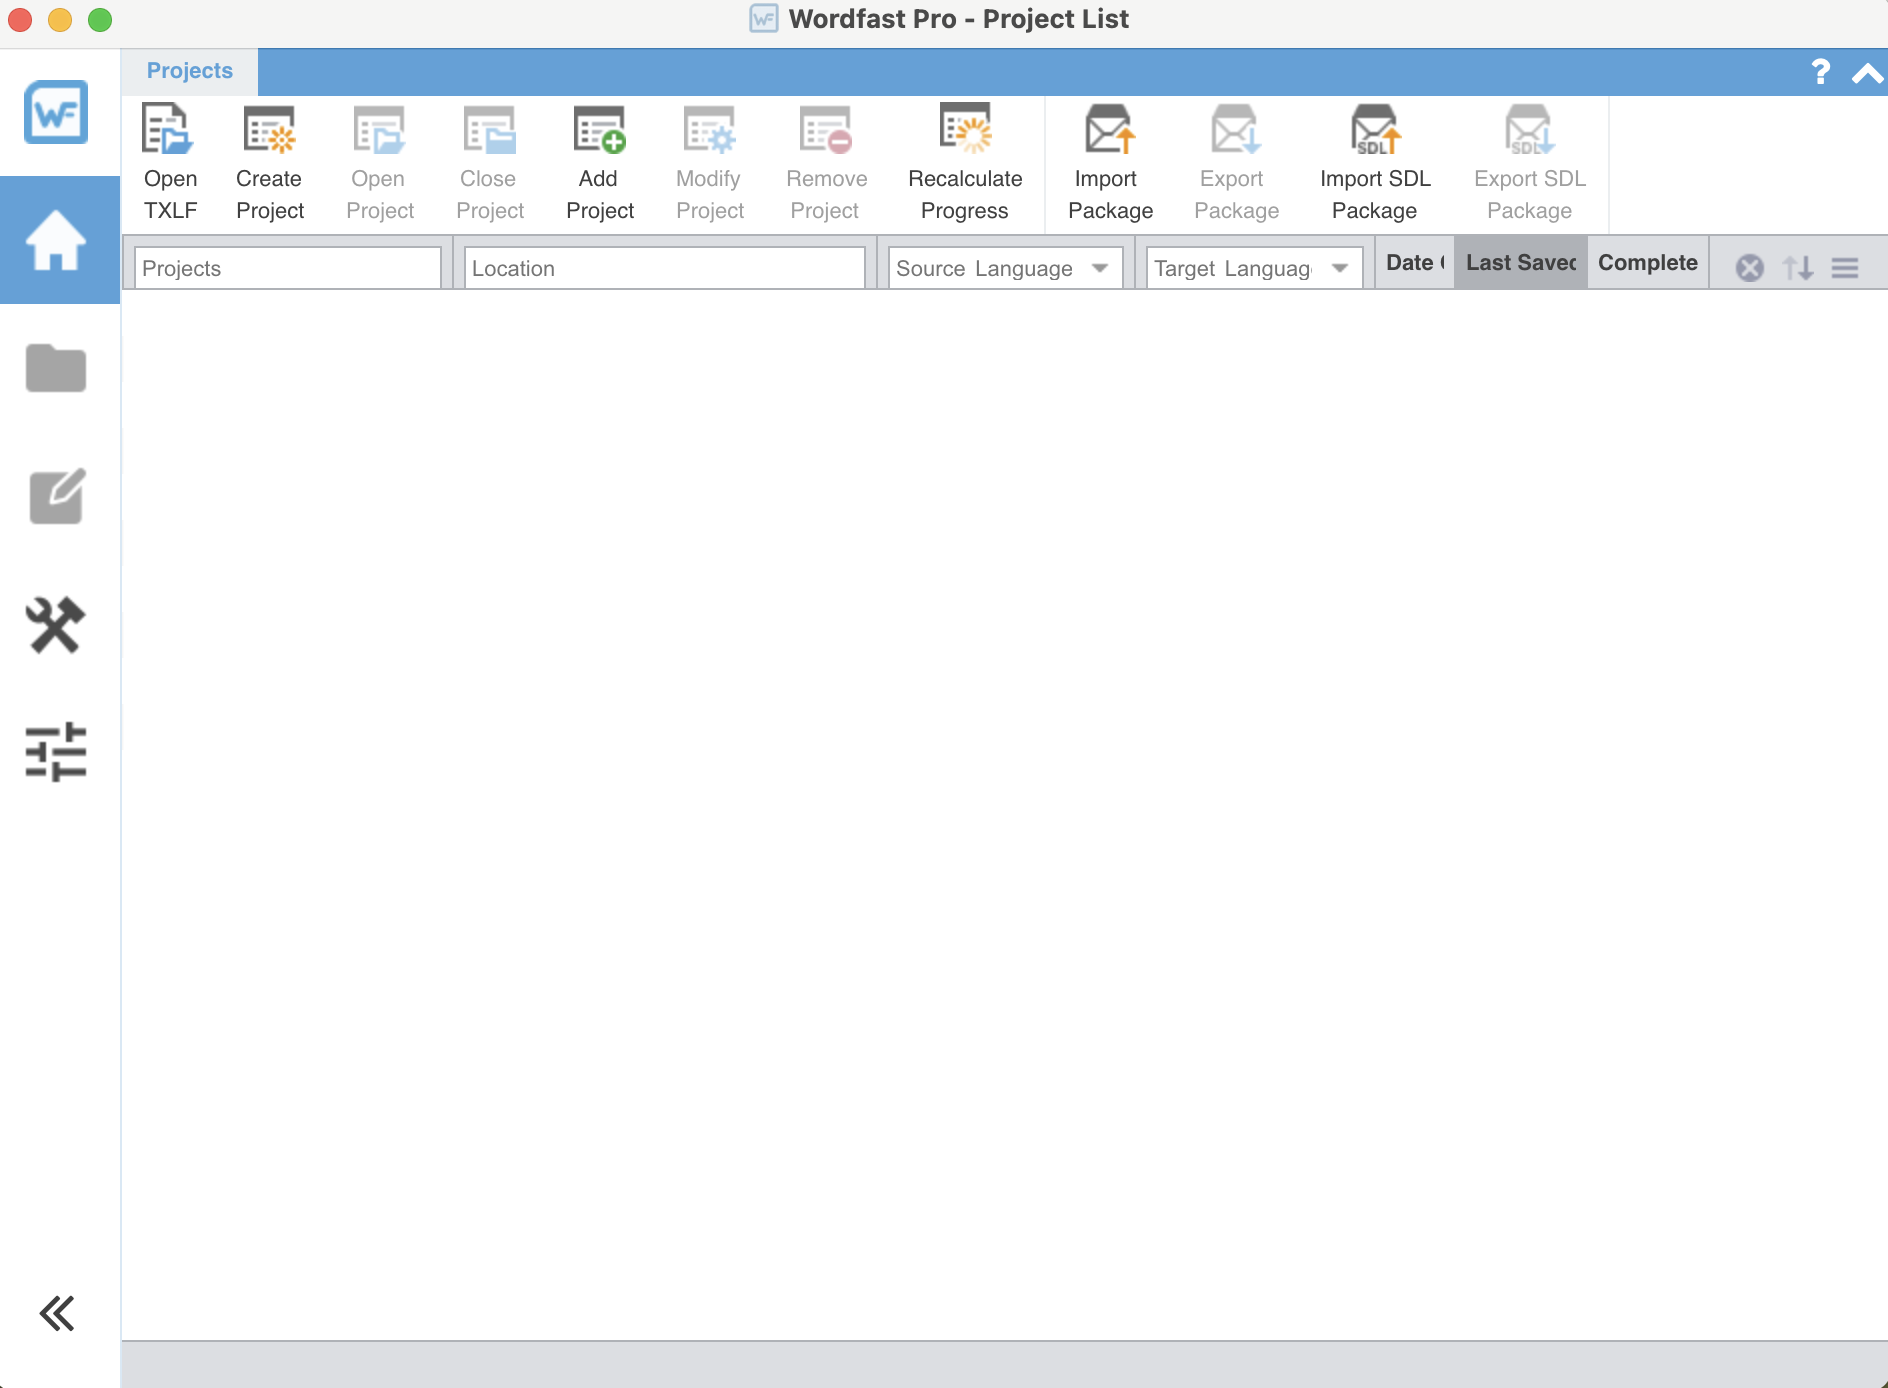
Ouvrez Wordfast Pro. Le démarrage est long, surtout la première fois : laissez
l’écran de chargement finir. Vous arrivez ensuite sur la liste des projets, et
elle est vide.
Figure 9. La liste des projets au premier lancement. Le tableau est vide, et c'est ce qu'il faut voir.
Il se remplira à partir de la séance 2 : un projet par ligne, avec sa paire de
langues et son pourcentage d’avancement.
Ce qu’il faut vérifier maintenant
Une seule chose : que la licence est active. Cliquez sur le logo Wordfast, en
haut à gauche, puis sur « Online Registration ». La ligne « License type » doit
annoncer une licence complète, et le nombre de jours restants doit s’afficher.
Si ce n’est pas le cas, reprenez la page
Activer votre licence.
Figure 10. Le logo Wordfast, en haut à gauche, ouvre la fenêtre générale.
C’est tout ce qui est attendu de vous avant la séance 2. Ne créez pas de projet
d’essai : la création d’un projet se fait ensemble, en classe, et le premier
chapitre du parcours Wordfast commence par l’organisation de vos dossiers, qui
est le genre de décision qu’il vaut mieux prendre avant d’avoir dix projets
éparpillés.
This page is only available in French.
When it does not workQuand ça ne fonctionne pas
Les postes du département sont une solution complète
Si Wordfast refuse de s’installer ou de démarrer sur votre machine, ce n’est pas
un problème pour votre réussite dans le cours. Les postes du département ont le
logiciel et permettent de faire les séances, les exercices et l’examen de
mi-session, qui se tient de toute façon en classe.
Ce que vous perdez, c’est la commodité de travailler chez vous entre deux
séances. Cela vaut la peine d’essayer de régler le problème, sans que ce soit
urgent au point d’y passer une soirée.
Wordfast est lent, surtout au démarrage
Le logiciel met du temps à s’ouvrir, et l’écran de chargement peut rester
affiché longtemps, surtout au premier lancement. Ce n’est pas un blocage.
Laissez-le finir avant de forcer la fermeture, et évitez de le relancer
plusieurs fois pendant qu’il démarre : vous n’obtiendrez que plusieurs
démarrages en même temps.
macOS refuse d’ouvrir l’application
Le message dit que le développeur ne peut pas être vérifié. Ouvrez Réglages
Système, puis Confidentialité et sécurité, et descendez jusqu’au message qui
vient d’apparaître : un bouton « Ouvrir quand même » s’y trouve. Il faut avoir
tenté d’ouvrir l’application juste avant pour que le bouton apparaisse.
Windows bloque l’installateur
L’écran bleu de SmartScreen annonce qu’il a protégé votre appareil. Cliquez sur
« Informations complémentaires », puis sur « Exécuter quand même ».
La licence refuse de s’activer
Trois causes, dans l’ordre de fréquence :
vous n’êtes pas connecté au bon compte. La licence est rattachée à votre
adresse de l’UdeM ;
la clé a été copiée avec une espace en trop, au début ou à la fin. Recollez-la
en vérifiant les extrémités ;
la clé a déjà servi sur une autre machine. Une licence n’autorise qu’UNE
activation, donc une clé déjà utilisée ne servira pas une deuxième fois.
Venez me voir : c’est le cas que je ne peux pas régler à distance.
Un fichier refuse d’être importé dans un projet
Si Wordfast annonce « Failed: 1 » à l’ajout d’un fichier, avec un message qui
parle de « Rules file » introuvable, ce n’est pas votre document : ce sont les
règles de filtrage de Wordfast, qu’il range dans un dossier temporaire du système et
que le système efface de temps à autre. Redémarrez Wordfast et ajoutez le fichier de
nouveau ; il les réinstalle en démarrant.
Cela s’est produit sur mon poste avec un fichier HTML, en septembre 2026, et le
redémarrage a suffi.
L’ordinateur est trop ancien, ou c’est un Chromebook
Wordfast Pro ne s’installe pas sur ChromeOS ni sur un iPad. Deux possibilités :
les postes du département, ou Wordfast Anywhere, la version qui s’exécute dans
un navigateur et à laquelle votre licence donne accès. Anywhere fait moins de
choses que Pro et les séances ne s’y donnent pas, mais il permet de suivre.
Ce que je vous demande
Signalez-moi un problème d’installation avant la séance 2 plutôt que le jour de
l’examen. Écrivez-moi ce que vous avez tenté et ce que dit le message d’erreur
exactement, ou venez me voir avant ou après une séance. Une installation qui ne
fonctionne pas est un problème banal, pas un aveu.
This page is only available in French.
🔒 TRA2600 · The exchange formats readingTRA2600 · La lecture sur les formats d'échangeis course material (TRA2600). Open it on the site to include it here.est réservé au cours (TRA2600). Ouvrez-le sur le site pour l'inclure ici.
TRA2600 · The exchange formats readingTRA2600 · La lecture sur les formats d'échange
🔒 TRA2600 · Assignment briefsTRA2600 · Consignes des travauxis course material (TRA2600). Open it on the site to include it here.est réservé au cours (TRA2600). Ouvrez-le sur le site pour l'inclure ici.
TRA2600 · Assignment briefsTRA2600 · Consignes des travaux
Mid-session exam: instructions and filesExamen de mi-session : consignes et fichiers
Le mandat
Votre client est Alignio Logiciels inc., un éditeur montréalais de logiciels de traduction (fictif). Un traducteur a commencé la traduction du guide d’utilisation d’Alignio Desktop 3, son outil à mémoire de traduction, puis a quitté le mandat. Vous reprenez son projet Wordfast. Entre-temps, le client vous envoie deux choses : une foire aux questions à traduire, et sa politique de licence et de soutien, traduite il y a quelques années sans outil de TAO, dont il veut récupérer la traduction dans la mémoire.
Direction
français → anglais
Terminologie imposée
base terminologique → termbase ; service à la clientèle → customer service ; traduction automatique → machine translation, jamais « automatic translation » ; Alignio, Alignio Desktop et Alignio Logiciels ne se traduisent pas
Livrables
le guide et la FAQ traduits, dans leur format d’origine ; le projet Wordfast ; la mémoire mise à jour, au format TMX
Le mandat d'Alignio.
Les fichiers
Mettez-les dans un même dossier, hors de OneDrive, avant de commencer.
Le projet du traducteur précédent : le guide, traduit en partie, avec la mémoire et le glossaire du projet. Il s’importe dans Wordfast avec « Import Package ».
La foire aux questions, à traduire dans le même projet. Un fichier ajouté à un projet existant n’est pas prétraduit : c’est à vous d’aller chercher les correspondances de la mémoire et la traduction automatique, segment par segment ou pour tout le fichier.
Le guide livré complet : la partie déjà traduite revue et corrigée, le reste traduit.
La FAQ traduite.
La traduction de l’ancienne politique récupérée dans la mémoire existante du projet, Alignio_TM_fr-en, et non dans une mémoire à part, pour que le client n’ait plus à la payer deux fois. Les réglages par défaut de l’importation conviennent.
Le terme banni bloqué, pour ce mandat et les suivants.
Les ressources du projet corrigées là où elles étaient fausses.
Les segments sans correspondance traduits à partir de la traduction automatique, branchée comme en classe : chaque proposition relue, corrigée au besoin et validée. Le projet garde la trace de ce qui vient de la machine.
Le tout vérifié avec Transcheck, chaque signalement corrigé ou justifié dans le journal.
Les livrables du mandat : les deux documents traduits dans leur format d’origine, le projet en paquet (.glp) et la mémoire du projet au format TMX. L’exportation de la mémoire n’a pas été vue en classe : à vous de trouver comment la faire, avec la documentation, l’aide de Wordfast ou le web.
Dans quel ordre faire tout cela, et comment vous assurer que rien ne manque, fait partie de ce qui est évalué.
Les noms
Deux régimes, et la différence compte dans la note.
Ce qui porte un nom
Qui décide
La règle
Les cinq fichiers remis sur StudiUM
Moi
Exactement les noms du tableau ci-dessous, pour que je retrouve votre travail. Un fichier mal nommé me coûte du temps et vous coûte des points.
Le projet Wordfast
Vous
Le nom du paquet convient ; si vous le changez, suivez la convention du cours.
La liste de blocage, que vous créez
Vous
La convention du cours : le client, le type de ressource, la langue ; ni espaces ni accents. Ce nom est noté.
Qui nomme quoi.
La remise
NomPrenom = nom de famille suivi du prénom, sans espaces ni accents. Exemple : Marie Tremblay → TremblayMarie_guide.docx.
Nom du fichier
Contenu
NomPrenom_guide.docx
Le guide d’utilisation traduit, exporté de Wordfast
NomPrenom_faq.docx
La FAQ traduite, exportée de Wordfast
NomPrenom_projet.glp
Le projet Wordfast complet, exporté en paquet
NomPrenom_memoire.tmx
La mémoire du projet, exportée au format TMX
NomPrenom_journal.docx
Le journal de bord
Les cinq fichiers à déposer sur StudiUM.
Vérifiez votre dépôt avant de partir : cinq fichiers, bien nommés, et rien d’autre. Ouvrez chaque fichier exporté pour vous assurer qu’il contient bien votre traduction.
This page is only available in French.
🔒 TRA6008 · Practical informationTRA6008 · Informations pratiquesis course material (TRA6008). Open it on the site to include it here.est réservé au cours (TRA6008). Ouvrez-le sur le site pour l'inclure ici.
Comprendre ce que font ces systèmes, comment ils sont construits et où
ils échouent.
Explorer un outil nouveau par vous-mêmes, efficacement, sans attendre
qu’on vous le montre : les outils changeront, cette autonomie restera.
Évaluer : mesurer ce que fait une technologie, interpréter des résultats
publiés, et composer avec le cas ordinaire de la traduction, où il n’existe
pas une seule bonne réponse à laquelle se comparer.
Les trois volets
Le trimestre tient en trois fois trois : trois séances de théorie, trois
modules en ligne, trois projets d’équipe.
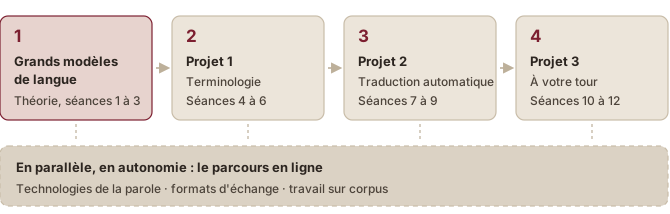
Figure 2. Les quatre blocs, et le parcours en ligne qui court à côté.
Les trois projets d’équipe occupent le reste du trimestre. Ils reprennent le
même schéma sur trois tâches différentes, et l’autonomie qu’ils vous demandent
augmente de l’un à
l’autre (see also the three projects page) (voir aussi la page Les trois projets).
Ce cours ne porte donc pas uniquement sur les GML, même s’ils y occupent une
grande place. La démarche d’évaluation que vous apprenez dans les projets vaut
pour n’importe quelle technologie langagière.
La première séance
La première séance, le 3 septembre 2026, sert à poser les bases pratiques et à entrer
dans la matière :
le plan de cours, le calendrier et les échéances du trimestre ;
comment le cours se sert de l’intelligence artificielle, et ce qui est attendu
de vous à ce sujet ;
ce qui se trouve sur ce site et ce qui se trouve sur StudiUM ;
l’annonce du Projet 1 ;
une entrée en matière sur les grands modèles de langue.
L’apprentissage est majoritairement axé sur des projets, soutenus par des
apports théoriques ciblés. Vous travaillez en équipes sur des tâches inspirées de
la pratique professionnelle et développez progressivement votre autonomie : les
premiers projets sont fortement encadrés, le dernier suppose que l’équipe
conçoive elle-même sa démarche.
Le séminaire de traductique vise à vous initier à l’utilisation et au
fonctionnement général des systèmes de traduction automatique et de traduction
assistée par ordinateur, ainsi qu’aux divers outils d’aide à la traduction.
À la fin du cours, vous serez en mesure d’utiliser différents outils de
traduction et de les évaluer en fonction de besoins précis. Vous pourrez, en
outre, jauger les possibilités et les limites de l’informatique dans un
environnement de traduction.
Objectifs spécifiques
À la fin du cours, vous devriez être en mesure de :
comprendre le fonctionnement général des grands modèles de langue et ce qui en
découle pour leur usage en traduction ;
exploiter les GML de manière efficace et critique dans des tâches langagières
concrètes, notamment par le requêtage et la comparaison de modèles ;
concevoir et appliquer un protocole d’évaluation adapté à une tâche donnée ;
choisir des mesures d’évaluation pertinentes, en interpréter les résultats et
en reconnaître les limites ;
documenter une démarche technologique de façon à la rendre reproductible et
critiquable ;
développer une réflexion critique et argumentée sur la place de l’intelligence
artificielle dans les professions langagières.
Structure générale
Le cours comprend trois volets :
une introduction aux grands modèles de langue, en début de trimestre,
combinant séances en classe et lectures individuelles ;
trois projets successifs, réalisés en équipes, portant sur des tâches
langagières distinctes ;
un parcours d’apprentissage en ligne, individuel et asynchrone, consacré à
d’autres technologies langagières.
Chaque projet combine des apports théoriques ciblés, du travail d’équipe en
classe, du travail à la maison, une présentation orale et la remise de rapports.
Dans la mesure du possible, chaque équipe travaille avec un agent conversationnel
différent, ce qui permet de comparer les résultats obtenus d’une équipe à
l’autre. La composition des équipes peut être revue entre les projets.
Références et ressources
Chaque projet et chaque parcours d’apprentissage comprend ses propres
références, communiquées avec le matériel correspondant. La liste ci-dessous est
non exhaustive.
Baumgarten, S., & Tieber, M. (dir.). (2025). The Routledge Handbook of Translation Technology and Society. Routledge.
Bowker, L. (2023). Translating for Canada, eh? (version 2). University of Ottawa. Également disponible en français.
Drouin, P. (2003). Term Extraction Using Non-Technical Corpora as a Point of Leverage. Terminology, 9(1), 99–115.
Gallegos, I. O., Rossi, R. A., Barrow, J., Tanjim, M. M., Kim, S., Dernoncourt, F., Yu, T., Zhang, R., & Ahmed, N. K. (2024). Bias and Fairness in Large Language Models: A Survey. Computational Linguistics, 50(3), 1097–1179.
Jurafsky, D., & Martin, J. H. (2025). Speech and Language Processing (3e éd.). Manuscrit en ligne.
Kilgarriff, A., Baisa, V., Bušta, J., Jakubíček, M., Kovář, V., Michelfeit, J., Rychlý, P., & Suchomel, V. (2014). The Sketch Engine: Ten years on. Lexicography, 1(1), 7–36.
O’Hagan, M. (dir.). (2020). The Routledge Handbook of Translation and Technology. Routledge.
Rigouts Terryn, A. (2026). Introduction to Large Language Models: Principles, Pitfalls, and Possibilities. Matériel de cours, Université de Montréal.
Rivas Ginel, M. I., & Moorkens, J. (2025). Translators’ trust and distrust in the times of GenAI. Translation Studies, 18, 283–299.
Rothwell, A., Moorkens, J., Fernández-Parra, M., Drugan, J., & Austermuehl, F. (2023). Translation Tools and Technologies. Routledge.
Vanroy, B., Tezcan, A., & Macken, L. (2023). MATEO: MAchine Translation Evaluation Online. Proceedings of the 24th Annual Conference of the European Association for Machine Translation, 499–500.
WMT. Proceedings of the Conference on Machine Translation. Association for Computational Linguistics. Édition la plus récente disponible au moment du cours.
Parfois la référence n’est qu’une bonne réponse parmi d’autres, et le
travail consiste à juger des productions à l’aide d’une grille d’erreurs,
puis à confronter ce jugement à celui d’un agent conversationnel et à des
mesures automatiques.
Parfois enfin, rien n’est donné, et c’est à vous de décider quoi mesurer et
comment.
L’autonomie augmente
Les trois projets se suivent en ordre croissant de difficulté et d’autonomie.
Le Projet 1, sur l’extraction de termes, est encadré de près : tâche
fixée, environnement de travail prêt, évaluation construite ensemble en
classe. Il a aussi un volet industriel, puisqu’il alimente une étude menée
avec une entreprise de traduction.
Le Projet 3 est le vôtre : l’équipe choisit sa question, conçoit sa
démarche et la défend.
Les équipes
Les équipes comptent trois personnes. Chaque équipe travaille avec un agent conversationnel
différent, et l’attribution change d’un projet à l’autre : au fil du trimestre,
le groupe aura vu plusieurs modèles à l’œuvre sur les mêmes tâches. La
composition des équipes peut elle aussi être revue entre les projets.
Ce que vous remettez
Chaque projet se conclut par deux rapports, un individuel et un d’équipe, remis
à la même date ; un gabarit vous est fourni pour chacun, avec le contenu attendu
section par section.
À la dernière séance du projet, chaque équipe présente son travail. Rien de
formel : le but est de montrer aux autres équipes ce que vous avez fait et de
nourrir la discussion, pas de vous mettre en
scène (see also the Evaluation page) (voir aussi la page Évaluation).
Les consignes de chaque projet
Tout ce qui est propre à un projet, le calendrier, la répartition des points,
les règles de ressources et les gabarits des rapports, est sur la page du
projet, publiée au début du projet (see also the TRA6008 · Project briefs chapter) (voir aussi le chapitre TRA6008 · Consignes des projets).
This page is only available in French.
Calendar and structureCalendrier et structure
Quand a lieu le cours
Les séances ont lieu le jeudi, de 12 h 30 à 15 h 30. Onze séances de cours,
plus la séance de présentations finales du 10 décembre 2026, dans la même case
horaire.
Les séances
Le tableau donne tous les jeudis du trimestre, y compris ceux sans cours, pour
que les interruptions soient visibles. Les séances teintées portent une
évaluation.
Séance
Date
Sujet
1
3 septembre 2026
Introduction, plan de cours, entrée en matière sur les GML ; annonce du Projet 1
2
10 septembre 2026
GML : théorie
17 septembre 2026 · Pas de cours (engagement IVADO). À faire cette semaine-là : le module sur la parole, et les lectures pour la séance 3
3
24 septembre 2026
Se servir des GML ; leurs limites et leurs risques ; rappel de la question du consentement (Projet 1)
4
1er octobre 2026
Projet 1 : présentation du travail de projet, questionnaire de profil, début de l'annotation, formation des équipes
5
8 octobre 2026
Projet 1 : calcul de l'accord, précision, rappel et F1, retour sur la notion de terme et sur l'extraction automatique
6
15 octobre 2026
Présentations du Projet 1
22 octobre 2026 · Pas de cours (période d'activités libres)
7
29 octobre 2026
Projet 2 : vos questions sur les lectures, rédaction commune de la requête unique, traduction à la main, traduction avec l'agent
8
5 novembre 2026
Projet 2 : vos questions sur les lectures, annotation des erreurs, rédaction commune de la requête du juge, jugement par l'agent, chrF et COMET dans MATEO
9
12 novembre 2026
Présentations du Projet 2 ; lancement du Projet 3
19 novembre 2026 · Pas de cours (colloque à Ottawa). À faire cette semaine-là : choisir en équipe la question du Projet 3 et m'envoyer une proposition d'étude pour le dimanche 22 novembre 2026
10
26 novembre 2026
Projet 3 : séance de travail (collecte)
11
3 décembre 2026
Projet 3 : séance de travail (analyse et préparation de l'oral)
12
10 décembre 2026
Présentations finales du Projet 3
Les trois jeudis sans cours
Il n’y a pas de séance le 17 septembre 2026, le 22 octobre 2026 ni le 19 novembre 2026.
Le 22 octobre 2026 tombe dans la période d’activités libres, où rien n’est prévu.
La semaine du 17 septembre 2026, en revanche, porte du travail. C’est là que se fait le
module sur les technologies de la parole, dont l’échéance est le 25 septembre 2026,
au lendemain de la séance 3, et que se préparent les lectures de cette séance.
Le 19 novembre 2026, je suis à Ottawa pour un colloque. Ce jeudi-là remplace la
première séance de travail du Projet 3 : l’équipe se sert du créneau du cours,
et peut se retrouver dans la salle habituelle, pour choisir sa question. Elle
m’envoie ensuite une proposition d’étude au plus tard le dimanche 22 novembre 2026 à
23 h 59. Je lis ces propositions avant de rencontrer chaque équipe à mon
bureau, le lundi 23 novembre 2026 ou le mardi 24 novembre 2026.
In classEn classeTrois séances : ce qu'est un grand modèle de langue et comment il est entraîné, puis comment s'en servir et ce qu'il fait mal. Le Projet 1 est annoncé à la séance 1 ; ses consignes détaillées arrivent au début de la séance 4.
Outside classHors classeTrois chapitres avant la séance 2. Avant la séance 3 : la fin de l'entraînement des GML (données, préentraînement, affinage) et l'essentiel de l'inférence et de l'apprentissage en contexte. La semaine du 17 septembre 2026, sans séance, sert aussi au module sur la parole.
In classEn classeLa présentation du travail de projet et le début de l'annotation à la séance 4, sans théorie avant. L'accord entre annotateurs, la précision, le rappel et le F1 à la séance 5, avec un retour sur la notion de terme. Présentations à la séance 6.
Outside classHors classeLa fin de l'annotation pour le 4 octobre 2026, puis le module d'extraction terminologique pour la séance 5, les listes et les scores des deux systèmes pour la séance 6, les deux rapports pour le 25 octobre 2026.
In classEn classeÀ la séance 7, vos questions sur les lectures, puis les traductions : la requête unique rédigée ensemble, la traduction à la main et la traduction avec l'agent. À la séance 8, vos questions, puis les évaluations : l'annotation des erreurs, la requête du juge rédigée ensemble, le jugement par l'agent, chrF et COMET. Présentations à la séance 9, qui lance le Projet 3.
Outside classHors classeLa théorie sur la traduction automatique pour la séance 7, celle sur son évaluation pour la séance 8. Ce qui n'est pas fini en classe se termine à la maison, et l'équipe compare ses annotations avant la séance 9. Les deux rapports pour le 20 novembre 2026.
4Séances 10 à 12, présentations le 10 décembre 2026
Projet 3 · À votre tour
In classEn classeLancement à la séance 9, puis deux séances de travail, l'une pour la collecte, l'autre pour l'analyse et la préparation de l'oral. Présentations finales le 10 décembre 2026.
Outside classHors classePas de séance le 19 novembre 2026 : l'équipe choisit sa question et m'envoie une proposition d'étude pour le 22 novembre 2026, puis en discute avec moi à mon bureau le 23 novembre 2026 ou le 24 novembre 2026. Les deux rapports pour le 17 décembre 2026.
Outside classHors classeTrois modules individuels : la parole pour le 25 septembre 2026, les formats d'échange pour le 11 octobre 2026 et Sketch Engine pour le 1er novembre 2026. Ensemble, 10 % de la note.
Ce qui se passe entre les séances
Le tableau des séances ne montre pas tout le travail du trimestre.
Le parcours en ligne se fait seul, sur les créneaux que vous choisissez, et
ses trois modules ont chacun leur échéance, placée dans les semaines les plus
calmes (see also the online path page) (voir aussi la page Le parcours en ligne).
Les lectures annoncées avant une séance ne sont pas facultatives : sans
elles, la séance se suit mal, parce que le temps de classe sert au travail qui
s’appuie dessus. Pendant les blocs de projet, c’est aussi une responsabilité
envers votre équipe, puisque c’est ce qui vous permet d’y contribuer.
This page is only available in French.
EvaluationÉvaluation
Les composantes et leur poids
Composante
Pondération
Format
Parcours d’apprentissage en ligne
10 %
Individuel, en ligne, trois échéances
Projet 1 · Terminologie
20 %
Équipe et individuel, présentations le 15 octobre 2026, deux rapports le 25 octobre 2026
Projet 2 · Traduction automatique
30 %
Équipe et individuel, présentations le 12 novembre 2026, deux rapports le 20 novembre 2026
Projet 3 · À votre tour
40 %
Équipe et individuel, présentations le 10 décembre 2026, deux rapports le 17 décembre 2026
Pourquoi les projets ne pèsent pas le même poids
La progression 20 %, 30 %, 40 % ne suit pas le nombre d’heures, qui est
comparable d’un projet à l’autre. Elle suit ce que le projet vous demande de
décider.
Au Projet 1, vous appliquez une démarche que je vous donne. Au Projet 2, la
tâche et les outils restent donnés, mais vous décidez de votre façon de
traduire avec l’agent et vous jugez vous-mêmes les erreurs, sur une tâche où
mesurer la qualité est nettement plus difficile. Au Projet 3, vous
concevez tout : la question, le protocole, les mesures et l’interprétation.
C’est là que se joue l’essentiel de ce que le cours cherche à vous apprendre, et
c’est pour cela qu’il vaut le plus.
Comment un projet est noté
Sauf problème signalé en cours de projet, le rapport d’équipe et la présentation
orale reçoivent chacun une note d’équipe, la même pour tous les membres ; le
rapport individuel est noté individuellement.
La répartition des points à l’intérieur d’un projet est précisée dans ses
consignes, avec ce que j’attends de la présentation orale, publiées en même
temps que le reste du projet.
Les dates des évaluations
Élément
Date
Parcours sur les technologies de la parole
vendredi 25 septembre 2026, 23 h 59, au lendemain de la séance 3
Réponse à la question du consentement (AnnoTerm)
jeudi 1er octobre 2026, envoyée en classe le 3 septembre 2026
Annotation du Projet 1 et questionnaire de fin de tâche
dimanche 4 octobre 2026, 23 h 59
Module sur l'extraction terminologique
jeudi 8 octobre 2026, à lire avant la séance, une fois l'annotation remise
Parcours sur les formats d'échange
dimanche 11 octobre 2026, 23 h 59
Présentations du Projet 1
jeudi 15 octobre 2026, en classe
Listes de TermoStat et de l'agent, par équipe
jeudi 15 octobre 2026, par courriel, au plus tard à 23 h 59, avec les diapositives s'il y en a
Rapports du Projet 1
dimanche 25 octobre 2026, 23 h 59, sur StudiUM
Module sur la traduction automatique
jeudi 29 octobre 2026, à lire avant la séance
Parcours sur Sketch Engine
dimanche 1er novembre 2026, 23 h 59
Lectures sur l'évaluation de la traduction automatique
jeudi 5 novembre 2026, avant la séance
Projet 2 : référence de l'équipe
jeudi 5 novembre 2026, par courriel, au plus tard au début de la séance
Présentations du Projet 2
jeudi 12 novembre 2026, en classe
Projet 2 : diapositives de l'équipe
jeudi 12 novembre 2026, par courriel, au plus tard à 23 h 59 ; partagées avec toute la classe sur StudiUM
Rapports du Projet 2
vendredi 20 novembre 2026, 23 h 59
Proposition d'étude du Projet 3
dimanche 22 novembre 2026, 23 h 59
Rencontres d'encadrement du Projet 3
lundi 23 novembre 2026, à mon bureau, une rencontre par équipe sur les deux jours
Rencontres d'encadrement du Projet 3
mardi 24 novembre 2026, à mon bureau, une rencontre par équipe sur les deux jours
Présentations finales du Projet 3
jeudi 10 décembre 2026, en classe
Rapports du Projet 3
jeudi 17 décembre 2026, 23 h 59
Correction et retards
Les retards sont pénalisés à hauteur de 20 % par jour de retard, sauf en cas
de circonstances exceptionnelles justifiées. Les délais sont communiqués dès le
début du trimestre, et il est attendu que les travaux soient remis à temps.
Ce à quoi je m’engage
Vous recevez une rétroaction détaillée sur chaque projet, et non une note
seule : ce qui a fonctionné, ce qui n’a pas fonctionné, et ce qu’il faut changer
pour le projet suivant. Comme les trois projets reprennent la même démarche sur
des tâches différentes, cette rétroaction est faite pour être utilisée : je vise
à vous la remettre avant les présentations du projet suivant, et pour le
Projet 3, avant la remise des notes finales.
Les ressources autorisées
Les ressources permises ne sont pas les mêmes d’un projet à l’autre, et elles
sont précisées par écrit avec les consignes, avant chaque évaluation.
Les trois sont notés sur ce que vous produisez, et non sur le simple fait de
les avoir parcourus. Ils ne pèsent pas le même poids parce qu’ils ne demandent
pas le même travail. Le module sur la parole vous fait manipuler trois outils
et produire des fichiers, ce qui prend plusieurs heures. Les deux autres sont
plus courts : celui sur les formats d’échange se lit, et celui sur Sketch Engine
reprend un outil que vous connaissez déjà en partie.
Les formats d’échange en traduction : pourquoi les outils de traduction ont
besoin de formats communs, comment lire du XML, et ce que font concrètement TMX,
TBX et XLIFF. C’est le module le plus proche du travail quotidien avec un
outil de TAO.
Les trois sont en ligne et vous les faites sur les créneaux
que vous choisissez.
Les échéances, elles, sont placées dans les creux du trimestre.
Celle de la parole tombe au lendemain de la séance 3, pour que les
dernières questions puissent se poser en classe la veille ; la semaine sans
séance du 17 septembre 2026 lui est réservée, car c’est le plus exigeant des trois.
Celle de Sketch Engine suit la semaine d’activités libres.
Tout est remis avant le lancement du Projet 3, le 12 novembre 2026, pour que les
dernières semaines du trimestre appartiennent à votre propre étude.
Vos marques de progression ne sont enregistrées nulle part
Le site n’a pas de comptes et ne conserve rien sur un serveur. Quand vous
terminez un exercice, la marque est écrite dans la mémoire de votre
navigateur, sur cet ordinateur-là. Vous la perdez si vous effacez vos données
de navigation, si vous passez à un autre appareil, ou si vous travaillez en
navigation privée.
Je ne vois donc rien de votre progression sur le site. Ce qui compte est ce que
vous remettez : le fichier sur StudiUM pour la parole, et les deux
questionnaires en ligne pour les formats d’échange et pour Sketch Engine.
This page is only available in French.
Where to find whatOù trouver quoi
Sur ce site
Toute l’information sur le cours est publiée sur ce site.
Le contenu du cours : les chapitres de théorie, le parcours en ligne, les
consignes des projets, le glossaire, la bibliographie et les informations
pratiques que vous êtes en train de lire. C’est ici que vous venez pour
apprendre quelque chose ou pour vérifier une consigne.
Le site est public en grande partie ; les pages propres au cours, comme
celle-ci, demandent le mot de passe du cours. La page Comment ce site
fonctionne explique la structure, les profils et les cadenas.
Sur StudiUM
Tout ce qui vous concerne personnellement, puisque ce site n’a pas de comptes :
les annonces, les remises de travaux, les questionnaires et vos notes. C’est
là que vous déposez un fichier et que vous consultez un résultat.
StudiUM renvoie ici pour le contenu.
Posez vos questions pendant que quelque chose peut encore être corrigé. Je
préfère de loin vous aider à ce moment-là que de découvrir à la correction
qu’un point n’a pas été compris, quand il ne me reste qu’à enlever des points.
Si un passage n’est pas clair, ou si je vais trop vite, demandez : dans un
groupe de cette taille, la question intéresse presque toujours tout le monde.
Me joindre
Il n’y a pas de permanence fixe. Vous pouvez venir me parler avant ou après
la séance, ainsi que pendant la pause : c’est le moyen le plus rapide d’obtenir
une réponse.
Par courriel, comptez un à deux jours ouvrables. Je ne réponds pas les fins
de semaine ni les jours fériés, ce qui vaut la peine d’être pris en compte quand
une échéance tombe un dimanche soir, comme celle de deux des trois modules
du parcours en ligne.
Si une question demande plus qu’un échange de courriels, demandez-moi un
rendez-vous. Dans un groupe de cette taille, c’est faisable.
Vos retours sur le cours
Signalez-moi les difficultés et les suggestions au fur et à mesure. Je préfère
apprendre qu’il y a un problème tant qu’il est encore possible d’y remédier,
plutôt qu’à l’évaluation de fin de trimestre, quand il est trop tard pour ce
groupe-ci.
Cela vaut aussi pour ce site : le bouton en bas de chaque page sert à me
signaler une erreur, un lien mort ou un passage incompréhensible.
This page is only available in French.
🔒 TRA6008 · Project briefsTRA6008 · Consignes des projetsis course material (TRA6008). Open it on the site to include it here.est réservé au cours (TRA6008). Ouvrez-le sur le site pour l'inclure ici.
TRA6008 · Project briefsTRA6008 · Consignes des projets
Project 1 · Terminology: the full instructionsProjet 1 · Terminologie : les consignes complètes
Le calendrier du projet
lun.mar.mer.jeu.ven.sam.dim.
Séance 4 · Projet 1 : présentation du travail de projet, questionnaire de profil, début de l'annotation, formation des équipes
Échéance · Réponse à la question du consentement (AnnoTerm) (envoyée en classe le 3 septembre 2026)
Évaluation · Annotation du Projet 1 et questionnaire de fin de tâche (23 h 59)
Séance 5 · Projet 1 : calcul de l'accord, précision, rappel et F1, retour sur la notion de terme et sur l'extraction automatique
Échéance · Module sur l'extraction terminologique (à lire avant la séance, une fois l'annotation remise)
Évaluation · Parcours sur les formats d'échange (23 h 59)
Séance 6, évaluation · Présentations du Projet 1
Échéance · Listes de TermoStat et de l'agent, par équipe (par courriel, au plus tard à 23 h 59, avec les diapositives s'il y en a)
Pas de cours (période d'activités libres)
Évaluation · Rapports du Projet 1 (23 h 59, sur StudiUM)
14 séance
28 évaluation
30 autre échéance
5 jeudi sans cours
Ce que demande le projet
Le premier projet porte sur l’extraction de termes, en trois temps :
Annoter : vous marquez vous-même, dans dix textes, ce qui est un terme
et ce qui n’en est pas.
Comparer : vous mettez vos décisions à côté de celles des huit autres
personnes, et vous mesurez l’écart.
Évaluer : vous faites travailler un outil d’extraction et un agent
conversationnel sur les mêmes textes, et vous jugez ce qu’ils produisent.
Ces trois temps se font en sept étapes pratiques, de la séance 4 aux deux
rapports du 25 octobre 2026 (see also the Project 1 · Step by step page) (voir aussi la page Projet 1 · Pas à pas).
Les équipes : trois équipes de trois, formées à la séance 4, chacune avec
un agent conversationnel différent (Claude, ChatGPT ou Gemini), pour comparer
les résultats d’une équipe à l’autre. L’équipe à qui revient Gemini peut
proposer un autre agent, à condition qu’il repose sur une autre famille de
modèles.
L’annotation, terminée le 4 octobre 2026
L’annotation s’est faite individuellement et en silence, sur INCEpTION, avec
deux questionnaires, de profil et de fin de tâche. Les consignes d’annotation
servent encore pour la section 1 du rapport individuel :
Les règles sur les ressources permises pendant l’annotation sont les plus strictes du trimestre, et c’est voulu. La tâche
consiste à décider vous-même, texte en main, ce qui est un terme et ce qui n’en
est pas. Un outil qui vous propose des candidats ne vous aide pas à faire
cette tâche : il la fait à votre place, et ce qu’il produit n’est plus votre
jugement. Or c’est votre jugement, et son écart avec celui des autres, que le
projet mesure. La règle courte : vous pouvez poser des questions sur un mot,
pas sur le texte. Tout ce qui vous aide à comprendre la langue et le domaine
est permis ; tout ce qui vous suggère quoi annoter est interdit.
Permis :
consulter un dictionnaire, TERMIUM Plus, le GDT, une encyclopédie, une
recherche générale sur le domaine ;
demander à un agent conversationnel ce que veut dire un mot, dans quel
domaine il s’emploie, quelle est sa catégorie grammaticale dans une phrase
donnée, ou de vous en donner des exemples d’usage ;
relire les consignes d’annotation autant de fois que nécessaire, et me poser
des questions dessus.
Interdit :
demander à un agent conversationnel quels mots d’un passage sont des termes,
d’extraire les termes d’un texte, d’en tirer une liste de candidats ou de
mots-clés, sous quelque formulation que ce soit ;
coller tout ou partie des textes du projet dans un agent conversationnel pour
lui demander de les analyser ;
utiliser un extracteur de termes ou une fonction d’extraction de mots-clés
sur les textes du projet ;
chercher une version déjà annotée des textes, ou une liste de termes déjà
publiée pour ces documents précis ;
comparer votre annotation avec celle d’une autre personne avant l’échéance.
Deux exemples :
Permis : vous rencontrez « débit de dose » dans le texte, sans savoir ce
que c’est. Vous demandez à un agent conversationnel ce que l’expression
désigne, et il vous répond que c’est une quantité de rayonnement reçue par
unité de temps. Vous décidez ensuite vous-même si c’est un terme du domaine
au sens des consignes.
Interdit : vous collez le paragraphe qui contient « débit de dose » et
vous demandez quels éléments du paragraphe sont des termes techniques. Peu
importe que vous suiviez ou non la réponse : la tâche est faite.
Ce qui est interdit avant l’échéance devient le cœur du
travail après : le troisième temps consiste justement à faire travailler un outil et un
agent sur les mêmes textes. Si vous vous demandez si un usage précis est
permis, posez-moi la question avant plutôt qu’après.
La dimension recherche
L’annotation du Projet 1 sert aussi de premier groupe d’annotateurs à une
étude que je mène sur l’annotation terminologique, AnnoTerm. Votre charge de
travail et votre note sont exactement les mêmes que vous participiez à l’étude
ou non : le projet compte pour 20 %, il est corrigé selon les mêmes critères,
et rien dans la correction ne dépend de votre décision.
Ce qui change, en revanche, c’est la forme de la tâche. Plusieurs
contraintes du Projet 1 viennent de l’étude et non de la pédagogie, et une
contrainte dont on connaît la raison se supporte mieux qu’une contrainte
arbitraire :
les textes sont fixés et identiques pour tout le monde ;
la plateforme est imposée ;
la consigne d’annotation est unique et ne se négocie pas ;
il est interdit d’en discuter avant la remise ;
l’échéance est ferme ;
les outils qui proposent des candidats sont interdits.
Sur quoi porte le consentement
Le projet, vous le faites en entier dans tous les cas. Le consentement porte
sur une seule chose : que vos données servent aussi à l’étude que nous
comptons publier. Vous pouvez donc faire tout le projet et refuser cela. La
question vous a été envoyée pendant la séance du 3 septembre 2026, par un courriel de
Noah Tremblay Taillon menant à un questionnaire LimeSurvey ; votre réponse est
attendue pour le 1er octobre 2026. Elle ne passe pas par moi : je n’ai pas accès aux
réponses, et je n’apprends qu’après la remise des notes finales qui a consenti
à l’étude et qui n’y a pas consenti.
Les deux questionnaires du projet, eux, sont des travaux de cours, et je vois
vos réponses comme je vois vos annotations. La seule chose que je ne vois
pas, c’est votre réponse à la question du consentement.
Retirer son consentement
Vous pouvez retirer votre consentement jusqu’au 1er novembre 2026, sans avoir à
vous justifier et sans aucune conséquence sur le cours. La demande passe par
Noah, jamais par moi. Ce retrait ne vous retire pas du projet, qui reste noté
comme pour tout le monde : il veut dire seulement que vos données ne serviront
pas à l’étude publiée.
L’encadrement éthique
L’étude a reçu l’approbation du comité d’éthique de la recherche en arts et en
humanités le 24 août 2026 (dossier 2026-8835, CERAH). Elle est financée par le
FRQNT (2025-NCM-362349).
This page is only available in French.
🔒 Projet 1 · The group's annotationsProjet 1 · Les annotations du groupeis course material (TRA6008). Open it on the site to include it here.est réservé au cours (TRA6008). Ouvrez-le sur le site pour l'inclure ici.
Projet 1 · The group's annotationsProjet 1 · Les annotations du groupe
The group's agreement scoresLes scores d'accord du groupe
#FORMAT=WebAnno TSV 3.3#T_SP=webanno.custom.Terme|Commentaire#Text=Among the various cardiovascular diseases, heart failure (HF) is projected to have the largest increases in incidence over the coming decades; therefore, improving HF prediction is of significant value.2-6 187-201 cardiovascular *[8] 2-7 202-210 diseases *[8] 2-8 210-211 , _ 2-9 212-217 heart *[9] 2-10 218-225 failure *[9] 2-11 226-227 ( _ 2-12 227-229 HF * 2-13 229-230 ) _ 2-14 231-233 is _ …2-20 264-273 increases _ 2-21 274-276 in _ 2-22 277-286 incidence *
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 1. Du fichier exporté au score F1, sur une phrase, entre deux annotateurs pris comme exemple, A et B.
Scores computed on 5 October 2026 from the INCEpTION export; initials instead of names.Scores calculés le 5 octobre 2026 à partir de l'export INCEpTION ; des initiales plutôt que des noms.
La colonne « moyenne », au bout de votre ligne, est votre accord moyen
avec les huit autres personnes, pour la langue et la règle choisies au-dessus
du tableau : c’est le chiffre que demande le rapport individuel (section 3.1,
règle 3).
Les couleurs vont du score le plus bas de ce tableau au plus haut ; la
légende donne les deux valeurs.
Les causes de désaccord : la frontière du terme, les sigles, les mots
courants au sens spécialisé, le degré de spécialisation. Vos propres cas sont sur la page de
comparaison (see also the Comparing two lists, term by term page) (voir aussi la page Comparer deux listes, terme par terme).
L’accord moyen du groupe
L’accord moyen du groupe est la moyenne des 36 scores F1 du tableau, une fois
par langue et par règle de correspondance.
Rule 1: exactRègle 1 : exacte
Rule 2: formRègle 2 : forme
Rule 3: pluralRègle 3 : pluriel
English textsTextes en anglais
Mean agreement (F1)Accord moyen (F1)
0.520,52
0.530,53
0.530,53
Terms marked by at least one personTermes marqués par au moins une personne
434
407
389
Mean size of a listTaille moyenne d'une liste
167
160
152
Shortest and longest listListe la plus courte et la plus longue
83 and 31783 et 317
79 and 29779 et 297
75 and 28175 et 281
Majority listListe majoritaire
133
127
118
French textsTextes en français
Mean agreement (F1)Accord moyen (F1)
0.590,59
0.590,59
0.600,60
Terms marked by at least one personTermes marqués par au moins une personne
414
379
357
Mean size of a listTaille moyenne d'une liste
174
160
153
Shortest and longest listListe la plus courte et la plus longue
108 and 250108 et 250
97 and 22997 et 229
94 and 21694 et 216
Majority listListe majoritaire
146
131
125
Ce que chaque règle de correspondance change pour ce groupe : l'accord moyen (la moyenne des 36 paires), le nombre de termes différents, la taille des listes et celle de la liste majoritaire.
Les règles de correspondance
Les règles 2 et 3 réunissent des formes que la règle 1 sépare, par exemple
« disease » et « diseases » (see also the Project 1 · Step by step page) (voir aussi la page Projet 1 · Pas à pas).
Le tableau montre ce que cela change pour ce groupe : de la règle 1 à la règle 3,
les termes différents, les listes et la liste majoritaire raccourcissent
d’environ un dixième en anglais et un peu plus en français, mais l’accord
monte à peine. Les désaccords portent donc rarement sur la forme d’un terme : ils
portent sur ce qui compte comme terme et sur ses frontières, que
les règles ne touchent pas.
L’anglais et le français
Le groupe s’accorde mieux sur les textes français, selon les trois
règles. Les textes français et anglais sont des résumés différents : l’écart
peut donc venir des textes autant que de la langue.
Le nombre de termes
Ensemble, les neuf personnes ont marqué bien plus de termes différents
qu’une seule liste n’en contient : selon la règle 3, 389 en anglais et 357 en
français, contre 152 et 153 dans une liste moyenne.
Les listes diffèrent par les termes retenus, et aussi par leur nombre :
en anglais, la plus longue compte près de quatre fois plus de termes que la
plus courte. Deux listes de tailles très différentes ne peuvent pas avoir un
F1 élevé, même si la plus courte est entièrement comprise dans la plus
longue : pour ces deux listes extrêmes, le F1 ne peut pas dépasser 0,42.
Par rapport à la recherche
Les scores d’accord du groupe sont du même ordre que ceux d’études publiées. Dans une étude
sur des résumés scientifiques en anglais sur l’insuffisance cardiaque, huit
personnes aux profils variés obtenaient un F1 moyen de 0,48 avec de simples
définitions du terme, et de 0,59 avec des consignes complètes, calculé comme
ici entre chaque paire de personnes et sur les formes distinctes (Rigouts
Terryn et al., 2020a, tableau 2). Un accord entre 0,5 et 0,6 reflète la
difficulté de la tâche.
Sources
Rigouts Terryn, A., Hoste, V., & Lefever, E. (2020a). In No Uncertain Terms: A Dataset for Monolingual and Multilingual Automatic Term Extraction from Comparable Corpora. Language Resources and Evaluation, 54(2), 385–418. https://doi.org/10.1007/s10579-019-09453-9
This page is only available in French.
Comparing two lists, term by termComparer deux listes, terme par terme
Click the drawing, or a line below, to build it up stage by stage.Cliquez sur le dessin, ou sur une ligne ci-dessous, pour le construire étape par étape.
Figure 2. Un vote majoritaire sur neuf listes fictives.
Le groupe et la référence
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
1.001,00
0.320,32
0.490,49
FD
1.001,00
0.360,36
0.530,53
GH
1.001,00
0.730,73
0.840,84
JD
1.001,00
0.380,38
0.550,55
JC
1.001,00
0.510,51
0.670,67
JP
1.001,00
0.360,36
0.530,53
LA
1.001,00
0.190,19
0.320,32
MI
1.001,00
0.360,36
0.530,53
VL
1.001,00
0.250,25
0.400,40
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.970,97
0.450,45
0.610,61
FD
0.910,91
0.470,47
0.620,62
GH
0.800,80
0.830,83
0.810,81
JD
0.930,93
0.500,50
0.650,65
JC
0.940,94
0.680,68
0.790,79
JP
0.920,92
0.480,48
0.630,63
LA
0.930,93
0.250,25
0.400,40
MI
0.990,99
0.510,51
0.670,67
VL
0.970,97
0.350,35
0.520,52
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.890,89
0.530,53
0.670,67
FD
0.760,76
0.510,51
0.610,61
GH
0.650,65
0.880,88
0.750,75
JD
0.850,85
0.580,58
0.690,69
JC
0.840,84
0.780,78
0.810,81
JP
0.860,86
0.580,58
0.690,69
LA
0.900,90
0.320,32
0.470,47
MI
0.940,94
0.620,62
0.740,74
VL
0.960,96
0.450,45
0.610,61
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.820,82
0.660,66
0.730,73
FD
0.620,62
0.560,56
0.590,59
GH
0.520,52
0.940,94
0.670,67
JD
0.690,69
0.640,64
0.670,67
JC
0.700,70
0.880,88
0.780,78
JP
0.730,73
0.660,66
0.690,69
LA
0.810,81
0.390,39
0.520,52
MI
0.810,81
0.730,73
0.770,77
VL
0.920,92
0.580,58
0.710,71
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.760,76
0.800,80
0.780,78
FD
0.500,50
0.590,59
0.550,55
GH
0.410,41
0.980,98
0.580,58
JD
0.560,56
0.680,68
0.610,61
JC
0.570,57
0.950,95
0.720,72
JP
0.610,61
0.730,73
0.670,67
LA
0.770,77
0.480,48
0.590,59
MI
0.690,69
0.810,81
0.740,74
VL
0.790,79
0.650,65
0.720,72
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.620,62
0.890,89
0.730,73
FD
0.420,42
0.670,67
0.520,52
GH
0.310,31
1.001,00
0.470,47
JD
0.470,47
0.790,79
0.590,59
JC
0.430,43
0.960,96
0.590,59
JP
0.490,49
0.790,79
0.600,60
LA
0.690,69
0.580,58
0.630,63
MI
0.550,55
0.870,87
0.670,67
VL
0.650,65
0.720,72
0.680,68
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.440,44
1.001,00
0.610,61
FD
0.280,28
0.720,72
0.400,40
GH
0.190,19
1.001,00
0.320,32
JD
0.340,34
0.900,90
0.490,49
JC
0.270,27
0.980,98
0.430,43
JP
0.370,37
0.950,95
0.530,53
LA
0.540,54
0.740,74
0.630,63
MI
0.360,36
0.920,92
0.520,52
VL
0.460,46
0.820,82
0.580,58
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.310,31
1.001,00
0.470,47
FD
0.240,24
0.860,86
0.370,37
GH
0.140,14
1.001,00
0.240,24
JD
0.250,25
0.950,95
0.400,40
JC
0.200,20
1.001,00
0.330,33
JP
0.270,27
0.980,98
0.420,42
LA
0.430,43
0.840,84
0.570,57
MI
0.280,28
1.001,00
0.430,43
VL
0.330,33
0.840,84
0.470,47
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.140,14
1.001,00
0.250,25
FD
0.130,13
1.001,00
0.230,23
GH
0.060,06
1.001,00
0.120,12
JD
0.120,12
1.001,00
0.220,22
JC
0.090,09
1.001,00
0.170,17
JP
0.130,13
1.001,00
0.230,23
LA
0.240,24
1.001,00
0.390,39
MI
0.130,13
1.001,00
0.230,23
VL
0.180,18
1.001,00
0.310,31
The 133 terms at least 5 of the 9 annotators markedLes 133 termes qu'au moins 5 des 9 personnes ont marqués
9 of 9 · 20 terms9 sur 9 · 20 termes
body mass index
cardiac resynchronization therapy
cardiovascular diseases
case-control analysis
CHF
clinical practice
congestive heart failure
cTnT
diabetes mellitus
ejection fraction
heart failure
heart rate
hyperkalemia
intubations
left ventricular ejection fraction
morbidity
mortality
spironolactone
systolic heart failure
Troponin T
8 of 9 · 23 terms8 sur 9 · 23 termes
biomarker
biomarkers
clinical trials
confidence intervals
CRT
diabetes
dialysis
dialysis-dependent patients
echocardiograms
emergency department
HF
high-sensitivity assay
hospitalization
implantation
International Classification of Diseases
intubated
laboratory report
NT-proBNP
periprocedural
reverse remodeling
Spironolactone
systolic blood pressure
β-blocker
7 of 9 · 18 terms7 sur 9 · 18 termes
acute kidney injury
AUCs
bundle branch morphology
CIs
confidence interval
Congestive heart failure
echocardiographic
ED
hazard ratio
heart failure patients
HF prediction model
implant
implantable cardioverter-defibrillator
N-terminal pro-B-type natriuretic peptide
NRIs
randomized trials
regression analyses
symptomatic systolic heart failure
6 of 9 · 37 terms6 sur 9 · 37 termes
Aldosterone receptor antagonists
all-cause hospitalization
angiotensin II receptor blocker
angiotensin-converting enzyme inhibitor
ARIC HF model
atherosclerosis
AUC
cardiac troponin T
cardiomyopathy
CHF patients
clinical characteristics
clinical status
Cox regression
CRT implantation
Crude rates
device implantation
diagnosed
dialysis patients
dialysis-dependent
ED physicians
ED visits
end-of-life treatment
heart failure risk
incident HF
incident systolic heart failure
integrated discrimination improvement
Intubation
laboratory report model
medications
net reclassification improvement
NRI
patients
physicians
prevalent coronary heart disease
severe hyperkalemia
sex-specific models
treatment
5 of 9 · 35 terms5 sur 9 · 35 termes
adverse events
Aldosterone
all-cause hospitalizations
antagonists
antihypertensive medication
ARIC
atherosclerosis risk
Atherosclerosis Risk in Communities
Cardiac resynchronization therapy
cardiomyopathy origin
cardioverter-defibrillator
CHF treatments
class I recommendation
coronary heart disease
deactivation
deterioration
Dialysis
Dialysis patients
HF hospitalizations
hospitalizations
implantable
intubation
Intubation rates
intubation rates
model fit
natriuretic peptide
Patient
Patients
receptor
Retrospective cohort
risk of hospitalization
serum potassium level
sex-specific model
Student t test
time-varying covariates
The 130 terms found in only one of the 9 listsLes 130 termes présents dans une seule des 9 listes
"laboratory report" model
-fold
6-month echocardiograms
advances
AIM
analysis
analyze
area under the receiver operating characteristic curve (AUC)
ARIC)
assay
assessed
assessment
associated
association
atherosclerosis risk in communities
average
baseline serum creatinine
benefit
body mass
Cardiac resynchronization
cardiac troponin
characteristic curve (AUC)
coefficient
collect
communicate
compelling improvement
CONCLUSION
conclusion
CONCLUSIONS
confidence
confidence intervals (CIs)
congestive heart failure (CHF)
consecutive patients
coronary
correlation
correlation coefficient R
Cox
Cox regression with time-varying covariates
creatinine level
Crude
cTnT and NT-proBNP
current/former smoking
deactivation discussions
declined
decrease
decreases
described
developed
device
dialysis-dependent patients with heart failure
dialysis-dependent patients with HF
discrimination
discrimination improvement
discussed
echocardiographic outcomes.
emergency department (ED)
evaluate
excluded
failure
heart
Heart Function
HF risk
hypothesize
identified
improvement
improvements
incident
increased
increased risk of hyperkalemia
increases
increases in incidence
initiated
interval
interview data
left ventricular ejection
life
male
mean
mean follow-up
median
medication use
mellitus
men
mEq
month
n =
N-terminal pro-B-type
N-terminal pro-B-type natriuretic peptide:
observed
operating characteristic curve
operating characteristic curve (AUC)
PARTICIPANTS
participants
patient awareness
patient's
perspective
prediction model.
preferences
process
qualitative
Rates
rates of annual ED visits
receptor antagonists
reclassification
reduce
regression
report model
RESULTS
resynchronization
resynchronization therapy
Retrospective
serious complications
simple sex-specific model
simpler laboratory report model
smoking
statistically
Student t test,
studies
systolic heart failure,
theory
timing
total ED visits
trials
Troponin T and N-terminal pro-B-type natriuretic peptide
use
use of spironolactone
value
ventricular
visits
women
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
1.001,00
0.330,33
0.500,50
FD
1.001,00
0.380,38
0.550,55
GH
1.001,00
0.730,73
0.840,84
JD
1.001,00
0.390,39
0.560,56
JC
1.001,00
0.500,50
0.670,67
JP
1.001,00
0.380,38
0.550,55
LA
1.001,00
0.190,19
0.330,33
MI
1.001,00
0.370,37
0.540,54
VL
1.001,00
0.260,26
0.410,41
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.980,98
0.460,46
0.620,62
FD
0.910,91
0.490,49
0.640,64
GH
0.810,81
0.830,83
0.820,82
JD
0.940,94
0.510,51
0.660,66
JC
0.940,94
0.670,67
0.780,78
JP
0.920,92
0.490,49
0.640,64
LA
0.920,92
0.250,25
0.400,40
MI
0.990,99
0.510,51
0.680,68
VL
0.980,98
0.350,35
0.520,52
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.900,90
0.540,54
0.670,67
FD
0.760,76
0.520,52
0.620,62
GH
0.670,67
0.880,88
0.760,76
JD
0.860,86
0.590,59
0.700,70
JC
0.850,85
0.770,77
0.810,81
JP
0.860,86
0.590,59
0.700,70
LA
0.910,91
0.320,32
0.470,47
MI
0.930,93
0.610,61
0.740,74
VL
0.970,97
0.450,45
0.610,61
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.820,82
0.670,67
0.740,74
FD
0.620,62
0.590,59
0.600,60
GH
0.530,53
0.950,95
0.680,68
JD
0.700,70
0.670,67
0.680,68
JC
0.710,71
0.880,88
0.780,78
JP
0.720,72
0.670,67
0.700,70
LA
0.800,80
0.380,38
0.520,52
MI
0.810,81
0.730,73
0.760,76
VL
0.910,91
0.580,58
0.710,71
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.760,76
0.800,80
0.780,78
FD
0.520,52
0.640,64
0.570,57
GH
0.420,42
0.980,98
0.590,59
JD
0.570,57
0.710,71
0.630,63
JC
0.580,58
0.940,94
0.720,72
JP
0.610,61
0.740,74
0.670,67
LA
0.760,76
0.470,47
0.580,58
MI
0.690,69
0.800,80
0.740,74
VL
0.800,80
0.650,65
0.720,72
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.650,65
0.870,87
0.750,75
FD
0.440,44
0.680,68
0.540,54
GH
0.340,34
1.001,00
0.510,51
JD
0.500,50
0.780,78
0.610,61
JC
0.470,47
0.960,96
0.630,63
JP
0.500,50
0.760,76
0.600,60
LA
0.700,70
0.550,55
0.610,61
MI
0.580,58
0.860,86
0.700,70
VL
0.710,71
0.730,73
0.720,72
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.440,44
1.001,00
0.610,61
FD
0.280,28
0.750,75
0.410,41
GH
0.200,20
1.001,00
0.330,33
JD
0.340,34
0.920,92
0.500,50
JC
0.280,28
0.980,98
0.440,44
JP
0.360,36
0.950,95
0.530,53
LA
0.540,54
0.730,73
0.620,62
MI
0.360,36
0.920,92
0.520,52
VL
0.460,46
0.810,81
0.590,59
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.310,31
1.001,00
0.470,47
FD
0.240,24
0.880,88
0.370,37
GH
0.140,14
1.001,00
0.250,25
JD
0.260,26
0.950,95
0.400,40
JC
0.200,20
1.001,00
0.340,34
JP
0.270,27
0.980,98
0.420,42
LA
0.440,44
0.830,83
0.580,58
MI
0.280,28
1.001,00
0.440,44
VL
0.340,34
0.830,83
0.480,48
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.150,15
1.001,00
0.260,26
FD
0.130,13
1.001,00
0.230,23
GH
0.070,07
1.001,00
0.130,13
JD
0.130,13
1.001,00
0.230,23
JC
0.100,10
1.001,00
0.180,18
JP
0.130,13
1.001,00
0.230,23
LA
0.250,25
1.001,00
0.400,40
MI
0.130,13
1.001,00
0.240,24
VL
0.190,19
1.001,00
0.320,32
The 127 terms at least 5 of the 9 annotators markedLes 127 termes qu'au moins 5 des 9 personnes ont marqués
9 of 9 · 20 terms9 sur 9 · 20 termes
body mass index
cardiac resynchronization therapy
cardiovascular diseases
case-control analysis
CHF
clinical practice
congestive heart failure
cTnT
diabetes mellitus
ejection fraction
heart failure
heart rate
hyperkalemia
intubations
left ventricular ejection fraction
morbidity
mortality
spironolactone
systolic heart failure
Troponin T
8 of 9 · 22 terms8 sur 9 · 22 termes
biomarker
biomarkers
clinical trials
confidence intervals
CRT
diabetes
dialysis
dialysis-dependent patients
echocardiograms
emergency department
HF
high-sensitivity assay
hospitalization
implantation
International Classification of Diseases
intubated
laboratory report
NT-proBNP
periprocedural
reverse remodeling
systolic blood pressure
β-blocker
7 of 9 · 17 terms7 sur 9 · 17 termes
acute kidney injury
AUCs
bundle branch morphology
CIs
confidence interval
echocardiographic
ED
hazard ratio
heart failure patients
HF prediction model
implant
implantable cardioverter-defibrillator
N-terminal pro-B-type natriuretic peptide
NRIs
randomized trials
regression analyses
symptomatic systolic heart failure
6 of 9 · 42 terms6 sur 9 · 42 termes
Aldosterone receptor antagonists
all-cause hospitalization
angiotensin II receptor blocker
angiotensin-converting enzyme inhibitor
ARIC
ARIC HF model
atherosclerosis
Atherosclerosis Risk in Communities
AUC
baseline
cardiac troponin T
cardiomyopathy
CHF patients
clinical characteristics
clinical status
Cox regression
CRT implantation
Crude rates
device implantation
diagnosed
dialysis patients
dialysis-dependent
ED physicians
ED visits
end-of-life treatment
heart failure risk
incident HF
incident systolic heart failure
integrated discrimination improvement
Intubation
Intubation rates
laboratory report model
medications
net reclassification improvement
NRI
patients
physicians
prevalent coronary heart disease
severe hyperkalemia
sex-specific models
Student t test
treatment
5 of 9 · 26 terms5 sur 9 · 26 termes
adverse events
Aldosterone
all-cause hospitalizations
antagonists
antihypertensive medication
atherosclerosis risk
cardiomyopathy origin
cardioverter-defibrillator
CHF treatments
class I recommendation
coronary heart disease
deactivation
deterioration
end of life
HF hospitalizations
hospitalizations
implantable
model fit
natriuretic peptide
Patient
receptor
Retrospective cohort
risk of hospitalization
serum potassium level
sex-specific model
time-varying covariates
The 119 terms found in only one of the 9 listsLes 119 termes présents dans une seule des 9 listes
-fold
6-month echocardiograms
advances
AIM
analysis
analyze
area under the receiver operating characteristic curve (AUC
assay
assessed
assessment
associated
association
average
baseline serum creatinine
benefit
body mass
cardiac troponin
characteristic curve (AUC
coefficient
collect
communicate
compelling improvement
CONCLUSION
CONCLUSIONS
confidence
confidence intervals (CIs
congestive heart failure (CHF
consecutive patients
coronary
correlation
correlation coefficient R
Cox
Cox regression with time-varying covariates
creatinine level
Crude
cTnT and NT-proBNP
current/former smoking
deactivation discussions
declined
decrease
decreases
described
developed
device
dialysis-dependent patients with heart failure
dialysis-dependent patients with HF
discrimination
discrimination improvement
discussed
emergency department (ED
evaluate
excluded
failure
heart
Heart Function
HF risk
hypothesize
identified
improvement
improvements
incident
increased
increased risk of hyperkalemia
increases
increases in incidence
initiated
interval
interview data
left ventricular ejection
life
male
mean
mean follow-up
median
medication use
mellitus
men
mEq
month
n =
N-terminal pro-B-type
observed
operating characteristic curve
operating characteristic curve (AUC
participants
patient awareness
patient's
perspective
prediction model
preferences
process
qualitative
rates of annual ED visits
receptor antagonists
reclassification
reduce
regression
report model
RESULTS
resynchronization
resynchronization therapy
Retrospective
serious complications
simple sex-specific model
simpler laboratory report model
smoking
statistically
studies
theory
timing
total ED visits
trials
Troponin T and N-terminal pro-B-type natriuretic peptide
use
use of spironolactone
value
ventricular
visits
women
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
1.001,00
0.330,33
0.490,49
FD
1.001,00
0.400,40
0.570,57
GH
1.001,00
0.720,72
0.840,84
JD
1.001,00
0.390,39
0.560,56
JC
1.001,00
0.500,50
0.670,67
JP
1.001,00
0.380,38
0.550,55
LA
1.001,00
0.190,19
0.320,32
MI
1.001,00
0.360,36
0.530,53
VL
1.001,00
0.260,26
0.410,41
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.980,98
0.460,46
0.620,62
FD
0.910,91
0.510,51
0.650,65
GH
0.810,81
0.830,83
0.820,82
JD
0.930,93
0.510,51
0.660,66
JC
0.930,93
0.660,66
0.770,77
JP
0.920,92
0.490,49
0.640,64
LA
0.920,92
0.250,25
0.400,40
MI
0.990,99
0.510,51
0.670,67
VL
0.980,98
0.360,36
0.530,53
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.900,90
0.540,54
0.670,67
FD
0.760,76
0.550,55
0.640,64
GH
0.670,67
0.880,88
0.760,76
JD
0.850,85
0.600,60
0.700,70
JC
0.840,84
0.770,77
0.800,80
JP
0.860,86
0.600,60
0.710,71
LA
0.910,91
0.320,32
0.470,47
MI
0.930,93
0.610,61
0.740,74
VL
0.970,97
0.460,46
0.620,62
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.810,81
0.670,67
0.730,73
FD
0.620,62
0.620,62
0.620,62
GH
0.520,52
0.950,95
0.670,67
JD
0.700,70
0.680,68
0.690,69
JC
0.700,70
0.880,88
0.780,78
JP
0.730,73
0.690,69
0.710,71
LA
0.790,79
0.380,38
0.510,51
MI
0.810,81
0.730,73
0.770,77
VL
0.910,91
0.590,59
0.720,72
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.740,74
0.810,81
0.770,77
FD
0.520,52
0.680,68
0.590,59
GH
0.410,41
0.980,98
0.580,58
JD
0.570,57
0.730,73
0.640,64
JC
0.580,58
0.950,95
0.720,72
JP
0.610,61
0.760,76
0.680,68
LA
0.750,75
0.470,47
0.580,58
MI
0.680,68
0.810,81
0.740,74
VL
0.800,80
0.690,69
0.740,74
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.650,65
0.860,86
0.740,74
FD
0.440,44
0.710,71
0.540,54
GH
0.340,34
1.001,00
0.510,51
JD
0.510,51
0.800,80
0.630,63
JC
0.480,48
0.970,97
0.640,64
JP
0.520,52
0.790,79
0.630,63
LA
0.690,69
0.540,54
0.610,61
MI
0.600,60
0.880,88
0.710,71
VL
0.710,71
0.750,75
0.730,73
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.460,46
0.980,98
0.630,63
FD
0.300,30
0.780,78
0.440,44
GH
0.210,21
1.001,00
0.350,35
JD
0.370,37
0.920,92
0.520,52
JC
0.300,30
0.980,98
0.470,47
JP
0.390,39
0.950,95
0.550,55
LA
0.560,56
0.700,70
0.620,62
MI
0.410,41
0.950,95
0.570,57
VL
0.480,48
0.820,82
0.610,61
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.340,34
1.001,00
0.500,50
FD
0.250,25
0.880,88
0.390,39
GH
0.150,15
1.001,00
0.270,27
JD
0.270,27
0.950,95
0.420,42
JC
0.220,22
1.001,00
0.360,36
JP
0.290,29
0.980,98
0.440,44
LA
0.480,48
0.840,84
0.610,61
MI
0.310,31
1.001,00
0.470,47
VL
0.370,37
0.860,86
0.510,51
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.170,17
1.001,00
0.290,29
FD
0.140,14
1.001,00
0.250,25
GH
0.080,08
1.001,00
0.140,14
JD
0.150,15
1.001,00
0.260,26
JC
0.110,11
1.001,00
0.200,20
JP
0.150,15
1.001,00
0.260,26
LA
0.290,29
1.001,00
0.450,45
MI
0.160,16
1.001,00
0.270,27
VL
0.220,22
1.001,00
0.360,36
The 118 terms at least 5 of the 9 annotators markedLes 118 termes qu'au moins 5 des 9 personnes ont marqués
9 of 9 · 22 terms9 sur 9 · 22 termes
biomarker
body mass index
cardiac resynchronization therapy
cardiovascular diseases
case-control analysis
CHF
clinical practice
congestive heart failure
cTnT
diabetes mellitus
ejection fraction
heart failure
heart rate
hyperkalemia
intubations
left ventricular ejection fraction
morbidity
mortality
NRI
spironolactone
systolic heart failure
Troponin T
8 of 9 · 21 terms8 sur 9 · 21 termes
AUC
clinical trials
confidence interval
CRT
diabetes
dialysis
dialysis-dependent patients
echocardiograms
emergency department
HF
high-sensitivity assay
hospitalization
implantation
International Classification of Diseases
intubated
laboratory report
NT-proBNP
periprocedural
reverse remodeling
systolic blood pressure
β-blocker
7 of 9 · 17 terms7 sur 9 · 17 termes
acute kidney injury
all-cause hospitalization
bundle branch morphology
CIs
echocardiographic
ED
hazard ratio
heart failure patients
HF prediction model
implant
implantable cardioverter-defibrillator
N-terminal pro-B-type natriuretic peptide
randomized trials
regression analyses
sex-specific models
symptomatic systolic heart failure
treatment
6 of 9 · 36 terms6 sur 9 · 36 termes
Aldosterone receptor antagonists
angiotensin II receptor blocker
angiotensin-converting enzyme inhibitor
ARIC
ARIC HF model
atherosclerosis
Atherosclerosis Risk in Communities
baseline
cardiac troponin T
cardiomyopathy
CHF patients
clinical characteristics
clinical status
Cox regression
CRT implantation
Crude rates
device implantation
diagnosed
dialysis patients
dialysis-dependent
ED physicians
ED visits
end-of-life treatment
heart failure risk
incident HF
incident systolic heart failure
integrated discrimination improvement
Intubation rates
laboratory report model
medication
net reclassification improvement
patients
physicians
prevalent coronary heart disease
severe hyperkalemia
Student t test
5 of 9 · 22 terms5 sur 9 · 22 termes
adverse events
Aldosterone
antagonists
antihypertensive medication
atherosclerosis risk
cardiomyopathy origin
cardioverter-defibrillator
CHF treatments
class I recommendation
coronary heart disease
deactivation
deterioration
end of life
HF hospitalization
implantable
model fit
natriuretic peptide
receptor
Retrospective cohort
risk of hospitalization
serum potassium level
time-varying covariates
The 115 terms found in only one of the 9 listsLes 115 termes présents dans une seule des 9 listes
-fold
6-month echocardiograms
advances
AIM
analysis
analyze
area under the receiver operating characteristic curve (AUC
assay
assessed
assessment
associated
association
average
baseline serum creatinine
body mass
cardiac troponin
characteristic curve (AUC
coefficient
collect
communicate
compelling improvement
CONCLUSION
confidence
confidence intervals (CIs
congestive heart failure (CHF
consecutive patients
coronary
correlation
correlation coefficient R
Cox
Cox regression with time-varying covariates
creatinine level
Crude
cTnT and NT-proBNP
current/former smoking
deactivation discussions
declined
decrease
described
developed
device
dialysis-dependent patients with heart failure
dialysis-dependent patients with HF
discrimination
discrimination improvement
discussed
emergency department (ED
evaluate
excluded
failure
heart
Heart Function
HF risk
hypothesize
identified
improvements
incident
increased
increased risk of hyperkalemia
increases
increases in incidence
initiated
interval
interview data
left ventricular ejection
life
male
mean
mean follow-up
median
medication use
mellitus
men
mEq
month
n =
N-terminal pro-B-type
observed
operating characteristic curve
operating characteristic curve (AUC
participants
patient awareness
patient's
perspective
prediction model
preferences
process
qualitative
rates of annual ED visits
receptor antagonists
reclassification
reduce
regression
report model
RESULTS
resynchronization
resynchronization therapy
Retrospective
serious complications
simple sex-specific model
simpler laboratory report model
smoking
statistically
studies
theory
timing
total ED visits
trials
Troponin T and N-terminal pro-B-type natriuretic peptide
use
use of spironolactone
value
ventricular
visits
women
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
1.001,00
0.450,45
0.620,62
FD
1.001,00
0.290,29
0.450,45
GH
1.001,00
0.600,60
0.750,75
JD
1.001,00
0.510,51
0.680,68
JC
1.001,00
0.560,56
0.720,72
JP
1.001,00
0.420,42
0.600,60
LA
1.001,00
0.260,26
0.410,41
MI
1.001,00
0.390,39
0.560,56
VL
1.001,00
0.290,29
0.450,45
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.980,98
0.630,63
0.770,77
FD
0.960,96
0.400,40
0.570,57
GH
0.880,88
0.770,77
0.820,82
JD
0.880,88
0.650,65
0.750,75
JC
0.870,87
0.700,70
0.780,78
JP
0.950,95
0.580,58
0.730,73
LA
0.840,84
0.320,32
0.460,46
MI
0.960,96
0.540,54
0.690,69
VL
0.980,98
0.410,41
0.580,58
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.940,94
0.770,77
0.850,85
FD
0.900,90
0.480,48
0.630,63
GH
0.770,77
0.850,85
0.810,81
JD
0.760,76
0.720,72
0.740,74
JC
0.790,79
0.820,82
0.810,81
JP
0.880,88
0.690,69
0.770,77
LA
0.820,82
0.400,40
0.540,54
MI
0.850,85
0.610,61
0.710,71
VL
0.950,95
0.510,51
0.660,66
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.830,83
0.860,86
0.840,84
FD
0.790,79
0.540,54
0.640,64
GH
0.660,66
0.930,93
0.770,77
JD
0.680,68
0.810,81
0.740,74
JC
0.690,69
0.900,90
0.780,78
JP
0.810,81
0.800,80
0.810,81
LA
0.780,78
0.470,47
0.590,59
MI
0.750,75
0.690,69
0.720,72
VL
0.900,90
0.610,61
0.730,73
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.730,73
0.930,93
0.820,82
FD
0.720,72
0.600,60
0.650,65
GH
0.580,58
0.990,99
0.730,73
JD
0.590,59
0.860,86
0.700,70
JC
0.590,59
0.940,94
0.720,72
JP
0.720,72
0.870,87
0.790,79
LA
0.760,76
0.560,56
0.650,65
MI
0.660,66
0.730,73
0.690,69
VL
0.860,86
0.700,70
0.770,77
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.630,63
0.950,95
0.760,76
FD
0.650,65
0.630,63
0.640,64
GH
0.490,49
0.990,99
0.650,65
JD
0.540,54
0.930,93
0.680,68
JC
0.510,51
0.960,96
0.670,67
JP
0.640,64
0.920,92
0.760,76
LA
0.670,67
0.580,58
0.620,62
MI
0.600,60
0.800,80
0.690,69
VL
0.830,83
0.810,81
0.820,82
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.510,51
0.970,97
0.670,67
FD
0.560,56
0.700,70
0.620,62
GH
0.380,38
0.990,99
0.550,55
JD
0.450,45
0.980,98
0.610,61
JC
0.410,41
0.970,97
0.570,57
JP
0.530,53
0.960,96
0.680,68
LA
0.610,61
0.680,68
0.640,64
MI
0.510,51
0.840,84
0.630,63
VL
0.730,73
0.910,91
0.810,81
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.370,37
0.970,97
0.530,53
FD
0.470,47
0.810,81
0.600,60
GH
0.280,28
0.990,99
0.430,43
JD
0.330,33
0.990,99
0.490,49
JC
0.300,30
1.001,00
0.460,46
JP
0.380,38
0.960,96
0.550,55
LA
0.520,52
0.800,80
0.630,63
MI
0.400,40
0.910,91
0.550,55
VL
0.560,56
0.960,96
0.700,70
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.150,15
1.001,00
0.260,26
FD
0.220,22
1.001,00
0.360,36
GH
0.110,11
1.001,00
0.200,20
JD
0.130,13
1.001,00
0.230,23
JC
0.120,12
1.001,00
0.210,21
JP
0.150,15
1.001,00
0.270,27
LA
0.250,25
1.001,00
0.400,40
MI
0.170,17
1.001,00
0.290,29
VL
0.230,23
1.001,00
0.370,37
The 146 terms at least 5 of the 9 annotators markedLes 146 termes qu'au moins 5 des 9 personnes ont marqués
9 of 9 · 27 terms9 sur 9 · 27 termes
arythmies ventriculaires
auto-soins
bêta-bloquants
cardiopathies congénitales
d'insuffisance rénale
DNP
endopeptidase
l'ANP
L'asynchronisme
l'enzyme de conversion
l'hypertension artérielle
l'Incidence hospitalière
l'insuffisance cardiaque
l'urodilatine
maladie chronique
marqueurs pronostiques
molécules
mortalité hospitalière
NPR-C
NT-proBNP
post chirurgie
profil épidémiologique
Resynchronisation cardiaque
système rénine-angiotensine
Système Rénine-Angiotensine-Aldostérone
vasodilatatrice
Épidémiologie
8 of 9 · 43 terms8 sur 9 · 43 termes
Antagonistes
BNP
brain natriuretic peptide
cardiomyocyte
cardiopathie
cardiopathie congénitale
circulation sanguine
CNP
concentration plasmatique
d'IC
d'insuffisance cardiaque
diurétique
dysfonction ventriculaire
dysfonction ventriculaire gauche
développement clinique
fonction ventriculaire
hypertensive
inhibiteurs
ischémique
l'angiotensine II
l'asynchronisme
l'autodétermination
l'expansion volémique
l'IC
l'incidence hospitalière
natriurétique
néphropathie diabètique
pathologies cardiaques congénitales
peptides
peptides natriurétiques
plan de traitement
pratique clinique
proBNP
pré-proBNP
resynchronisation
récepteur de clairance
rénales
symptômes
thérapeutique
ventricule droit systémique
ventricule unique
échographique
équimolaire
7 of 9 · 27 terms7 sur 9 · 27 termes
activité biologique
antagonistes
B-type natriuretic peptide
centrales
clivé
d'inhiber
diagnostic
dosage
fonction rénale
fraction d'éjection ventriculaire gauche
hospitalisations
IC
intervention infirmière de soutien
interventions
L'autodétermination
l'hospitalisation
l'Ic
L'incidence hospitalière standardisée
l'Insuffisance cardiaque
L'épidémiologie
marqueurs
mort subite
NPR-A
peptide
récepteurs AT1
syndromes coronariens aigus
traitement
6 of 9 · 26 terms6 sur 9 · 26 termes
biologiques
calcium
cardiopathies
cliniques
clivage
congénitales
d'hospitalisation
diète
GI
groupe d'intervention
intervention infirmière
L'IC
L'insuffisance cardiaque
l'insuffisance rénale chronique
l'élimination
non-peptidiques
patients
prise en charge
récepteur
stimulation cardiaque de resynchronisation
synthétisé
TAD
techniques d'immunodosage automatisées
ventriculaire
voie orale
études cliniques
5 of 9 · 23 terms5 sur 9 · 23 termes
amélioration clinique
arythmies
concentration
congénitaux
d'affiliation
d'autonomie
d'immunodosage
dysfonction ventriculaire avec bloc de branche droit
groupe anatomique
hospitalisés
l'angiotensine
L'incidence hospitalière
l'insuffisance cardiaque gauche
l'insuffisance cardiaque gauche avec bloc de branche gauche
l'intervention
multicentriques
pathologies
physiologiquement
Resynchronisation
rénale
théorie de l'autodétermination
vasculaires
étude pilote
The 127 terms found in only one of the 9 listsLes 127 termes présents dans une seule des 9 listes
adultes
amélioration clinique et échographique
analytique
Antagonistes des récepteurs AT1 de l'angiotensine II
antagonistes non-peptidiques des récepteurs de l'angiotensine
appel téléphonique
aspects
AT1
besoin d'affiliation,
biologique
bloc
blocage du système
branche gauche
bénéfices à long terme
cas
challenges
chirurgie
CNP,
Conclusion
congénitale
critique
d'inhiber le système
de façon équimolaire
diurétique et natriurétique
dysfonction
dysfonction ventriculaire avec bloc de branche
développement
développement de l'insuffisance cardiaque
Effet
effets
famille
fonction ventriculaire de l'insuffisance cardiaque
fraction d'éjection
fréquence de l'insuffisance cardiaque
fréquence de l'insuffisance cardiaque à fonction systolique préservée
groupe anatomique et fonctionnel
groupe d'intervention (GI)
groupes de patients
hospitalisations répétées
hospitalière
implications
infirmière
inhibiteurs de l'enzyme
interpréter
intervention
l'angiotensine II.
l'effet
l'expansion volémique.
l'incidence
l'incidence hospitalière de l'IC
l'installation progressive
l'installation progressive de l'insuffisance cardiaque
l'Insuffisance cardiaque (IC)
l'âge moyen
l'étude ETICS
l'étude prospective ETICS
la circulation sanguine
La concentration plasmatique
la fonction rénale
la néphropathie diabètique
la resynchronisation
La stimulation cardiaque
La stimulation cardiaque de resynchronisation
Le dosage
le système rénine-angiotensine
les antagonistes du calcium
les inhibiteurs de l'enzyme de conversion de l'angiotensine
les récepteurs AT1 de l'angiotensine II
les syndromes coronariens aigus
Les études cliniques
limitée
long terme
modèle
modèle de l'insuffisance cardiaque
modèle de l'insuffisance cardiaque gauche avec bloc de branche gauche
mono
mono- ou multicentriques
mort
natriuretic
natriuretic peptide
par liaison
parent
patients atteints d'IC
patients atteints d'IC.
patients jeunes
pistes
population de patients
post chirurgie de cardiopathie congénitale
poussée d'IC
pratique des auto-soins
première poussée
première poussée d'IC
problèmes
pronostiques
prospective
précocement
prévention de l'insuffisance rénale
prévention de l'insuffisance rénale chronique
randomisée à deux groupes
rapport homme/femme
recherches
rendu de résultat
restrictions
resynchronisation en post chirurgie de cardiopathie congénitale
récepteurs AT1 de l'angiotensine II
Rénine-Angiotensine-Aldostérone
résultat
Résultats
résultats
Résultats de l'étude ETICS
soins
Somme
soutien
standardisée
systémique
sévères
traitement de l'hypertension artérielle
voie orale,
à deux groupes
à fonction systolique
à long terme
âge
équivalentes
étude
études mono
études mono-
évaluée
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
1.001,00
0.450,45
0.620,62
FD
1.001,00
0.320,32
0.480,48
GH
1.001,00
0.600,60
0.750,75
JD
1.001,00
0.520,52
0.680,68
JC
1.001,00
0.560,56
0.720,72
JP
1.001,00
0.430,43
0.600,60
LA
1.001,00
0.260,26
0.410,41
MI
1.001,00
0.390,39
0.560,56
VL
1.001,00
0.280,28
0.440,44
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.980,98
0.620,62
0.760,76
FD
0.960,96
0.430,43
0.590,59
GH
0.900,90
0.770,77
0.830,83
JD
0.890,89
0.650,65
0.750,75
JC
0.870,87
0.690,69
0.770,77
JP
0.960,96
0.580,58
0.730,73
LA
0.830,83
0.300,30
0.440,44
MI
0.950,95
0.520,52
0.680,68
VL
0.980,98
0.400,40
0.560,56
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.940,94
0.760,76
0.840,84
FD
0.910,91
0.520,52
0.670,67
GH
0.780,78
0.860,86
0.810,81
JD
0.760,76
0.720,72
0.740,74
JC
0.780,78
0.800,80
0.790,79
JP
0.880,88
0.690,69
0.770,77
LA
0.820,82
0.390,39
0.530,53
MI
0.840,84
0.600,60
0.700,70
VL
0.940,94
0.490,49
0.650,65
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.820,82
0.860,86
0.840,84
FD
0.780,78
0.590,59
0.670,67
GH
0.650,65
0.930,93
0.770,77
JD
0.670,67
0.820,82
0.740,74
JC
0.670,67
0.890,89
0.760,76
JP
0.800,80
0.810,81
0.810,81
LA
0.770,77
0.470,47
0.580,58
MI
0.750,75
0.690,69
0.720,72
VL
0.890,89
0.600,60
0.720,72
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.720,72
0.920,92
0.810,81
FD
0.720,72
0.660,66
0.690,69
GH
0.570,57
0.990,99
0.720,72
JD
0.580,58
0.870,87
0.700,70
JC
0.570,57
0.930,93
0.710,71
JP
0.720,72
0.890,89
0.790,79
LA
0.750,75
0.560,56
0.640,64
MI
0.650,65
0.720,72
0.680,68
VL
0.850,85
0.700,70
0.770,77
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.610,61
0.940,94
0.750,75
FD
0.650,65
0.710,71
0.680,68
GH
0.480,48
1.001,00
0.650,65
JD
0.530,53
0.940,94
0.670,67
JC
0.490,49
0.950,95
0.650,65
JP
0.640,64
0.940,94
0.760,76
LA
0.660,66
0.580,58
0.620,62
MI
0.600,60
0.800,80
0.690,69
VL
0.820,82
0.810,81
0.820,82
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.500,50
0.970,97
0.660,66
FD
0.570,57
0.770,77
0.650,65
GH
0.380,38
1.001,00
0.560,56
JD
0.440,44
0.980,98
0.610,61
JC
0.400,40
0.970,97
0.570,57
JP
0.530,53
0.970,97
0.680,68
LA
0.620,62
0.680,68
0.650,65
MI
0.510,51
0.850,85
0.640,64
VL
0.740,74
0.910,91
0.820,82
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.380,38
0.970,97
0.550,55
FD
0.480,48
0.880,88
0.620,62
GH
0.290,29
1.001,00
0.450,45
JD
0.330,33
0.980,98
0.500,50
JC
0.310,31
1.001,00
0.470,47
JP
0.400,40
0.970,97
0.560,56
LA
0.540,54
0.790,79
0.640,64
MI
0.410,41
0.910,91
0.560,56
VL
0.580,58
0.950,95
0.720,72
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.180,18
1.001,00
0.300,30
FD
0.250,25
1.001,00
0.400,40
GH
0.130,13
1.001,00
0.230,23
JD
0.150,15
1.001,00
0.270,27
JC
0.140,14
1.001,00
0.250,25
JP
0.180,18
1.001,00
0.310,31
LA
0.310,31
1.001,00
0.470,47
MI
0.200,20
1.001,00
0.340,34
VL
0.280,28
1.001,00
0.430,43
The 131 terms at least 5 of the 9 annotators markedLes 131 termes qu'au moins 5 des 9 personnes ont marqués
9 of 9 · 30 terms9 sur 9 · 30 termes
ANP
arythmies ventriculaires
asynchronisme
auto-soins
bêta-bloquants
cardiopathies congénitales
CNP
DNP
endopeptidase
enzyme de conversion
expansion volémique
hypertension artérielle
Incidence hospitalière
insuffisance cardiaque
insuffisance rénale
maladie chronique
marqueurs pronostiques
molécules
mortalité hospitalière
NPR-C
NT-proBNP
post chirurgie
profil épidémiologique
resynchronisation
Resynchronisation cardiaque
système rénine-angiotensine
Système Rénine-Angiotensine-Aldostérone
urodilatine
vasodilatatrice
Épidémiologie
8 of 9 · 36 terms8 sur 9 · 36 termes
angiotensine II
antagonistes
autodétermination
BNP
brain natriuretic peptide
cardiomyocyte
cardiopathie
cardiopathie congénitale
circulation sanguine
concentration plasmatique
diurétique
dysfonction ventriculaire
dysfonction ventriculaire gauche
développement clinique
fonction ventriculaire
hypertensive
IC
inhibiteurs
ischémique
natriurétique
néphropathie diabètique
pathologies cardiaques congénitales
peptides
peptides natriurétiques
plan de traitement
pratique clinique
proBNP
pré-proBNP
récepteur de clairance
rénales
symptômes
thérapeutique
ventricule droit systémique
ventricule unique
échographique
équimolaire
7 of 9 · 22 terms7 sur 9 · 22 termes
activité biologique
B-type natriuretic peptide
centrales
clivé
diagnostic
dosage
fonction rénale
fraction d'éjection ventriculaire gauche
hospitalisation
hospitalisations
incidence hospitalière standardisée
inhiber
intervention infirmière de soutien
interventions
marqueurs
mort subite
NPR-A
peptide
récepteurs AT1
syndromes coronariens aigus
traitement
voie orale
6 of 9 · 22 terms6 sur 9 · 22 termes
biologiques
calcium
cardiopathies
cliniques
clivage
congénitales
diète
GI
groupe d'intervention
insuffisance rénale chronique
intervention infirmière
non-peptidiques
patients
prise en charge
récepteur
stimulation cardiaque de resynchronisation
synthétisé
TAD
techniques d'immunodosage automatisées
ventriculaire
élimination
études cliniques
5 of 9 · 21 terms5 sur 9 · 21 termes
affiliation
amélioration clinique
angiotensine
arythmies
autonomie
concentration
congénitaux
dysfonction ventriculaire avec bloc de branche droit
groupe anatomique
hospitalisés
immunodosage
insuffisance cardiaque gauche
insuffisance cardiaque gauche avec bloc de branche gauche
intervention
multicentriques
pathologies
physiologiquement
rénale
théorie de l'autodétermination
vasculaires
étude pilote
The 111 terms found in only one of the 9 listsLes 111 termes présents dans une seule des 9 listes
adultes
amélioration clinique et échographique
analytique
Antagonistes des récepteurs AT1 de l'angiotensine II
antagonistes non-peptidiques des récepteurs de l'angiotensine
appel téléphonique
aspects
AT1
biologique
bloc
blocage du système
branche gauche
bénéfices à long terme
cas
challenges
chirurgie
Conclusion
congénitale
critique
de façon équimolaire
diurétique et natriurétique
dysfonction
dysfonction ventriculaire avec bloc de branche
développement
développement de l'insuffisance cardiaque
Effet
effets
famille
fonction ventriculaire de l'insuffisance cardiaque
fraction d'éjection
fréquence de l'insuffisance cardiaque
fréquence de l'insuffisance cardiaque à fonction systolique préservée
groupe anatomique et fonctionnel
groupe d'intervention (GI
groupes de patients
hospitalisations répétées
hospitalière
implications
incidence
incidence hospitalière de l'IC
infirmière
inhiber le système
inhibiteurs de l'enzyme
installation progressive
installation progressive de l'insuffisance cardiaque
interpréter
la circulation sanguine
La concentration plasmatique
la fonction rénale
la néphropathie diabètique
la resynchronisation
La stimulation cardiaque
La stimulation cardiaque de resynchronisation
Le dosage
le système rénine-angiotensine
les antagonistes du calcium
les inhibiteurs de l'enzyme de conversion de l'angiotensine
les récepteurs AT1 de l'angiotensine II
les syndromes coronariens aigus
Les études cliniques
limitée
long terme
modèle
modèle de l'insuffisance cardiaque
modèle de l'insuffisance cardiaque gauche avec bloc de branche gauche
mono
mono- ou multicentriques
mort
natriuretic
natriuretic peptide
par liaison
parent
patients jeunes
pistes
population de patients
post chirurgie de cardiopathie congénitale
poussée d'IC
pratique des auto-soins
première poussée
première poussée d'IC
problèmes
pronostiques
prospective
précocement
prévention de l'insuffisance rénale
prévention de l'insuffisance rénale chronique
randomisée à deux groupes
rapport homme/femme
recherches
rendu de résultat
restrictions
resynchronisation en post chirurgie de cardiopathie congénitale
récepteurs AT1 de l'angiotensine II
Rénine-Angiotensine-Aldostérone
résultat
Résultats de l'étude ETICS
soins
Somme
soutien
standardisée
systémique
sévères
traitement de l'hypertension artérielle
à deux groupes
à fonction systolique
à long terme
âge moyen
équivalentes
étude ETICS
étude prospective ETICS
évaluée
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
1.001,00
0.460,46
0.630,63
FD
1.001,00
0.330,33
0.500,50
GH
1.001,00
0.600,60
0.750,75
JD
1.001,00
0.520,52
0.690,69
JC
1.001,00
0.570,57
0.720,72
JP
1.001,00
0.430,43
0.600,60
LA
1.001,00
0.260,26
0.420,42
MI
1.001,00
0.380,38
0.550,55
VL
1.001,00
0.300,30
0.460,46
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.970,97
0.630,63
0.770,77
FD
0.960,96
0.450,45
0.610,61
GH
0.910,91
0.780,78
0.840,84
JD
0.890,89
0.660,66
0.760,76
JC
0.860,86
0.700,70
0.770,77
JP
0.960,96
0.580,58
0.720,72
LA
0.830,83
0.310,31
0.450,45
MI
0.960,96
0.520,52
0.670,67
VL
0.980,98
0.410,41
0.580,58
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.930,93
0.760,76
0.840,84
FD
0.920,92
0.550,55
0.690,69
GH
0.790,79
0.860,86
0.820,82
JD
0.770,77
0.720,72
0.740,74
JC
0.780,78
0.790,79
0.790,79
JP
0.900,90
0.680,68
0.780,78
LA
0.820,82
0.390,39
0.530,53
MI
0.870,87
0.590,59
0.700,70
VL
0.940,94
0.500,50
0.660,66
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.810,81
0.860,86
0.830,83
FD
0.810,81
0.620,62
0.700,70
GH
0.670,67
0.940,94
0.780,78
JD
0.670,67
0.820,82
0.740,74
JC
0.670,67
0.890,89
0.760,76
JP
0.810,81
0.800,80
0.810,81
LA
0.770,77
0.470,47
0.580,58
MI
0.770,77
0.680,68
0.720,72
VL
0.890,89
0.610,61
0.730,73
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.710,71
0.930,93
0.810,81
FD
0.730,73
0.690,69
0.710,71
GH
0.580,58
1.001,00
0.730,73
JD
0.590,59
0.870,87
0.700,70
JC
0.570,57
0.930,93
0.710,71
JP
0.720,72
0.880,88
0.790,79
LA
0.740,74
0.560,56
0.640,64
MI
0.670,67
0.730,73
0.700,70
VL
0.850,85
0.720,72
0.780,78
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.620,62
0.950,95
0.750,75
FD
0.660,66
0.740,74
0.700,70
GH
0.490,49
1.001,00
0.660,66
JD
0.540,54
0.940,94
0.690,69
JC
0.500,50
0.950,95
0.650,65
JP
0.650,65
0.930,93
0.770,77
LA
0.660,66
0.580,58
0.620,62
MI
0.620,62
0.790,79
0.700,70
VL
0.820,82
0.820,82
0.820,82
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.510,51
0.960,96
0.670,67
FD
0.590,59
0.810,81
0.690,69
GH
0.400,40
1.001,00
0.570,57
JD
0.450,45
0.980,98
0.620,62
JC
0.400,40
0.950,95
0.570,57
JP
0.550,55
0.960,96
0.700,70
LA
0.620,62
0.670,67
0.640,64
MI
0.540,54
0.850,85
0.660,66
VL
0.740,74
0.920,92
0.820,82
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.390,39
0.970,97
0.550,55
FD
0.500,50
0.910,91
0.650,65
GH
0.300,30
1.001,00
0.460,46
JD
0.340,34
0.980,98
0.510,51
JC
0.320,32
1.001,00
0.480,48
JP
0.410,41
0.970,97
0.580,58
LA
0.540,54
0.790,79
0.640,64
MI
0.440,44
0.910,91
0.590,59
VL
0.580,58
0.950,95
0.720,72
How many annotators marked each termCombien de personnes ont marqué chaque terme
Each annotator against the referenceChaque personne par rapport à la référence
precisionprécision
recallrappel
F1
AB
0.190,19
1.001,00
0.320,32
FD
0.260,26
1.001,00
0.420,42
GH
0.140,14
1.001,00
0.250,25
JD
0.170,17
1.001,00
0.290,29
JC
0.150,15
1.001,00
0.270,27
JP
0.200,20
1.001,00
0.340,34
LA
0.330,33
1.001,00
0.500,50
MI
0.230,23
1.001,00
0.370,37
VL
0.290,29
1.001,00
0.450,45
The 125 terms at least 5 of the 9 annotators markedLes 125 termes qu'au moins 5 des 9 personnes ont marqués
9 of 9 · 31 terms9 sur 9 · 31 termes
ANP
arythmies ventriculaires
asynchronisme
auto-soins
bêta-bloquants
cardiopathie
cardiopathies congénitales
CNP
DNP
endopeptidase
enzyme de conversion
expansion volémique
hypertension artérielle
Incidence hospitalière
insuffisance cardiaque
insuffisance rénale
maladie chronique
marqueurs pronostiques
molécules
mortalité hospitalière
NPR-C
NT-proBNP
post chirurgie
profil épidémiologique
resynchronisation
Resynchronisation cardiaque
système rénine-angiotensine
Système Rénine-Angiotensine-Aldostérone
urodilatine
vasodilatatrice
Épidémiologie
8 of 9 · 34 terms8 sur 9 · 34 termes
angiotensine II
antagonistes
autodétermination
BNP
brain natriuretic peptide
cardiomyocyte
circulation sanguine
concentration plasmatique
diurétique
dysfonction ventriculaire
dysfonction ventriculaire gauche
développement clinique
fonction ventriculaire
hypertensive
IC
inhibiteurs
ischémique
natriurétique
néphropathie diabètique
pathologies cardiaques congénitales
peptides
peptides natriurétiques
plan de traitement
pratique clinique
proBNP
pré-proBNP
récepteur de clairance
rénales
symptômes
thérapeutique
ventricule droit systémique
ventricule unique
échographique
équimolaire
7 of 9 · 21 terms7 sur 9 · 21 termes
activité biologique
B-type natriuretic peptide
centrales
clivé
diagnostic
dosage
fonction rénale
fraction d'éjection ventriculaire gauche
hospitalisation
incidence hospitalière standardisée
inhiber
intervention
intervention infirmière de soutien
marqueurs
mort subite
NPR-A
récepteur
récepteurs AT1
syndromes coronariens aigus
traitement
voie orale
6 of 9 · 20 terms6 sur 9 · 20 termes
biologiques
calcium
cliniques
clivage
congénitales
diète
GI
groupe d'intervention
insuffisance rénale chronique
intervention infirmière
non-peptidiques
patients
prise en charge
stimulation cardiaque de resynchronisation
synthétisé
TAD
techniques d'immunodosage automatisées
ventriculaire
élimination
études cliniques
5 of 9 · 19 terms5 sur 9 · 19 termes
affiliation
amélioration clinique
angiotensine
arythmies
autonomie
concentration
congénitaux
dysfonction ventriculaire avec bloc de branche droit
groupe anatomique
hospitalisés
immunodosage
insuffisance cardiaque gauche
insuffisance cardiaque gauche avec bloc de branche gauche
multicentriques
pathologies
physiologiquement
théorie de l'autodétermination
vasculaires
étude pilote
The 106 terms found in only one of the 9 listsLes 106 termes présents dans une seule des 9 listes
amélioration clinique et échographique
analytique
Antagonistes des récepteurs AT1 de l'angiotensine II
antagonistes non-peptidiques des récepteurs de l'angiotensine
appel téléphonique
aspects
AT1
bloc
blocage du système
branche gauche
bénéfices à long terme
cas
challenges
chirurgie
Conclusion
critique
de façon équimolaire
diurétique et natriurétique
dysfonction
dysfonction ventriculaire avec bloc de branche
développement
développement de l'insuffisance cardiaque
effets
famille
fonction ventriculaire de l'insuffisance cardiaque
fraction d'éjection
fréquence de l'insuffisance cardiaque
fréquence de l'insuffisance cardiaque à fonction systolique préservée
groupe anatomique et fonctionnel
groupe d'intervention (GI
groupes de patients
hospitalisations répétées
hospitalière
implications
incidence
incidence hospitalière de l'IC
infirmière
inhiber le système
inhibiteurs de l'enzyme
installation progressive
installation progressive de l'insuffisance cardiaque
interpréter
la circulation sanguine
La concentration plasmatique
la fonction rénale
la néphropathie diabètique
la resynchronisation
La stimulation cardiaque
La stimulation cardiaque de resynchronisation
Le dosage
le système rénine-angiotensine
les antagonistes du calcium
les inhibiteurs de l'enzyme de conversion de l'angiotensine
les récepteurs AT1 de l'angiotensine II
les syndromes coronariens aigus
Les études cliniques
limitée
long terme
modèle
modèle de l'insuffisance cardiaque
modèle de l'insuffisance cardiaque gauche avec bloc de branche gauche
mono
mono- ou multicentriques
mort
natriuretic
natriuretic peptide
par liaison
parent
patients jeunes
pistes
population de patients
post chirurgie de cardiopathie congénitale
poussée d'IC
pratique des auto-soins
première poussée
première poussée d'IC
problèmes
pronostiques
prospective
précocement
prévention de l'insuffisance rénale
prévention de l'insuffisance rénale chronique
randomisée à deux groupes
rapport homme/femme
recherches
rendu de résultat
restrictions
resynchronisation en post chirurgie de cardiopathie congénitale
récepteurs AT1 de l'angiotensine II
Rénine-Angiotensine-Aldostérone
Résultats de l'étude ETICS
soins
Somme
soutien
standardisée
systémique
sévères
traitement de l'hypertension artérielle
à deux groupes
à fonction systolique
à long terme
âge moyen
équivalentes
étude ETICS
étude prospective ETICS
évaluée
Scores computed on 5 October 2026 from the INCEpTION export; initials instead of names.Scores calculés le 5 octobre 2026 à partir de l'export INCEpTION ; des initiales plutôt que des noms.
Lire les graphiques
Le seuil se change dans le menu : plus il est bas, plus la référence est
longue.
Les barres comptent les termes selon le nombre de personnes qui les ont
marqués. Une longue barre à gauche : beaucoup de termes présents dans une
seule liste.
Les termes listés sont ceux qu’au moins cinq personnes ont marqués,
puis, à part, ceux qui ne figurent que dans une des neuf listes.
This page is only available in French.
🔒 Projet 1 · Step by stepProjet 1 · Pas à pasis course material (TRA6008). Open it on the site to include it here.est réservé au cours (TRA6008). Ouvrez-le sur le site pour l'inclure ici.
Projet 1 · Step by stepProjet 1 · Pas à pas
Project 1 · Step by stepProjet 1 · Pas à pas
Le projet en sept étapes
Le Projet 1 se fait en sept étapes, dans cet ordre. La première est terminée.
Étape
Qui
Pour quand
1. Annoter les dix textes
individuel
4 octobre 2026 (fait)
2. Lire les scores d’accord
individuel, puis en équipe
dès maintenant, pour la séance 6
3. Tirer une liste de TermoStat
en équipe
séance 6, 15 octobre 2026
4. Tirer une liste de l’agent conversationnel
en équipe
séance 6, 15 octobre 2026
5. Calculer les scores des deux systèmes
individuel et en équipe
séance 6, 15 octobre 2026
6. Envoyer les quatre listes et présenter
en équipe
séance 6, 15 octobre 2026
7. Rédiger les deux rapports
individuel et en équipe
25 octobre 2026, 23 h 59
Les sept étapes du Projet 1.
Le Projet 1 vaut 20 % de la note du cours, sur 100 points : 10 pour
l’annotation terminée et les deux questionnaires, 15 pour la présentation, 30
pour le rapport d’équipe et 45 pour le rapport individuel.
Où trouver chaque résultat
Tout est sur le site, sauf les dix textes en .txt, sur StudiUM. Aucun
fichier de scores ne vous est envoyé : chaque score se consulte ou se calcule
sur l’une des quatre pages ci-dessous, en choisissant la langue et la règle de
correspondance en haut de la page.
Ce que vous cherchez
Où
Ce que vous y choisissez
les dix textes, pour TermoStat, pour l’agent et pour retrouver vos segments
StudiUM, en .txt
en_01 à en_05, fr_01 à fr_05
votre F1 moyen avec les huit autres, et votre accord le plus haut et le plus bas
votre ligne : la colonne « Moyenne » et les autres cases. Le même F1 moyen se recopie sur les deux lignes de sa langue dans le tableau 3.1 du rapport individuel : il ne dépend pas du système
le F1 entre deux personnes, dont les membres de votre équipe
Où se trouve chaque élément du Projet 1, et ce que vous choisissez sur la page.
Quelle règle de correspondance utiliser
Par défaut, la règle 3, dans les deux rapports : les écarts qui restent
portent sur ce qui compte comme terme, le sujet du projet. Les trois règles
seulement aux deux questions qui les demandent : 3.2 du rapport individuel et
3.1 du rapport d’équipe.
la casse, les espaces et traits d’union, le type d’apostrophe, l’article élidé
« ProBNP » et « probnp », « l’insuffisance cardiaque » et « insuffisance cardiaque »
3 · singulier et pluriel confondus
la règle 2, plus le -s ou le -x final du pluriel
« facteur de risque » et « facteurs de risque », mais pas « principal » et « principaux »
Les trois règles de correspondance, de la plus stricte à la plus souple.
Rien d’autre n’est mis en commun : « congénital » et « congénitale », ou un
terme et sa reformulation, restent deux formes sous les trois règles.
Où l'écart entre les règles compte
Les exemples se prennent dans les listes de la règle 3. Sous la règle 1,
un candidat juste mais écrit autrement que dans la référence (« disease »
pour « diseases ») peut compter à la fois comme bruit et comme silence : vous
commenteriez une différence d’écriture au lieu d’un désaccord sur ce qu’est
un terme.
L’écart entre les règles est une information en soi. Un score qui monte
beaucoup de la règle 1 à la règle 3 veut dire qu’une partie des erreurs ne
portait que sur la forme ; un score qui ne bouge presque pas veut dire que
les écarts portent sur le choix des termes.
En comparant l’anglais et le français (question 4.2 du rapport
d’équipe), regardez aussi si l’écart entre les règles diffère d’une langue à
l’autre.
Les chiffres dans les rapports : la tendance avant le détail
Les tableaux donnent les chiffres ; votre texte dit ce qu’ils montrent
ensemble : quel système fait mieux, en anglais ou en français, plutôt en
précision ou en rappel, et où il se situe par rapport à l’accord entre vous.
La moyenne avant les cas particuliers : votre F1 moyen avec les huit
autres dit plus que chacune des huit cases ; votre accord le plus haut et le
plus bas servent de repères.
Quelques centièmes d’écart ne sont pas un résultat : avec une liste
majoritaire d’environ 120 termes, un terme de plus ou de moins déplace le
rappel de près d’un centième. Commentez un chiffre isolé seulement quand il
rompt la tendance, et dites alors pourquoi.
Les exemples font le reste : un écart qui compte s’explique avec deux ou
trois termes tirés de vos listes, pas avec d’autres chiffres.
Vous situez votre annotation par rapport à celles des huit autres personnes,
individuellement d’abord, puis en équipe. Règle 3, en anglais et en français.
Sur Comparer deux listes, terme par terme,
votre liste contre la liste majoritaire : deux termes de la majorité que vous
n’avez pas retenus, et deux de vos termes que la majorité n’a pas gardés.
Cette matière fait la section 2 du rapport individuel.
Cette matière fait la section 2 du rapport d’équipe.
3. Tirer une liste de TermoStat
En équipe, une liste par langue : les cinq fichiers .txt d’une langue, pris
sur StudiUM, en un seul passage (TermoStat accepte plusieurs fichiers). Le seuil se choisit avant
de calculer le moindre score.
Comment faire
Choisissez les catégories grammaticales à garder, et notez pourquoi.
Lancez l’extraction et téléchargez le résultat en TSV, pas en TBX : le
TSV garde la spécificité de chaque candidat.
Choisissez le seuil. Par défaut, TermoStat trie les candidats selon leur
score de spécificité, la colonne « Spec », du plus spécifique au moins
spécifique. Le seuil est une valeur de cette colonne : vous gardez les
candidats dont le score l’atteint ou la dépasse, c’est-à-dire le haut de la
liste, et vous écartez les autres. Vous pouvez aussi garder la liste
entière, sans seuil. Notez votre choix et sa raison en deux ou trois
phrases.
Sur la page de calcul, entrez cette valeur dans le champ « Seuil » : la page
applique le seuil elle-même au fichier TSV complet.
Les scores à rapporter sont ceux de la liste au seuil choisi. Essayer d’autres
seuils après coup, pour voir ce qu’ils changent, est permis. Vos réglages et
leur raison font la section 1.1 du rapport d’équipe.
4. Tirer une liste de l’agent conversationnel
En équipe, avec l’agent de votre équipe : une conversation et une liste par
langue, sur les cinq fichiers .txt de cette langue. Le but : une liste aussi proche
que possible de ce que vous ajouteriez à votre propre base terminologique.
rapport d’équipe, sections 3 et 4 ; rapport individuel, 3.1
Les deux calculs à faire, selon la référence choisie dans la page.
Dans les listes de bruit et de silence de la règle 3, relevez tout de suite des
exemples : pour chaque système, deux candidats erronés et deux termes manqués,
d’un même type, que le fonctionnement du système explique (section 4.1 du
rapport d’équipe).
6. Envoyer les listes et présenter, à la séance 6
Le 15 octobre 2026, une présentation de 15 à 20 minutes en classe. Les
diapositives ne sont pas obligatoires, mais un support visuel aide à montrer
des exemples et des scores ; le tableau de la classe peut aussi servir.
Une seule personne peut faire l’essentiel de la présentation : vous n’avez
pas à vous relayer. Chaque membre de l’équipe doit toutefois pouvoir répondre
aux questions et prendre part à la discussion, qui compte pour 4 des 15
points. Je vous suggère aussi que chacun présente brièvement ses propres choix
d’annotation, puisque c’est là que vos trois annotations divergent.
Les quatre listes de l’équipe, et vos diapositives si vous en avez, s’envoient
dans un même courriel au plus tard le 15 octobre 2026 à 23 h 59, avant ou après
la présentation.
Les quatre fichiers à envoyer
Par courriel, à ayla.rigouts.terryn@umontreal.ca,
au plus tard le 15 octobre 2026 à 23 h 59, avec le seuil de TermoStat retenu pour
chaque langue dans le corps du message :
TermoStat_[Agent]_EN.tsv et TermoStat_[Agent]_FR.tsv, tels que
téléchargés ;
Agent_[Agent]_EN.txt et Agent_[Agent]_FR.txt, un candidat par ligne.
[Agent] est le nom de l’agent de votre équipe, par exemple
TermoStat_Claude_EN.tsv. Je les ajoute au site pour que les trois équipes
comparent leurs résultats ; cette comparaison fait la section 5 du rapport
d’équipe. Les conversations avec l’agent ne sont pas partagées : à la présentation,
vous montrez ce que vous avez essayé et votre requête finale, avec des
exemples, mais la conversation entière reste à l’équipe et n’est remise qu’à
moi, avec le rapport.
Ce qui est noté dans la présentation
La présentation sert à partager votre expérience avec les autres équipes et à
en discuter avant d’écrire les rapports. Ce qui compte, ce sont des exemples
concrets et ce que vous avez vécu, pas une analyse terminée : l’analyse est
notée dans les rapports. De 15 à 20 minutes par équipe, discussion comprise.
Critère
Points
Ce qui vaut tous les points
Vos annotations
4
comment vous avez décidé, où vos trois annotations divergent, avec des exemples
Votre agent conversationnel
4
votre expérience avec lui : ce que vous avez essayé, ce qui a marché ou non, des exemples de ses réponses, et ce qu’il fait autrement que TermoStat
TermoStat, brièvement
1
vos réglages et vos scores, pour que les équipes puissent se comparer. Un seul point, parce que TermoStat est le même outil pour toutes les équipes : seuls ses réglages peuvent un peu différer
La discussion
4
des réponses claires aux questions, et de l’intérêt pour les résultats des autres équipes
Clarté et présentation
2
on comprend ce que vous avez fait, la présentation est structurée et tient dans le temps prévu
Les critères de la présentation, sur 15 points.
7. Rédiger les deux rapports
Pour le 25 octobre 2026, 23 h 59, en PDF, sur les gabarits, à déposer sur
StudiUM dans deux remises, « Projet 1 · Rapport individuel » et « Projet 1 ·
Rapport d’équipe ». Chaque membre de l’équipe dépose le même rapport d’équipe :
chacun a ainsi une remise officielle, et la note et les commentaires du rapport
d’équipe, les mêmes pour tous, vous sont transmis sur StudiUM. Chaque question
donne ses points, et chaque gabarit commence par un tableau qui dit sur quelle
page trouver chaque chiffre demandé.
Les sections des deux rapports et l'étape d'où vient leur matière.
Les agents conversationnels dans les rapports
Les agents conversationnels sont permis pour les rapports et la présentation,
comme toute autre ressource.
Ce qui est noté, c’est ce que vous avez compris et ce que vous pensez :
vos décisions, vos exemples, vos chiffres, votre position sur les cas où les
autres personnes ou les outils ne sont pas d’accord avec vous. Un agent
conversationnel n’a rien de tout cela ; un agent qui vous aide à structurer,
à reformuler ou à vérifier un calcul ne vous coûte rien.
Déclarez-le : à la fin de chaque rapport, en une ligne, quel agent vous
avez utilisé et pour quoi. Aucun usage n’a à être justifié ; un usage non
déclaré, lui, relève du règlement sur l’intégrité.
This page is only available in French.
🔒 Projet 1 · The two systems' scoresProjet 1 · Les scores des deux systèmesis course material (TRA6008). Open it on the site to include it here.est réservé au cours (TRA6008). Ouvrez-le sur le site pour l'inclure ici.
Projet 1 · The two systems' scoresProjet 1 · Les scores des deux systèmes
Scoring TermoStat and the chatbotCalculer les scores de TermoStat et de l'agent
Ce qu’il vous faut
Pour chaque langue, les deux listes de l’équipe, une par système :
le fichier TSV de TermoStat, tel que téléchargé. Exportez le TSV plutôt
que le TBX : le TSV garde la spécificité de chaque candidat, ce qui permet
d’appliquer votre seuil ici, alors que le TBX ne garde que les formes ;
Correct candidates and terms found can differ for TermoStat: one of its lines can match several forms of the reference.Pour TermoStat, les candidats corrects et les termes trouvés peuvent différer : une même ligne peut correspondre à plusieurs formes de la référence.
Les scores sont donnés selon les trois règles de correspondance, celles
du calcul de l’accord (see also the Project 1 · Step by step page) (voir aussi la page Projet 1 · Pas à pas).
Rien n’est envoyé : les fichiers sont lus par votre navigateur et
restent sur votre ordinateur.
This page is only available in French.
🔒 Projet 2 · Machine translationProjet 2 · Traduction automatiqueis course material (TRA6008). Open it on the site to include it here.est réservé au cours (TRA6008). Ouvrez-le sur le site pour l'inclure ici.
Projet 2 · Machine translationProjet 2 · Traduction automatique
Project 2 · OverviewProjet 2 · Aperçu
Le projet en bref
Le Projet 2 compare trois façons de faire traduire un même texte de l’anglais
vers le français :
avec l’agent : vous traduisez vous-même en travaillant avec un agent
conversationnel, de la préparation à la version finale ;
Les trois suivent le même mandat de traduction (public, français du Canada,
terminologie), mais ne le reçoivent pas de la même façon : DeepL ne le reçoit pas, la
requête unique le contient en entier, et avec l’agent, c’est vous qui veillez
à ce qu’il soit suivi. Un écart au mandat compte comme une erreur dans les
évaluations qui s’appuient sur lui, quelle que soit la traduction.
Ces traductions sont ensuite évaluées de quatre façons :
votre annotation de leurs erreurs, avec la grille MQM ;
le juge : un agent conversationnel à qui l’on demande de les juger ;
chrF, une métrique automatique de surface ;
COMET, une métrique automatique apprise à partir de jugements humains.
chrF et COMET comparent chaque traduction à une traduction humaine faite par
une autre équipe, la référence.
Le projet se fait en trois équipes de trois, chacune avec son agent :
Claude, ChatGPT ou Gemini.
La comparaison des quatre évaluations est le cœur du projet : un texte n’a
pas une seule bonne traduction, et les quatre évaluations ne classent pas
toujours les traductions de la même manière.
La Figure 1figure 1 résume le travail du projet et, pour chaque
partie, où trouver de l’aide.
Figure 1. Le travail du projet. La traduction de référence se fait sur le texte que vous traduisez à la main, tout le reste sur votre texte de travail.
Le Projet 2 vaut 30 % de la note du cours. Il est noté sur 100 points :
Ce qui est noté
Points
Qui
le processus : votre part dans le travail en classe (la rédaction des deux requêtes, la référence en équipe) et le travail fait (vos deux traductions, votre annotation, vos conversations avec le juge), notés sur l’engagement et non sur la qualité
10
chaque personne
la présentation
15
l’équipe
le rapport d’équipe
30
l’équipe
le rapport individuel
45
chaque personne
La note du Projet 2.
Les gabarits indiquent les points de chaque question.
Votre équipe et vos textes
Choisissez votre équipe : la page indique vos deux textes, et la page
d’annotation s’en souviendra.
You translate text 1 by hand. Your working text is text 2; its reference comes from the ChatGPT team.Vous traduisez à la main le texte 1. Votre texte de travail est le texte 2 ; sa référence vient de l'équipe ChatGPT.
You translate text 2 by hand. Your working text is text 3; its reference comes from the Gemini team.Vous traduisez à la main le texte 2. Votre texte de travail est le texte 3 ; sa référence vient de l'équipe Gemini.
You translate text 3 by hand. Your working text is text 1; its reference comes from the Claude team.Vous traduisez à la main le texte 3. Votre texte de travail est le texte 1 ; sa référence vient de l'équipe Claude.
TeamÉquipe
Translates by handTraduit à la main
Working textTexte de travail
Its reference comes fromSa référence vient de
Claude teaml'équipe Claude
text 1le texte 1
text 2le texte 2
the ChatGPT teaml'équipe ChatGPT
ChatGPT teaml'équipe ChatGPT
text 2le texte 2
text 3le texte 3
the Gemini teaml'équipe Gemini
Gemini teaml'équipe Gemini
text 3le texte 3
text 1le texte 1
the Claude teaml'équipe Claude
The rotation of the three teams over the three texts.La rotation des trois équipes sur les trois textes.
La composition des équipes et l’agent de chacune sont annoncés sur StudiUM ;
l’attribution des agents change d’un projet à l’autre.
Chaque équipe travaille sur deux textes, celui qu’elle traduit à la main
et son texte de travail, pour deux raisons :
Vos deux traductions restent indépendantes. Si vous traduisiez le même
texte à la main puis avec l’agent, la seconde traduction reprendrait vos
solutions de la première, et ne montrerait plus ce que donne le travail avec
l’agent.
La référence ne favorise aucune de vos traductions. chrF et COMET
mesurent la ressemblance avec la référence. Faite par une autre équipe, qui
n’a pas travaillé sur ce texte avec un agent, la référence ne ressemble pas
d’avance à vos traductions.
L’ordre est fixe. Sur le texte de travail, les trois traductions avec
l’agent viennent en premier, puis la requête unique, puis DeepL : une
traduction lue avant de traduire influence la vôtre.
Le projet semaine par semaine
Quand
Chaque personne
L’équipe
Toute la classe
entre les séances 6 et 7, pour le 29 octobre 2026
lire la théorie sur la traduction automatique (1)
séance 7, 29 octobre 2026
traduire à la main le texte indiqué pour votre équipe ; traduire le texte de travail avec l’agent (2)
rédiger la requête unique (2)
entre les séances 7 et 8, pour le 5 novembre 2026
finir les traductions ; vérifier vos fichiers ; lire la théorie sur l’évaluation (2, 3)
lancer la requête unique et DeepL ; s’accorder sur la référence et me l’envoyer au plus tard au début de la séance 8 (2)
séance 8, 5 novembre 2026
annoter votre traduction avec l’agent, la requête unique et DeepL ; premier jugement des deux traductions que vous faites juger (4)
chrF et COMET dans MATEO (4)
rédiger la requête du juge (4)
entre les séances 8 et 9, pour le 12 novembre 2026
finir l’annotation ; les quatre autres jugements (4)
comparer les annotations et les jugements ; rassembler les quatre classements ; préparer la présentation (5, 6)
séance 9, 12 novembre 2026
présenter (6)
20 novembre 2026, 23 h 59
le rapport individuel, avec vos deux traductions et le fichier exporté de votre annotation (7)
le rapport d’équipe (7)
Qui fait quoi, et quand. Les numéros renvoient aux étapes de la page Pas à pas.
Échéance · Listes de TermoStat et de l'agent, par équipe (par courriel, au plus tard à 23 h 59, avec les diapositives s'il y en a)
Pas de cours (période d'activités libres)
Évaluation · Rapports du Projet 1 (23 h 59, sur StudiUM)
Séance 7 · Projet 2 : vos questions sur les lectures, rédaction commune de la requête unique, traduction à la main, traduction avec l'agent
Échéance · Module sur la traduction automatique (à lire avant la séance)
Évaluation · Parcours sur Sketch Engine (23 h 59)
Séance 8 · Projet 2 : vos questions sur les lectures, annotation des erreurs, rédaction commune de la requête du juge, jugement par l'agent, chrF et COMET dans MATEO
Échéance · Lectures sur l'évaluation de la traduction automatique (avant la séance)
Échéance · Projet 2 : référence de l'équipe (par courriel, au plus tard au début de la séance)
Séance 9, évaluation · Présentations du Projet 2 ; lancement du Projet 3
Échéance · Projet 2 : diapositives de l'équipe (par courriel, au plus tard à 23 h 59 ; partagées avec toute la classe sur StudiUM)
Pas de cours (colloque à Ottawa). À faire cette semaine-là : choisir en équipe la question du Projet 3 et m'envoyer une proposition d'étude pour le dimanche 22 novembre 2026
Évaluation · Rapports du Projet 2 (23 h 59)
Échéance · Proposition d'étude du Projet 3 (23 h 59)
14 séance
28 évaluation
30 autre échéance
5 jeudi sans cours
Les traductions et leurs évaluations
Traduction
Annotation MQM
Juge, trois fois
chrF et COMET, contre la référence
les trois traductions avec l’agent, une par membre
par son auteur
oui
oui
la requête unique
par chaque membre
oui
oui
DeepL
par chaque membre
oui
oui
la référence
oui
elle sert de point de comparaison
Quelle traduction de votre texte de travail passe par quelle évaluation.
Ce que vous remettez
Les remises finales se font sur StudiUM ; les remises intermédiaires, par
courriel, à
ayla.rigouts.terryn@umontreal.ca.
Vos conversations avec l’agent et vos scores ne se remettent pas à part : ils vont dans les rapports. Un lien de partage qui ne fonctionne pas,
ou un agent qui ne permet pas le partage, se remplace par une copie de la
conversation, ajoutée à la remise du rapport où le lien figure.
Quoi
Qui
Où
Quand
la référence de l’équipe
l’équipe
courriel
au début de la séance 8, le 5 novembre 2026
les diapositives
l’équipe
courriel
12 novembre 2026, 23 h 59
le rapport individuel, avec vos deux traductions (.txt) et le fichier exporté de votre annotation (.json)
chaque personne
StudiUM
20 novembre 2026, 23 h 59
le rapport d’équipe
chaque membre, le même fichier
StudiUM
20 novembre 2026, 23 h 59
Ce que vous me remettez, par qui, où et quand.
This page is only available in French.
Project 2 · Step by stepProjet 2 · Pas à pas
1. Lire la théorie sur la traduction automatique, pour la séance 7
chaque personne traduit à la main le texte que
l’aperçu indique pour son
équipe (texte 1 pour l’équipe Claude, par exemple) ;
chaque personne traduit le texte de travail avec l’agent de l’équipe.
Puis, en équipe, en classe s’il reste du temps, sinon pour la séance 8 :
lancer la requête unique et DeepL sur le texte de travail, une fois les
trois traductions avec l’agent terminées ;
s’accorder sur une seule version du texte traduit à la main, la référence,
et me l’envoyer au plus tard au début de la séance 8.
L’ordre des traductions du texte de travail est fixe : d’abord les trois
traductions avec l’agent, puis la requête unique, puis DeepL, jamais
l’inverse. Une traduction lue avant de traduire influence la vôtre, et les
trois traductions avec l’agent doivent être terminées quand la requête unique
est lancée.
Le mandat de traduction
Toutes les traductions du projet suivent ce mandat, les traductions à la main
et la référence comprises. Il s’applique aussi à l’annotation : un terme qui
s’écarte de la liste imposée est un terme inadapté, un format de nombre qui
s’écarte des conventions une erreur de format, une espace ou un guillemet fautif une erreur
de ponctuation. Le texte ci-dessous se copie tel quel
dans la requête unique.
MANDAT DE TRADUCTIONTexte à traduire : le résumé d'un article scientifique sur la traductionautomatique, en anglais.Destination : la page « Recherche récente » du site d'un centre universitairede traduction au Québec. Lectorat : traducteurs, terminologues, réviseurs etétudiants en traduction, francophones, qui ne lisent pas la littératurespécialisée en anglais mais connaissent les outils de traduction.Langue : français du Canada. Registre neutre et soutenu, comme dansl'original ; la première personne du pluriel de l'original est conservée.Terminologie : les termes attestés, dans cet ordre de priorité : TERMIUM Plus,puis le Grand dictionnaire terminologique de l'OQLF, puis DataFranca.Termes imposés :- machine translation (MT) : traduction automatique (TA)- large language model (LLM) : grand modèle de langue (GML)- benchmark : test de performances- test set : jeu de données de test- prompt : requête- shared task : tâche partagéeUn terme technique dont l'équivalent français est peu répandu est donné enfrançais, suivi du terme anglais entre parenthèses à sa première occurrence,par exemple « apprentissage en contexte (in-context learning) ». Les noms desystèmes, de produits, de jeux de données et de conférences restent telsquels (Google Translate, WMT).Sigles : développés en français à la première occurrence, le sigle françaisentre parenthèses ; ensuite le sigle seul. Un sigle qui est un nom (WMT)reste tel quel.Format : virgule décimale ; les nombres restent en chiffres, comme dansl'original.Ponctuation : espace insécable entre un nombre et le signe % ; guillemetsfrançais « ».Fidélité : rien d'ajouté, rien d'omis ; une phrase par ligne, dans le mêmeordre que l'original.
Les trois textes et le texte d'essai
Quatre résumés d’articles sur la traduction automatique, publiés dans
l’ACL Anthology sous licence CC BY 4.0. Les trois textes ont été choisis
dans les mêmes actes, ceux de WMT 2025, pour leur longueur, leur sujet et
leur difficulté comparables : environ 160 mots en sept phrases chacun. Le
choix ne dit rien de la qualité des articles.
Texte d’essai : Stanovsky et al. (2019), Evaluating Gender Bias in Machine Translation, Proceedings of the 57th Annual Meeting of the Association for Computational Linguistics, p. 1679–1684.
Traduire avec l'agent
Des conseils, non des exigences : ce qui est noté est dit à la question 1.2
du rapport individuel.
Une conversation que vous menez. La requête unique montre ce que l’agent
produit seul ; ici, c’est vous qui menez la traduction, en allers-retours
jusqu’à une version qui vous satisfait. Il n’y a pas de nombre minimal de
tours : si la traduction vous satisfait vite, une conversation courte
suffit, et elle n’est pas pénalisée. Ce qui est noté est ce que vous avez
demandé et vérifié, pas le nombre de tours.
Ne demandez pas tout le texte traduit dès le premier message. Travaillez
par étapes : la préparation (lire le texte, repérer les difficultés,
chercher la terminologie avec des sources), un premier jet, puis la
révision.
Donnez le mandat dès le premier message, en entier : le public, le
français du Canada, les termes imposés, les conventions. Sans lui, l’agent
part dans une mauvaise direction et vous perdez des tours à le corriger.
Faites des demandes ciblées, un terme, une phrase, un passage :
« remplace partout ce terme par celui-ci », « cette phrase suit trop
l’anglais », « prends le terme de TERMIUM ».
Demandez les sources dès le début, jamais après coup : demandées après,
elles risquent d’être inventées.
Le mandat est le vôtre à faire respecter : vérifiez chaque terme
imposé et chaque convention dans la version finale, l’agent ne le fera pas
pour vous.
Si l’agent refuse, s’interrompt ou atteint une limite d’usage, reprenez
dans une nouvelle conversation et notez-le ; un refus qui persiste est un
résultat, à signaler dans le rapport.
La version finale n’a pas à venir de l’agent. Quand il devient plus
rapide de corriger vous-même, faites-le. Une fonction de document partagé,
comme le canevas de certains agents, peut aider.
La conversation est notée (rapport individuel, question 1.2), la qualité de
la traduction obtenue ne l’est pas.
La requête unique
Une seule requête pour tout le groupe, rédigée ensemble à partir d’une
requête de départ et du mandat de traduction, qu’elle contient en entier, et
essayée sur le texte d’essai : les traductions faites
avec elle ne diffèrent donc que par l’agent. Chaque équipe la lance une seule
fois sur son texte de travail, dans une nouvelle conversation, sans rien
ajouter ni corriger ensuite. Notez le modèle exact, la date et le niveau
de raisonnement.
Le point de départ, à améliorer ensemble en classe :
Traduis le texte ci-dessous de l'anglais vers le français du Canada. C'est le résumé d'un article scientifique sur la traduction automatique, destiné à la page « Recherche récente » du site d'un centre universitaire de traduction au Québec, lue par des traducteurs, des terminologues, des réviseurs et des étudiants en traduction francophones qui ne lisent pas la littérature spécialisée en anglais mais connaissent les outils de traduction, dans un registre neutre et soutenu comme l'original, en gardant la première personne du pluriel, avec les termes attestés par TERMIUM Plus, sinon par le Grand dictionnaire terminologique de l'OQLF, sinon par DataFranca, et en traduisant machine translation (MT) par traduction automatique (TA), large language model (LLM) par grand modèle de langue (GML), benchmark par test de performances, test set par jeu de données de test, prompt par requête et shared task par tâche partagée, un terme technique dont l'équivalent français est peu répandu étant donné en français suivi du terme anglais entre parenthèses à sa première occurrence, les noms de systèmes, de produits, de jeux de données et de conférences restant tels quels, les sigles étant développés en français à la première occurrence avec le sigle français entre parenthèses puis le sigle seul, avec la virgule décimale, une espace insécable entre un nombre et le signe %, les guillemets français et les nombres en chiffres comme dans l'original, sans rien ajouter ni omettre, une phrase par ligne dans le même ordre que l'original, et sans aucun commentaire, seulement la traduction.[le texte, une phrase par ligne]
S'accorder sur la référence
Comparez les trois traductions à la main phrase par phrase et décidez
d’une seule version. Gardez une trace de chaque désaccord : les solutions
proposées, celle que l’équipe retient, et pourquoi. Le rapport d’équipe
demande ce tableau.
Gardez la référence dans l’équipe. L’équipe qui l’utilise ne doit pas
la voir avant d’avoir terminé son annotation.
Envoyez-la-moi par courriel au plus tard au début de la séance 8, le
5 novembre 2026, en .txt, une phrase par ligne, avec le même découpage que le
texte source. Je l’ajoute à cette page, que seuls les étudiants du cours
peuvent ouvrir, pour qu’elle soit plus facile à manipuler sur le site, par
exemple à charger dans l’outil de la page « Annoter les erreurs » ;
si votre équipe n’est pas d’accord, dites-le-moi en me l’envoyant. Vous la
collerez aussi dans le rapport d’équipe. Si une
référence manque, l’équipe qui l’attend calcule chrF et COMET à la maison
dès qu’elle arrive ; le retard est celui de l’équipe qui la devait.
La traduction de DeepL
Un membre de l’équipe la fait, une seule fois. Pour que les traductions de
DeepL des trois équipes se comparent :
la version gratuite, sur deepl.com,
avec les réglages par défaut : le français comme langue d’arrivée, sans
glossaire ni choix de registre ;
le texte de travail collé en entier, une phrase par ligne : DeepL garde
en général les sauts de ligne ; vérifiez le nombre de lignes comme pour
les autres fichiers ;
sans le mandat de traduction, par choix : DeepL est le point de
comparaison sans consigne, et ses écarts au mandat comptent comme ceux des
autres traductions ;
une seule traduction, gardée telle quelle, sans retouche ;
Nommez chaque fichier par le texte, la façon de traduire et, pour une
traduction personnelle, vos initiales, sans espace ni accent.
Pour la personne AB de l’équipe Claude, qui traduit le texte 1 à la main et
travaille sur le texte 2 :
texte1_a-la-main_AB.txt et texte2_avec-agent_AB.txt ;
texte1_reference.txt pour la référence de l’équipe, qui porte sur le texte
traduit à la main ;
texte2_requete-unique.txt pour la requête unique ;
texte2_deepl.txt pour la traduction de DeepL.
Vérifiez vos fichiers dès qu’ils sont prêts en chargeant le texte source,
votre traduction avec l’agent, la requête unique et DeepL sur
Projet 2 · Annoter les erreurs :
la page dit lequel n’a pas le bon nombre de lignes ou contient une ligne vide.
Un fichier décalé d’une phrase qui a pourtant le bon nombre de lignes passe ces
vérifications, et celles de MATEO : relisez le début et la fin de chaque
fichier en face de la source.
3. Lire la théorie sur l’évaluation, pour la séance 8
Si vous le pouvez, faites une fois l’essai décrit sur la page
MATEO, avec un court texte que vous avez
traduit vous-même : à la séance 8, vous lancerez MATEO sur les fichiers du projet sans
avoir à découvrir l’outil.
4. Évaluer, à la séance 8
À la séance 8, après vos questions sur les lectures : chaque personne
annote les erreurs, toute la classe rédige la requête du juge (votre part
dans ce travail compte dans la note du processus), puis
chaque équipe fait juger ses traductions et calcule chrF et COMET dans
MATEO. Ce qui n’est pas fini en classe se termine pour la séance 9.
Trois traductions : la vôtre avec l’agent, celle de la requête unique
et celle de DeepL. Les deux dernières sont les mêmes pour toute l’équipe.
Annoter sa propre traduction n’est pas ce que prévoit MQM, où
l’annotateur n’a pas fait la traduction : signalez-le dans votre rapport.
La grille, les règles d’annotation et le fonctionnement de l’outil sont
sur la page.
Exportez votre travail à la fin de la séance, et gardez le fichier : il
sert à comparer en équipe (étape 5) et il se remet avec le rapport
individuel (étape 7).
La requête du juge
Rédigée ensemble à la séance 8, à partir de la grille d’annotation et du
mandat : les mêmes catégories, les mêmes règles, les mêmes gravités et le même
mandat, pour que le jugement de l’agent et le vôtre se comparent. La gravité neutre n’y figure pas : une
préférence ne compte pas dans le score. L’agent juge une traduction par
requête, sans référence et sans savoir qui l’a faite, et donne un résultat de
forme fixe : ses erreurs, puis leur nombre par gravité.
Le point de départ, à améliorer ensemble en classe :
You are an impartial evaluator of English-to-French (Canada) translations.You annotate errors with the MQM typology of Freitag et al. (2021).# Input- SOURCE: an English scientific abstract, one numbered sentence per line.- TRANSLATION: its French translation, with the same numbering.No reference translation is given.# TaskIdentify the errors in the translation, judged against the source andagainst the norms of Canadian French, reading the translation as a wholetext. Do not rewrite or correct the translation. A wording that is correctbut that you would phrase differently is not an error.# Translation brief (applies to every translation)Target: Canadian French, neutral formal register, for a web page read byfrancophone language professionals.Required terms: machine translation = traduction automatique (TA); largelanguage model = grand modèle de langue (GML); benchmark = test deperformances; test set = jeu de données de test; prompt = requête; sharedtask = tâche partagée. Any other term follows TERMIUM Plus, then the OQLF,then DataFranca.Format: decimal comma; numbers as digits, as in the source. Punctuation: ano-break space before %; French quotation marks « ». Acronyms expanded inFrench at first mention, except names such as WMT; names of systems,products, datasets and conferences unchanged.A term that departs from the required list is Terminology/Inappropriate. Anumber format that departs from the conventions is Locale convention/Format;a spacing or quotation-mark fault is Fluency/Punctuation. AFrench term followed by the English term in brackets at its firstoccurrence is not an error.# Categories (category/subcategory)- Accuracy/Addition: information not present in the source- Accuracy/Omission: content of the source missing from the translation- Accuracy/Mistranslation: the translation does not accurately represent the source- Accuracy/Untranslated: source text left in English- Fluency/Punctuation: incorrect punctuation, French spacing and quotation marks included- Fluency/Spelling: incorrect spelling or capitalization- Fluency/Grammar: problems with grammar, other than spelling- Fluency/Register: wrong grammatical register- Fluency/Inconsistency: internal inconsistency, not related to terminology- Terminology/Inappropriate: a term that is non-standard or does not fit the field- Terminology/Inconsistent: the same term translated in different ways- Style/Awkward: awkward or calqued phrasing- Locale convention/Format: wrong format for numbers, dates, units or names- Other: any other issue- Source error: an error in the English text itself; it does not count against the translation# Rules- Mark each error separately: two mistranslated words are two errors.- If one passage has several problems, mark only the most severe; if they are equally severe, the category listed first.- At most five errors per sentence: keep the five most severe.# Severities- major: seriously affects the understandability, reliability or usability of the text; the reader is misled or cannot follow- minor: a real imperfection that does not prevent the reader from understanding or relying on the text# OutputOne line per error, in this format:sentence number | category/subcategory | severity | words in error | explanation in French, one sentenceThen the totals, on three lines:major: nminor: nof which minor punctuation: nIf there is no error, write "No errors" and totals of 0.# Example of the expected output (for another text)2 | Accuracy/Omission | major | professional | Le mot « professional » n'est pas traduit.4 | Fluency/Punctuation | minor | modéré: | Il manque l'espace avant le deux-points.major: 1minor: 1of which minor punctuation: 1# SOURCE[the source text, one numbered sentence per line]# TRANSLATION[the translation, with the same numbering]
Faire juger les traductions par l'agent
Trois jugements par traduction, chacun dans une nouvelle conversation,
avec la requête du juge et l’agent de votre équipe. Six traductions sont
jugées : vos trois traductions avec l’agent, celle de la requête unique, celle
de DeepL et la référence.
Chacun fait juger sa traduction avec l’agent et une des trois traductions
communes :
répartissez la requête unique, DeepL et la référence entre vous. Cela fait
six conversations par personne.
Les premiers jugements à la séance 8, les deux autres pour la séance 9.
Le premier sert à comparer le juge à votre annotation ; les trois ensemble
montrent si le juge est constant.
La page Projet 2 · Annoter les erreurs,
partie « 3 · Le juge », prépare chaque requête et lit chaque réponse : un
bouton copie la source et la traduction numérotées, à coller dans la
requête, et la réponse du juge se colle telle quelle dans sa case. Pour la
référence, chargez-la d’abord sur la page, une fois votre annotation
terminée.
Si la réponse ne suit pas le format, demandez dans la même conversation
les mêmes erreurs dans le format demandé, sans redemander de jugement : une
nouvelle demande donnerait un autre jugement. Une réponse impossible à remettre
au format est elle aussi un résultat sur le juge : notez-la.
Si l’agent refuse ou s’interrompt, recommencez dans une nouvelle
conversation ; une limite d’usage atteinte se contourne en répartissant les
jugements autrement dans l’équipe, ou en attendant.
Gardez le lien de chaque conversation de jugement pour le rapport
d’équipe (tableau 3.1).
La référence de votre texte de travail : à ouvrir une fois votre annotation terminée
Les trois références sont ajoutées ici au début de la séance 8 ; seule celle
de votre texte de travail vous sert. N’ouvrez la référence de votre texte
de travail qu’une fois votre annotation terminée : avec la référence en
tête, on annote ce qui en diffère plutôt que ce qui est faux.
chrF et COMET dans MATEO
En équipe, une seule fois : les cinq traductions de votre texte de travail
(les trois traductions avec l’agent, la requête unique et DeepL), comparées à
la référence de ce texte, avec deux métriques :
chrF, une métrique de surface, qui compte les suites de caractères
communes ;
COMET, une métrique qui compare le sens, apprise à partir de jugements
humains.
La page MATEO décrit l’outil en détail.
Sur MATEO, page « Evaluate » :
Les métriques, sous « Metric selection » : gardez chrF et COMET,
décochez BLEU, et gardez les options proposées par défaut.
Les fichiers, sous « Input data » : indiquez d’abord le nombre de
traductions (« How many systems do you wish to compare? »), puis déposez
la référence dans « Reference file », le texte source dans « Source file »
(COMET en a besoin) et chaque traduction dans sa case « System ». MATEO
accepte au plus quatre traductions à la fois : faites un premier calcul
avec les trois traductions avec l’agent et la requête unique, puis un
second avec DeepL. Le score d’une traduction ne dépend pas des autres
traductions calculées avec elle.
Les scores du texte entier, sous « Evaluation results (corpus) » :
téléchargez le tableau. Les intervalles de confiance et les valeurs p ne
sont pas demandés.
Les scores phrase par phrase, sous « Evaluation results
(sentences) » : MATEO ne les donne que pour COMET. Téléchargez-les aussi :
ils servent à trouver les phrases où COMET et votre annotation ne sont pas
d’accord.
Comparez les traductions à l’intérieur d’une même métrique, jamais un
score de chrF à un score de COMET : leurs échelles sont différentes.
5. Comparer, pour la séance 9
En équipe, sur Projet 2 · Annoter les erreurs,
chacun ajoute les fichiers exportés des deux autres, échangés entre vous par
courriel ou autrement. La page donne alors :
les scores de chaque traduction : votre annotation, et les trois
jugements de l’agent avec leur moyenne ;
les erreurs par catégorie, pour chaque membre et chaque jugement ;
les phrases où vous divergez, vous et le juge compris.
Avec les scores de MATEO, vous avez alors les quatre classements des cinq
traductions avec et sans l’agent : l’annotation (celle de l’auteur pour une
traduction avec l’agent, la moyenne de l’équipe pour la requête unique et
DeepL), le juge (la moyenne de ses trois jugements), chrF et COMET. Ces quatre
classements nourrissent la présentation et sont au cœur des rapports.
Regardez les écarts autant que les rangs. Sur un texte de sept
phrases, une seule erreur peut faire passer une traduction de la première à la
dernière place : avant de conclure que deux évaluations divergent, regardez de
combien les traductions diffèrent dans chacune, et dans quelles phrases.
6. Présenter, à la séance 9
Le 12 novembre 2026, de 15 à 20 minutes par équipe, discussion comprise.
Les diapositives sont obligatoires, et je les partage avec toute la classe
sur StudiUM : c’est par elles que chaque équipe a les résultats des deux
autres pour son rapport. Elles contiennent au moins le tableau des quatre
évaluations des cinq traductions, avec les scores et les rangs (le tableau 5.1
du rapport d’équipe). Envoyez-les-moi par courriel au plus tard le 12 novembre 2026
à 23 h 59.
Une seule personne peut faire l’essentiel de la présentation : vous n’avez
pas à vous relayer. Chaque membre de l’équipe doit toutefois pouvoir répondre
aux questions et prendre part à la discussion. Je vous suggère aussi que
chacun présente brièvement ses propres annotations d’erreurs : c’est là que
vos jugements diffèrent le plus d’une personne à l’autre.
L’équipe qui a fait la référence de votre texte de travail est dans la salle :
vous pouvez lui demander pourquoi elle a fait ses choix, et elle peut les
défendre.
Ce qui est noté dans la présentation
La présentation sert à partager votre expérience avec les autres équipes et à
en discuter avant d’écrire les rapports. Ce qui compte, ce sont des exemples
concrets et ce que vous avez vécu, pas une analyse terminée : l’analyse est
notée dans les rapports.
Critère
Points
Ce qui vaut tous les points
Vos annotations d’erreurs
4
les erreurs que vous avez trouvées dans les traductions de votre texte de travail, avec des exemples, et où vos annotations divergent
Votre agent conversationnel
4
votre façon de traduire avec lui, ce qui a marché ou non, des exemples, ce qu’il fait autrement que la requête unique et DeepL, et son jugement comme juge comparé au vôtre
DeepL et les scores, brièvement
1
le tableau des quatre évaluations des cinq traductions, pour que les équipes puissent se comparer. Un seul point, parce que DeepL est le même outil pour toutes les équipes et que les scores sont calculés par l’outil d’annotation et MATEO
La discussion
4
des réponses claires aux questions, sur votre référence aussi, et de l’intérêt pour les résultats des autres équipes
Clarté et présentation
2
on comprend ce que vous avez fait, la présentation est structurée et tient dans le temps prévu
Les critères de la présentation, sur 15 points.
7. Rédiger les deux rapports, pour le 20 novembre 2026
Pour le 20 novembre 2026, 23 h 59, sur StudiUM, en PDF sur les gabarits, dans
deux remises : « Projet 2 · Rapport individuel », où vous joignez aussi vos
deux traductions (.txt) et votre dernier fichier exporté de l’annotation
(.json), avec tous vos jugements, et « Projet 2 · Rapport d’équipe », où chaque membre dépose le même rapport.
Chaque gabarit indique où trouver chaque chiffre, les repères de lecture des
scores et les points de chaque question.
Les agents conversationnels dans les rapports
Les agents conversationnels sont permis pour les rapports et la présentation,
comme toute autre ressource : un agent qui vous aide à structurer, à
reformuler ou à vérifier un calcul ne vous coûte rien, puisque ce qui est
noté, c’est votre raisonnement. Déclarez-le brièvement à la fin de chaque
rapport : quel agent, et pour quoi. Un usage non déclaré relève du règlement
sur l’intégrité.
This page is only available in French.
Project 2 · Annotating the errorsProjet 2 · Annoter les erreurs
La grille
La grille est celle de MQM dans la version de Freitag et al. (2021), que WMT
emploie encore pour ses annotations MQM, réduite à ce qu’un résumé
scientifique traduit de l’anglais vers le français peut contenir. Depuis 2024,
WMT évalue la plupart de ses paires de langues avec ESA, un protocole plus
rapide qui garde les erreurs et leur gravité mais pas leur catégorie ; MQM est
le cadre sur lequel ESA est construit (Kocmi et al., 2025) (see also the Human evaluation: DA, MQM and ESA page, in the Evaluating language technology module) (voir aussi la page L'évaluation humaine : DA, MQM et ESA, dans le module L'évaluation des technologies langagières).
Pour chaque erreur, vous choisissez une sous-catégorie, qui donne sa
catégorie, puis une gravité.
CategoryCatégorie
SubcategorySous-catégorie
What it coversCe qu'elle couvre
AccuracyExactitude
AdditionAjout
the translation includes information not present in the sourcela traduction contient une information absente de la source
OmissionOmission
the translation is missing content from the sourceil manque à la traduction une partie du contenu de la source
MistranslationErreur de sens
the translation does not accurately represent the sourcela traduction ne rend pas fidèlement la source : faux sens, contresens, non-sens
Untranslated textPassage non traduit
source text has been left untranslatedun passage de la source est resté en anglais
FluencyFluidité
PunctuationPonctuation
incorrect punctuation for the locale or the style, spacing and quotation marks includedponctuation incorrecte, y compris les espaces et les guillemets du français
SpellingOrthographe
incorrect spelling or capitalizationorthographe ou majuscules incorrectes
GrammarGrammaire
problems with grammar, other than spellingaccords, conjugaison, construction de la phrase
RegisterRegistre
wrong grammatical register, for instance inappropriately informal pronounsregistre grammatical inapproprié, par exemple un tutoiement
InconsistencyIncohérence
internal inconsistency, not related to terminologyincohérence interne qui ne porte pas sur un terme
TerminologyTerminologie
Inappropriate for contextTerme inadapté
terminology is non-standard or does not fit the contextterme non standard ou qui ne convient pas au domaine
Inconsistent useTerme incohérent
terminology is used inconsistentlyun même terme est traduit de plusieurs façons
StyleStyle
AwkwardMaladresse
the translation has stylistic problemstournure lourde, peu naturelle ou calquée sur l'anglais
Locale conventionConventions locales
FormatFormat
wrong format for numbers, dates, units or namesformat des nombres, des dates, des unités ou des noms
OtherAutre
OtherAutre
any other issue, explained in the notetout autre problème, expliqué dans la note
Source errorErreur dans la source
Source errorErreur dans la source
an error in the English text; it does not count against the translationune erreur du texte anglais ; elle ne compte pas contre la traduction
The error categories, after Freitag et al. (2021).Les catégories d'erreurs, d'après Freitag et al. (2021).
SeverityGravité
When to use itQuand l'employer
WeightPoids
majormajeure
seriously affects the understandability, reliability or usability of the text: the reader is misled or cannot follownuit sérieusement à la compréhension, à la fiabilité ou à l'utilité du texte : le lecteur est induit en erreur ou ne comprend pas
5
minormineure
a real imperfection that does not prevent the reader from understanding or relying on the textune imperfection réelle, qui n'empêche pas de comprendre ni de se fier au texte
1 (0.1 for punctuation)1 (0,1 pour la ponctuation)
neutralneutre
a preference: the translation is correct, but you would have phrased it differentlyune préférence : la traduction est correcte, mais vous l'auriez formulée autrement
0
The severities and their weights, after Freitag et al. (2021). A source error weighs nothing.Les gravités et leurs poids, d'après Freitag et al. (2021). Une erreur dans la source ne pèse rien.
La gravité neutre sert à noter une préférence sans la compter comme une
erreur : elle ne pèse rien dans le score, mais elle reste dans votre
annotation, et vous pouvez en parler dans vos rapports.
Les règles d’annotation
D’après les consignes d’annotation de Freitag et al. (2021) :
Le texte source, le mandat de traduction et la traduction. Ni la
référence, ni une autre traduction du même texte : MQM juge une traduction par rapport à
sa source, et une traduction sous les yeux fait relever ce qui en diffère
plutôt que ce qui est faux. L’outil montre donc une seule traduction à la
fois. Les dictionnaires et les banques de terminologie restent permis.
Le mandat compte comme la source. Un terme qui s’écarte de la liste
imposée est un terme inadapté (terminologie), un format de nombre qui
s’écarte des conventions une erreur de format (conventions locales), une
espace ou un guillemet fautif une erreur de ponctuation (fluidité) ; un terme anglais
gardé entre parenthèses après son équivalent français n’est pas une erreur.
Le mandat est sur Projet 2 · Pas à pas,
à l’étape 2.
Lisez la traduction comme un texte, phrase après phrase. Une formulation
qui convient dans ce texte n’est pas une erreur, même si elle serait douteuse
ailleurs ; une formulation correcte ailleurs mais fausse dans ce texte en est
une.
Une erreur par problème. Deux mots mal traduits dans une phrase font deux
erreurs. Un même passage qui pose plusieurs problèmes n’en compte qu’une, la
plus grave ; à gravité égale, la catégorie qui vient la première dans la
grille.
Une erreur répétée dans plusieurs phrases compte dans chacune.
Une préférence n’est pas une erreur : si la traduction est correcte mais
que vous l’auriez formulée autrement, la gravité est neutre.
Citez les mots en cause : ceux de la traduction, ou ceux de la source
pour une omission ou une erreur dans la source. Ajoutez une note quand la
catégorie ne suffit pas à comprendre le problème.
Cinq erreurs au plus par phrase. S’il y en a davantage, gardez les cinq
plus graves.
Annotez les trois traductions l’une après l’autre, et cochez la case du
bas quand vous avez relu toutes les phrases d’une traduction. Pour ajouter
une erreur, sélectionnez à la souris les mots en cause dans la traduction,
ou dans la source pour une omission : le formulaire s’ouvre avec ces mots,
et une fois l’erreur ajoutée, ils restent marqués dans la couleur de sa
catégorie. Le bouton « + erreur » ouvre le formulaire sans sélection.
Le juge : pour chaque traduction que vous faites juger, le bouton
« Copier la source et la traduction numérotées » prépare le texte de la
requête, et chaque réponse du juge se colle telle quelle dans sa case. La
page lit les erreurs ; une ligne signalée en rouge se corrige directement
dans la case. Pour la référence, chargez d’abord son fichier, une fois votre
annotation terminée.
Rien n’est envoyé : vos fichiers sont lus par votre navigateur et
restent sur votre ordinateur.
L’outil
4 · Results and comparison4 · Résultats et comparaison
Sources
Freitag, M., Foster, G., Grangier, D., Ratnakar, V., Tan, Q., & Macherey, W. (2021). Experts, Errors, and Context: A Large-Scale Study of Human Evaluation for Machine Translation. Transactions of the Association for Computational Linguistics, 9, 1460–1474. https://doi.org/10.1162/tacl_a_00437
Kocmi, T., Artemova, E., Avramidis, E., Bawden, R., Bojar, O., Dranch, K., et al. (2025). Findings of the WMT25 General Machine Translation Shared Task: Time to Stop Evaluating on Easy Test Sets. Proceedings of the Tenth Conference on Machine Translation (WMT 2025), Volume 2: Shared Task Papers, 355–413. https://doi.org/10.18653/v1/2025.wmt-1.22