Projet 2 · AperçuProjet 2 · Aperçu
Le projet en bref
Le Projet 2 compare trois façons de faire traduire un même texte de l’anglais vers le français :
- avec l’agent : vous traduisez vous-même en travaillant avec un agent conversationnel, de la préparation à la version finale ;
- la requête unique : l’agent reçoit une seule requête promptrequête promptingrequêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. et l’on garde ce qu’il produit ;
- DeepL : un service de traduction automatique machine translation (MT)traduction automatique (TA) translationtraduction The use of a computer system to produce content in a target language that conveys content expressed in a source language.Utilisation d'un système informatique pour produire, dans une langue cible, un contenu qui rend un contenu exprimé dans une langue source. conçu pour traduire et rien d’autre.
Les trois suivent le même mandat de traduction (public, français du Canada, terminologie), mais ne le reçoivent pas de la même façon : DeepL ne le reçoit pas, la requête unique le contient en entier, et avec l’agent, c’est vous qui veillez à ce qu’il soit suivi. Un écart au mandat compte comme une erreur dans les évaluations qui s’appuient sur lui, quelle que soit la traduction.
Ces traductions sont ensuite évaluées de quatre façons :
- votre annotation de leurs erreurs, avec la grille MQM ;
- le juge : un agent conversationnel à qui l’on demande de les juger ;
- chrF, une métrique automatique de surface ;
- COMET, une métrique automatique apprise à partir de jugements humains.
chrF et COMET comparent chaque traduction à une traduction humaine faite par une autre équipe, la référence.
Le projet se fait en trois équipes de trois, chacune avec son agent : Claude, ChatGPT ou Gemini.
La comparaison des quatre évaluations est le cœur du projet : un texte n’a pas une seule bonne traduction, et les quatre évaluations ne classent pas toujours les traductions de la même manière.
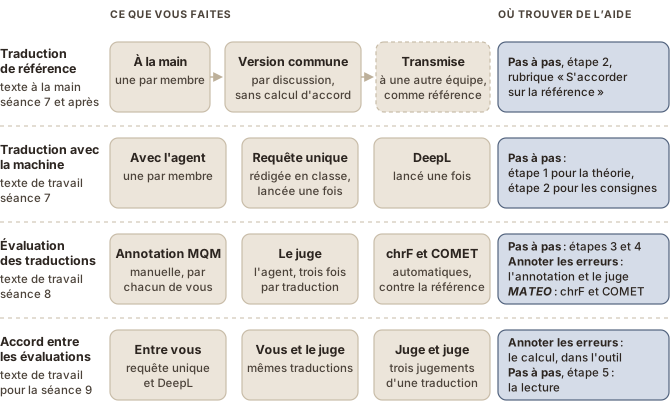
La Figure 1figure 1 résume le travail du projet et, pour chaque partie, où trouver de l’aide.
Le Projet 2 vaut 30 % de la note du cours. Il est noté sur 100 points :
| Ce qui est noté | Points | Qui |
|---|---|---|
| le processus : votre part dans le travail en classe (la rédaction des deux requêtes, la référence en équipe) et le travail fait (vos deux traductions, votre annotation, vos conversations avec le juge), notés sur l’engagement et non sur la qualité | 10 | chaque personne |
| la présentation | 15 | l’équipe |
| le rapport d’équipe | 30 | l’équipe |
| le rapport individuel | 45 | chaque personne |
Les gabarits indiquent les points de chaque question.
Votre équipe et vos textes
Choisissez votre équipe : la page indique vos deux textes, et la page d’annotation s’en souviendra.
You translate text 1 by hand. Your working text is text 2; its reference comes from the ChatGPT team. Vous traduisez à la main le texte 1. Votre texte de travail est le texte 2 ; sa référence vient de l'équipe ChatGPT.
You translate text 2 by hand. Your working text is text 3; its reference comes from the Gemini team. Vous traduisez à la main le texte 2. Votre texte de travail est le texte 3 ; sa référence vient de l'équipe Gemini.
You translate text 3 by hand. Your working text is text 1; its reference comes from the Claude team. Vous traduisez à la main le texte 3. Votre texte de travail est le texte 1 ; sa référence vient de l'équipe Claude.
| TeamÉquipe | Translates by handTraduit à la main | Working textTexte de travail | Its reference comes fromSa référence vient de |
|---|---|---|---|
| Claude teaml'équipe Claude | text 1le texte 1 | text 2le texte 2 | the ChatGPT teaml'équipe ChatGPT |
| ChatGPT teaml'équipe ChatGPT | text 2le texte 2 | text 3le texte 3 | the Gemini teaml'équipe Gemini |
| Gemini teaml'équipe Gemini | text 3le texte 3 | text 1le texte 1 | the Claude teaml'équipe Claude |
La composition des équipes et l’agent de chacune sont annoncés sur StudiUM ; l’attribution des agents change d’un projet à l’autre.
Chaque équipe travaille sur deux textes, celui qu’elle traduit à la main et son texte de travail, pour deux raisons :
- Vos deux traductions restent indépendantes. Si vous traduisiez le même texte à la main puis avec l’agent, la seconde traduction reprendrait vos solutions de la première, et ne montrerait plus ce que donne le travail avec l’agent.
- La référence ne favorise aucune de vos traductions. chrF et COMET mesurent la ressemblance avec la référence. Faite par une autre équipe, qui n’a pas travaillé sur ce texte avec un agent, la référence ne ressemble pas d’avance à vos traductions.
- L’ordre est fixe. Sur le texte de travail, les trois traductions avec l’agent viennent en premier, puis la requête unique, puis DeepL : une traduction lue avant de traduire influence la vôtre.
Le projet semaine par semaine
| Quand | Chaque personne | L’équipe | Toute la classe |
|---|---|---|---|
| entre les séances 6 et 7, pour le 29 octobre 2026 | lire la théorie sur la traduction automatique (1) | ||
| séance 7, 29 octobre 2026 | traduire à la main le texte indiqué pour votre équipe ; traduire le texte de travail avec l’agent (2) | rédiger la requête unique (2) | |
| entre les séances 7 et 8, pour le 5 novembre 2026 | finir les traductions ; vérifier vos fichiers ; lire la théorie sur l’évaluation (2, 3) | lancer la requête unique et DeepL ; s’accorder sur la référence et me l’envoyer au plus tard au début de la séance 8 (2) | |
| séance 8, 5 novembre 2026 | annoter votre traduction avec l’agent, la requête unique et DeepL ; premier jugement des deux traductions que vous faites juger (4) | chrF et COMET dans MATEO (4) | rédiger la requête du juge (4) |
| entre les séances 8 et 9, pour le 12 novembre 2026 | finir l’annotation ; les quatre autres jugements (4) | comparer les annotations et les jugements ; rassembler les quatre classements ; préparer la présentation (5, 6) | |
| séance 9, 12 novembre 2026 | présenter (6) | ||
| 20 novembre 2026, 23 h 59 | le rapport individuel, avec vos deux traductions et le fichier exporté de votre annotation (7) | le rapport d’équipe (7) |
Chaque étape est détaillée, avec son matériel, sur Projet 2 · Pas à pas.
Les traductions et leurs évaluations
| Traduction | Annotation MQM | Juge, trois fois | chrF et COMET, contre la référence |
|---|---|---|---|
| les trois traductions avec l’agent, une par membre | par son auteur | oui | oui |
| la requête unique | par chaque membre | oui | oui |
| DeepL | par chaque membre | oui | oui |
| la référence | oui | elle sert de point de comparaison |
Ce que vous remettez
Les remises finales se font sur StudiUM ; les remises intermédiaires, par courriel, à ayla.rigouts.terryn@umontreal.ca. Vos conversations avec l’agent et vos scores ne se remettent pas à part : ils vont dans les rapports. Un lien de partage qui ne fonctionne pas, ou un agent qui ne permet pas le partage, se remplace par une copie de la conversation, ajoutée à la remise du rapport où le lien figure.
| Quoi | Qui | Où | Quand |
|---|---|---|---|
| la référence de l’équipe | l’équipe | courriel | au début de la séance 8, le 5 novembre 2026 |
| les diapositives | l’équipe | courriel | 12 novembre 2026, 23 h 59 |
le rapport individuel, avec vos deux traductions (.txt) et le fichier exporté de votre annotation (.json) | chaque personne | StudiUM | 20 novembre 2026, 23 h 59 |
| le rapport d’équipe | chaque membre, le même fichier | StudiUM | 20 novembre 2026, 23 h 59 |
This page is only available in French.