Precision, recall and F1Précision, rappel et score F1
TRA2600 S9 · in classS9 · en classe
TRA6008 S5 · in classS5 · en classe
Precision and recall
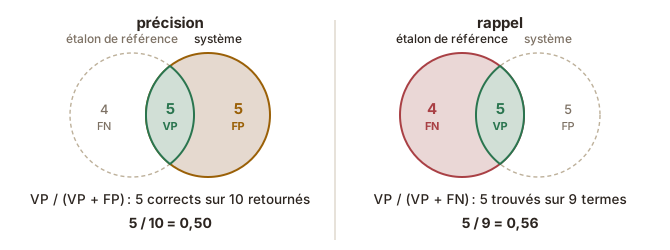
For a system that finds things in a text, or that sorts items into two classes, the comparison with a gold standard gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. gives two scores (Jurafsky & Martin, 2026). Figure 6figure 6 shows the parts they are calculated from, for a term extractor.
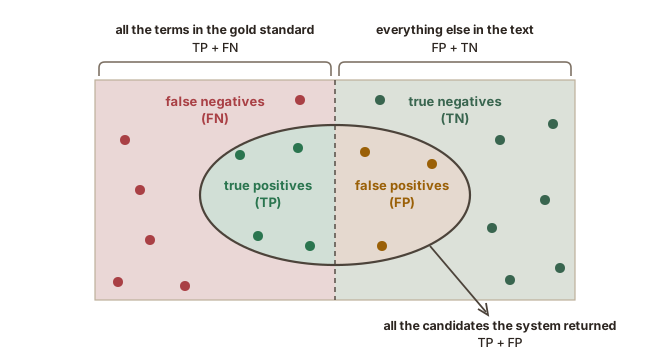
Each score can be explained in several ways, and one may be clearer to you than the others:
- Precision
- as a formula: precision = TP / (TP + FP);
- as a share: the true positives true positive (TP)vrai positif (VP) evaluationévaluation An item that a system returned, or assigned to the class it looks for, and that the gold standard also contains: for example, a candidate that is a term, or spam stopped by a spam filter.Élément qu'un système a trouvé, ou classé dans la classe recherchée, et que la référence contient aussi : par exemple, un candidat qui est un terme, ou un pourriel arrêté par un filtre antipourriel. divided by everything the system returned, for a term extractor all its candidates;
- as a question: of everything the system returned, how much is correct?
- false positives false positive (FP)faux positif (FP) evaluationévaluation An item that a system returned, or assigned to the class it looks for, but that the gold standard does not contain: for example, a candidate that is not a term, or a legitimate message stopped by a spam filter.Élément qu'un système a trouvé, ou classé dans la classe recherchée, mais que la référence ne contient pas : par exemple, un candidat qui n'est pas un terme, ou un message légitime arrêté par un filtre antipourriel. , the noise noisebruit evaluationévaluation The items a system returns that are not correct: in term extraction, the candidates that are not terms.Éléments trouvés par un système qui ne sont pas corrects : en extraction de termes, les candidats qui ne sont pas des termes. , lower it.
- Recall
- as a formula: recall = TP / (TP + FN);
- as a share: the true positives divided by everything in the gold standard, for a term extractor all its terms;
- as a question: of everything in the gold standard, how much did the system find?
- false negatives false negative (FN)faux négatif (FN) evaluationévaluation An item that the gold standard contains but that a system did not return, or did not assign to the class it looks for: for example, a term that was not proposed, or spam that reaches the inbox.Élément que la référence contient, mais qu'un système n'a ni trouvé ni classé dans la classe recherchée : par exemple, un terme qui n'a pas été proposé, ou un pourriel qui arrive dans la boîte de réception. , the silence silencesilence evaluationévaluation The correct items a system fails to return: in term extraction, the terms of the gold standard that were not proposed.Éléments corrects qu'un système ne trouve pas : en extraction de termes, les termes de la référence qui n'ont pas été proposés. , lower it.
A worked example
In this example, a term extractor returns ten candidates for a short text about dressage, and the gold standard for that text has nine terms (Figure 7figure 7).
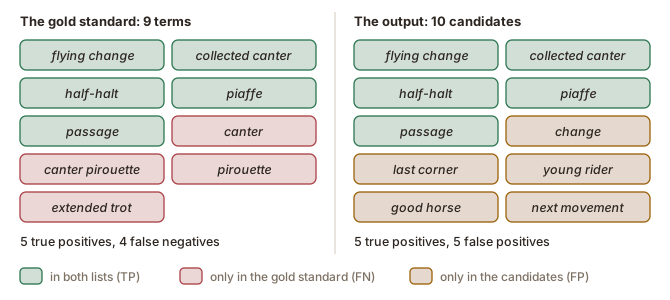
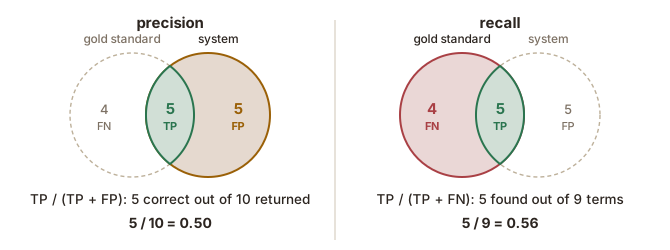
Five candidates are on both lists, so there are 5 true positives, 5 false positives and 4 false negatives (Figure 8figure 8):
- precision = 5 / (5 + 5) = 0.50;
- recall = 5 / (5 + 4) = 0.56.
The F1 score
The F1 score combines precision and recall into one number.
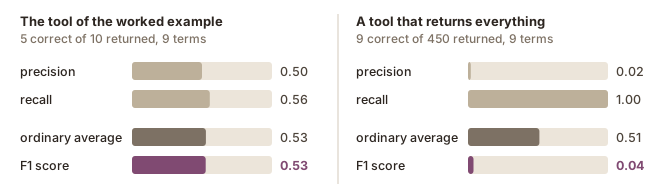
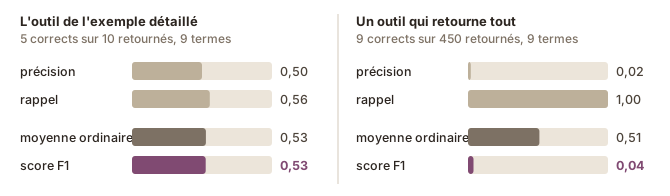
It is twice their product divided by their sum: F1 = 2 × precision × recall / (precision + recall), here 2 × 0.50 × 0.56 / (0.50 + 0.56) = 0.53. As a harmonic mean, it is closer to the lower of the two values than an ordinary average would be (Jurafsky & Martin, 2026), so a tool cannot score well by doing one thing only. For example, if a tool returned every word and every sequence of words of a text, it would have perfect recall, a precision close to zero, and an F1 score close to zero (Figure 9figure 9).
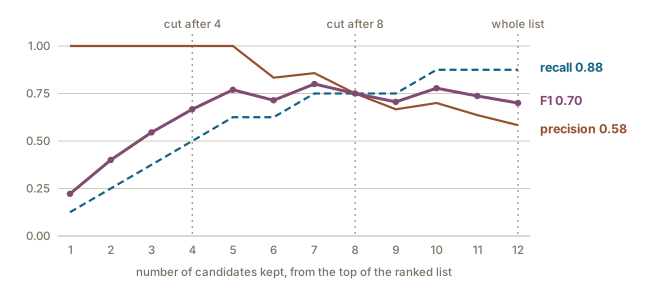
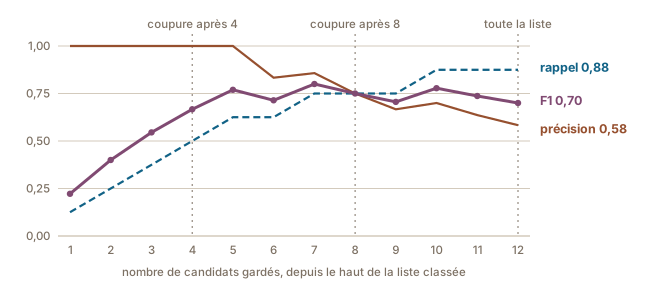
The scores change with the number of candidates a tool returns. Figure 10figure 10 gives the three scores after each candidate of the ranked list of Figure 5figure 5: as more candidates are kept, precision falls and recall rises, and the F1 score is highest after seven candidates.
More than two classes
When a system sorts items into more than two classes, for example emails into urgent, normal and spam, precision and recall are calculated for each class. The scores of the classes are then averaged (macroaveraging), or the decisions for all classes are pooled before the calculation (microaveraging), in which case the most frequent class has the most influence on the result (Jurafsky & Martin, 2026).
Accuracy
The most obvious score is accuracy.
Unlike precision and recall, accuracy also counts the true negatives true negative (TN)vrai négatif (VN) evaluationévaluation An item that the gold standard does not contain and that a system did not return, or did not assign to the class it looks for: for example, a legitimate message that a spam filter lets through.Élément que la référence ne contient pas et qu'un système n'a ni trouvé ni classé dans la classe recherchée : par exemple, un message légitime qu'un filtre antipourriel laisse passer. : accuracy = (TP + TN) / (TP + FP + FN + TN). In words, accuracy is the number of correct decisions, positive or negative, divided by the number of all decisions. It can be calculated for a system that sorts items into classes, where the true negatives can be counted, but not for a system that finds things in a text (see also the False positives and false negatives page) (voir aussi la page Faux positifs et faux négatifs).
Figure 11figure 11 calculates it for a spam filter and 100 messages: 10 of the messages are spam, and the filter stops 6 of them and 6 messages that are not spam.
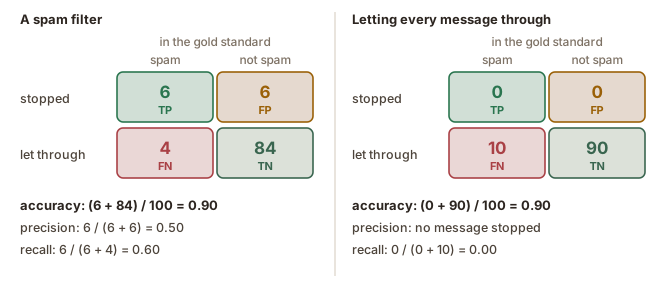
Accuracy is misleading when the class to find is rare, as the second matrix shows. Jurafsky and Martin (2026) give a more extreme example: a million social media posts, of which a hundred are about the product a company wants to follow: a system that labels every post as not about the product is right for 99.99 % of the posts, but it has found none of the hundred. Precision and recall do not count the true negatives, so the same system has a recall of zero (see also the Baselines page) (voir aussi la page Les étalons).
La précision et le rappel
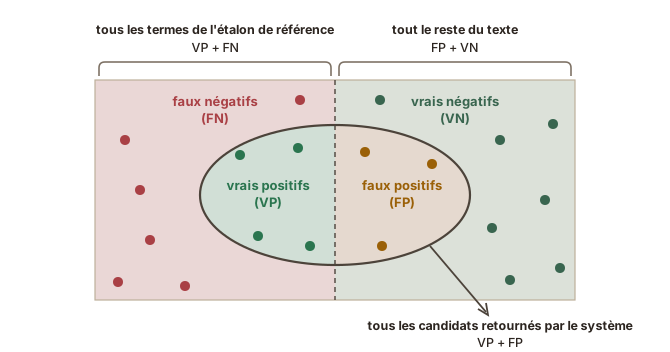
Pour un système qui repère des éléments dans un texte, ou qui classe des éléments en deux classes, la comparaison avec un étalon de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. donne deux scores (Jurafsky & Martin, 2026). La Figure 6figure 6 montre les parties à partir desquelles ils se calculent, pour un extracteur de termes.
Chaque score peut s’expliquer de plusieurs façons, et l’une d’elles vous paraîtra peut-être plus claire que les autres :
- Précision
- sous forme de formule : précision = VP / (VP + FP) ;
- sous forme de part : les vrais positifs true positive (TP)vrai positif (VP) evaluationévaluation An item that a system returned, or assigned to the class it looks for, and that the gold standard also contains: for example, a candidate that is a term, or spam stopped by a spam filter.Élément qu'un système a trouvé, ou classé dans la classe recherchée, et que la référence contient aussi : par exemple, un candidat qui est un terme, ou un pourriel arrêté par un filtre antipourriel. divisés par tout ce que le système a trouvé, pour un extracteur de termes tous ses candidats ;
- sous forme de question : de tout ce que le système a trouvé, quelle part est correcte ?
- les faux positifs false positive (FP)faux positif (FP) evaluationévaluation An item that a system returned, or assigned to the class it looks for, but that the gold standard does not contain: for example, a candidate that is not a term, or a legitimate message stopped by a spam filter.Élément qu'un système a trouvé, ou classé dans la classe recherchée, mais que la référence ne contient pas : par exemple, un candidat qui n'est pas un terme, ou un message légitime arrêté par un filtre antipourriel. , le bruit noisebruit evaluationévaluation The items a system returns that are not correct: in term extraction, the candidates that are not terms.Éléments trouvés par un système qui ne sont pas corrects : en extraction de termes, les candidats qui ne sont pas des termes. , la font baisser.
- Rappel
- sous forme de formule : rappel = VP / (VP + FN) ;
- sous forme de part : les vrais positifs divisés par tout ce que contient l’étalon de référence, pour un extracteur de termes tous ses termes ;
- sous forme de question : de tout ce que contient l’étalon de référence, quelle part le système a-t-il trouvée ?
- les faux négatifs false negative (FN)faux négatif (FN) evaluationévaluation An item that the gold standard contains but that a system did not return, or did not assign to the class it looks for: for example, a term that was not proposed, or spam that reaches the inbox.Élément que la référence contient, mais qu'un système n'a ni trouvé ni classé dans la classe recherchée : par exemple, un terme qui n'a pas été proposé, ou un pourriel qui arrive dans la boîte de réception. , le silence silencesilence evaluationévaluation The correct items a system fails to return: in term extraction, the terms of the gold standard that were not proposed.Éléments corrects qu'un système ne trouve pas : en extraction de termes, les termes de la référence qui n'ont pas été proposés. , le font baisser.
Un exemple détaillé
Dans cet exemple, un extracteur de termes propose dix candidats pour un court texte sur le dressage, et l’étalon de référence de ce texte compte neuf termes (Figure 7figure 7).
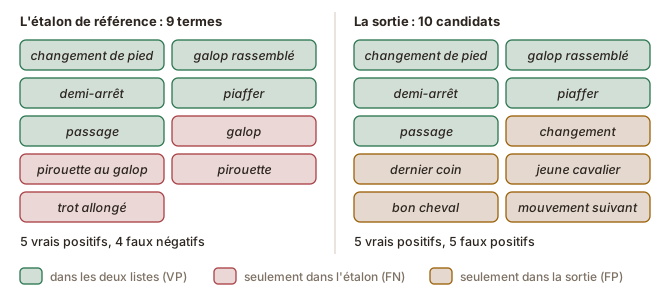
Cinq candidats figurent sur les deux listes : il y a donc 5 vrais positifs, 5 faux positifs et 4 faux négatifs (Figure 8figure 8) :
- précision = 5 / (5 + 5) = 0,50 ;
- rappel = 5 / (5 + 4) = 0,56.
Le score F1
Le score F1 combine la précision et le rappel en un seul nombre.
Il vaut deux fois leur produit, divisé par leur somme : F1 = 2 × précision × rappel / (précision + rappel), ici 2 × 0,50 × 0,56 / (0,50 + 0,56) = 0,53. Comme moyenne harmonique, il est plus proche de la plus basse des deux valeurs que ne le serait une moyenne ordinaire (Jurafsky & Martin, 2026) : un outil ne peut donc pas obtenir un bon score en ne faisant qu’une seule chose. Par exemple, si un outil proposait chaque mot et chaque suite de mots d’un texte, il aurait un rappel parfait, une précision proche de zéro et un score F1 proche de zéro (Figure 9figure 9).
Les scores changent avec le nombre de candidats qu’un outil propose. La Figure 10figure 10 donne les trois scores après chaque candidat de la liste classée de Figure 5figure 5 : à mesure qu’on garde plus de candidats, la précision baisse et le rappel augmente, et le score F1 est le plus élevé après sept candidats.
Plus de deux classes
Quand un système classe des éléments en plus de deux classes, par exemple des courriels en urgents, normaux et pourriels, la précision et le rappel se calculent pour chaque classe. On fait ensuite la moyenne des scores des classes (macromoyenne), ou on regroupe les décisions de toutes les classes avant le calcul (micromoyenne) ; dans ce cas, la classe la plus fréquente pèse le plus sur le résultat (Jurafsky & Martin, 2026).
L’exactitude
Le score le plus évident est l’exactitude.
Contrairement à la précision et au rappel, l’exactitude compte aussi les vrais négatifs true negative (TN)vrai négatif (VN) evaluationévaluation An item that the gold standard does not contain and that a system did not return, or did not assign to the class it looks for: for example, a legitimate message that a spam filter lets through.Élément que la référence ne contient pas et qu'un système n'a ni trouvé ni classé dans la classe recherchée : par exemple, un message légitime qu'un filtre antipourriel laisse passer. : exactitude = (VP + VN) / (VP + FP + FN + VN). Autrement dit, l’exactitude est le nombre de décisions correctes, positives ou négatives, divisé par le nombre total de décisions. Elle peut se calculer pour un système qui classe des éléments, où les vrais négatifs peuvent être comptés, mais pas pour un système qui repère des éléments dans un texte (see also the False positives and false negatives page) (voir aussi la page Faux positifs et faux négatifs).
La Figure 11figure 11 la calcule pour un filtre antipourriel et 100 messages : 10 de ces messages sont des pourriels, et le filtre en arrête 6, ainsi que 6 messages qui ne sont pas des pourriels.
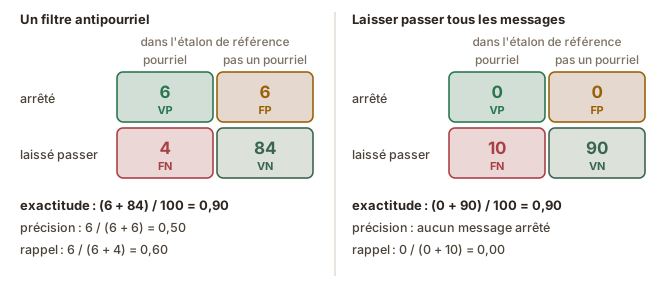
L’exactitude est trompeuse quand la classe à trouver est rare, comme le montre la deuxième matrice. Jurafsky et Martin (2026) donnent un exemple plus extrême : un million de publications sur les réseaux sociaux, dont une centaine portent sur le produit qu’une entreprise veut suivre. Un système qui étiquette chaque publication comme ne portant pas sur le produit a raison pour 99,99 % des publications, mais il n’a trouvé aucune des cent. La précision et le rappel ne comptent pas les vrais négatifs : le même système a donc un rappel de zéro (see also the Baselines page) (voir aussi la page Les étalons).
Sources
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- Rigouts Terryn, A., Hoste, V., & Lefever, E. (2020a). In No Uncertain Terms: A Dataset for Monolingual and Multilingual Automatic Term Extraction from Comparable Corpora. Language Resources and Evaluation, 54(2), 385–418. https://doi.org/10.1007/s10579-019-09453-9