The WMT general translation taskLa tâche générale de traduction de WMT
TRA6008 To read for S8À lire pour la S8
A shared task
Two systems tested by their own developers are hard to compare, since each is tested on texts and with a measure the developer chose. A shared task gives every system the same test.
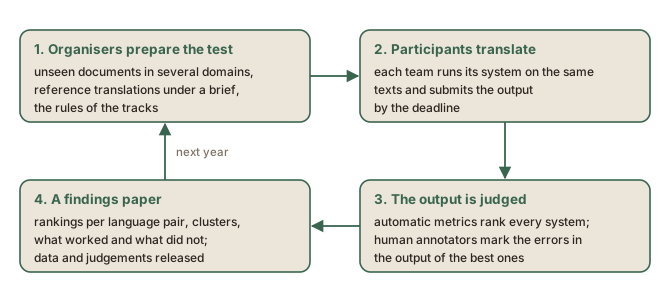
For machine translation, the best-known shared task is WMT, the Conference on Machine Translation, which has run a general translation task every year since 2006, first as a workshop and since 2016 as a conference (Kocmi et al., 2025). Each year follows the same cycle (Figure 1figure 1):
- the organizers prepare test texts that nobody has seen;
- the participants translate them with their systems and submit the output by a deadline;
- the organizers have the output judged;
- the results appear together in a findings paper, and the data are released so that the evaluation can be checked and reused.
Training data and test data
A system is built from training data training setjeu de données d'entraînement machine learningapprentissage automatique The portion of a dataset used to train a machine-learning model.Portion d'un jeu de données servant à entraîner un modèle d'apprentissage automatique. , often public parallel corpora parallel corpuscorpus parallèle corporacorpus A corpus of texts in one language together with their translations into one or more other languages, usually aligned sentence by sentence so that each segment can be viewed next to its equivalent.Corpus de textes dans une langue accompagnés de leurs traductions vers une ou plusieurs autres langues, généralement alignés phrase par phrase de façon à afficher chaque segment en regard de son équivalent. , and tested on texts that WMT prepares for the evaluation only. These texts are the test set test setjeu de données de test machine learningapprentissage automatique A portion of a dataset held back from both model training and model selection and used to evaluate the final model.Portion d'un jeu de données tenue à l'écart tant de l'entraînement que de la sélection du modèle et servant à évaluer le modèle final. Son but est d'estimer la performance du modèle achevé sur de nouvelles données issues de la tâche ou de la population visée. , and the whole arrangement (texts, reference translations and scoring) is a benchmark benchmarktest de performances evaluationévaluation A standardized evaluation used to measure and compare how AI systems perform on particular tasks or capabilities.Évaluation normalisée servant à mesurer et à comparer la performance de systèmes d'IA sur des tâches ou des capacités données. (see also the Benchmarks and test sets page, in the Evaluating language technology module) (voir aussi la page Tests de performances et jeux de test, dans le module L'évaluation des technologies langagières). The texts have to be new to the systems: a system trained on them would be scored on text it may have memorized rather than on how well it translates. The organizers therefore collect the most recent source texts they can, to limit the overlap with the data the systems were trained or fine-tuned fine-tuningaffinage machine learningapprentissage automatique Further training of a pretrained model on new data to adapt it for a particular task, domain, or intended behaviour.Poursuite de l'entraînement d'un modèle préentraîné sur un jeu de données généralement plus restreint et spécialisé, afin de l'adapter à une tâche ou à un domaine particulier. on (Kocmi et al., 2024b, 2025).
Building the test sets
A recent edition covers a few dozen language pairs, about half of them with human evaluation. The test sets of the 2024 and 2025 editions were built this way (Kocmi et al., 2024b, 2025):
- Several domains. News, social media, speech and literary texts in both editions, with educational texts added in 2025, chosen to cover different styles while staying readable by annotators without specialist knowledge. For the speech domain, participants receive the audio and an automatic transcription; in 2025 they also received screenshots of the social media posts.
- Whole documents. Since 2024, each source text is an entire document, such as a news article or a social media thread, divided into paragraphs. Participants can translate it at once or piece by piece, and each translation is judged in its context.
- Difficult documents. New in 2025: an automatic estimator of translation difficulty scores every paragraph from the source alone, the scores are aggregated by document, and the hardest documents are kept.
- Human references. Professional translation agencies translate the test sets according to a brief that requires translation from scratch, without post-editing post-editingpostédition machine translationtraduction automatique The human correction of raw machine translation output; the counterpart, for machine translation, of revision in human translation.Correction humaine de la sortie brute d'une traduction automatique ; l'équivalent, pour la traduction automatique, de l'étape de révision en traduction humaine. machine output or using a CAT tool, since post-edited references would bias the evaluation. Different agencies serve different language pairs, which the organizers note as one source of variation in the quality of the references.
Tracks
Submissions are compared within tracks, which set what a system may be built with:
- the constrained track admits only models and training data that are publicly available, so that the result can be reproduced; in 2025 it also limited the model to 20 billion parameters parameterparamètre de modèle machine learningapprentissage automatique A numerical value learned during a model's training and used in its computations.Valeur numérique apprise pendant l'entraînement d'un modèle et utilisée dans ses calculs. ;
- the other systems, proprietary models and private data included, form a track of their own: the unconstrained track in 2025, split in 2024 into an open track (public data and models) and a closed one (Kocmi et al., 2024b, 2025).
In 2025, a multilingual subtrack, evaluated automatically only, tested one system translating from English into many languages at once.
The participants
A few dozen teams submit systems, academic and industrial, and the organizers add systems that they collect themselves: output from large language models large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. prompted to translate, and from popular online translation services, which appear in the results under anonymous names (Kocmi et al., 2024b, 2025).
The judging
Several dozen systems are too many to judge by hand, so since 2024 the judging happens in two stages (Figure 2figure 2; Kocmi et al., 2024b, 2025).
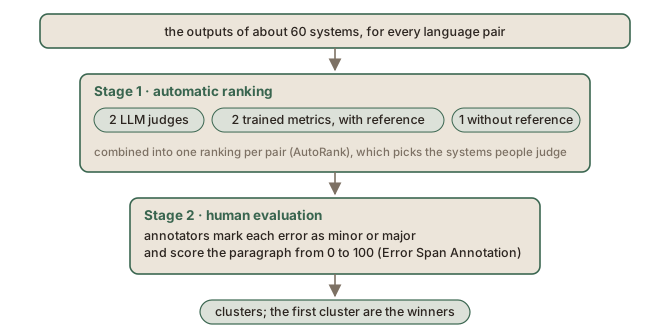
- Automatic ranking. Automatic methods score every system, and the scores are combined into one ranking per language pair, which the organizers call AutoRank and use to choose which systems go to human evaluation. In 2024 AutoRank combined two metrics trained on human judgements, one that compares the output with the reference and one that works without it; in 2025 it combined two large language models prompted to act as judges, two trained metrics that compare with the reference, and one that works without it.
- Human evaluation. Annotators who are native speakers of the target language, many of them professional translators or linguists, judge the output with the Error Span Annotation protocol: they mark every error in a paragraph as minor or major, then give the paragraph a score from 0 to 100 (Kocmi et al., 2024a). In 2025, two language pairs were judged with the finer MQM scheme instead (see also the Human evaluation: DA, MQM and ESA page, in the Evaluating language technology module) (voir aussi la page L'évaluation humaine : DA, MQM et ESA, dans le module L'évaluation des technologies langagières). Systems whose human scores cannot be told apart statistically are placed in one cluster, and the systems of the first cluster are the winners of a language pair.
Une tâche partagée
Deux systèmes testés par leurs propres développeurs se comparent mal, puisque chacun est testé sur des textes et avec une mesure que son développeur a choisis. Une tâche partagée soumet tous les systèmes au même test.
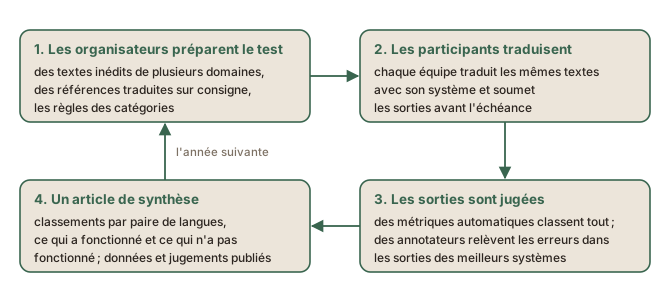
En traduction automatique, la tâche partagée la plus connue est celle de WMT, la Conference on Machine Translation, qui organise chaque année depuis 2006 une tâche générale de traduction, d’abord sous forme d’atelier, puis, depuis 2016, de conférence (Kocmi et al., 2025). Chaque année suit le même cycle (Figure 1figure 1) :
- les organisateurs préparent des textes de test que personne n’a vus ;
- les participants les traduisent avec leurs systèmes et soumettent les résultats avant une échéance ;
- les organisateurs font juger les résultats ;
- les résultats paraissent ensemble dans un article de synthèse, et les données sont publiées pour que l’évaluation puisse être vérifiée et réutilisée.
Données d’entraînement et données de test
Un système est construit à partir de données d’entraînement training setjeu de données d'entraînement machine learningapprentissage automatique The portion of a dataset used to train a machine-learning model.Portion d'un jeu de données servant à entraîner un modèle d'apprentissage automatique. , souvent des corpus parallèles parallel corpuscorpus parallèle corporacorpus A corpus of texts in one language together with their translations into one or more other languages, usually aligned sentence by sentence so that each segment can be viewed next to its equivalent.Corpus de textes dans une langue accompagnés de leurs traductions vers une ou plusieurs autres langues, généralement alignés phrase par phrase de façon à afficher chaque segment en regard de son équivalent. publics, et testé sur des textes que WMT prépare pour la seule évaluation. Ces textes forment le jeu de test test setjeu de données de test machine learningapprentissage automatique A portion of a dataset held back from both model training and model selection and used to evaluate the final model.Portion d'un jeu de données tenue à l'écart tant de l'entraînement que de la sélection du modèle et servant à évaluer le modèle final. Son but est d'estimer la performance du modèle achevé sur de nouvelles données issues de la tâche ou de la population visée. , et l’ensemble du dispositif (textes, traductions de référence et notation) est un test de performances benchmarktest de performances evaluationévaluation A standardized evaluation used to measure and compare how AI systems perform on particular tasks or capabilities.Évaluation normalisée servant à mesurer et à comparer la performance de systèmes d'IA sur des tâches ou des capacités données. (see also the Benchmarks and test sets page, in the Evaluating language technology module) (voir aussi la page Tests de performances et jeux de test, dans le module L'évaluation des technologies langagières). Les textes doivent être nouveaux pour les systèmes : un système entraîné sur ces textes serait noté sur un texte qu’il a peut-être mémorisé, plutôt que sur sa capacité à traduire. Les organisateurs recueillent donc les textes sources les plus récents possible, afin de limiter le recouvrement avec les données sur lesquelles les systèmes ont été entraînés ou affinés fine-tuningaffinage machine learningapprentissage automatique Further training of a pretrained model on new data to adapt it for a particular task, domain, or intended behaviour.Poursuite de l'entraînement d'un modèle préentraîné sur un jeu de données généralement plus restreint et spécialisé, afin de l'adapter à une tâche ou à un domaine particulier. (Kocmi et al., 2024b, 2025).
La constitution des jeux de test
Une édition récente couvre quelques dizaines de paires de langues, dont environ la moitié font l’objet d’une évaluation humaine. Les jeux de test des éditions 2024 et 2025 ont été constitués ainsi (Kocmi et al., 2024b, 2025) :
- Plusieurs domaines. Des textes journalistiques, des médias sociaux, de la parole et des textes littéraires dans les deux éditions, auxquels s’ajoutent des textes pédagogiques en 2025, choisis pour couvrir des styles différents tout en restant lisibles par des annotateurs sans connaissances spécialisées. Pour le domaine de la parole, les participants reçoivent l’audio et une transcription automatique ; en 2025, ils ont aussi reçu des captures d’écran des publications des médias sociaux.
- Des documents entiers. Depuis 2024, chaque texte source est un document entier, par exemple un article de presse ou un fil de discussion sur un média social, découpé en paragraphes. Les participants peuvent le traduire d’un seul tenant ou morceau par morceau, et chaque traduction est jugée dans son contexte.
- Des documents difficiles. Nouveauté de 2025 : un estimateur automatique de la difficulté de traduction note chaque paragraphe à partir de la source seule, les notes sont regroupées par document, et les documents les plus difficiles sont retenus.
- Des références humaines. Des agences de traduction professionnelles traduisent les jeux de test selon une consigne qui exige une traduction à partir de zéro, sans postédition post-editingpostédition machine translationtraduction automatique The human correction of raw machine translation output; the counterpart, for machine translation, of revision in human translation.Correction humaine de la sortie brute d'une traduction automatique ; l'équivalent, pour la traduction automatique, de l'étape de révision en traduction humaine. d’une traduction automatique ni recours à un outil de TAO, puisque des références postéditées biaiseraient l’évaluation. Des agences différentes se chargent de paires de langues différentes, ce que les organisateurs relèvent comme l’une des sources de variation dans la qualité des références.
Les catégories
Les soumissions sont comparées au sein de catégories, qui fixent ce avec quoi un système peut être construit :
- la catégorie contrainte n’admet que des modèles et des données d’entraînement accessibles au public, pour que le résultat puisse être reproduit ; en 2025, elle limitait aussi le modèle à 20 milliards de paramètres parameterparamètre de modèle machine learningapprentissage automatique A numerical value learned during a model's training and used in its computations.Valeur numérique apprise pendant l'entraînement d'un modèle et utilisée dans ses calculs. ;
- les autres systèmes, modèles propriétaires et données privées compris, forment une catégorie à part : la catégorie non contrainte en 2025, divisée en 2024 en une catégorie ouverte (données et modèles publics) et une catégorie fermée (Kocmi et al., 2024b, 2025).
En 2025, une sous-catégorie multilingue, évaluée automatiquement seulement, testait un système unique qui traduit de l’anglais vers de nombreuses langues à la fois.
Les participants
Quelques dizaines d’équipes, universitaires et industrielles, soumettent des systèmes, et les organisateurs ajoutent des systèmes qu’ils recueillent eux-mêmes : les résultats de grands modèles de langue large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. (GML) auxquels on demande de traduire, et ceux de services de traduction en ligne populaires, qui figurent dans les résultats sous des noms anonymes (Kocmi et al., 2024b, 2025).
Le jugement
Plusieurs dizaines de systèmes, c’est trop pour un jugement manuel ; depuis 2024, le jugement se fait donc en deux étapes (Figure 2figure 2 ; Kocmi et al., 2024b, 2025).
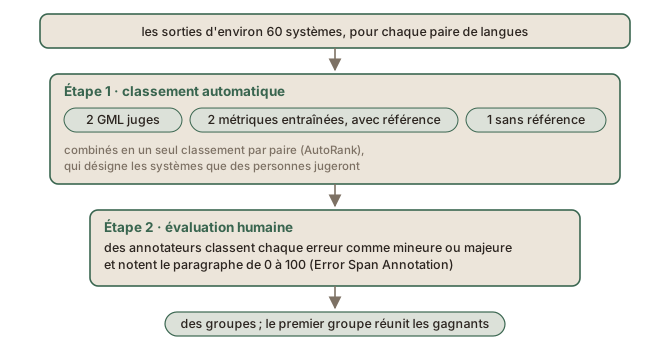
- Classement automatique. Des méthodes automatiques notent chaque système, et les notes sont combinées en un classement par paire de langues, que les organisateurs appellent AutoRank et qui sert à choisir les systèmes soumis à l’évaluation humaine. En 2024, AutoRank combinait deux métriques entraînées sur des jugements humains, l’une qui compare le résultat à la référence et l’autre qui s’en passe ; en 2025, il combinait deux grands modèles de langue utilisés comme juges, deux métriques entraînées qui comparent le résultat à la référence et une qui s’en passe.
- Évaluation humaine. Des annotateurs dont la langue maternelle est la langue cible, pour beaucoup des traducteurs professionnels ou des linguistes, jugent les résultats selon le protocole Error Span Annotation : ils classent chaque erreur d’un paragraphe comme mineure ou majeure, puis attribuent au paragraphe une note de 0 à 100 (Kocmi et al., 2024a). En 2025, deux paires de langues ont été jugées avec la grille MQM, plus fine (see also the Human evaluation: DA, MQM and ESA page, in the Evaluating language technology module) (voir aussi la page L'évaluation humaine : DA, MQM et ESA, dans le module L'évaluation des technologies langagières). Les systèmes dont les notes humaines ne se distinguent pas statistiquement sont placés dans un même groupe, et les systèmes du premier groupe sont les gagnants d’une paire de langues.
Sources
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- Kocmi, T., Artemova, E., Avramidis, E., Bawden, R., Bojar, O., Dranch, K., et al. (2025). Findings of the WMT25 General Machine Translation Shared Task: Time to Stop Evaluating on Easy Test Sets. Proceedings of the Tenth Conference on Machine Translation (WMT 2025), Volume 2: Shared Task Papers, 355–413. https://doi.org/10.18653/v1/2025.wmt-1.22
- Kocmi, T., Avramidis, E., Bawden, R., Bojar, O., Dvorkovich, A., Federmann, C., et al. (2024b). Findings of the WMT24 General Machine Translation Shared Task: The LLM Era Is Here but MT Is Not Solved Yet. Proceedings of the Ninth Conference on Machine Translation (WMT 2024), 1–46. https://doi.org/10.18653/v1/2024.wmt-1.1
- Kocmi, T., Zouhar, V., Avramidis, E., Grundkiewicz, R., Karpinska, M., Popović, M., et al. (2024a). Error Span Annotation: A Balanced Approach for Human Evaluation of Machine Translation. Proceedings of the Ninth Conference on Machine Translation (WMT 2024), 1440–1453. https://doi.org/10.18653/v1/2024.wmt-1.131