Computing scores with MATEOCalculer des scores avec MATEO
TRA6008 To read for S8À lire pour la S8
A tool that computes metrics
MATEO, for MAchine Translation Evaluation Online, is a web interface that computes the main automatic metrics for machine translation without any programming, built for students, translators and researchers in the humanities as well as for experts (Vanroy et al., 2023).
Each score MATEO shows comes from one of the metrics you select, such as chrF or COMET, with that metric’s own scale (see also the Reading the scores page) (voir aussi la page Lire les scores). MATEO does not store the files you upload: they are processed in memory and removed once the processing is done.As stated on MATEO’s home page, read on 13 October 2026.
Preparing the files
MATEO compares the files line by line: line 1 of a translation is scored against line 1 of the reference, and so on. Each file must be:
- plain text plain texttexte brut text encodingencodage du texte Text represented as a sequence of characters alone, with no formatting or layout of its own. A plain-text file opens in any text editor, whatever produced it, which is why interchange formats are written this way: markup languages record structure inside plain text, by writing that structure as characters in the text itself.Texte représenté par la seule suite de ses caractères, sans mise en forme ni mise en page propre. Un fichier en texte brut s'ouvre dans n'importe quel éditeur de texte, quel que soit le logiciel qui l'a produit, ce qui explique que les formats d'échange s'écrivent ainsi : les langages de balisage consignent la structure à l'intérieur du texte brut, en l'écrivant sous forme de caractères dans le texte lui-même. (
.txt), in UTF-8 UTF-8UTF-8 text encodingencodage du texte A variable-length character encoding for Unicode. It represents each valid Unicode code point using a sequence of one to four bytes. Characters in the ASCII repertoire use one byte and retain the same byte values as in ASCII, which helps with compatibility. UTF-8 can represent the same Unicode repertoire as UTF-16 and UTF-32, but it does not imply that every character occupies a single byte. It is widely recommended for multilingual Web content and data exchange.Codage de caractères à longueur variable pour Unicode. Il représente chaque point de code Unicode valide au moyen d'une séquence de un à quatre octets. Les caractères du répertoire ASCII occupent un seul octet et conservent les mêmes valeurs qu'en ASCII, ce qui favorise la compatibilité. UTF-8 permet de représenter le même répertoire Unicode que UTF-16 et UTF-32, mais cela ne signifie pas que chaque caractère occupe un seul octet. Il est largement recommandé pour les contenus Web multilingues et l'échange de données. ; - one segment segmentsegment CAT toolsTAO A portion of translatable content that a CAT tool treats as a discrete unit for translation, alignment, storage and match retrieval.Portion de contenu à traduire qu'un outil de TAO traite comme une unité distincte aux fins de traduction, d'alignement, de stockage et de recherche de correspondances. per line, with no empty line: usually a sentence, but a paragraph or a whole document also works, as long as every file uses the same unit, and the scores per line are then scores per paragraph or per document;
- the same number of lines as the other files, so that each line of every file corresponds to the same segment of the source;
- 1 MB at most.
| File | Contains | Needed |
|---|---|---|
| Reference file | the reference translation | always |
| Source file | the source text | for COMET; optional for the other metrics |
| System file | the translation to evaluate, one file per system | at least one, at most four in one run |
MATEO names each system after its file, without the extension, so a file
called deepl.txt appears as deepl in the results. A translation copied
from a chatbot or a web page does not always come out one segment per line:
a line that wraps on screen is not necessarily a
line break line breaksaut de ligne text encodingencodage du texte The character that ends a line in a file, stored in it like any other and invisible on screen. It is what divides a file into lines, so a file's line count is fixed: two of them make three lines, whatever width the window is. Windows writes it as two characters, a carriage return followed by a line feed (CR LF), where macOS and Linux use one (LF).Caractère qui termine une ligne dans un fichier, enregistré comme n'importe quel autre et invisible à l'écran. C'est lui qui découpe le fichier en lignes, si bien que leur nombre est fixe : deux sauts de ligne font trois lignes, quelle que soit la largeur de la fenêtre. Windows l'écrit au moyen de deux caractères, un retour chariot suivi d'un saut de ligne (CR LF), là où macOS et Linux n'en emploient qu'un (LF). (see also the Plain text and its lines page, in the Exchange formats in translation module) (voir aussi la page Le texte brut et ses lignes, dans le module Les formats d'échange en traduction).
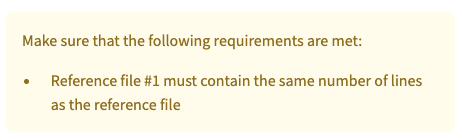
MATEO checks the files as they are uploaded. When a file is missing, or has a different number of lines from the reference, a message under the upload boxes says so, and the button that starts the evaluation does not appear until the problem is solved (Figure 14figure 14). In that message, Reference file #1 is the first system file.
Running an evaluation
On the Evaluate page of MATEO:
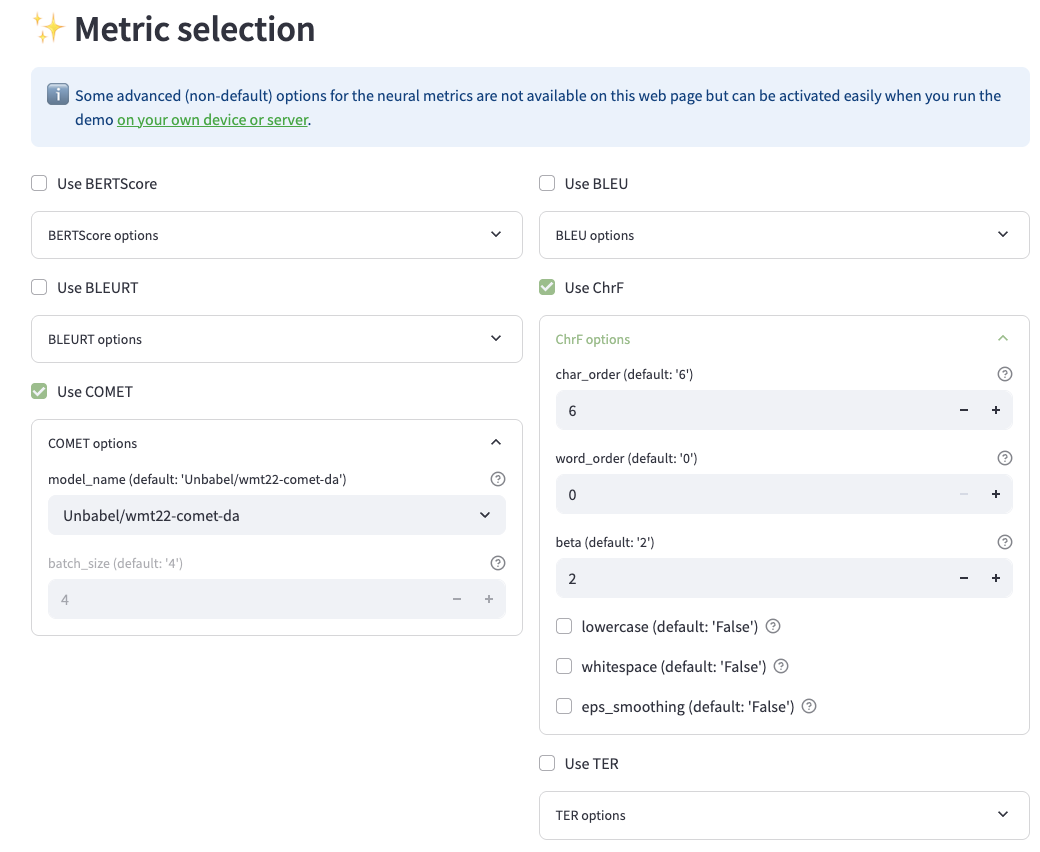
- Choose the metrics under Metric selection (Figure 15figure 15). BLEU, chrF and COMET are ticked by default; BERTScore, BLEURT and TER are not. Each metric has a panel of options; the default options are the usual settings.
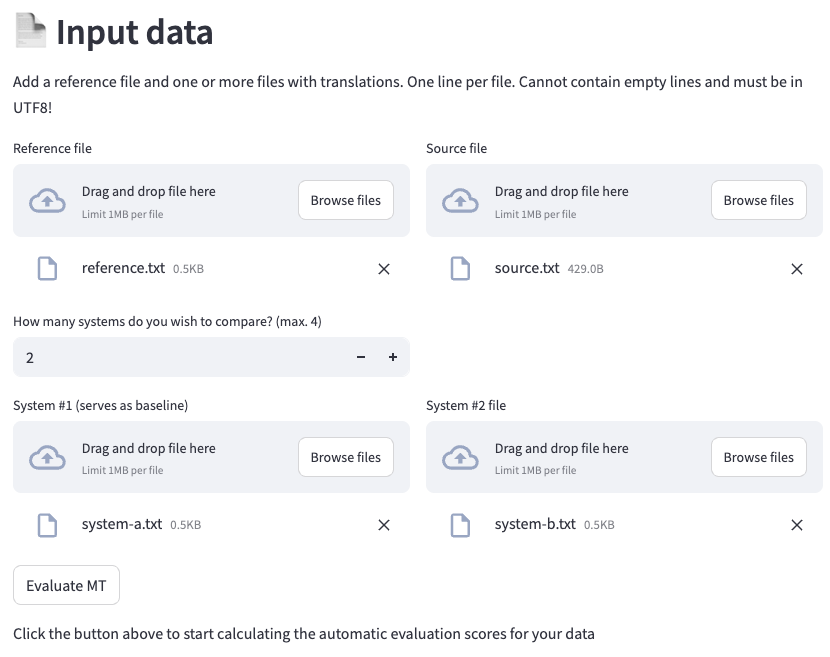
- Upload the files under Input data (Figure 16figure 16): the reference in Reference file, the source in Source file, and each translation in a System box. Set How many systems do you wish to compare? first, to get one box per system; the first system is marked as the baseline. Each file is dragged onto its box or chosen with Browse files; text cannot be pasted.
- Click Evaluate MT. The button appears once the files listed under the boxes are in place: a reference, at least one system, and a source if COMET is selected.
When the evaluation shown here was run on six sentences with chrF, BLEU and COMET on 13 October 2026, the results appeared within a few seconds. The site is shared, so a longer text, or many people using it at the same time, takes longer.
Reading the results
The whole text
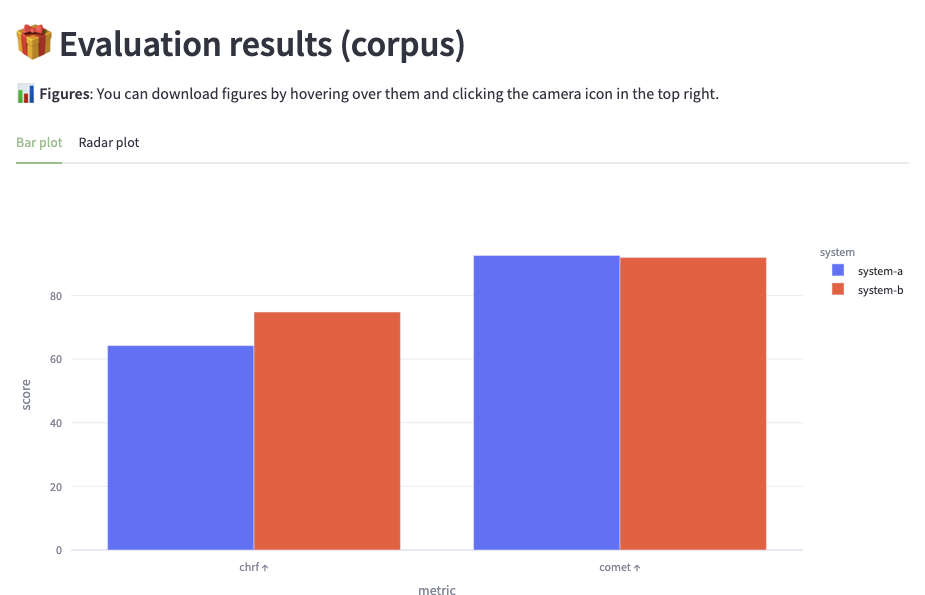
Under Evaluation results (corpus), MATEO gives a bar plot and a radar plot of the scores (Figure 17figure 17), which can be downloaded with the camera icon that appears when the pointer is over them, and a table with one row per system and one column per metric (Figure 18figure 18). In the captures, system-a is a translation worded differently from the reference, and system-b a literal translation with several errors.
In the table, each cell gives:
- the score of the metric for the whole text, before the brackets. This is the number to report.
- in brackets, a mean and a 95 % confidence interval, computed by drawing 1,000 resampled versions of the text: a range in which the score would probably fall with other sentences of the same kind. It can be left aside for a first comparison.
- for every system but the first, a p-value, with an asterisk when the system differs significantly from the first one, which MATEO calls the baseline and highlights. The order in which the systems are uploaded therefore decides which system the others are tested against.
The best score of each metric is in bold. The table can be downloaded with or without the confidence intervals and p-values, as an Excel file or a tab-separated file. Under the table, the Signatures line records the settings of each metric, the information another person needs to compute the same scores.
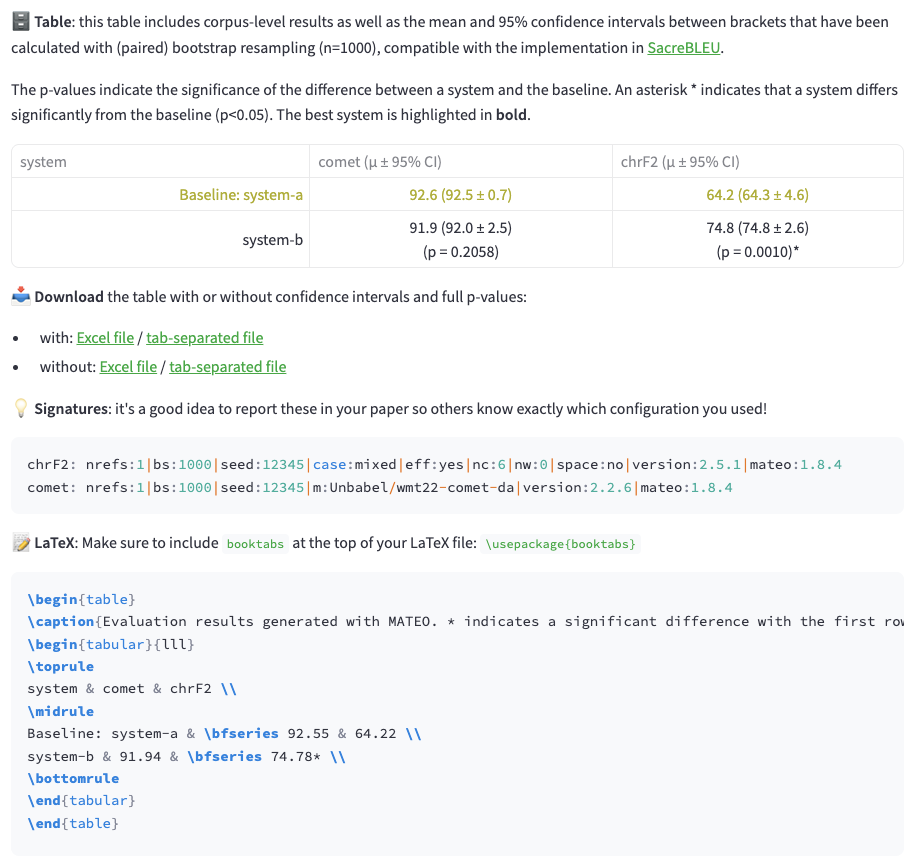
In these results, system-b, the literal translation with errors, has the higher chrF, by a significant margin, because it keeps more of the reference’s character sequences. The COMET difference between the two systems is small and not significant.
COMET appears in MATEO on a scale up to 100, which makes it look like a percentage. It is not one, and neither is any other score in the table.
Sentence by sentence
Under Evaluation results (sentences), MATEO gives a plot with one point per sentence and per system (Figure 19figure 19), and a table with the source and the reference of every sentence, followed by each system’s translation and its score, in a column named after the system (Figure 20figure 20). The table scrolls sideways to show the systems, and it can be downloaded as an Excel file, with one sheet per metric.
These scores exist only for metrics whose score for the whole text is the mean of their scores per sentence, such as COMET. BLEU and chrF are computed over the whole text at once, so MATEO gives them no score per sentence, as its note About sentence-level scores explains.
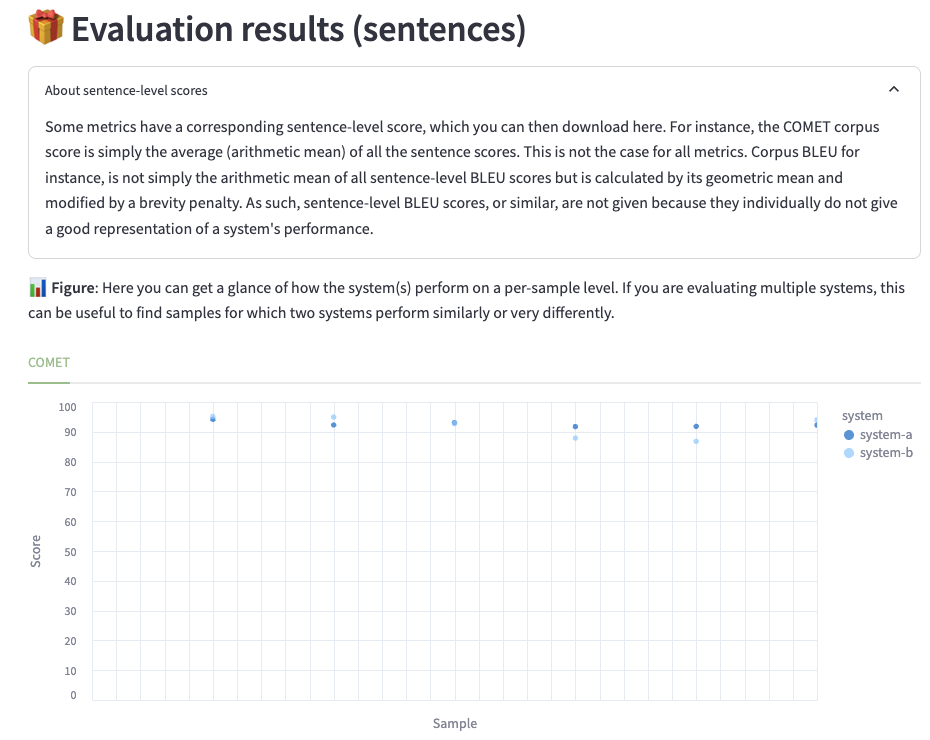
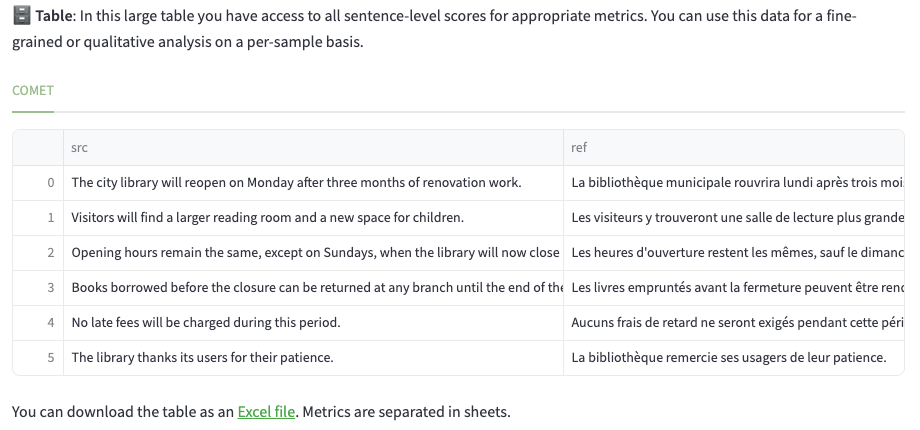
The sentences with the lowest scores, and those on which two systems are far apart, are the ones to read (see also the Reading the scores page) (voir aussi la page Lire les scores).
Writing about the scores
- Name the metric and the tool. For instance: “COMET 91.9 (model Unbabel/wmt22-comet-da, COMET 2.2.6), computed with MATEO 1.8.4”, with the Signatures line in a note. The same metric with other settings or another version gives another score (see also the BLEU page) (voir aussi la page BLEU). The metric is BERTScore, not BERT, which is one of the models BERTScore can use.
- Compare within one metric. A difference between two systems on the same metric can be read; a chrF score set against a COMET score cannot (see also the Reading the scores page) (voir aussi la page Lire les scores).
- Keep “significant” for the test. A difference is significant in the statistical sense only when the test says so, and a small difference may be noise.
- Describe what the metric does. A metric counts shared words or characters, compares vectors or predicts a human score; it does not understand the translation.
Running MATEO once
Un outil qui calcule des métriques
MATEO, pour MAchine Translation Evaluation Online, est une interface Web qui calcule les principales métriques automatiques de la traduction automatique sans aucune programmation, conçue pour les étudiants, les traducteurs et les chercheurs en sciences humaines autant que pour les spécialistes (Vanroy et al., 2023).
Chaque score que montre MATEO vient de l’une des métriques que vous sélectionnez, comme chrF ou COMET, avec l’échelle propre à cette métrique (see also the Reading the scores page) (voir aussi la page Lire les scores). MATEO ne conserve pas les fichiers que vous téléversez : ils sont traités en mémoire et supprimés une fois le traitement terminé.Selon la page d’accueil de MATEO, consultée le 13 octobre 2026.
Préparer les fichiers
MATEO compare les fichiers ligne par ligne : la ligne 1 d’une traduction est notée par rapport à la ligne 1 de la référence, et ainsi de suite. Chaque fichier doit être :
- en texte brut plain texttexte brut text encodingencodage du texte Text represented as a sequence of characters alone, with no formatting or layout of its own. A plain-text file opens in any text editor, whatever produced it, which is why interchange formats are written this way: markup languages record structure inside plain text, by writing that structure as characters in the text itself.Texte représenté par la seule suite de ses caractères, sans mise en forme ni mise en page propre. Un fichier en texte brut s'ouvre dans n'importe quel éditeur de texte, quel que soit le logiciel qui l'a produit, ce qui explique que les formats d'échange s'écrivent ainsi : les langages de balisage consignent la structure à l'intérieur du texte brut, en l'écrivant sous forme de caractères dans le texte lui-même. (
.txt), encodé en UTF-8 UTF-8UTF-8 text encodingencodage du texte A variable-length character encoding for Unicode. It represents each valid Unicode code point using a sequence of one to four bytes. Characters in the ASCII repertoire use one byte and retain the same byte values as in ASCII, which helps with compatibility. UTF-8 can represent the same Unicode repertoire as UTF-16 and UTF-32, but it does not imply that every character occupies a single byte. It is widely recommended for multilingual Web content and data exchange.Codage de caractères à longueur variable pour Unicode. Il représente chaque point de code Unicode valide au moyen d'une séquence de un à quatre octets. Les caractères du répertoire ASCII occupent un seul octet et conservent les mêmes valeurs qu'en ASCII, ce qui favorise la compatibilité. UTF-8 permet de représenter le même répertoire Unicode que UTF-16 et UTF-32, mais cela ne signifie pas que chaque caractère occupe un seul octet. Il est largement recommandé pour les contenus Web multilingues et l'échange de données. ; - à raison d’un segment segmentsegment CAT toolsTAO A portion of translatable content that a CAT tool treats as a discrete unit for translation, alignment, storage and match retrieval.Portion de contenu à traduire qu'un outil de TAO traite comme une unité distincte aux fins de traduction, d'alignement, de stockage et de recherche de correspondances. par ligne, sans ligne vide : habituellement une phrase, mais un paragraphe ou un document entier convient aussi, à condition que tous les fichiers emploient la même unité, les scores par ligne étant alors des scores par paragraphe ou par document ;
- du même nombre de lignes que les autres fichiers, de sorte que chaque ligne de chaque fichier corresponde au même segment de la source ;
- d’au plus 1 Mo.
| Fichier | Contenu | Nécessaire |
|---|---|---|
| Fichier de référence | la traduction de référence | toujours |
| Fichier source | le texte source | pour COMET ; facultatif pour les autres métriques |
| Fichier de système | la traduction à évaluer, un fichier par système | au moins un, au plus quatre par exécution |
MATEO nomme chaque système d’après son fichier, sans l’extension : un
fichier nommé deepl.txt apparaît comme deepl dans les résultats. Une
traduction copiée depuis un agent conversationnel ou une page Web ne sort
pas toujours à raison d’un segment par ligne : une ligne qui passe à la
ligne à l’écran n’est pas forcément un
saut de ligne line breaksaut de ligne text encodingencodage du texte The character that ends a line in a file, stored in it like any other and invisible on screen. It is what divides a file into lines, so a file's line count is fixed: two of them make three lines, whatever width the window is. Windows writes it as two characters, a carriage return followed by a line feed (CR LF), where macOS and Linux use one (LF).Caractère qui termine une ligne dans un fichier, enregistré comme n'importe quel autre et invisible à l'écran. C'est lui qui découpe le fichier en lignes, si bien que leur nombre est fixe : deux sauts de ligne font trois lignes, quelle que soit la largeur de la fenêtre. Windows l'écrit au moyen de deux caractères, un retour chariot suivi d'un saut de ligne (CR LF), là où macOS et Linux n'en emploient qu'un (LF). (see also the Plain text and its lines page, in the Exchange formats in translation module) (voir aussi la page Le texte brut et ses lignes, dans le module Les formats d'échange en traduction).
MATEO vérifie les fichiers au moment du téléversement. Quand un fichier manque, ou qu’il n’a pas le même nombre de lignes que la référence, un message sous les zones de téléversement le signale, et le bouton qui lance l’évaluation n’apparaît pas tant que le problème n’est pas réglé (Figure 14figure 14). Dans ce message, Reference file #1 désigne le premier fichier de système.
Lancer une évaluation
Sur la page Evaluate de MATEO :
- Choisissez les métriques sous Metric selection (Figure 15figure 15). BLEU, chrF et COMET sont cochées par défaut ; BERTScore, BLEURT et TER ne le sont pas. Chaque métrique a un panneau d’options ; les options par défaut correspondent aux réglages habituels.
- Téléversez les fichiers sous Input data (Figure 16figure 16) : la référence dans Reference file, la source dans Source file, et chaque traduction dans une zone System. Réglez d’abord How many systems do you wish to compare?, pour obtenir une zone par système ; le premier système est marqué comme système de comparaison, que MATEO appelle baseline. Chaque fichier est glissé sur sa zone ou choisi avec Browse files ; il n’est pas possible de coller du texte.
- Cliquez sur Evaluate MT. Le bouton apparaît une fois que les fichiers indiqués sous les zones sont en place : une référence, au moins un système, et une source si COMET est sélectionnée.
Quand l’évaluation présentée ici a été lancée sur six phrases avec chrF, BLEU et COMET le 13 octobre 2026, les résultats sont apparus en quelques secondes. Le site est partagé : un texte plus long, ou de nombreuses personnes qui l’emploient en même temps, demande plus de temps.
Lire les résultats
Le texte entier
Sous Evaluation results (corpus), MATEO donne un diagramme à barres et un diagramme en radar des scores (Figure 17figure 17), qui peuvent être téléchargés avec l’icône d’appareil photo qui apparaît quand le pointeur les survole, ainsi qu’un tableau avec une ligne par système et une colonne par métrique (Figure 18figure 18). Dans les captures, system-a est une traduction formulée autrement que la référence, et system-b une traduction littérale qui comporte plusieurs erreurs.
Dans le tableau, chaque case donne :
- le score de la métrique pour tout le texte, avant les parenthèses. C’est le nombre à présenter.
- entre parenthèses, une moyenne et un intervalle de confiance à 95 %, calculés en tirant 1 000 versions rééchantillonnées du texte : une plage dans laquelle le score tomberait probablement avec d’autres phrases du même genre. Il peut être laissé de côté pour une première comparaison.
- pour chaque système sauf le premier, une valeur p, avec un astérisque quand le système diffère significativement du premier, que MATEO appelle baseline et met en évidence. L’ordre dans lequel les systèmes sont téléversés décide donc du système auquel les autres sont comparés.
Le meilleur score de chaque métrique est en gras. Le tableau peut être téléchargé avec ou sans les intervalles de confiance et les valeurs p, en fichier Excel ou en fichier à valeurs séparées par des tabulations. Sous le tableau, la ligne Signatures consigne les réglages de chaque métrique, l’information dont une autre personne a besoin pour calculer les mêmes scores.
Dans ces résultats, system-b, la traduction littérale qui comporte des erreurs, a le chrF le plus élevé, avec un écart significatif, parce qu’elle reprend davantage de suites de caractères de la référence. L’écart de COMET entre les deux systèmes est faible et non significatif.
COMET apparaît dans MATEO sur une échelle allant jusqu’à 100, ce qui le fait ressembler à un pourcentage. Ce n’en est pas un, pas plus qu’aucun autre score du tableau.
Phrase par phrase
Sous Evaluation results (sentences), MATEO donne un graphique avec un point par phrase et par système (Figure 19figure 19), et un tableau avec la source et la référence de chaque phrase, suivies de la traduction de chaque système et de son score, dans une colonne qui porte le nom du système (Figure 20figure 20). Le tableau défile horizontalement pour montrer les systèmes, et il peut être téléchargé en fichier Excel, avec une feuille par métrique.
Ces scores n’existent que pour les métriques dont le score pour tout le texte est la moyenne de leurs scores par phrase, comme COMET. BLEU et chrF sont calculés sur tout le texte d’un coup : MATEO ne leur donne donc pas de score par phrase, comme l’explique sa note About sentence-level scores.
Les phrases qui obtiennent les scores les plus bas, et celles sur lesquelles deux systèmes sont très éloignés, sont celles à lire (see also the Reading the scores page) (voir aussi la page Lire les scores).
Rendre compte des scores
- Nommez la métrique et l’outil. Par exemple : « COMET 91,9 (modèle Unbabel/wmt22-comet-da, COMET 2.2.6), calculé avec MATEO 1.8.4 », avec la ligne Signatures en note. La même métrique avec d’autres réglages ou une autre version donne un autre score (see also the BLEU page) (voir aussi la page BLEU). La métrique est BERTScore, et non BERT, qui n’est que l’un des modèles que BERTScore peut employer.
- Comparez à l’intérieur d’une même métrique. Une différence entre deux systèmes sur la même métrique peut être lue ; un score chrF mis en regard d’un score COMET ne le peut pas (see also the Reading the scores page) (voir aussi la page Lire les scores).
- Réservez « significatif » au test. Une différence n’est significative au sens statistique que si le test le dit, et une petite différence peut n’être que du bruit.
- Décrivez ce que fait la métrique. Une métrique compte des mots ou des caractères partagés, compare des vecteurs ou prédit un score humain ; elle ne comprend pas la traduction.
Essayer MATEO une fois
Sources
- Vanroy, B., Tezcan, A., & Macken, L. (2023). MATEO: MAchine Translation Evaluation Online. Proceedings of the 24th Annual Conference of the European Association for Machine Translation (EAMT 2023), Tampere, 499–500. https://aclanthology.org/2023.eamt-1.52/
Sources
- Vanroy, B., Tezcan, A., & Macken, L. (2023). MATEO: MAchine Translation Evaluation Online. Proceedings of the 24th Annual Conference of the European Association for Machine Translation (EAMT 2023), Tampere, 499–500. https://aclanthology.org/2023.eamt-1.52/