Many correct translationsDe nombreuses traductions correctes
TRA6008 To read for S8À lire pour la S8
Several right answers
For systems that find or label things, such as a term extractor or a spam filter, people do not always agree on the correct answer (Basile et al., 2021). An evaluation usually settles the question with a gold standard gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. , which fixes one answer per item, and counts each answer of the system as right or wrong against it (see also the gold standard page) (voir aussi la page L'étalon de référence).
Translation shares this difficulty in a more complex form, and adds a second one, because translation means generating new text rather than selecting text or labels from a limited set:
- The correct answers cannot be listed. The terms of a text are sequences of words in that text, so a gold standard can list them (see also the Matching rules page) (voir aussi la page Les règles de correspondance). A sentence has too many correct translations to list, and a correct output rarely matches a translation made by a person word for word.
- An answer can be partly right. Even a borderline term is either on a list or not. A translated sentence contains many decisions and can be wrong in one part, slightly or seriously: awkward phrasing is not as serious as reversing the meaning.
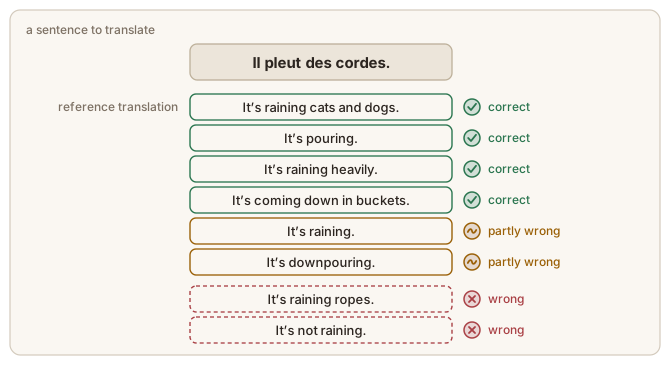
Figure 1figure 1 shows both on one French idiom: four English translations are correct and differ from each other in wording, two are partly wrong because they lose part of the meaning or are awkwardly phrased, and two are wrong.
Adequacy and fluency
Two dimensions are standard in judging a translation (Jurafsky & Martin, 2026):
- adequacy, also called fidelity: how well the translation conveys the meaning of the source;
- fluency: whether the translation is grammatical, clear and natural in the target language.
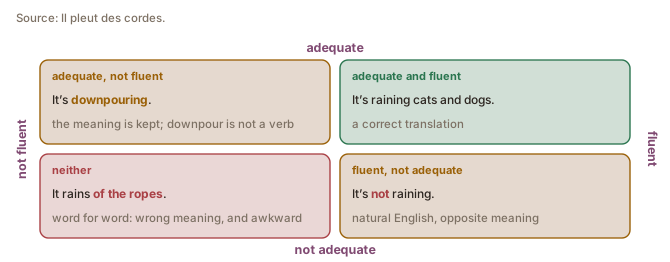
The two come apart, as Figure 2figure 2 shows on four translations of one sentence.
In professional work, style and terminology are judged as well; MQM treats them as separate error categories (Freitag et al., 2021) (see also the Human evaluation: DA, MQM and ESA page) (voir aussi la page L'évaluation humaine : DA, MQM et ESA). Raters without translation training find adequacy and fluency hard to keep apart, so human evaluations train their raters with examples (Jurafsky & Martin, 2026).
The reference translation
In machine translation, the gold standard is a reference translation: a translation of the test sentence by a professional translator, taken as one correct answer among many.
- A metric that compares an output with a reference therefore measures resemblance to one translation, and a perfect match is rare, even for a very good translation. Some evaluations give each sentence several references to soften that (Papineni et al., 2002).
- Its quality varies with who produced it, as the organizers of WMT, the Conference on Machine Translation, note of their own references (Kocmi et al., 2025) (see also the trend across editions page, in the Machine translation module) (voir aussi la page La tendance d'une édition à l'autre, dans le module Traduction automatique).
- A reference-based evaluation can penalize a correct translation, and a system that is better than the reference, for differing from it (Freitag et al., 2021).
Plusieurs bonnes réponses
Pour les systèmes qui trouvent ou étiquettent des éléments, comme un extracteur de termes ou un filtre antipourriel, les personnes ne s’accordent pas toujours sur la bonne réponse (Basile et al., 2021). Une évaluation tranche habituellement la question avec un étalon de référence gold standardétalon de référence evaluationévaluation The best available reference dataset, annotation, measurement or procedure against which a system's results are evaluated.Meilleur jeu de données, annotation, mesure ou procédure de référence disponible pour évaluer les résultats d'un système. , qui fixe une réponse par élément, et compte chaque réponse du système comme juste ou fausse par rapport à lui (see also the gold standard page) (voir aussi la page L'étalon de référence).
La traduction partage cette difficulté sous une forme plus complexe, et en ajoute une seconde, parce que traduire consiste à produire un texte nouveau plutôt qu’à choisir des passages ou des étiquettes dans un ensemble limité :
- Les bonnes réponses ne peuvent pas être énumérées. Les termes d’un texte sont des suites de mots de ce texte, si bien qu’un étalon de référence peut en dresser la liste (see also the Matching rules page) (voir aussi la page Les règles de correspondance). Une phrase a trop de traductions correctes pour qu’on les énumère, et une sortie correcte correspond rarement mot pour mot à une traduction faite par une personne.
- Une réponse peut être en partie juste. Même un terme limite figure sur une liste ou n’y figure pas. Une phrase traduite contient de nombreuses décisions et peut être fausse sur un point, légèrement ou gravement : une tournure maladroite est moins grave qu’un sens inversé.
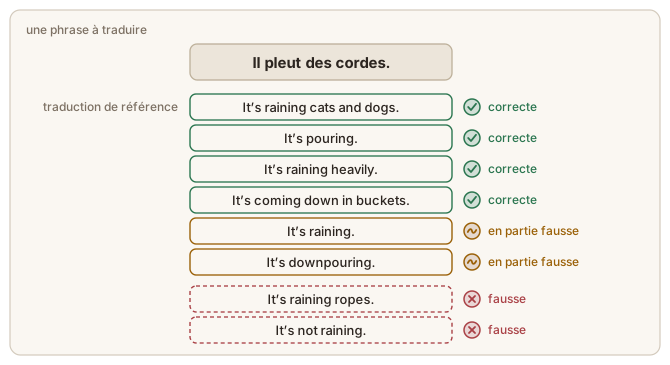
La Figure 1figure 1 montre les deux sur une expression figée française : quatre traductions anglaises sont correctes et diffèrent entre elles par leur formulation, deux sont en partie fausses parce qu’elles perdent une partie du sens ou sont maladroites, et deux sont fausses.
L’adéquation et la fluidité
Deux dimensions servent habituellement à juger une traduction (Jurafsky & Martin, 2026) :
- l’adéquation, aussi appelée fidélité : la mesure dans laquelle la traduction rend le sens de la source ;
- la fluidité : la traduction est-elle grammaticale, claire et naturelle dans la langue cible ?
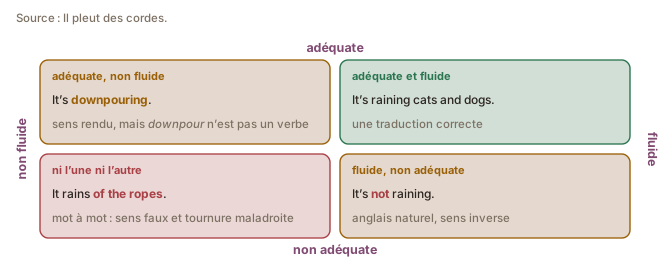
Les deux peuvent diverger, comme le montre la Figure 2figure 2 sur quatre traductions d’une même phrase.
Dans le travail professionnel, le style et la terminologie sont aussi jugés ; MQM en fait des catégories d’erreurs distinctes (Freitag et al., 2021) (see also the Human evaluation: DA, MQM and ESA page) (voir aussi la page L'évaluation humaine : DA, MQM et ESA). Les évaluateurs sans formation en traduction ont du mal à séparer l’adéquation de la fluidité, si bien que les évaluations humaines forment leurs évaluateurs à l’aide d’exemples (Jurafsky & Martin, 2026).
La traduction de référence
En traduction automatique, l’étalon de référence est une traduction de référence : une traduction de la phrase de test faite par une traductrice ou un traducteur professionnel, retenue comme une bonne réponse parmi d’autres.
- Une métrique qui compare une sortie avec une référence mesure donc la ressemblance avec une seule traduction, et une correspondance parfaite est rare, même pour une très bonne traduction. Certaines évaluations donnent plusieurs références à chaque phrase pour atténuer ce problème (Papineni et al., 2002).
- Sa qualité varie selon qui l’a produite, comme le notent les organisateurs de WMT, la Conference on Machine Translation, à propos de leurs propres références (Kocmi et al., 2025) (see also the trend across editions page, in the Machine translation module) (voir aussi la page La tendance d'une édition à l'autre, dans le module Traduction automatique).
- Une évaluation fondée sur une référence peut pénaliser une traduction correcte, et un système meilleur que la référence, parce qu’ils s’en écartent (Freitag et al., 2021).
Sources
- Basile, V., Fell, M., Fornaciari, T., Hovy, D., Paun, S., Plank, B., et al. (2021). We Need to Consider Disagreement in Evaluation. Proceedings of the 1st Workshop on Benchmarking: Past, Present and Future. https://doi.org/10.18653/v1/2021.bppf-1.3
- Freitag, M., Foster, G., Grangier, D., Ratnakar, V., Tan, Q., & Macherey, W. (2021). Experts, Errors, and Context: A Large-Scale Study of Human Evaluation for Machine Translation. Transactions of the Association for Computational Linguistics, 9, 1460–1474. https://doi.org/10.1162/tacl_a_00437
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- Kocmi, T., Artemova, E., Avramidis, E., Bawden, R., Bojar, O., Dranch, K., et al. (2025). Findings of the WMT25 General Machine Translation Shared Task: Time to Stop Evaluating on Easy Test Sets. Proceedings of the Tenth Conference on Machine Translation (WMT 2025), Volume 2: Shared Task Papers, 355–413. https://doi.org/10.18653/v1/2025.wmt-1.22
- Papineni, K., Roukos, S., Ward, T., & Zhu, W.-J. (2002). BLEU: a method for automatic evaluation of machine translation. Proceedings of the 40th Annual Meeting of the Association for Computational Linguistics (ACL 2002), Philadelphia, 311–318. https://doi.org/10.3115/1073083.1073135