Reinforcement learning: AlphaGo and move 37L'apprentissage par renforcement : AlphaGo et le coup 37
TRA6008 OptionalFacultatif
Go as a challenge for AI
Games have long been test cases for AI, chess being the best known (see also the What counts as AI? page, in the Foundations of AI & NLP module) (voir aussi la page Ce qu'on appelle « IA », dans le module Fondements de l'IA et du TAL), and Go had long been seen as the most challenging of the classic games (Silver et al., 2016). It offers far more possible moves at each turn than chess, about 250 against about 35, and its games run longer (Silver et al., 2016). No program can work through every possible continuation of a game of Go and pick the best one: it cannot brute-force its way to a good move.
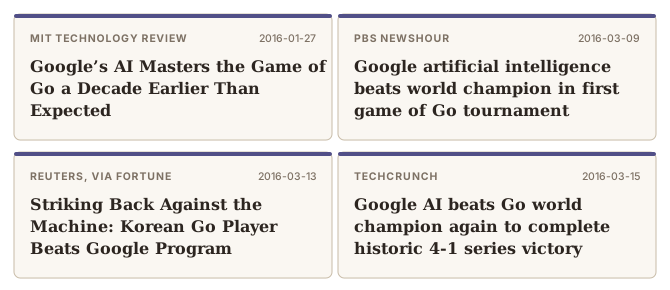
Between 2015 and 2017, Google DeepMind nonetheless built systems that played Go well, and tested them in well-publicized matches against human champions.
Learning from humans, then from itself
AlphaGo, the Go program, was trained in two stages much like a language model’s.
It began by learning from about 30 million positions from games between strong amateur players on an online Go server, predicting the move such a player would make (Silver et al., 2016). Imitation tends to cap a program near the level of the players it copies (Silver et al., 2017).
Then it played against itself, millions of times, and learned from which side won. Self-play, combined with a search through possible moves, took it past them: the program beat a professional player, Fan Hui, five games to nothing (Silver et al., 2016). Learning from a score rather than from examples is called reinforcement learning reinforcement learning (RL)apprentissage par renforcement (AR) machine learningapprentissage automatique A type of machine learning in which an agent learns how to act by receiving rewards or penalties in response to its actions, with the aim of maximizing its overall reward.Type d'apprentissage automatique dans lequel un agent apprend à agir en recevant des récompenses ou des pénalités en réponse à ses actions, avec l'objectif de maximiser sa récompense globale. (see also the Three kinds of learning page, in the Foundations of AI & NLP module) (voir aussi la page Trois types d'apprentissage, dans le module Fondements de l'IA et du TAL).
The Lee Sedol match and move 37
In March 2016 AlphaGo played Lee Sedol, one of the strongest players in the world, and won four games of five (Metz, 2016).
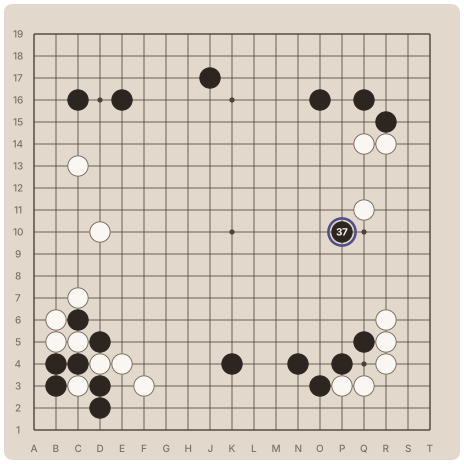
Of the match’s two commentators, one called it a very strange move and the other thought it was a mistake. It proved central to winning the game, and AlphaGo won the match about a decade before experts had expected such a win (Metz, 2016).
Learning from the rules alone
A later system, AlphaZero, was given no human games at all. It started from the rules of the game and its own play, and it ended up stronger still (Silver et al., 2018).
Le go, un défi pour l’IA
Les jeux, dont les échecs sont l’exemple le plus connu, servent depuis longtemps de terrain d’essai à l’IA (see also the What counts as AI? page, in the Foundations of AI & NLP module) (voir aussi la page Ce qu'on appelle « IA », dans le module Fondements de l'IA et du TAL), et le go était vu depuis longtemps comme le plus difficile des jeux classiques (Silver et al., 2016). Il offre bien plus de coups possibles à chaque tour que les échecs, environ 250 contre environ 35, et ses parties sont plus longues (Silver et al., 2016). Aucun programme ne peut examiner toutes les suites possibles d’une partie de go pour choisir la meilleure : il ne peut pas trouver un bon coup par la force brute.
Entre 2015 et 2017, Google DeepMind a néanmoins construit des systèmes qui jouaient bien au go, et les a mis à l’épreuve lors de matchs très médiatisés contre des champions humains.
Apprendre des humains, puis de soi-même
AlphaGo, le programme de go, a été entraîné en deux étapes, tout comme un modèle de langue.
Il a commencé par apprendre à partir d’environ 30 millions de positions tirées de parties entre de forts joueurs amateurs sur un serveur de go en ligne, en prédisant le coup qu’un tel joueur jouerait (Silver et al., 2016). L’imitation tend à plafonner un programme près du niveau des joueurs qu’il copie (Silver et al., 2017).
Puis il a joué contre lui-même, des millions de fois, et a appris de l’issue des parties. Le jeu contre lui-même, allié à une recherche parmi les coups possibles, l’a mené au-delà d’eux : le programme a battu un joueur professionnel, Fan Hui, cinq parties à zéro (Silver et al., 2016). Apprendre à partir d’un score plutôt que d’exemples, c’est l’apprentissage par renforcement reinforcement learning (RL)apprentissage par renforcement (AR) machine learningapprentissage automatique A type of machine learning in which an agent learns how to act by receiving rewards or penalties in response to its actions, with the aim of maximizing its overall reward.Type d'apprentissage automatique dans lequel un agent apprend à agir en recevant des récompenses ou des pénalités en réponse à ses actions, avec l'objectif de maximiser sa récompense globale. (see also the Three kinds of learning page, in the Foundations of AI & NLP module) (voir aussi la page Trois types d'apprentissage, dans le module Fondements de l'IA et du TAL).
Le match contre Lee Sedol et le coup 37
En mars 2016, AlphaGo a affronté Lee Sedol, l’un des plus forts joueurs du monde, et a gagné quatre parties sur cinq (Metz, 2016).
Des deux commentateurs du match, l’un a trouvé le coup très étrange et l’autre l’a pris pour une erreur. Le coup s’est révélé décisif pour gagner la partie, et AlphaGo a remporté le match une dizaine d’années avant ce qu’attendaient les experts (Metz, 2016).
Apprendre à partir des seules règles
Un système ultérieur, AlphaZero, n’a reçu aucune partie humaine. Il est parti des règles du jeu et de son propre jeu, et il a fini plus fort encore (Silver et coll., 2018).
Sources
- Akpan, N. (2016). Google artificial intelligence beats world champion in first game of Go tournament. PBS NewsHour, 9 March 2016. https://www.pbs.org/newshour/science/google-artificial-intelligence-beats-world-champion-in-first-game-of-go-tournament
- Knight, W. (2016). Google's AI Masters the Game of Go a Decade Earlier Than Expected. MIT Technology Review, 27 January 2016. https://www.technologyreview.com/2016/01/27/109178/googles-ai-masters-the-game-of-go-a-decade-earlier-than-expected/
- Metz, C. (2016). In Two Moves, AlphaGo and Lee Sedol Redefined the Future. Wired, 16 March 2016. https://www.wired.com/2016/03/two-moves-alphago-lee-sedol-redefined-future/
- Reuters (2016). Striking Back Against the Machine: Korean Go Player Beats Google Program. Fortune, 13 March 2016. https://fortune.com/2016/03/13/korean-player-beats-alphago/
- Russell, J. (2016). Google AI beats Go world champion again to complete historic 4-1 series victory. TechCrunch, 15 March 2016. https://techcrunch.com/2016/03/15/google-ai-beats-go-world-champion-again-to-complete-historic-4-1-series-victory/
- Silver, D., Huang, A., Maddison, C. J., Guez, A., Sifre, L., van den Driessche, G., et al. (2016). Mastering the game of Go with deep neural networks and tree search. Nature, 529(7587), 484–489. https://doi.org/10.1038/nature16961
- Silver, D., Hubert, T., Schrittwieser, J., Antonoglou, I., Lai, M., Guez, A., et al. (2018). A general reinforcement learning algorithm that masters chess, shogi, and Go through self-play. Science, 362(6419), 1140-1144. https://doi.org/10.1126/science.aar6404
- Silver, D., Schrittwieser, J., Simonyan, K., Antonoglou, I., Huang, A., Guez, A., et al. (2017). Mastering the game of Go without human knowledge. Nature, 550(7676), 354–359. https://doi.org/10.1038/nature24270
Sources
- Akpan, N. (2016). Google artificial intelligence beats world champion in first game of Go tournament. PBS NewsHour, 9 mars 2016. https://www.pbs.org/newshour/science/google-artificial-intelligence-beats-world-champion-in-first-game-of-go-tournament
- Knight, W. (2016). Google's AI Masters the Game of Go a Decade Earlier Than Expected. MIT Technology Review, 27 janvier 2016. https://www.technologyreview.com/2016/01/27/109178/googles-ai-masters-the-game-of-go-a-decade-earlier-than-expected/
- Metz, C. (2016). In Two Moves, AlphaGo and Lee Sedol Redefined the Future. Wired, 16 mars 2016. https://www.wired.com/2016/03/two-moves-alphago-lee-sedol-redefined-future/
- Reuters (2016). Striking Back Against the Machine: Korean Go Player Beats Google Program. Fortune, 13 mars 2016. https://fortune.com/2016/03/13/korean-player-beats-alphago/
- Russell, J. (2016). Google AI beats Go world champion again to complete historic 4-1 series victory. TechCrunch, 15 mars 2016. https://techcrunch.com/2016/03/15/google-ai-beats-go-world-champion-again-to-complete-historic-4-1-series-victory/
- Silver, D., Huang, A., Maddison, C. J., Guez, A., Sifre, L., van den Driessche, G., et al. (2016). Mastering the game of Go with deep neural networks and tree search. Nature, 529(7587), 484–489. https://doi.org/10.1038/nature16961
- Silver, D., Hubert, T., Schrittwieser, J., Antonoglou, I., Lai, M., Guez, A., et al. (2018). A general reinforcement learning algorithm that masters chess, shogi, and Go through self-play. Science, 362(6419), 1140-1144. https://doi.org/10.1126/science.aar6404
- Silver, D., Schrittwieser, J., Simonyan, K., Antonoglou, I., Huang, A., Guez, A., et al. (2017). Mastering the game of Go without human knowledge. Nature, 550(7676), 354–359. https://doi.org/10.1038/nature24270