Preference tuning: learning from rankingsLe réglage des préférences : apprendre à partir de classements
TRA6008 To read for S3À lire pour la S3
Ranking instead of writing
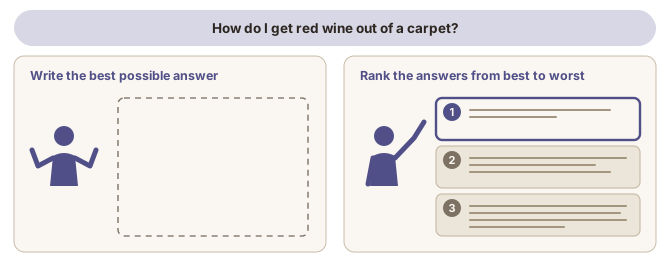
Some things about a good answer are easy to judge and hard to state. Asked whether this response or that one is better, an annotator can answer quickly; asked to write down the rule they applied, they would find it far harder.
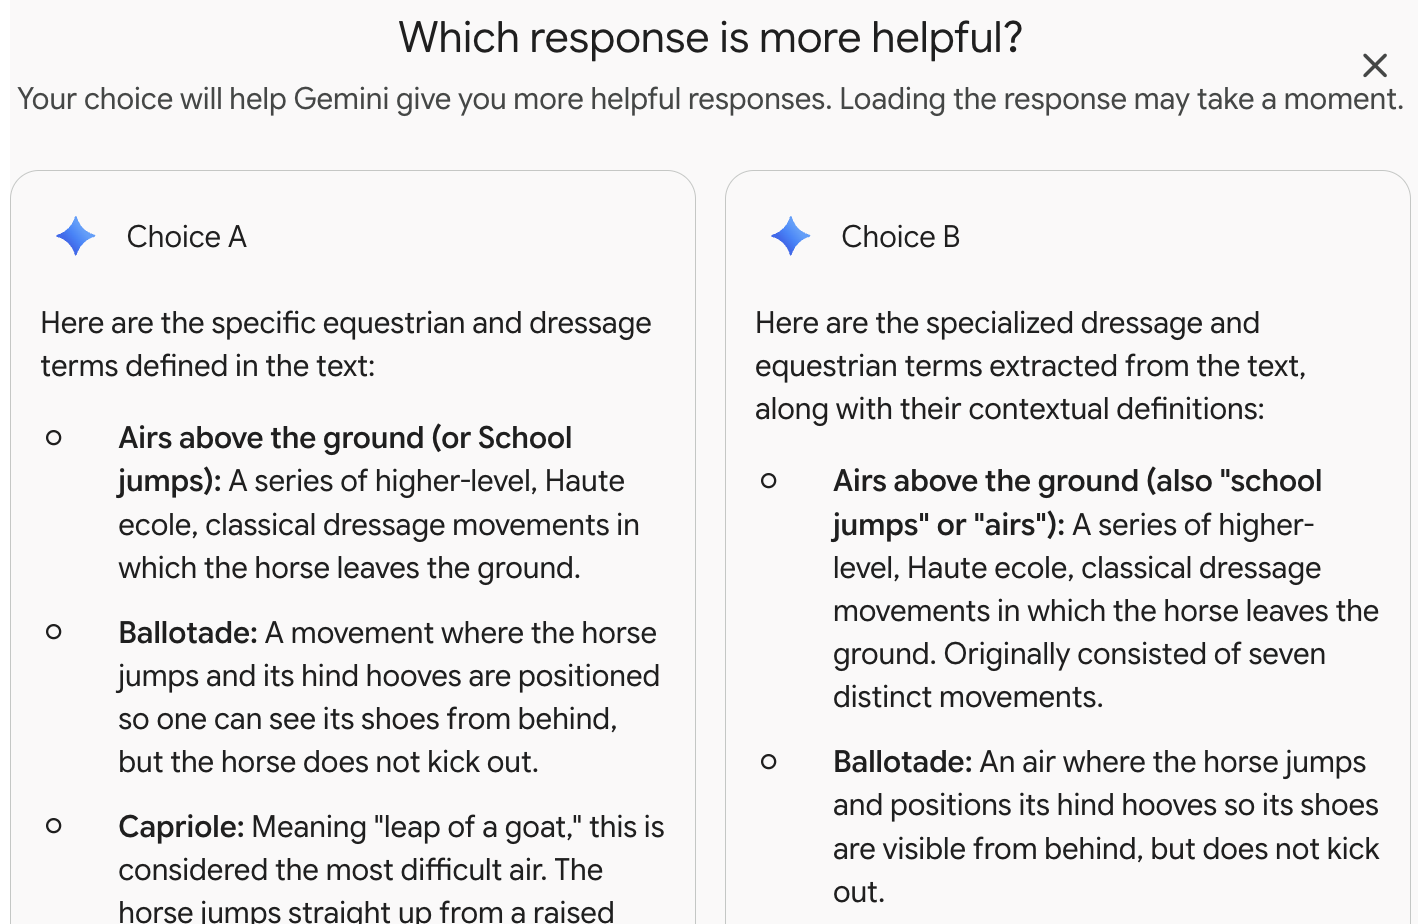
Preference tuning uses that asymmetry. Rather than asking people to produce the ideal answer, it asks them to put several of the model’s own answers in order. The rankings are not perfectly consistent: the labellers of Ouyang et al. (2022) agreed with each other on about 73% of comparisons. Each ranking is then split into pairs: four answers in order give six pairs, each made of a better and a worse answer.
The two best-known methods are reinforcement learning from human feedback (RLHF) and direct preference optimization (DPO) (Jurafsky & Martin, 2026).
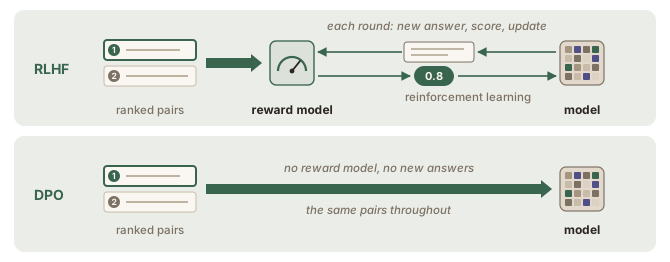
RLHF: a reward model stands in for the people
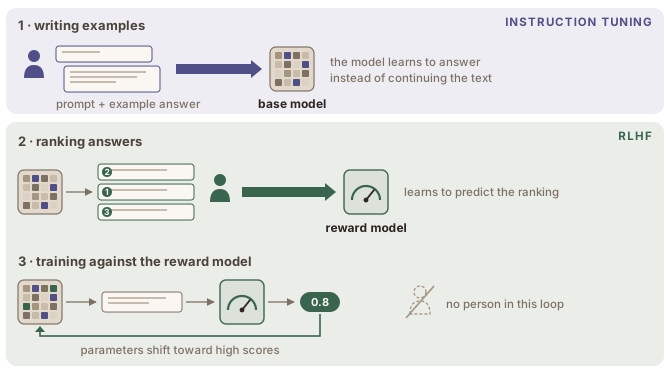
The reward model is the piece that makes the scale possible. Human rankings are slow and expensive to collect, so a separate network is trained to imitate them, and the language model is then trained against that imitation, round after round. In each round, the model writes a new answer, the reward model gives that answer a score, and the model’s parameters parameterparamètre de modèle machine learningapprentissage automatique A numerical value learned during a model's training and used in its computations.Valeur numérique apprise pendant l'entraînement d'un modèle et utilisée dans ses calculs. shift toward answers that score higher. A penalty keeps the model close to where it started: pushed too far, it learns to please the reward model rather than the people behind it (Ouyang et al., 2022).
The comparisons do not have to come from people: in a method its authors call Constitutional AI, a model compares answers for harmfulness against a written list of principles, and those comparisons, with human ones for helpfulness, train the reward model (Bai et al., 2022a).
The method predates large language models large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. : Christiano et al. (2017) trained systems from human comparisons of short behaviour clips, in a method designed for goals that are hard to write down.
DPO: learning from the ranked pairs directly
Direct preference optimization direct preference optimization (DPO)optimisation directe des préférences (DPO) language modelsmodèles de langue A preference-tuning method that trains a language model directly from pairs of preferred and rejected responses.Méthode de réglage des préférences qui entraîne un modèle de langue directement à partir de paires de réponses préférées et rejetées. (DPO) starts from the same ranked pairs but uses no reward model (Rafailov et al., 2023). The pairs are collected before training and stay the same throughout: the model writes no new answers while it learns. For each pair, its parameters are adjusted so that the preferred answer becomes more probable and the rejected one less probable.
DPO is therefore closer to supervised learning supervised (machine) learningapprentissage supervisé machine learningapprentissage automatique A form of machine learning in which a model learns from labelled examples.Forme d'apprentissage automatique dans laquelle un modèle apprend à partir d'exemples étiquetés. than to reinforcement learning (Jurafsky & Martin, 2026), but it is not supervised fine-tuning supervised fine-tuning (SFT)affinage supervisé language modelsmodèles de langue Additional training of a pretrained model on labelled examples that pair an input with a desired output, with the model's parameters adjusted to make the desired outputs more likely.Entraînement supplémentaire d'un modèle préentraîné sur des exemples étiquetés associant une entrée à une sortie souhaitée, les paramètres du modèle étant ajustés pour rendre ces sorties plus probables. : the model learns from a comparison between two answers, not from an answer to imitate.
Classer au lieu d’écrire
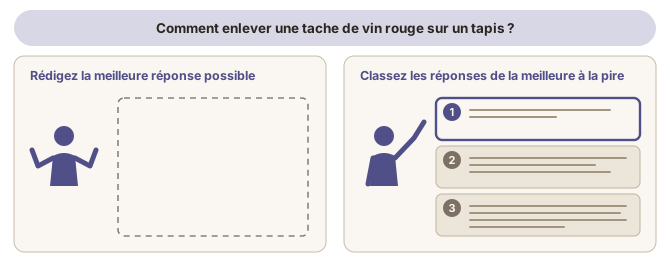
Certaines choses, dans une bonne réponse, sont faciles à juger et difficiles à énoncer. Si on lui demande si cette réponse-ci ou celle-là est meilleure, un annotateur peut répondre vite ; si on lui demande d’écrire la règle qu’il a appliquée, la tâche est bien plus difficile.
Le réglage des préférences exploite cette asymétrie. Plutôt que de demander aux gens de produire la réponse idéale, il leur demande de mettre en ordre plusieurs des réponses du modèle lui-même. Les classements ne sont pas parfaitement cohérents : les étiqueteurs d’Ouyang et al. (2022) concordaient sur environ 73 % des comparaisons. Chaque classement est ensuite découpé en paires : quatre réponses classées donnent six paires, chacune formée d’une meilleure et d’une moins bonne réponse.
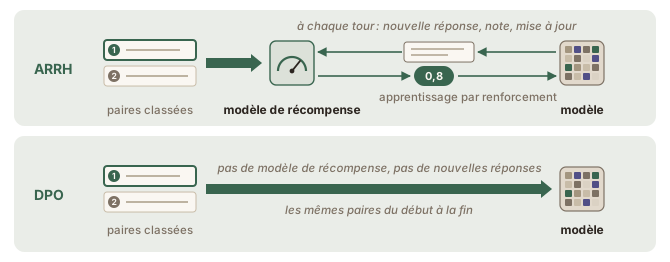
Les deux méthodes les plus connues sont l’apprentissage par renforcement avec rétroaction humaine (ARRH) et l’optimisation directe des préférences (DPO) (Jurafsky et Martin, 2026).
L’ARRH : un modèle de récompense remplace les personnes
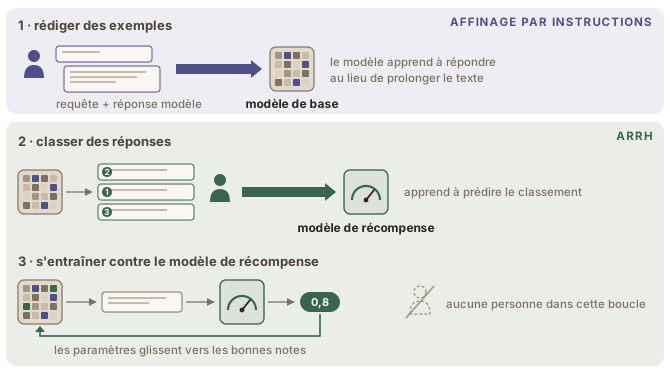
Le modèle de récompense est la pièce qui rend l’échelle possible. Les classements humains sont lents et coûteux à recueillir ; on entraîne donc un réseau distinct à les imiter, et le modèle de langue est ensuite entraîné contre cette imitation, tour après tour. À chaque tour, le modèle écrit une nouvelle réponse, le modèle de récompense attribue une note à cette réponse, et les paramètres parameterparamètre de modèle machine learningapprentissage automatique A numerical value learned during a model's training and used in its computations.Valeur numérique apprise pendant l'entraînement d'un modèle et utilisée dans ses calculs. du modèle sont ajustés en faveur des réponses les mieux notées. Une pénalité maintient le modèle près de son point de départ : poussé trop loin, il apprend à plaire au modèle de récompense plutôt qu’aux personnes derrière lui (Ouyang et al., 2022).
Les comparaisons ne viennent pas forcément de personnes : dans une méthode que ses auteurs appellent l’IA constitutionnelle, un modèle compare des réponses sur leur caractère nuisible d’après une liste écrite de principes, et ces comparaisons, avec des comparaisons humaines pour l’utilité, entraînent le modèle de récompense (Bai et al., 2022a).
La méthode est antérieure aux grands modèles de langue large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. : Christiano et al. (2017) ont entraîné des systèmes à partir de comparaisons humaines de courts extraits de comportement, par une méthode conçue pour des objectifs difficiles à formuler.
La DPO : apprendre directement des paires classées
L’optimisation directe des préférences direct preference optimization (DPO)optimisation directe des préférences (DPO) language modelsmodèles de langue A preference-tuning method that trains a language model directly from pairs of preferred and rejected responses.Méthode de réglage des préférences qui entraîne un modèle de langue directement à partir de paires de réponses préférées et rejetées. (DPO) part des mêmes paires classées, mais sans modèle de récompense (Rafailov et al., 2023). Les paires sont recueillies avant l’entraînement et restent les mêmes du début à la fin : le modèle n’écrit aucune nouvelle réponse pendant qu’il apprend. Pour chaque paire, ses paramètres sont ajustés de sorte que la réponse préférée devienne plus probable et la réponse rejetée, moins probable.
La DPO est donc plus proche de l’apprentissage supervisé supervised (machine) learningapprentissage supervisé machine learningapprentissage automatique A form of machine learning in which a model learns from labelled examples.Forme d'apprentissage automatique dans laquelle un modèle apprend à partir d'exemples étiquetés. que de l’apprentissage par renforcement (Jurafsky et Martin, 2026), sans être pour autant un affinage supervisé supervised fine-tuning (SFT)affinage supervisé language modelsmodèles de langue Additional training of a pretrained model on labelled examples that pair an input with a desired output, with the model's parameters adjusted to make the desired outputs more likely.Entraînement supplémentaire d'un modèle préentraîné sur des exemples étiquetés associant une entrée à une sortie souhaitée, les paramètres du modèle étant ajustés pour rendre ces sorties plus probables. : le modèle apprend d’une comparaison entre deux réponses, et non d’une réponse à imiter.
Sources
- Bai, Y., Kadavath, S., Kundu, S., Askell, A., Kernion, J., Jones, A., et al. (2022a). Constitutional AI: Harmlessness from AI Feedback. arXiv:2212.08073 (preprint). https://arxiv.org/abs/2212.08073
- Christiano, P. F., Leike, J., Brown, T., Martic, M., Legg, S., & Amodei, D. (2017). Deep Reinforcement Learning from Human Preferences. Advances in Neural Information Processing Systems 30 (NIPS 2017). https://proceedings.neurips.cc/paper/2017/hash/d5e2c0adad503c91f91df240d0cd4e49-Abstract.html
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- OpenAI (2025). Expanding on what we missed with sycophancy. OpenAI (blog), 2 May 2025. https://openai.com/index/expanding-on-sycophancy/
- Ouyang, L., Wu, J., Jiang, X., Almeida, D., Wainwright, C., Mishkin, P., et al. (2022). Training language models to follow instructions with human feedback. Advances in Neural Information Processing Systems 35 (NeurIPS 2022). https://proceedings.neurips.cc/paper_files/paper/2022/hash/b1efde53be364a73914f58805a001731-Abstract-Conference.html
- Rafailov, R., Sharma, A., Mitchell, E., Manning, C. D., Ermon, S., & Finn, C. (2023). Direct Preference Optimization: Your Language Model is Secretly a Reward Model. Advances in Neural Information Processing Systems 36 (NeurIPS 2023). https://proceedings.neurips.cc/paper_files/paper/2023/hash/a85b405ed65c6477a4fe8302b5e06ce7-Abstract-Conference.html
Sources
- Bai, Y., Kadavath, S., Kundu, S., Askell, A., Kernion, J., Jones, A., et al. (2022a). Constitutional AI: Harmlessness from AI Feedback. arXiv:2212.08073 (preprint). https://arxiv.org/abs/2212.08073
- Christiano, P. F., Leike, J., Brown, T., Martic, M., Legg, S., & Amodei, D. (2017). Deep Reinforcement Learning from Human Preferences. Advances in Neural Information Processing Systems 30 (NIPS 2017). https://proceedings.neurips.cc/paper/2017/hash/d5e2c0adad503c91f91df240d0cd4e49-Abstract.html
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- OpenAI (2025). Expanding on what we missed with sycophancy. OpenAI (blog), 2 mai 2025. https://openai.com/index/expanding-on-sycophancy/
- Ouyang, L., Wu, J., Jiang, X., Almeida, D., Wainwright, C., Mishkin, P., et al. (2022). Training language models to follow instructions with human feedback. Advances in Neural Information Processing Systems 35 (NeurIPS 2022). https://proceedings.neurips.cc/paper_files/paper/2022/hash/b1efde53be364a73914f58805a001731-Abstract-Conference.html
- Rafailov, R., Sharma, A., Mitchell, E., Manning, C. D., Ermon, S., & Finn, C. (2023). Direct Preference Optimization: Your Language Model is Secretly a Reward Model. Advances in Neural Information Processing Systems 36 (NeurIPS 2023). https://proceedings.neurips.cc/paper_files/paper/2023/hash/a85b405ed65c6477a4fe8302b5e06ce7-Abstract-Conference.html