The four stages from pretraining to assistantLes quatre étapes du préentraînement à l'assistant
TRA6008 To read for S3À lire pour la S3
From pretraining to deployment
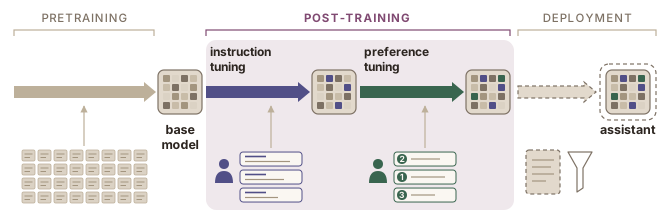
- Pretraining pre-trainingpréentraînement language modelsmodèles de langue An initial stage in which a model learns general patterns and reusable representations from a large dataset, often through self-supervised learning, before any later adaptation for particular tasks or uses.Étape initiale au cours de laquelle un modèle apprend des régularités générales et des représentations réutilisables à partir d'un grand jeu de données, souvent par apprentissage autosupervisé, avant toute adaptation ultérieure à des tâches ou à des usages particuliers. . Training on a vast amount of text, which produces the base model base modelmodèle de base language modelsmodèles de langue A language model that has completed pretraining but has not yet undergone post-training.Modèle de langue qui a terminé son préentraînement mais n'a pas encore reçu de postentraînement. : it continues text and does not reliably follow instructions.
- Instruction tuning instruction tuningaffinage par instructions language modelsmodèles de langue A form of supervised fine-tuning in which a pretrained language model is trained further on examples pairing instructions or questions with appropriate responses.Forme d'affinage supervisé dans laquelle un modèle de langue préentraîné est entraîné davantage sur des exemples associant des instructions ou des questions à des réponses appropriées. . Training on examples of instructions and good responses, so the model recognizes a request as a request.
- Preference tuning preference tuningréglage des préférences language modelsmodèles de langue A form of fine-tuning, applied in post-training, that adjusts a language model so that it becomes more likely to produce responses judged preferable and less likely to produce responses judged undesirable.Forme d'affinage, appliquée au postentraînement, qui ajuste un modèle de langue pour qu'il produise plus volontiers des réponses jugées préférables et moins volontiers des réponses jugées indésirables. . Training on judgements, usually human, of which response is better, for the qualities that are easier to recognize than to demonstrate.
- Deployment. System prompts system promptrequête générative système promptingrequêtes An instruction supplied to a language model before or alongside the user's input that establishes the model's role, task, behavioural rules, tone, or other context for the interaction.Instruction fournie à un modèle de langue avant l'entrée de l'utilisateur, ou en parallèle, qui établit le rôle du modèle, sa tâche, ses règles de conduite, son ton ou d'autres éléments de contexte pour l'interaction. , safety filters and other machinery around the model, changing nothing in its parameters (see also the Alignment page) (voir aussi la page L'alignement).
Post-training
Stages 2 and 3 are both forms of fine-tuning fine-tuningaffinage machine learningapprentissage automatique Further training of a pretrained model on new data to adapt it for a particular task, domain, or intended behaviour.Poursuite de l'entraînement d'un modèle préentraîné sur un jeu de données généralement plus restreint et spécialisé, afin de l'adapter à une tâche ou à un domaine particulier. , and together the field calls them post-training. Many current models add a third post-training stage, reinforcement learning with verifiable rewards reinforcement learning with verifiable rewards (RLVR)apprentissage par renforcement vérifiable (ARV) language modelsmodèles de langue A method for post-training a language model in which rewards are based on whether its responses satisfy criteria that can be checked automatically.Méthode de postentraînement d'un modèle de langue dans laquelle les récompenses dépendent du respect, par ses réponses, de critères vérifiables automatiquement. (Jurafsky & Martin, 2026) (see also the RLVR: learning from answers that can be checked page) (voir aussi la page L'ARV : apprendre à partir de réponses vérifiables). The two terms are not synonyms: fine-tuning is the technique, and it is also used outside post-training, for instance to adapt an existing model to one organization’s texts.
Du préentraînement au déploiement
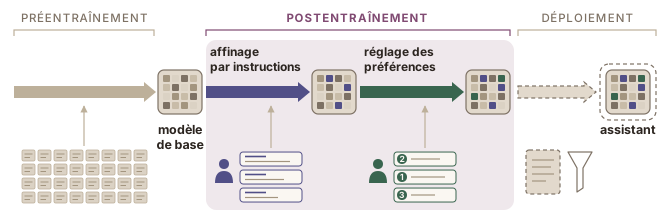
- Préentraînement pre-trainingpréentraînement language modelsmodèles de langue An initial stage in which a model learns general patterns and reusable representations from a large dataset, often through self-supervised learning, before any later adaptation for particular tasks or uses.Étape initiale au cours de laquelle un modèle apprend des régularités générales et des représentations réutilisables à partir d'un grand jeu de données, souvent par apprentissage autosupervisé, avant toute adaptation ultérieure à des tâches ou à des usages particuliers. . Un entraînement sur une très grande quantité de texte, qui produit le modèle de base base modelmodèle de base language modelsmodèles de langue A language model that has completed pretraining but has not yet undergone post-training.Modèle de langue qui a terminé son préentraînement mais n'a pas encore reçu de postentraînement. : il prolonge du texte et ne suit pas les instructions de façon fiable.
- Affinage par instructions instruction tuningaffinage par instructions language modelsmodèles de langue A form of supervised fine-tuning in which a pretrained language model is trained further on examples pairing instructions or questions with appropriate responses.Forme d'affinage supervisé dans laquelle un modèle de langue préentraîné est entraîné davantage sur des exemples associant des instructions ou des questions à des réponses appropriées. . Un entraînement sur des exemples d’instructions et de bonnes réponses, pour que le modèle reconnaisse une demande comme une demande.
- Réglage des préférences preference tuningréglage des préférences language modelsmodèles de langue A form of fine-tuning, applied in post-training, that adjusts a language model so that it becomes more likely to produce responses judged preferable and less likely to produce responses judged undesirable.Forme d'affinage, appliquée au postentraînement, qui ajuste un modèle de langue pour qu'il produise plus volontiers des réponses jugées préférables et moins volontiers des réponses jugées indésirables. . Un entraînement sur des jugements, humains le plus souvent, quant à la meilleure réponse, pour les qualités plus faciles à reconnaître qu’à montrer par l’exemple.
- Déploiement. Requêtes génératives système system promptrequête générative système promptingrequêtes An instruction supplied to a language model before or alongside the user's input that establishes the model's role, task, behavioural rules, tone, or other context for the interaction.Instruction fournie à un modèle de langue avant l'entrée de l'utilisateur, ou en parallèle, qui établit le rôle du modèle, sa tâche, ses règles de conduite, son ton ou d'autres éléments de contexte pour l'interaction. , filtres de sécurité et autres dispositifs autour du modèle, qui ne changent rien à ses paramètres (see also the Alignment page) (voir aussi la page L'alignement).
Le postentraînement
Les étapes 2 et 3 sont deux formes d’affinage fine-tuningaffinage machine learningapprentissage automatique Further training of a pretrained model on new data to adapt it for a particular task, domain, or intended behaviour.Poursuite de l'entraînement d'un modèle préentraîné sur un jeu de données généralement plus restreint et spécialisé, afin de l'adapter à une tâche ou à un domaine particulier. , que le domaine regroupe sous le nom de postentraînement. Beaucoup de modèles actuels y ajoutent une troisième étape, l’apprentissage par renforcement vérifiable reinforcement learning with verifiable rewards (RLVR)apprentissage par renforcement vérifiable (ARV) language modelsmodèles de langue A method for post-training a language model in which rewards are based on whether its responses satisfy criteria that can be checked automatically.Méthode de postentraînement d'un modèle de langue dans laquelle les récompenses dépendent du respect, par ses réponses, de critères vérifiables automatiquement. (Jurafsky et Martin, 2026) (see also the RLVR: learning from answers that can be checked page) (voir aussi la page L'ARV : apprendre à partir de réponses vérifiables). Les deux termes ne sont pas synonymes : l’affinage est la technique, et il sert aussi en dehors du postentraînement, par exemple pour adapter un modèle existant aux textes d’une organisation.
Sources
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- Ouyang, L., Wu, J., Jiang, X., Almeida, D., Wainwright, C., Mishkin, P., et al. (2022). Training language models to follow instructions with human feedback. Advances in Neural Information Processing Systems 35 (NeurIPS 2022). https://proceedings.neurips.cc/paper_files/paper/2022/hash/b1efde53be364a73914f58805a001731-Abstract-Conference.html