Instruction tuning: learning from examplesL'affinage par instructions : apprendre à partir d'exemples
TRA6008 To read for S3À lire pour la S3
Showing the model what a good answer looks like
Instruction tuning is done by giving pairs of examples: instructions and responses. One half is an instruction, the kind of thing a user would actually type, which in this context is called a prompt promptrequête promptingrequêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. . The other half is a response worth imitating.
Prompt: Explain photosynthesis to a 10-year-old.
Response: Photosynthesis is how plants make their own food using sunlight. Think of leaves as tiny factories that take in sunlight, water and air…
Training on enough of these teaches a pattern that pretraining rarely presented so consistently: an instruction is followed by a response to it. Thus, the text completion system becomes a question answering system.
Instruction tuning is one kind of supervised fine-tuning, which is itself one kind of fine-tuning. Supervised fine-tuning is also used outside assistants, to adapt a model to a task, such as translating with one organization’s terminology from its translation memory translation memory (TM)mémoire de traduction (MT) CAT toolsTAO A bilingual database of previously translated source segments and their corresponding target segments, which a translation-memory system searches to propose exact or similar matches for new source text.Base de données bilingue de segments source déjà traduits et de leurs segments cibles correspondants, dans laquelle un système de mémoire de traduction cherche des correspondances exactes ou similaires pour un nouveau texte source. .
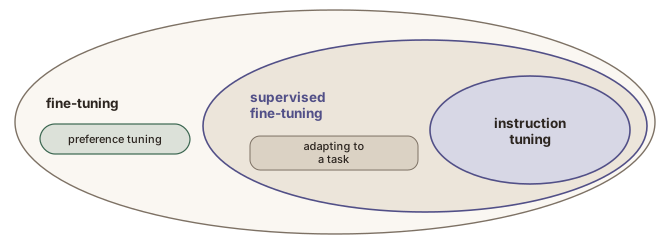
The term instruction tuning was introduced by Wei et al. (2022), who fine-tuned a pretrained model on more than 60 datasets phrased as instructions and found that it could then follow instructions for tasks it had not seen.
Small data, chosen carefully
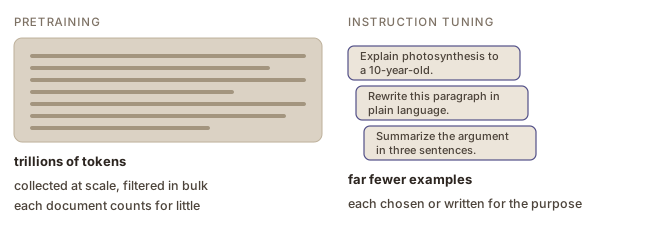
Pretraining text was written by people too, but not for this purpose, and it is filtered in bulk. Instruction-tuning examples are chosen or written for the behaviour wanted. For InstructGPT, that meant about 13 000 prompts with answers written by hired labellers (Ouyang et al., 2022). Later sets also reuse questions and answers from community sites (Zhou et al., 2023) and instructions and answers generated by a model, then filtered (Wang et al., 2023).
Quality counts for more than quantity here: a thousand carefully chosen examples can be enough: doubling their number did not improve the answers, and filtering them for quality did (Zhou et al., 2023). The authors take this as a sign that the model learns a manner rather than a subject.
Where the examples are written for the purpose, the work is often paid: Ouyang et al. (2022) recruited and screened about 40 labellers for it.
Not quite the helpful assistant chatbot yet
After this stage the model answers questions and can keep up a conversation. Its finer judgement goes only as far as its examples showed it: how long an answer should be, when to say it is unsure, when a request should be declined. Those qualities are easy to recognize in a response and hard to specify in advance.
Montrer au modèle à quoi ressemble une bonne réponse
L’affinage par instructions se fait en fournissant des paires d’exemples : des instructions et des réponses. Une moitié est une instruction, le genre de chose qu’un utilisateur taperait réellement, ce qu’on appelle dans ce contexte une requête promptrequête promptingrequêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. . L’autre moitié est une réponse digne d’être imitée.
Requête : Explique la photosynthèse à un enfant de 10 ans.
Réponse : La photosynthèse, c’est la façon dont les plantes fabriquent leur propre nourriture avec la lumière du soleil. Imagine les feuilles comme de petites usines qui captent la lumière, l’eau et l’air…
S’entraîner sur assez de ces paires enseigne une régularité que le préentraînement présentait rarement de façon aussi constante : une instruction est suivie d’une réponse. Le système qui complète du texte devient ainsi un système qui répond aux questions.
L’affinage par instructions est une sorte d’affinage supervisé, qui est lui-même une sorte d’affinage. L’affinage supervisé sert aussi en dehors des assistants, pour adapter un modèle à une tâche, comme traduire avec la terminologie d’une organisation à partir de sa mémoire de traduction translation memory (TM)mémoire de traduction (MT) CAT toolsTAO A bilingual database of previously translated source segments and their corresponding target segments, which a translation-memory system searches to propose exact or similar matches for new source text.Base de données bilingue de segments source déjà traduits et de leurs segments cibles correspondants, dans laquelle un système de mémoire de traduction cherche des correspondances exactes ou similaires pour un nouveau texte source. .
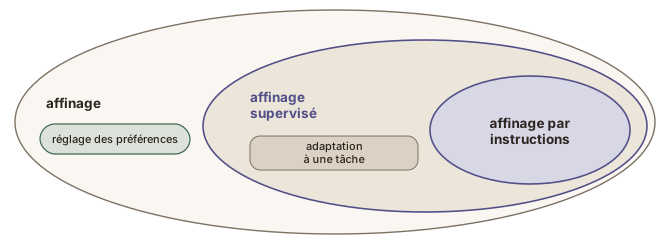
Le terme anglais instruction tuning a été introduit par Wei et al. (2022), qui ont affiné un modèle préentraîné sur plus de 60 jeux de données formulés comme des instructions et constaté qu’il pouvait ensuite suivre des instructions pour des tâches qu’il n’avait pas vues.
Peu de données, choisies avec soin
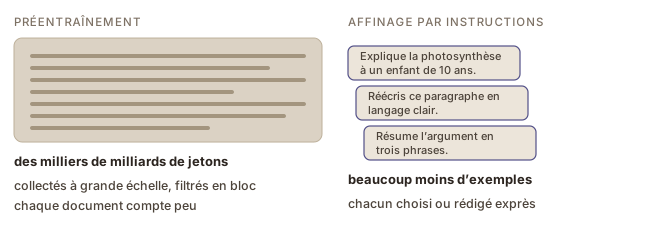
Le texte du préentraînement a lui aussi été écrit par des personnes, mais pas dans ce but, et il est filtré en bloc. Les exemples de l’affinage par instructions sont choisis ou rédigés selon le comportement recherché. Pour InstructGPT, il s’agissait d’environ 13 000 requêtes accompagnées de réponses rédigées par des étiqueteurs recrutés à cette fin (Ouyang et al., 2022). Les ensembles plus récents reprennent aussi des questions et des réponses de sites communautaires (Zhou et al., 2023) et des instructions et des réponses générées par un modèle, puis filtrées (Wang et al., 2023).
Ici, la qualité compte plus que la quantité : un millier d’exemples soigneusement choisis peut suffire. En doubler le nombre n’a pas amélioré les réponses, alors que les filtrer selon leur qualité les a améliorées (Zhou et al., 2023). Les auteurs y voient le signe que le modèle apprend une manière plutôt qu’un sujet.
Là où les exemples sont rédigés exprès, le travail est souvent rémunéré : Ouyang et coll. (2022) ont recruté et sélectionné une quarantaine d’étiqueteurs pour cette tâche.
Pas encore tout à fait l’agent conversationnel serviable
Après cette étape, le modèle répond aux questions et peut soutenir une conversation. Son jugement plus fin ne va pas plus loin que ce que ses exemples lui ont montré : quelle longueur donner à une réponse, quand dire qu’il n’est pas sûr, quand une demande devrait être refusée. Ces qualités sont faciles à reconnaître dans une réponse et difficiles à préciser d’avance.
Sources
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- Ouyang, L., Wu, J., Jiang, X., Almeida, D., Wainwright, C., Mishkin, P., et al. (2022). Training language models to follow instructions with human feedback. Advances in Neural Information Processing Systems 35 (NeurIPS 2022). https://proceedings.neurips.cc/paper_files/paper/2022/hash/b1efde53be364a73914f58805a001731-Abstract-Conference.html
- Wang, Y., Kordi, Y., Mishra, S., Liu, A., Smith, N. A., Khashabi, D., & Hajishirzi, H. (2023). Self-Instruct: Aligning Language Models with Self-Generated Instructions. Proceedings of the 61st Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 13484–13508. https://aclanthology.org/2023.acl-long.754/
- Wei, J., Bosma, M., Zhao, V. Y., Guu, K., Yu, A. W., Lester, B., Du, N., Dai, A. M., & Le, Q. V. (2022). Finetuned Language Models Are Zero-Shot Learners. International Conference on Learning Representations (ICLR 2022). https://openreview.net/forum?id=gEZrGCozdqR
- Zhou, C., Liu, P., Xu, P., Iyer, S., Sun, J., Mao, Y., et al. (2023). LIMA: Less Is More for Alignment. Advances in Neural Information Processing Systems 36 (NeurIPS 2023). https://openreview.net/forum?id=KBMOKmX2he