How a network learnsComment un réseau apprend
TRA6008 To read for S2À lire pour la S2
A toy example
Suppose we want a network that tells diamonds, squares and circles apart.Shapes are a toy task, chosen for its simplicity and easy visualization. A real network chooses among far more classes, and its input is rarely anything as tidy as a drawn shape. The loop is the same either way, which is what lets the example be this small. That already fixes the shape of its output layer: one unit per category, one for square, one for circle, one for diamond. Their scores are turned into percentages that add up to 100, so the three answers compete, and raising one lowers the others.
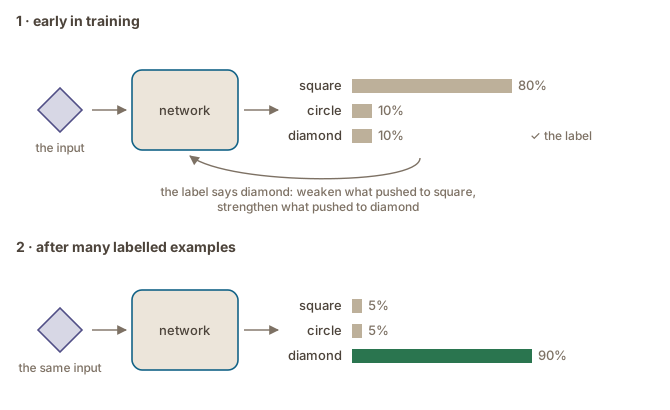
A network answers in probabilities from the start. Untrained, they are essentially random. Given a picture of a diamond and asked what shape it is, the answer might be something like: square 40%, circle 35%, diamond 25%. Early in training they can be confidently wrong instead: square 80%, circle 10%, diamond 10%. The network is then told the right answer, and the predict-compare-adjust loop of supervised learning reappears in its neural form (see also the From rules to machine learning chapter) (voir aussi le chapitre Des règles à l'apprentissage automatique): the error flows backward through the network, and the connections that pushed toward square are weakened, the ones that pushed toward diamond strengthened.
Millions of small adjustments
Adjustment is not reserved for mistakes. A network nudges its connections on every example, including the ones it already gets right; the nudge simply gets smaller as the prediction moves closer to the label. One example changes little. Millions of examples, each nudging millions of parameters parameterparamètre de modèle machine learningapprentissage automatique A numerical value learned during a model's training and used in its computations.Valeur numérique apprise pendant l'entraînement d'un modèle et utilisée dans ses calculs. , add up to a system whose predictions are sharp. Nothing else in the network changes during training: the architecture, the layers and the connections stay as designed. Learning is entirely a matter of adjusting the strengths.
The difference from a feature-based model
The decisive difference from a feature-based model is what the network learns from. A feature-based model needed a human to decide that suffixes and capitalization matter. A neural network takes raw data (e.g., pixels of an image, or numerical representations of words), and finds its own regularities in it, including ones no human would have thought to specify. The features are learned, and feature engineering disappears. The human work does not disappear with it: choosing and encoding features used to be most of the effort of building a system, and the effort now goes into collecting the data, defining the task and designing the network.
Why it took until the 2010s
Nothing about the idea is new: the underlying design goes back to the perceptron of the 1950s (Rosenblatt, 1958), the first model that could learn its own weights weightpoids machine learningapprentissage automatique A real number attached to one input of a computing unit, learned during training, that sets how much that input counts towards the unit's output.Nombre réel attaché à une entrée d'une unité de calcul, appris pendant l'entraînement, qui détermine l'importance de cette entrée dans la sortie de l'unité. from labelled examples (Goodfellow et al., 2016). In the 2010s, its two main requirements could finally be fulfilled. Learning features from raw data takes far more examples than learning weights for a few hand-picked features, and processing them takes enormous computation. Large collections of digital text and images supplied the first; graphics processors, built to render games, turned out to suit the calculations and supplied the second. With both in place, deep networks moved the state of the art in speech recognition, image recognition and object detection, and in fields as far from language as drug discovery (LeCun et al., 2015).
Un exemple jouet
Supposons que nous voulions un réseau qui distingue les losanges, les carrés et les cercles.Les formes sont une tâche jouet, choisie pour sa simplicité et sa facilité de visualisation. Un vrai réseau choisit parmi beaucoup plus de catégories, et son entrée est rarement aussi nette qu’une forme dessinée. La boucle est la même dans les deux cas, et c’est ce qui permet à l’exemple d’être aussi petit. Cela fixe déjà la forme de sa couche de sortie : une unité par catégorie, une pour carré, une pour cercle, une pour losange. Leurs scores sont transformés en pourcentages dont la somme fait 100, si bien que les trois réponses sont en concurrence : en faire monter une fait descendre les autres.
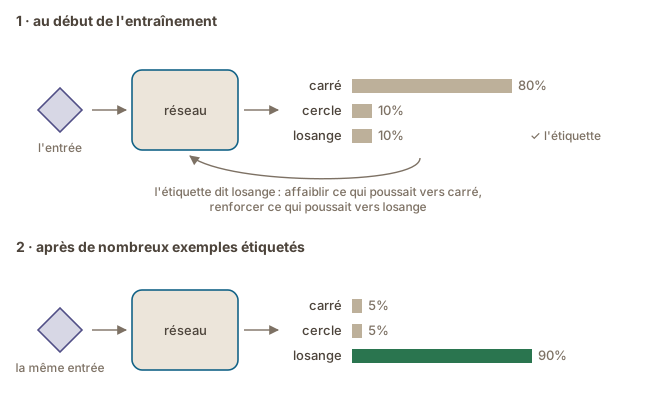
Un réseau répond en probabilités dès le départ. Sans entraînement, elles sont essentiellement aléatoires. Si on lui montre l’image d’un losange en lui demandant de quelle forme il s’agit, la réponse pourrait ressembler à ceci : carré 40 %, cercle 35 %, losange 25 %. Tôt dans l’entraînement, elles peuvent au contraire être fausses avec assurance : carré 80 %, cercle 10 %, losange 10 %. On donne ensuite la bonne réponse au réseau, et la boucle prédire, comparer, ajuster de l’apprentissage supervisé reparaît sous sa forme neuronale (see also the From rules to machine learning chapter) (voir aussi le chapitre Des règles à l'apprentissage automatique) : l’erreur remonte à travers le réseau, les connexions qui poussaient vers carré sont affaiblies, celles qui poussaient vers losange renforcées.
Des millions de petits ajustements
L’ajustement n’est pas réservé aux erreurs. Un réseau retouche ses connexions à chaque exemple, y compris ceux qu’il réussit déjà ; la retouche devient simplement plus petite à mesure que la prédiction se rapproche de l’étiquette. Un exemple change peu de chose. Des millions d’exemples, retouchant chacun des millions de paramètres parameterparamètre de modèle machine learningapprentissage automatique A numerical value learned during a model's training and used in its computations.Valeur numérique apprise pendant l'entraînement d'un modèle et utilisée dans ses calculs. , produisent un système dont les prédictions sont nettes. Rien d’autre ne change dans le réseau pendant l’entraînement : l’architecture, les couches et les connexions restent telles qu’elles ont été conçues. Apprendre revient entièrement à ajuster les forces.
La différence avec un modèle fondé sur des attributs
La différence décisive avec un modèle fondé sur des attributs tient à ce à partir de quoi le réseau apprend. Un tel modèle demandait à une personne de décider que les suffixes et les majuscules comptent. Un réseau de neurones prend des données brutes (p. ex. les pixels d’une image, ou des représentations numériques de mots) et y trouve ses propres régularités, y compris celles que personne n’aurait pensé à préciser. Les attributs sont appris, et l’ingénierie des attributs disparaît. Le travail humain ne disparaît pas pour autant : choisir et encoder les attributs constituait l’essentiel de l’effort de construction d’un système, et l’effort va désormais à la collecte des données, à la définition de la tâche et à la conception du réseau.
Pourquoi il a fallu attendre les années 2010
L’idée n’a rien de neuf : la conception de fond remonte au perceptron des années 1950 (Rosenblatt, 1958), le premier modèle capable d’apprendre lui-même ses poids weightpoids machine learningapprentissage automatique A real number attached to one input of a computing unit, learned during training, that sets how much that input counts towards the unit's output.Nombre réel attaché à une entrée d'une unité de calcul, appris pendant l'entraînement, qui détermine l'importance de cette entrée dans la sortie de l'unité. à partir d’exemples étiquetés (Goodfellow et al., 2016). Dans les années 2010, ses deux exigences principales ont enfin pu être satisfaites. Apprendre des attributs à partir de données brutes demande beaucoup plus d’exemples qu’apprendre des poids pour quelques attributs choisis à la main, et les traiter demande énormément de calcul. De grandes collections de textes et d’images numériques ont fourni la première ; les processeurs graphiques, conçus pour le rendu des jeux, se sont trouvés adaptés à ces calculs et ont fourni la seconde. Les deux réunies, les réseaux profonds ont fait progresser l’état de l’art en reconnaissance de la parole, en reconnaissance d’images et en détection d’objets, et dans des domaines aussi éloignés de la langue que la découverte de médicaments (LeCun et al., 2015).
Sources
- Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep Learning. MIT Press. https://www.deeplearningbook.org/
- LeCun, Y., Bengio, Y., & Hinton, G. (2015). Deep learning. Nature, 521(7553), 436–444. https://doi.org/10.1038/nature14539
- Rosenblatt, F. (1958). The perceptron: A probabilistic model for information storage and organization in the brain. Psychological Review, 65(6), 386-408. https://doi.org/10.1037/h0042519