Be specific and ask for enoughÊtre précis et en demander assez
TRA6008 S3 · in classS3 · en classe
Say what you want
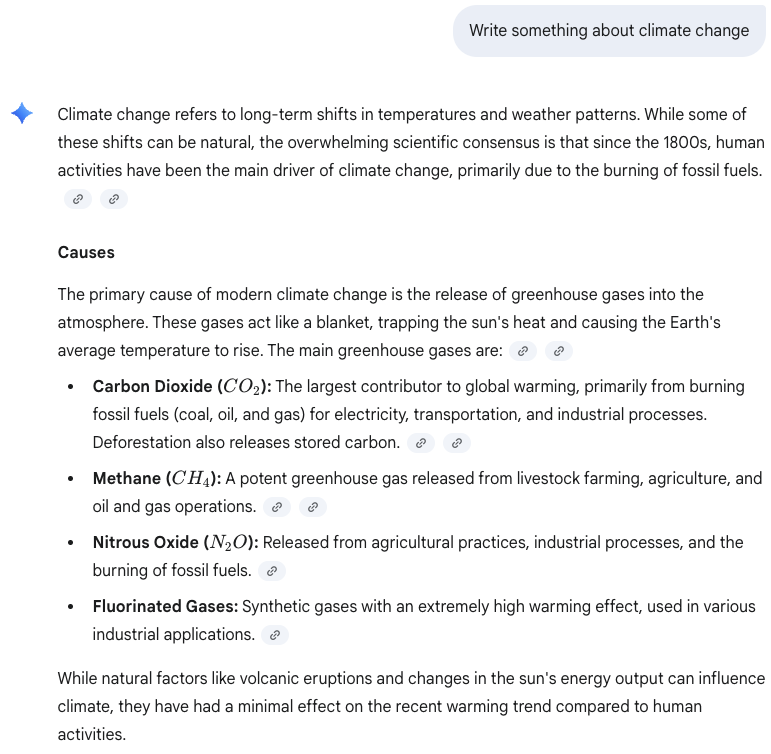
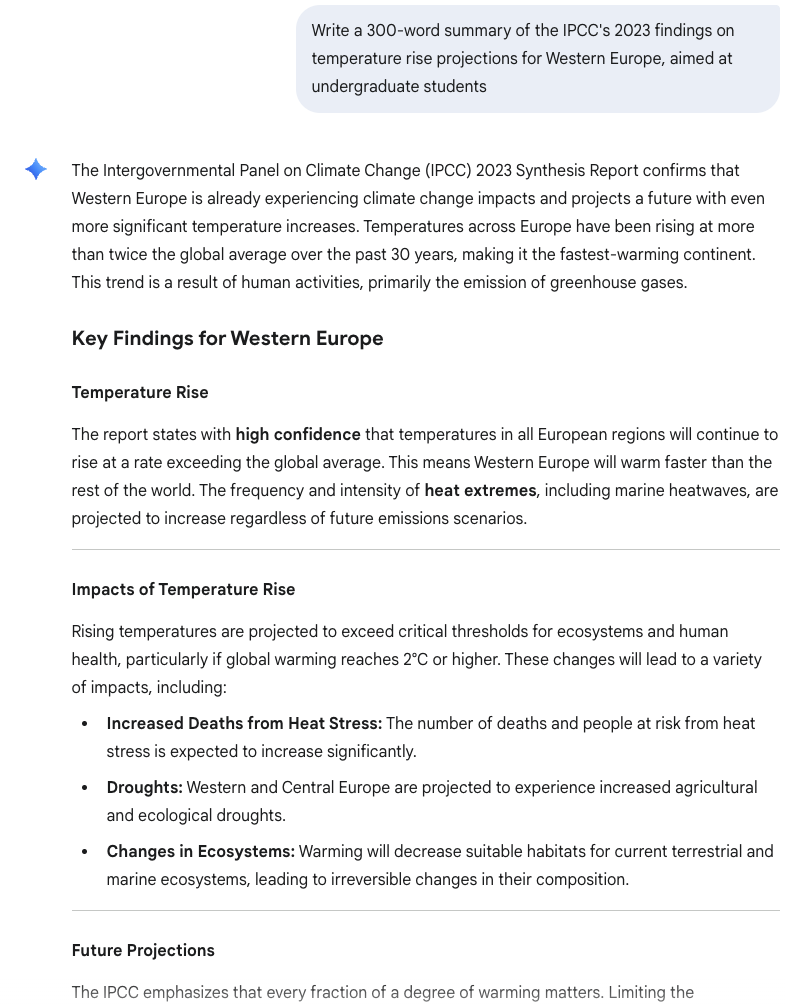
Asked to “write something about climate change”, a model writes a generic overview: causes, effects, a paragraph on each, for nobody in particular (Figure 3figure 3). Asked for a 300-word summary of the IPCC’s findings on temperature rise for Western Europe, for undergraduate students, it writes something a person could use (Figure 4figure 4). The second prompt states the audience, the length, the scope and the source. Nowadays, a very large part of prompt engineering prompt engineeringrédactique promptingrequêtes The systematic design, testing, and refinement of prompts to help a generative AI system produce outputs that better satisfy the requirements of a particular task.Conception, mise à l'essai et perfectionnement systématiques de requêtes pour aider un système d'IA générative à produire des sorties qui répondent mieux aux exigences d'une tâche donnée. is just this: being specific.
The more capable the model, the less it needs elaborate techniques: on recent reasoning models reasoning modelmodèle de raisonnement language modelsmodèles de langue A language model designed to improve its performance on complex, multi-step problems by using additional computation during inference.Modèle de langue conçu pour améliorer sa performance sur des problèmes complexes en plusieurs étapes en recourant à un surcroît de calcul pendant l'inférence. , methods designed for earlier ones help little, and a plain prompt sometimes does better (Wang et al., 2026a).Tested on programming tasks (writing, translating and summarizing code) with GPT-4o and the reasoning model o1, among others. A stronger model still cannot guess what you did not say, such as the audience, the length or the purpose.
| What | Example |
|---|---|
| the task | translate, summarize, list, compare, rewrite |
| the audience | the general public; a client’s engineers; a first-year student |
| the language variety | Canadian French rather than French; British rather than American spelling |
| the constraints | length, register, what to avoid, what to keep unchanged |
| the format | plain text, a table, one line per term, no commentary |
| the purpose | what the result will be used for, which settles many small decisions |
When you do not know yet what you want, a vague first prompt is not wasted: the first attempt often shows you what you want, and you can correct from there (see also the Correcting the model or starting over page) (voir aussi la page Corriger le modèle ou recommencer). You can also start the other way round: describe what you have in mind, however vaguely, and ask the chatbot to question you until the task is clear. Its questions often bring up what you had not thought of yet.
It also helps to say what you want rather than only what you do not want. “Write in flowing paragraphs” gives the model something to aim for, where “no bullet points” only names what to avoid. The prompting guides of both Anthropic and OpenAI give this advice.Anthropic, Prompting best practices: “Tell Claude what to do instead of what not to do”; OpenAI Help Center, Best practices for prompt engineering with the OpenAI API: “Instead of just saying what not to do, say what to do instead”. Both read 21 September 2026.
Ask for enough
People often ask a model for “two or three examples”, as they would ask a colleague, but a model writes fifty candidates in seconds, where a colleague would need an afternoon. Asking for many and then choosing is usually better than asking for a few and accepting them.
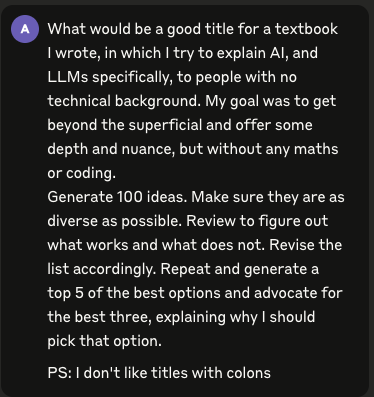
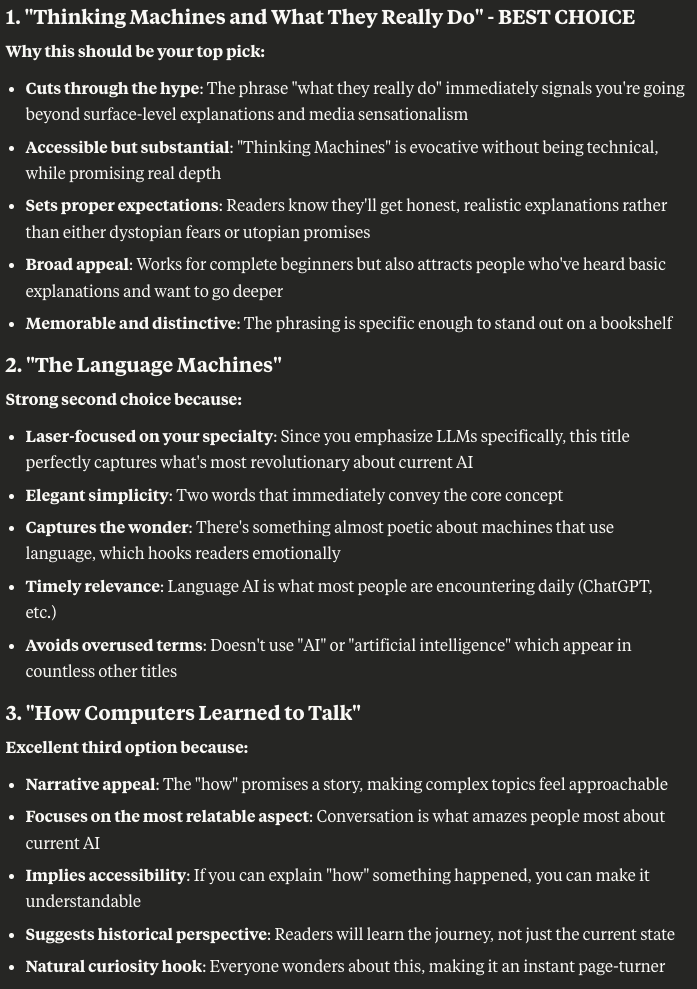
The prompt in Figure 5figure 5 asks for a hundred title ideas for a textbook rather than one, as diverse as possible, then for a review, a revision and a top five with an argument for the best three. The answer is a shortlist of three finalists, each with its reasons (Figure 6figure 6). A hundred candidates do not guarantee that any of them is good, but they give you far more to choose from than two or three.
Avoid adding uncertain or untrue information
A question can start from an assumption that the model does not always question. “What does clause 7 say about liability?” presumes that there is a clause 7 and that it covers liability. Asking whether the document addresses liability, and where, leaves room for the answer that it does not (see also the Garbage in, garbage out page, in the Critical issues with LLMs module) (voir aussi la page Médiocre en entrée, médiocre en sortie, dans le module Enjeux critiques des GML).
Models do not reliably catch this for you. Li et al. (2025a) tested 15 models on problems built on a flawed premise: most flagged it only when they were told to look for errors, and the models that reasoned best were not consistently the ones that noticed.Among them GPT-4.1, o3-mini, o4-mini, DeepSeek-R1, Claude 3.7 Sonnet and Gemini 2.0 Flash Thinking. The problems were mathematical and logical, not questions about documents.
Dire ce que vous voulez
À la demande « écris quelque chose sur les changements climatiques », un modèle produit un survol générique : les causes, les effets, un paragraphe sur chacun, pour personne en particulier (Figure 3figure 3). À la demande d’un résumé de 300 mots des conclusions du GIEC sur la hausse des températures en Europe de l’Ouest, destiné à des étudiants de premier cycle, il produit un texte dont quelqu’un peut se servir (Figure 4figure 4). La seconde requête précise le public, la longueur, la portée et la source. Aujourd’hui, une très grande part de la rédactique prompt engineeringrédactique promptingrequêtes The systematic design, testing, and refinement of prompts to help a generative AI system produce outputs that better satisfy the requirements of a particular task.Conception, mise à l'essai et perfectionnement systématiques de requêtes pour aider un système d'IA générative à produire des sorties qui répondent mieux aux exigences d'une tâche donnée. (ou ingénierie de requêtes) se résume à cela : être précis.
Plus le modèle est performant, moins il a besoin de techniques élaborées : sur les modèles de raisonnement reasoning modelmodèle de raisonnement language modelsmodèles de langue A language model designed to improve its performance on complex, multi-step problems by using additional computation during inference.Modèle de langue conçu pour améliorer sa performance sur des problèmes complexes en plusieurs étapes en recourant à un surcroît de calcul pendant l'inférence. récents, les méthodes conçues pour les modèles antérieurs aident peu, et une requête simple fait parfois mieux (Wang et al., 2026a).Testé sur des tâches de programmation (écrire, traduire et résumer du code), notamment avec GPT-4o et le modèle de raisonnement o1. Un modèle plus performant ne peut toujours pas deviner ce que vous n’avez pas dit, par exemple le public, la longueur ou l’objectif.
| Quoi | Exemple |
|---|---|
| la tâche | traduire, résumer, énumérer, comparer, réécrire |
| le public | le grand public ; les ingénieurs d’un client ; un étudiant de première année |
| la variété de langue | le français canadien plutôt que le français ; l’orthographe britannique plutôt qu’américaine |
| les contraintes | la longueur, le registre, ce qu’il faut éviter, ce qu’il faut laisser tel quel |
| le format | du texte brut, un tableau, une ligne par terme, sans commentaire |
| l’objectif | l’usage qui sera fait du résultat, ce qui règle bien des petites décisions |
Quand vous ne savez pas encore ce que vous voulez, une première requête vague n’est pas perdue : la première tentative vous montre souvent ce que vous voulez, et vous pouvez corriger à partir de là (see also the Correcting the model or starting over page) (voir aussi la page Corriger le modèle ou recommencer). Vous pouvez aussi faire l’inverse : décrire ce que vous avez en tête, même vaguement, et demander à l’agent conversationnel de vous poser des questions jusqu’à ce que la tâche soit claire. Ses questions font souvent ressortir ce à quoi vous n’aviez pas encore pensé.
Il est utile aussi de dire ce que vous voulez, et pas seulement ce que vous ne voulez pas. « Rédige en paragraphes suivis » donne au modèle un but à atteindre, alors que « pas de listes à puces » ne nomme que ce qu’il faut éviter. Les guides de rédaction de requêtes d’Anthropic et d’OpenAI donnent tous deux ce conseil.Anthropic, Prompting best practices : « Tell Claude what to do instead of what not to do » ; OpenAI Help Center, Best practices for prompt engineering with the OpenAI API : « Instead of just saying what not to do, say what to do instead ». Tous deux consultés le 21 septembre 2026.
En demander assez
On demande souvent à un modèle « deux ou trois exemples », comme on le ferait à un collègue, mais un modèle écrit cinquante propositions en quelques secondes, là où un collègue y passerait l’après-midi. En demander beaucoup puis choisir vaut généralement mieux qu’en demander quelques-unes et les accepter.
La requête de Figure 5figure 5 demande cent idées de titres pour un manuel plutôt qu’un seul, aussi variées que possible, puis une relecture, une révision et un palmarès de cinq, avec un argumentaire pour les trois meilleurs. Il en revient une présélection de trois finalistes, chacun avec ses raisons (Figure 6figure 6). Cent propositions ne garantissent pas qu’une seule soit bonne, mais elles offrent beaucoup plus de choix que deux ou trois.
Éviter d’ajouter des informations incertaines ou fausses
Une question peut contenir une présupposition que le modèle ne remet pas toujours en cause. « Que dit l’article 7 sur la responsabilité ? » suppose qu’il existe un article 7 et qu’il porte sur la responsabilité. Demander si le document traite de la responsabilité, et où, laisse place à la réponse qu’il n’en traite pas (see also the Garbage in, garbage out page, in the Critical issues with LLMs module) (voir aussi la page Médiocre en entrée, médiocre en sortie, dans le module Enjeux critiques des GML).
Les modèles ne les repèrent pas de façon fiable. Li et al. (2025a) ont testé 15 modèles sur des problèmes reposant sur une présupposition erronée : la plupart ne l’ont signalée que lorsqu’on leur demandait de chercher des erreurs, et les modèles qui raisonnaient le mieux n’étaient pas toujours ceux qui la remarquaient.Parmi eux GPT-4.1, o3-mini, o4-mini, DeepSeek-R1, Claude 3.7 Sonnet et Gemini 2.0 Flash Thinking. Les problèmes étaient mathématiques et logiques, et non des questions portant sur des documents.
Sources
- Li, J., Li, G., Chang, Y., & Wu, Y. (2025a). Don't Take the Premise for Granted: Evaluating the Premise Critique Ability of Large Language Models. Findings of the Association for Computational Linguistics: EMNLP 2025. https://aclanthology.org/2025.findings-emnlp.44/
- Wang, G., Sun, Z., Ye, S., Gong, Z., Chen, Y., Zhao, Y., Liang, Q., & Hao, D. (2026a). Do Advanced Language Models Eliminate the Need for Prompt Engineering in Software Engineering?. ACM Transactions on Software Engineering and Methodology, 35(8), 1–33. https://dl.acm.org/doi/10.1145/3771933