Learning the positions from text
Mikolov et al. (2013a) published word2vec, a pair of architectures
that put the distributional
hypothesis distributional hypothesis hypothèse distributionnelle embeddings plongements The linguistic hypothesis that patterns of word use provide evidence about meaning: words that occur with similar neighbouring words are likely to have related or similar meanings. Hypothèse linguistique selon laquelle les régularités d'emploi des mots renseignent sur leur sens : les mots qui apparaissent avec des voisins semblables ont vraisemblablement des sens apparentés ou proches. to work at scale. Each word starts
with a vector of a few hundred numbers, and those numbers are then adjusted on
millions of sentences, nudging words toward each other whenever they occur in
similar contexts. The method spread because it was efficient:
high-quality vectors from 1.6 billion words in under a day, where earlier
neural approaches cost far more. Related methods followed, GloVe among them
(Pennington et al., 2014), and the family became the standard representation
of words. Every word in the vocabulary vocabulary vocabulaire language models modèles de langue The fixed set of tokens that a tokenizer and language model can recognize and represent. Ensemble fixe des jetons qu'un segmenteur et un modèle de langue peuvent reconnaître et représenter. ends up with a vector, and all of them
together make one embedding space.
embeddings plongements Definition Définition · word embedding plongement lexical · fr: plongement lexical · en : word embedding
A learned numerical representation of a word as a short, dense vector, meaning a list of numbers. Représentation numérique apprise d'un mot sous la forme d'un vecteur dense et court, c'est-à-dire une liste de nombres. (Jurafsky & Martin, 2026, pp. 127–148 ; Mikolov et al., 2013b )
Notes Remarques The numbers are learned from patterns in language data rather than assigned manually, and their individual meanings are usually not interpretable. Words that occur in similar linguistic contexts generally receive similar vectors, allowing a system to compare words mathematically and recognize relationships in meaning or grammatical use. Word embeddings can therefore serve as inputs to tasks such as text classification, translation and language generation. In traditional static embedding methods such as word2vec and GloVe, each word type has a single fixed vector, so different senses of a polysemous word share the same representation. Modern language models instead create contextual embeddings for individual token occurrences, so the representation can change according to the surrounding text. Les formes « plongement lexical » et « plongement de mots » sont toutes deux d'usage courant. Les nombres sont appris à partir de régularités dans des données langagières plutôt qu'attribués à la main, et leur signification individuelle n'est généralement pas interprétable. Les mots qui apparaissent dans des contextes linguistiques semblables reçoivent en général des vecteurs semblables, ce qui permet de comparer les mots mathématiquement et de reconnaître des relations de sens ou d'usage grammatical. Les plongements lexicaux peuvent ainsi servir d'entrées à des tâches comme la classification de textes, la traduction et la génération de langue. Dans les méthodes statiques traditionnelles comme word2vec et GloVe, chaque type de mot possède un unique vecteur fixe, si bien que les différents sens d'un mot polysémique partagent la même représentation. Les modèles de langue modernes créent plutôt des plongements contextuels pour chaque occurrence de jeton, de sorte que la représentation peut varier selon le texte environnant.
Other attested French terms: plongement de mots, vecteur-mot, vectorisation de mots Autres termes français attestés : plongement de mots, vecteur-mot, vectorisation de mots
embeddings plongements Definition Définition · embedding space espace de plongement · fr: espace de plongement · en : embedding space
A vector space into which an embedding method maps items such as words, sentences, documents, or images. Espace vectoriel dans lequel une méthode de plongement projette des éléments comme des mots, des phrases, des documents ou des images. (Raschka, 2024 )
Notes Remarques Each item is represented by a vector, and the geometry of the space is constructed or learned so that proximity or other geometric relationships reflect patterns useful for the intended task. Chaque élément est représenté par un vecteur, et la géométrie de l'espace est construite ou apprise de sorte que la proximité ou d'autres relations géométriques reflètent des régularités utiles pour la tâche visée.
Other attested French terms: espace de plongement vectoriel Autres termes français attestés : espace de plongement vectoriel
Short, dense, and distances that mean something
Every property of these vectors contrasts with the one-hot representation:
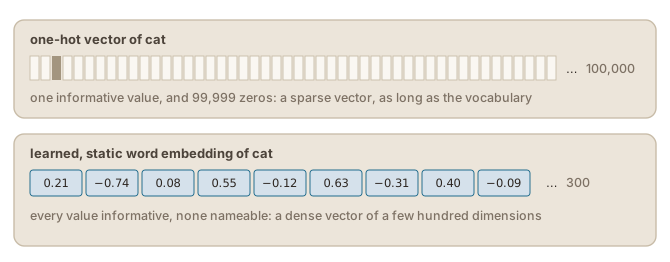
Short instead of vocabulary-sized. Typically 100 to 300 dimensions rather
than one per word.Dense instead of sparse. Every position has a meaningful value rather
than a zero.Distance means something. Cat and dog end up close, snake farther,
democracy elsewhere entirely, because their contexts imposed it
during training.
Figure 4. The same word in the two representations. The learned vector is short and dense, and no single one of its values can be read on its own.
machine learning apprentissage automatique Definition Définition · dense vector vecteur dense · fr: vecteur dense · en : dense vector
A vector in which most or all components are non-zero real numbers. Vecteur dont la plupart des composantes, ou toutes, sont des nombres réels non nuls. (Jurafsky & Martin, 2026, p. 136 )
Notes Remarques In natural language processing, dense vectors are often relatively short, learned representations of words or other tokens. Their individual dimensions usually have no obvious interpretation, but the vector as a whole can represent useful similarities between items. En traitement automatique de la langue, les vecteurs denses sont souvent des représentations apprises, relativement courtes, de mots ou d'autres jetons. Leurs dimensions n'ont généralement pas d'interprétation évidente, mais le vecteur dans son ensemble peut représenter des similarités utiles entre éléments.
No readable axes
The example with our means of transport showed axes that were interpretable:
speed and capacity. The learned dimensions are not. They do not correspond to
any nameable property, and looking at one value tells you nothing. In this
representation a word’s meaning is the whole pattern of all its values
together, and only comparisons between whole vectors are meaningful.
machine learning apprentissage automatique Definition Définition · distributed representation représentation répartie · fr: représentation répartie · en : distributed representation
A way of representing an item as a pattern of values spread over many units or dimensions, a vector for example, where each unit also takes part in representing other items. Façon de représenter un élément par un motif de valeurs réparti sur de nombreuses unités ou dimensions, un vecteur par exemple, où chaque unité participe aussi à la représentation d'autres éléments. (Goodfellow et al., 2016 )
Notes Remarques The opposite is a local representation, where one unit stands for one item and for nothing else. A one-hot vector is exactly that, so it is not a distributed representation: one position carries the word, that position carries nothing else, and every other position is a zero. A word embedding is one: the word becomes a pattern across a few hundred values, each of which also takes part in the pattern of every other word, so no dimension can be read on its own and only whole vectors can be compared. Son contraire est la représentation locale, où une unité représente un seul élément et rien d'autre. Le vecteur 1 parmi n en est un cas, et n'est donc pas une représentation répartie : une position porte le mot, elle ne porte rien d'autre et toutes les autres valent zéro. Le plongement lexical en est une : le mot devient un motif réparti sur quelques centaines de valeurs, dont chacune participe aussi au motif de tous les autres mots, de sorte qu'aucune dimension ne se lit isolément et que seuls des vecteurs entiers se comparent.
Written in English. The French version was automatically generated
and I have not revised it.
Rédigé en anglais. La version française a été
générée automatiquement et je ne l'ai pas révisée.
Updated 2 October 2026
Apprendre les positions à partir des textes
Mikolov et al. (2013a) publient word2vec, une paire d’architectures
qui mettent l’hypothèse
distributionnelle distributional hypothesis hypothèse distributionnelle embeddings plongements The linguistic hypothesis that patterns of word use provide evidence about meaning: words that occur with similar neighbouring words are likely to have related or similar meanings. Hypothèse linguistique selon laquelle les régularités d'emploi des mots renseignent sur leur sens : les mots qui apparaissent avec des voisins semblables ont vraisemblablement des sens apparentés ou proches. au travail à grande échelle.
Chaque mot part d’un vecteur de quelques centaines de nombres, et ces nombres
sont ensuite ajustés sur des millions de phrases, rapprochant les mots chaque
fois qu’ils apparaissent dans des contextes semblables. La méthode s’est
répandue parce qu’elle était efficace : des vecteurs de qualité obtenus à
partir de 1,6 milliard de mots en moins d’une journée, là où les approches
neuronales antérieures coûtaient bien davantage. D’autres méthodes ont suivi,
dont GloVe (Pennington et al., 2014), et cette famille est devenue la
représentation standard des mots. Chaque mot du
vocabulaire vocabulary vocabulaire language models modèles de langue The fixed set of tokens that a tokenizer and language model can recognize and represent. Ensemble fixe des jetons qu'un segmenteur et un modèle de langue peuvent reconnaître et représenter. se retrouve avec un vecteur, et tous
ensemble forment un espace de plongement.
embeddings plongements Definition Définition · word embedding plongement lexical · fr: plongement lexical · en : word embedding
A learned numerical representation of a word as a short, dense vector, meaning a list of numbers. Représentation numérique apprise d'un mot sous la forme d'un vecteur dense et court, c'est-à-dire une liste de nombres. (Jurafsky & Martin, 2026, pp. 127–148 ; Mikolov et al., 2013b )
Notes Remarques The numbers are learned from patterns in language data rather than assigned manually, and their individual meanings are usually not interpretable. Words that occur in similar linguistic contexts generally receive similar vectors, allowing a system to compare words mathematically and recognize relationships in meaning or grammatical use. Word embeddings can therefore serve as inputs to tasks such as text classification, translation and language generation. In traditional static embedding methods such as word2vec and GloVe, each word type has a single fixed vector, so different senses of a polysemous word share the same representation. Modern language models instead create contextual embeddings for individual token occurrences, so the representation can change according to the surrounding text. Les formes « plongement lexical » et « plongement de mots » sont toutes deux d'usage courant. Les nombres sont appris à partir de régularités dans des données langagières plutôt qu'attribués à la main, et leur signification individuelle n'est généralement pas interprétable. Les mots qui apparaissent dans des contextes linguistiques semblables reçoivent en général des vecteurs semblables, ce qui permet de comparer les mots mathématiquement et de reconnaître des relations de sens ou d'usage grammatical. Les plongements lexicaux peuvent ainsi servir d'entrées à des tâches comme la classification de textes, la traduction et la génération de langue. Dans les méthodes statiques traditionnelles comme word2vec et GloVe, chaque type de mot possède un unique vecteur fixe, si bien que les différents sens d'un mot polysémique partagent la même représentation. Les modèles de langue modernes créent plutôt des plongements contextuels pour chaque occurrence de jeton, de sorte que la représentation peut varier selon le texte environnant.
Other attested French terms: plongement de mots, vecteur-mot, vectorisation de mots Autres termes français attestés : plongement de mots, vecteur-mot, vectorisation de mots
embeddings plongements Definition Définition · embedding space espace de plongement · fr: espace de plongement · en : embedding space
A vector space into which an embedding method maps items such as words, sentences, documents, or images. Espace vectoriel dans lequel une méthode de plongement projette des éléments comme des mots, des phrases, des documents ou des images. (Raschka, 2024 )
Notes Remarques Each item is represented by a vector, and the geometry of the space is constructed or learned so that proximity or other geometric relationships reflect patterns useful for the intended task. Chaque élément est représenté par un vecteur, et la géométrie de l'espace est construite ou apprise de sorte que la proximité ou d'autres relations géométriques reflètent des régularités utiles pour la tâche visée.
Other attested French terms: espace de plongement vectoriel Autres termes français attestés : espace de plongement vectoriel
Court, dense, et des distances qui veulent dire quelque chose
Chaque propriété de ces vecteurs contraste avec la représentation 1 parmi n :
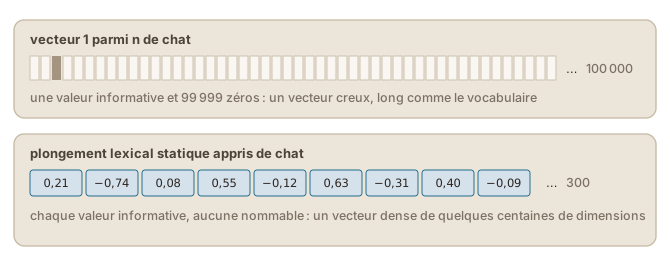
Court plutôt que long comme le vocabulaire. Typiquement de 100 à 300
dimensions, plutôt qu’une par mot.Dense plutôt que creux. Chaque position porte une valeur informative
plutôt qu’un zéro.La distance veut dire quelque chose. Chat et chien se retrouvent
proches, serpent plus loin, démocratie tout à fait ailleurs, parce que
leurs contextes l’ont imposé pendant l’entraînement.
Figure 4. Le même mot dans les deux représentations. Le vecteur appris est court et dense, et aucune de ses valeurs ne se lit isolément.
machine learning apprentissage automatique Definition Définition · dense vector vecteur dense · fr: vecteur dense · en : dense vector
A vector in which most or all components are non-zero real numbers. Vecteur dont la plupart des composantes, ou toutes, sont des nombres réels non nuls. (Jurafsky & Martin, 2026, p. 136 )
Notes Remarques In natural language processing, dense vectors are often relatively short, learned representations of words or other tokens. Their individual dimensions usually have no obvious interpretation, but the vector as a whole can represent useful similarities between items. En traitement automatique de la langue, les vecteurs denses sont souvent des représentations apprises, relativement courtes, de mots ou d'autres jetons. Leurs dimensions n'ont généralement pas d'interprétation évidente, mais le vecteur dans son ensemble peut représenter des similarités utiles entre éléments.
Des axes illisibles
L’exemple des moyens de transport montrait des axes interprétables : la vitesse
et le nombre de passagers. Les dimensions apprises ne le sont pas. Elles ne
correspondent à aucune propriété nommable, et regarder une seule valeur ne dit
rien. Dans cette représentation, le sens d’un mot est le motif complet de
toutes ses valeurs prises ensemble, et seules les comparaisons entre vecteurs
entiers ont un sens.
machine learning apprentissage automatique Definition Définition · distributed representation représentation répartie · fr: représentation répartie · en : distributed representation
A way of representing an item as a pattern of values spread over many units or dimensions, a vector for example, where each unit also takes part in representing other items. Façon de représenter un élément par un motif de valeurs réparti sur de nombreuses unités ou dimensions, un vecteur par exemple, où chaque unité participe aussi à la représentation d'autres éléments. (Goodfellow et al., 2016 )
Notes Remarques The opposite is a local representation, where one unit stands for one item and for nothing else. A one-hot vector is exactly that, so it is not a distributed representation: one position carries the word, that position carries nothing else, and every other position is a zero. A word embedding is one: the word becomes a pattern across a few hundred values, each of which also takes part in the pattern of every other word, so no dimension can be read on its own and only whole vectors can be compared. Son contraire est la représentation locale, où une unité représente un seul élément et rien d'autre. Le vecteur 1 parmi n en est un cas, et n'est donc pas une représentation répartie : une position porte le mot, elle ne porte rien d'autre et toutes les autres valent zéro. Le plongement lexical en est une : le mot devient un motif réparti sur quelques centaines de valeurs, dont chacune participe aussi au motif de tous les autres mots, de sorte qu'aucune dimension ne se lit isolément et que seuls des vecteurs entiers se comparent.
Written in English. The French version was automatically generated
and I have not revised it.
Rédigé en anglais. La version française a été
générée automatiquement et je ne l'ai pas révisée.
Mise à jour 14 septembre 2026