What makes a model largeCe qui rend un modèle grand
TRA6008 S2 · in classS2 · en classe
Large?
A phone keyboard and large language models large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. are both language models. Clearly, the large here makes a big difference. So in what ways, specifically, is a large language model so large?
- Billions of parameters. Every association the model has picked up, between words, between a country and its capital, between a question and the shape of an answer, is stored across those numbers and nowhere else.
- A large context window context windowfenêtre contextuelle language modelsmodèles de langue "The amount of input (like text) that an AI system can process at one time during a task. Think of it as a model's short-term memory. A model can only consider so much text when generating its next response, and once the conversation exceeds its context window, the model starts 'forgetting' prior responses." (Stanford HAI).Quantité d'entrée (du texte, par exemple) qu'un système d'IA peut traiter à la fois pendant une tâche ; en quelque sorte, la mémoire à court terme du modèle. Un modèle ne peut considérer qu'une quantité limitée de texte pour générer sa prochaine réponse et, quand la conversation dépasse sa fenêtre contextuelle, il commence à « oublier » les réponses antérieures (d'après Stanford HAI, traduction libre). . An LLM takes thousands of tokens of text into account at once and weighs all of them, where earlier systems built on the same transformer transformertransformeur deep learningapprentissage profond A neural-network architecture for processing sequences, such as text.Architecture de réseau de neurones pour le traitement des séquences, comme le texte. architecture usually worked a sentence at a time (Vaswani et al., 2017; Voita et al., 2019). The window is still bounded, though, and text that falls outside it might as well not exist (see also the Inference chapter) (voir aussi le chapitre Inférence).
- A vast corpus of training text. The largest models are trained on close to as much text as can be gathered: a crawl web crawlingexploration du Web datadonnées The automated process of systematically discovering and retrieving pages or other resources from the Web.Processus automatisé de découverte et de récupération systématiques de pages ou d'autres ressources du Web. of the public web, plus books, reference works, news and code (see also the Training data chapter) (voir aussi le chapitre Les données d'entraînement). That breadth lets one model be asked about cooking, contract law and Python in the same conversation.
What GPT stands for
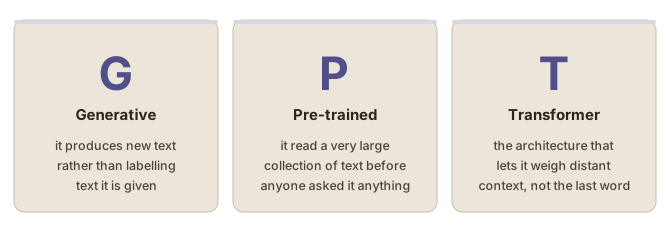
GPT is short for Generative Pre-trained Transformer, and each of the three letters names a property of the model. Radford et al. (2018) introduced the model the name comes from, describing the method as generative pre-training of a transformer-based language model; the acronym itself came into use later.
Grand ?
Un clavier de téléphone et les grands modèles de langue large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. sont tous des modèles de langue. De toute évidence, le « grand » fait ici une grande différence. Alors, en quoi, précisément, un grand modèle de langue est-il si grand ?
- Des milliards de paramètres. Chaque association que le modèle a captée, entre des mots, entre un pays et sa capitale, entre une question et la forme d’une réponse, est stockée à travers ces nombres et nulle part ailleurs.
- Une grande fenêtre contextuelle context windowfenêtre contextuelle language modelsmodèles de langue "The amount of input (like text) that an AI system can process at one time during a task. Think of it as a model's short-term memory. A model can only consider so much text when generating its next response, and once the conversation exceeds its context window, the model starts 'forgetting' prior responses." (Stanford HAI).Quantité d'entrée (du texte, par exemple) qu'un système d'IA peut traiter à la fois pendant une tâche ; en quelque sorte, la mémoire à court terme du modèle. Un modèle ne peut considérer qu'une quantité limitée de texte pour générer sa prochaine réponse et, quand la conversation dépasse sa fenêtre contextuelle, il commence à « oublier » les réponses antérieures (d'après Stanford HAI, traduction libre). . Un GML prend en compte des milliers de jetons de texte à la fois et les pondère tous, là où les systèmes antérieurs bâtis sur la même architecture transformeur transformertransformeur deep learningapprentissage profond A neural-network architecture for processing sequences, such as text.Architecture de réseau de neurones pour le traitement des séquences, comme le texte. travaillaient généralement une phrase à la fois (Vaswani et al., 2017 ; Voita et al., 2019). La fenêtre reste toutefois bornée, et le texte qui en sort n’existe pour ainsi dire plus (see also the Inference chapter) (voir aussi le chapitre Inférence).
- Un corpus d’entraînement colossal. Les plus grands modèles sont entraînés sur presque tout le texte qu’il est possible de rassembler : une exploration du Web web crawlingexploration du Web datadonnées The automated process of systematically discovering and retrieving pages or other resources from the Web.Processus automatisé de découverte et de récupération systématiques de pages ou d'autres ressources du Web. public, plus des livres, des ouvrages de référence, des nouvelles et du code (see also the Training data chapter) (voir aussi le chapitre Les données d'entraînement). Cette ampleur permet d’interroger un même modèle sur la cuisine, le droit des contrats et Python dans une même conversation.
Ce que veut dire GPT
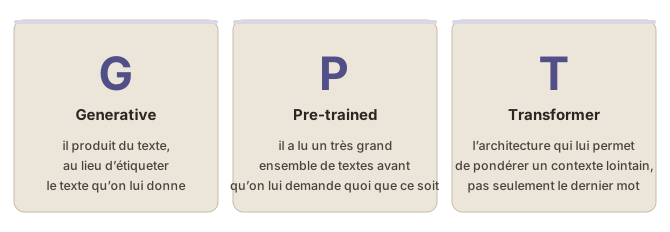
GPT est l’abréviation de Generative Pre-trained Transformer, et chacune des trois lettres nomme une propriété du modèle. Radford et al. (2018) ont présenté le modèle dont vient le nom, en décrivant la méthode comme un préentraînement génératif d’un modèle de langue fondé sur un transformeur ; l’acronyme lui-même s’est répandu plus tard.
Sources
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- Radford, A., Narasimhan, K., Salimans, T., & Sutskever, I. (2018). Improving Language Understanding by Generative Pre-Training. OpenAI (preprint). https://cdn.openai.com/research-covers/language-unsupervised/language_understanding_paper.pdf
- Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., et al. (2017). Attention Is All You Need. Advances in Neural Information Processing Systems 30 (NIPS 2017). https://papers.nips.cc/paper_files/paper/2017/hash/3f5ee243547dee91fbd053c1c4a845aa-Abstract.html
- Voita, E., Sennrich, R., & Titov, I. (2019). When a good translation is wrong in context: Context-aware machine translation improves on deixis, ellipsis, and lexical cohesion. Proceedings of the 57th Annual Meeting of the ACL, 1198–1212. https://aclanthology.org/P19-1116/