Four generationsQuatre générations
TRA6008 To read for S7À lire pour la S7
Four ways of building a system
The four paradigms of language technology (rules written by people, patterns learned from data, deep learning deep learning (DL)apprentissage profond machine learningapprentissage automatique An approach to machine learning based on neural networks with many successive layers of computing units.Approche de l'apprentissage automatique fondée sur des réseaux de neurones comportant de nombreuses couches successives d'unités de calcul. and large language models) each produced a generation of translation systems (see also the Four paradigms page, in the Foundations of AI & NLP module) (voir aussi la page Quatre paradigmes, dans le module Fondements de l'IA et du TAL). Figure 4figure 4 places them in time.
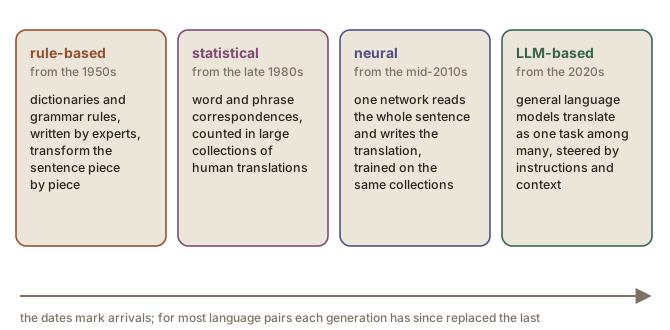
The dates of the four generations
The dates come from Jurafsky and Martin (2026), except the last; the detail of 1954 and 1966 from Hutchins (2003, 2004).
- Late 1940s. Machine translation is proposed, soon after the first computers.
- 1954. The first public demonstration of a prototype, the Georgetown-IBM experiment, is widely reported: about sixty Russian sentences are translated into English with a vocabulary of 250 words and six rules. Russian was chosen for political reasons: with the Cold War under way, the United States wanted above all to read what was being written in the Soviet Union (Hutchins, 2004).
- 1966. The ALPAC report, commissioned by the agencies funding the research in the United States, finds high-quality translation out of reach and leads to a sharp cut in that funding for about twenty years (Hutchins, 2003).ALPAC is the Automatic Language Processing Advisory Committee, set up in 1964 and chaired by John R. Pierce of Bell Telephone Laboratories; its only concern was the US government’s need to read Russian documents. The report itself is Language and Machines (National Research Council, 1966, doi:10.17226/9547); it concluded that “there is no immediate or predictable prospect of useful machine translation” and recommended machine aids for translators and better evaluation instead (Hutchins, 2003). Some systems are built anyway, among them Météo, which translates Canadian weather forecasts from English into French from the 1970s, and Systran.
- Around 1990. Statistical methods arrive, made possible by large bilingual corpora such as the Hansard, the proceedings of the Canadian Parliament in both languages.
- 2015 and 2017. The neural encoder-decoder is first applied to translation, and the transformer transformertransformeur deep learningapprentissage profond A neural-network architecture for processing sequences, such as text.Architecture de réseau de neurones pour le traitement des séquences, comme le texte. follows.
- 2023. WMT, the Conference on Machine Translation, includes large language models among the systems of its yearly comparison for the first time (Kocmi et al., 2023) (see also the WMT shared task chapter) (voir aussi le chapitre La tâche partagée WMT).
Written by people, learned from data
The last three generations are data-driven: a statistical system counts the human translations, a neural system is trained on them, and a large language model has read them, among everything else, during its pretraining pre-trainingpréentraînement language modelsmodèles de langue An initial stage in which a model learns general patterns and reusable representations from a large dataset, often through self-supervised learning, before any later adaptation for particular tasks or uses.Étape initiale au cours de laquelle un modèle apprend des régularités générales et des représentations réutilisables à partir d'un grand jeu de données, souvent par apprentissage autosupervisé, avant toute adaptation ultérieure à des tâches ou à des usages particuliers. (see also the Training data chapter, in the LLM lifecycle module) (voir aussi le chapitre Les données d'entraînement, dans le module Cycle de vie des GML).
The generations in use today
- For a language pair with plenty of translated text, each generation has replaced the last in the services people use: a rule-based rule-based systemsystème à base de règles AIIA A system whose behaviour is fixed by rules that people wrote, most often of the form "if this condition, then this action", so that every output can be traced to the rule that produced it.Système dont le comportement est fixé par des règles écrites par des personnes, le plus souvent de la forme « si cette condition, alors cette action », de sorte que chaque résultat peut être rapporté à la règle qui l'a produit. or statistical system is now hard to find for such a pair, and the neural systems themselves are becoming hybrids, a neural system with a large language model added for some languages (see also the Large language models as translators page) (voir aussi la page Les grands modèles de langue comme traducteurs).
- Older generations survive where the translated text a neural system needs does not exist: a narrow domain, or a language pair with little of it.
Quatre façons de construire un système
Les quatre paradigmes des technologies langagières (des règles écrites par des personnes, des régularités apprises à partir de données, l’apprentissage profond deep learning (DL)apprentissage profond machine learningapprentissage automatique An approach to machine learning based on neural networks with many successive layers of computing units.Approche de l'apprentissage automatique fondée sur des réseaux de neurones comportant de nombreuses couches successives d'unités de calcul. et les grands modèles de langue) ont chacun produit une génération de systèmes de traduction (see also the Four paradigms page, in the Foundations of AI & NLP module) (voir aussi la page Quatre paradigmes, dans le module Fondements de l'IA et du TAL). La Figure 4figure 4 les situe dans le temps.
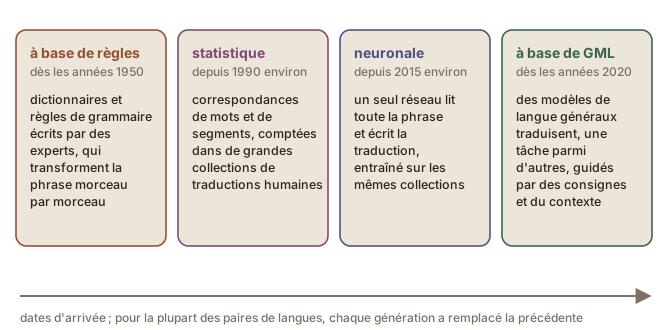
Les dates des quatre générations
Les dates viennent de Jurafsky et Martin (2026), sauf la dernière ; le détail de 1954 et de 1966 vient de Hutchins (2003, 2004).
- Fin des années 1940. La traduction automatique est proposée, peu après les premiers ordinateurs.
- 1954. La première démonstration publique d’un prototype, l’expérience Georgetown-IBM, est largement rapportée : une soixantaine de phrases russes sont traduites en anglais avec un vocabulaire de 250 mots et six règles. Le russe a été choisi pour des raisons politiques : en pleine guerre froide, les États-Unis voulaient avant tout lire ce qui s’écrivait en Union soviétique (Hutchins, 2004).
- 1966. Le rapport ALPAC, commandé par les organismes qui finançaient la recherche aux États-Unis, conclut qu’une traduction de haute qualité est hors de portée et entraîne une forte réduction de ce financement pendant une vingtaine d’années (Hutchins, 2003).ALPAC est l’Automatic Language Processing Advisory Committee, créé en 1964 et présidé par John R. Pierce, des Bell Telephone Laboratories ; sa seule préoccupation était le besoin du gouvernement américain de lire des documents russes. Le rapport lui-même est Language and Machines (National Research Council, 1966, doi:10.17226/9547) ; il concluait que « there is no immediate or predictable prospect of useful machine translation » [ma traduction : « il n’y a aucune perspective immédiate ou prévisible de traduction automatique utile »] et recommandait plutôt des aides informatiques pour les traducteurs et une meilleure évaluation (Hutchins, 2003). Quelques systèmes sont tout de même construits, dont Météo, qui traduit les bulletins météorologiques canadiens de l’anglais vers le français à partir des années 1970, et Systran.
- Vers 1990. Les méthodes statistiques arrivent, rendues possibles par de grands corpus bilingues comme le Hansard, les débats du Parlement canadien dans les deux langues.
- 2015 et 2017. L’encodeur-décodeur neuronal est appliqué à la traduction pour la première fois, et le transformeur transformertransformeur deep learningapprentissage profond A neural-network architecture for processing sequences, such as text.Architecture de réseau de neurones pour le traitement des séquences, comme le texte. suit.
- 2023. WMT, la Conference on Machine Translation, inclut pour la première fois des grands modèles de langue parmi les systèmes de sa comparaison annuelle (Kocmi et al., 2023) (see also the WMT shared task chapter) (voir aussi le chapitre La tâche partagée WMT).
Écrit par des personnes, appris des données
Les trois dernières générations sont fondées sur les données : un système statistique compte les traductions humaines, un système neuronal est entraîné sur elles, et un grand modèle de langue les a lues, parmi tout le reste, pendant son préentraînement pre-trainingpréentraînement language modelsmodèles de langue An initial stage in which a model learns general patterns and reusable representations from a large dataset, often through self-supervised learning, before any later adaptation for particular tasks or uses.Étape initiale au cours de laquelle un modèle apprend des régularités générales et des représentations réutilisables à partir d'un grand jeu de données, souvent par apprentissage autosupervisé, avant toute adaptation ultérieure à des tâches ou à des usages particuliers. (see also the Training data chapter, in the LLM lifecycle module) (voir aussi le chapitre Les données d'entraînement, dans le module Cycle de vie des GML).
Les générations en usage aujourd’hui
- Pour une paire de langues dotée d’abondants textes traduits, chaque génération a remplacé la précédente dans les services que les gens utilisent : un système à base de règles rule-based systemsystème à base de règles AIIA A system whose behaviour is fixed by rules that people wrote, most often of the form "if this condition, then this action", so that every output can be traced to the rule that produced it.Système dont le comportement est fixé par des règles écrites par des personnes, le plus souvent de la forme « si cette condition, alors cette action », de sorte que chaque résultat peut être rapporté à la règle qui l'a produit. ou statistique est devenu difficile à trouver pour une telle paire, et les systèmes neuronaux eux-mêmes deviennent des hybrides, un système neuronal auquel s’ajoute un grand modèle de langue pour certaines langues (see also the Large language models as translators page) (voir aussi la page Les grands modèles de langue comme traducteurs).
- Les générations plus anciennes survivent là où les textes traduits qu’exige un système neuronal n’existent pas : un domaine étroit, ou une paire de langues qui en compte peu.
Sources
- Hutchins, J. (2003). ALPAC: The (In)Famous Report. In S. Nirenburg, H. L. Somers & Y. A. Wilks (Eds.), Readings in Machine Translation (pp. 131–136). The MIT Press. https://doi.org/10.7551/mitpress/5779.003.0014
- Hutchins, W. J. (2004). The Georgetown-IBM experiment demonstrated in January 1954. Proceedings of the 6th Conference of the Association for Machine Translation in the Americas: Technical Papers, 102–114. https://aclanthology.org/2004.amta-papers.12/
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- Kocmi, T., Avramidis, E., Bawden, R., Bojar, O., Dvorkovich, A., Federmann, C., et al. (2023). Findings of the 2023 Conference on Machine Translation (WMT23): LLMs Are Here but Not Quite There Yet. Proceedings of the Eighth Conference on Machine Translation (WMT 2023), Singapore, 1–42. https://doi.org/10.18653/v1/2023.wmt-1.1