RLVR: learning from answers that can be checkedL'ARV : apprendre à partir de réponses vérifiables
TRA6008 OptionalFacultatif
AlphaGo training versus LLM training
AlphaGo was trained in two stages, on human games and then against itself (see also the Reinforcement learning: AlphaGo and move 37 page) (voir aussi la page L'apprentissage par renforcement : AlphaGo et le coup 37). They line up with instruction tuning instruction tuningaffinage par instructions language modelsmodèles de langue A form of supervised fine-tuning in which a pretrained language model is trained further on examples pairing instructions or questions with appropriate responses.Forme d'affinage supervisé dans laquelle un modèle de langue préentraîné est entraîné davantage sur des exemples associant des instructions ou des questions à des réponses appropriées. and preference tuning preference tuningréglage des préférences language modelsmodèles de langue A form of fine-tuning, applied in post-training, that adjusts a language model so that it becomes more likely to produce responses judged preferable and less likely to produce responses judged undesirable.Forme d'affinage, appliquée au postentraînement, qui ajuste un modèle de langue pour qu'il produise plus volontiers des réponses jugées préférables et moins volontiers des réponses jugées indésirables. , and the resemblance ends at the thing being optimized.
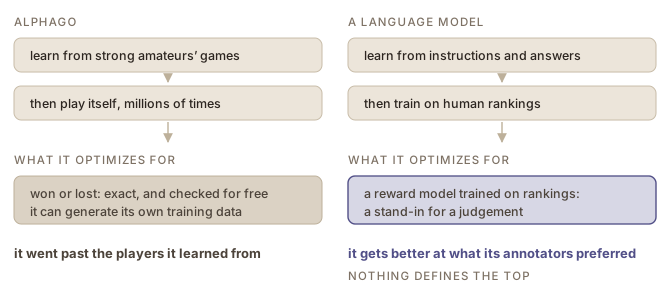
At the end of every game of Go, the rules say who won. That result is exact, it costs nothing to check, and a program can play millions of games against itself to collect more of it.
A translation, a summary or an explanation has nothing like that. No rule says whether a text is right, so preference tuning learns from people’s rankings, through a reward model or directly, and those rankings are a stand-in for a judgement and not a ground truth ground truthréalité de terrain evaluationévaluation The values, labels or observations treated as the correct description of the cases in a dataset.Valeurs, étiquettes ou observations tenues pour la description correcte des cas d'un jeu de données. (Guo et al., 2025). A language model can therefore get better at producing what its annotators preferred, but it has no clear route to becoming superhuman at writing the way AlphaGo and its successors became superhuman at Go, because nothing defines the top.
This is a crucial difference. Having a result you can check automatically means you can keep optimizing without people, and each check costs almost nothing. Whereas being reliant on subjective references that require human involvement to create is a considerable limitation in terms of how much you can optimize and what you should consider good performance (see also the Evaluating language technology module) (voir aussi le module L'évaluation des technologies langagières).
RLVR: verifiable answers are the answer
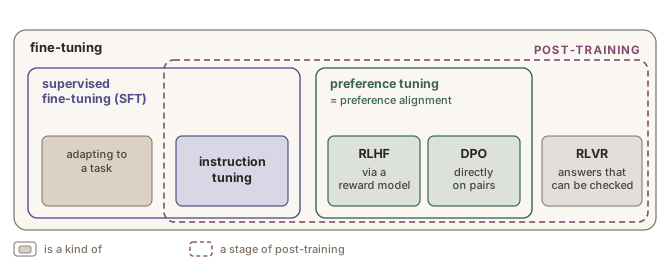
Some tasks done in language do end in a result that can be checked: a mathematical answer is right or wrong, and code passes its tests or does not. There, training can again score the model’s answers automatically, as often as the budget allows. This is reinforcement learning with verifiable rewards (RLVR), the method behind reasoning models reasoning modelmodèle de raisonnement language modelsmodèles de langue A language model designed to improve its performance on complex, multi-step problems by using additional computation during inference.Modèle de langue conçu pour améliorer sa performance sur des problèmes complexes en plusieurs étapes en recourant à un surcroît de calcul pendant l'inférence. such as DeepSeek-R1, which improved most in mathematics and code (Guo et al., 2025). The name was introduced for the post-training of the open Tülu 3 models (Lambert et al., 2025).
How the kinds of fine-tuning fit together
Instruction tuning, preference tuning and RLVR are all fine-tuning fine-tuningaffinage machine learningapprentissage automatique Further training of a pretrained model on new data to adapt it for a particular task, domain, or intended behaviour.Poursuite de l'entraînement d'un modèle préentraîné sur un jeu de données généralement plus restreint et spécialisé, afin de l'adapter à une tâche ou à un domaine particulier. : each trains a model that already exists on further data. Post-training post-trainingpostentraînement language modelsmodèles de langue Additional training applied to a pretrained model to adapt its capabilities or behaviour for intended uses.Entraînement supplémentaire appliqué à un modèle préentraîné pour adapter ses capacités ou son comportement aux usages visés. names the stages a developer runs to turn a base model base modelmodèle de base language modelsmodèles de langue A language model that has completed pretraining but has not yet undergone post-training.Modèle de langue qui a terminé son préentraînement mais n'a pas encore reçu de postentraînement. into an assistant (Jurafsky & Martin, 2026). Adapting a model to a domain or a task is fine-tuning as well, but it happens outside post-training.
L’entraînement d’AlphaGo face à celui des GML
AlphaGo a été entraîné en deux étapes, sur des parties humaines puis contre lui-même (see also the Reinforcement learning: AlphaGo and move 37 page) (voir aussi la page L'apprentissage par renforcement : AlphaGo et le coup 37). Elles correspondent à l’affinage par instructions instruction tuningaffinage par instructions language modelsmodèles de langue A form of supervised fine-tuning in which a pretrained language model is trained further on examples pairing instructions or questions with appropriate responses.Forme d'affinage supervisé dans laquelle un modèle de langue préentraîné est entraîné davantage sur des exemples associant des instructions ou des questions à des réponses appropriées. et au réglage des préférences preference tuningréglage des préférences language modelsmodèles de langue A form of fine-tuning, applied in post-training, that adjusts a language model so that it becomes more likely to produce responses judged preferable and less likely to produce responses judged undesirable.Forme d'affinage, appliquée au postentraînement, qui ajuste un modèle de langue pour qu'il produise plus volontiers des réponses jugées préférables et moins volontiers des réponses jugées indésirables. , et la ressemblance s’arrête à ce qui est optimisé.
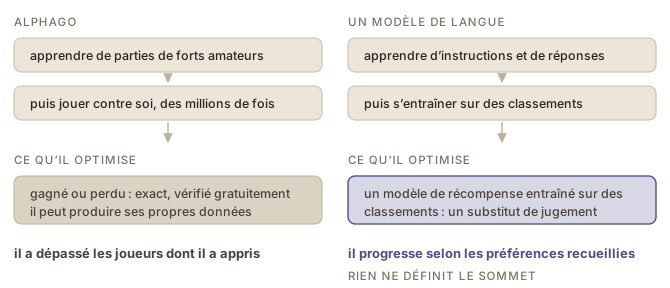
À la fin de chaque partie de go, les règles disent qui a gagné. Ce résultat est exact, il ne coûte rien à vérifier, et un programme peut jouer des millions de parties contre lui-même pour en recueillir davantage.
Une traduction, un résumé ou une explication n’ont rien de tel. Aucune règle ne dit si un texte est juste ; le réglage des préférences apprend donc de classements humains, par un modèle de récompense ou directement, et ces classements tiennent lieu de jugement sans être une réalité de terrain ground truthréalité de terrain evaluationévaluation The values, labels or observations treated as the correct description of the cases in a dataset.Valeurs, étiquettes ou observations tenues pour la description correcte des cas d'un jeu de données. (Guo et al., 2025). Un modèle de langue peut donc produire de mieux en mieux ce que ses annotateurs préféraient, mais il n’a pas de voie claire pour devenir surhumain en écriture comme AlphaGo et ses successeurs le sont devenus au go, parce que rien ne définit le sommet.
C’est une différence cruciale. Disposer d’un résultat vérifiable automatiquement permet de continuer à optimiser sans intervention humaine, et chaque vérification ne coûte presque rien. Dépendre de références subjectives, dont la création exige une intervention humaine, limite au contraire considérablement ce qu’on peut optimiser et ce qu’on doit considérer comme une bonne performance (see also the Evaluating language technology module) (voir aussi le module L'évaluation des technologies langagières).
L’ARV : les réponses vérifiables sont la réponse
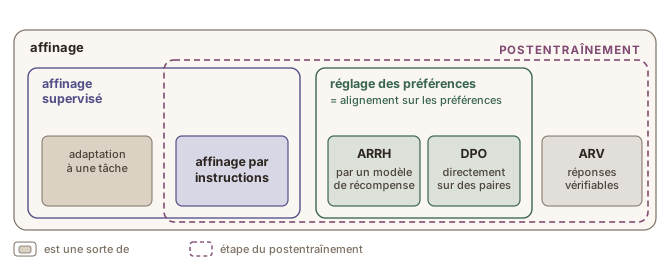
Certaines tâches langagières aboutissent pourtant à un résultat vérifiable : une réponse mathématique est juste ou fausse, et du code réussit ses tests ou non. Là, l’entraînement peut de nouveau noter automatiquement les réponses du modèle, aussi souvent que le budget le permet. C’est l’apprentissage par renforcement vérifiable (ARV), la méthode derrière des modèles de raisonnement reasoning modelmodèle de raisonnement language modelsmodèles de langue A language model designed to improve its performance on complex, multi-step problems by using additional computation during inference.Modèle de langue conçu pour améliorer sa performance sur des problèmes complexes en plusieurs étapes en recourant à un surcroît de calcul pendant l'inférence. comme DeepSeek-R1, qui ont le plus progressé en mathématiques et en programmation (Guo et al., 2025). Le nom a été introduit pour le postentraînement des modèles ouverts Tülu 3 (Lambert et al., 2025).
Comment les sortes d’affinage s’articulent
L’affinage par instructions, le réglage des préférences et l’ARV relèvent tous de l’affinage fine-tuningaffinage machine learningapprentissage automatique Further training of a pretrained model on new data to adapt it for a particular task, domain, or intended behaviour.Poursuite de l'entraînement d'un modèle préentraîné sur un jeu de données généralement plus restreint et spécialisé, afin de l'adapter à une tâche ou à un domaine particulier. : chacun entraîne davantage un modèle qui existe déjà. Le postentraînement post-trainingpostentraînement language modelsmodèles de langue Additional training applied to a pretrained model to adapt its capabilities or behaviour for intended uses.Entraînement supplémentaire appliqué à un modèle préentraîné pour adapter ses capacités ou son comportement aux usages visés. désigne les étapes qu’un développeur mène pour faire d’un modèle de base base modelmodèle de base language modelsmodèles de langue A language model that has completed pretraining but has not yet undergone post-training.Modèle de langue qui a terminé son préentraînement mais n'a pas encore reçu de postentraînement. un assistant (Jurafsky et Martin, 2026). Adapter un modèle à un domaine ou à une tâche relève aussi de l’affinage, mais en dehors du postentraînement.
Sources
- Guo, D., Yang, D., Zhang, H., Song, J., Zhang, R., Xu, R., et al. (2025). DeepSeek-R1 incentivizes reasoning in LLMs through reinforcement learning. Nature, 645(8081), 633–638. https://doi.org/10.1038/s41586-025-09422-z
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- Lambert, N., Morrison, J., Pyatkin, V., Huang, S., Ivison, H., Brahman, F., et al. (2025). Tulu 3: Pushing Frontiers in Open Language Model Post-Training. Conference on Language Modeling (COLM 2025). https://openreview.net/forum?id=i1uGbfHHpH