Correcting the model or starting overCorriger le modèle ou recommencer
TRA6008 S3 · in classS3 · en classe
Correcting as you go
Refining an answer over several turns is the normal way to work. Two habits help:
- Be precise in your corrections: “cut the second paragraph and keep the example” works better than “shorter”.
- Judge a change on more than one answer: a better output after a change may not come back on the next run, which people new to these systems tend to overlook (Zamfirescu-Pereira et al., 2023) (see also the LLMs are non-deterministic page, in the LLM lifecycle module) (voir aussi la page Les GML ne sont pas déterministes, dans le module Cycle de vie des GML).
When a conversation will not recover
Every correction is added to a context context windowfenêtre contextuelle language modelsmodèles de langue "The amount of input (like text) that an AI system can process at one time during a task. Think of it as a model's short-term memory. A model can only consider so much text when generating its next response, and once the conversation exceeds its context window, the model starts 'forgetting' prior responses." (Stanford HAI).Quantité d'entrée (du texte, par exemple) qu'un système d'IA peut traiter à la fois pendant une tâche ; en quelque sorte, la mémoire à court terme du modèle. Un modèle ne peut considérer qu'une quantité limitée de texte pour générer sa prochaine réponse et, quand la conversation dépasse sa fenêtre contextuelle, il commence à « oublier » les réponses antérieures (d'après Stanford HAI, traduction libre). that still contains the misreading, and the model’s answer is built on both rather than on the correction alone. Once a model has taken a wrong turn early in a conversation, it tends to build on it, and in tests it did considerably worse on a task spread over several messages than on the same task stated in one (Laban et al., 2026) (see also the Errors spread through context page, in the LLM lifecycle module) (voir aussi la page Les erreurs se propagent dans le contexte, dans le module Cycle de vie des GML). Four signs that you have reached that point:
- the answers get longer and less relevant with each turn;
- the model apologizes and repeats the same error;
- each correction introduces a new problem;
- the exchange has become a negotiation about your earlier instructions.
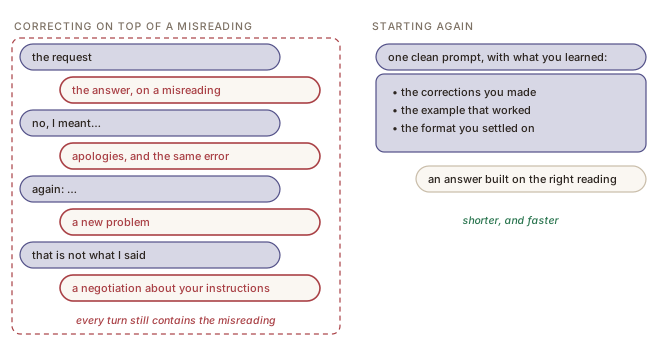
At that point, open a new conversation and write one clean prompt containing what you have learned: the corrections you made, the example that finally worked, the format you settled on (Figure 9figure 9). It can feel wasteful, but it is usually faster.
When a conversation has grown long
A long conversation fails in a different way. Instructions given at the start tend to be followed less as the conversation goes on, a long context is used unevenly, and once the context window fills, the chat app drops the oldest turns, or compacts them into a summary written by the model itself (see also the context window page, in the LLM lifecycle module) (voir aussi la page La fenêtre contextuelle, dans le module Cycle de vie des GML). Claude, for instance, does this on its paid plans.Claude Help Center, How large is the context window on paid Claude plans?: “When your conversation approaches the context window limit, Claude summarizes earlier messages to make room for new content”, on paid plans with code execution enabled. Read 21 September 2026. In practice, the model stops applying a decision made an hour ago. Three habits help:
- Restate the essentials later in a long conversation, rather than assuming the instruction at the top is still being followed.
- Start a new conversation with a summary of the decisions taken: ask the model for one, or write your own, and check it before you use it, since a summary can lose a decision.
- Do not fill the context with what you do not need: a pasted document you have finished with, a long tangent, the ten versions before the current one all compete with your instructions.
Corriger au fur et à mesure
Affiner une réponse en plusieurs tours est la façon normale de travailler. Deux habitudes aident :
- Soyez précis dans vos corrections : « supprime le deuxième paragraphe et garde l’exemple » fonctionne mieux que « plus court ».
- Jugez un changement sur plus d’une réponse : une réponse meilleure après un changement peut ne pas se reproduire à l’essai suivant, ce que les personnes qui découvrent ces systèmes ont tendance à négliger (Zamfirescu-Pereira et al., 2023) (see also the LLMs are non-deterministic page, in the LLM lifecycle module) (voir aussi la page Les GML ne sont pas déterministes, dans le module Cycle de vie des GML).
Quand une conversation ne se rétablit pas
Chaque correction s’ajoute à un contexte context windowfenêtre contextuelle language modelsmodèles de langue "The amount of input (like text) that an AI system can process at one time during a task. Think of it as a model's short-term memory. A model can only consider so much text when generating its next response, and once the conversation exceeds its context window, the model starts 'forgetting' prior responses." (Stanford HAI).Quantité d'entrée (du texte, par exemple) qu'un système d'IA peut traiter à la fois pendant une tâche ; en quelque sorte, la mémoire à court terme du modèle. Un modèle ne peut considérer qu'une quantité limitée de texte pour générer sa prochaine réponse et, quand la conversation dépasse sa fenêtre contextuelle, il commence à « oublier » les réponses antérieures (d'après Stanford HAI, traduction libre). qui contient encore le malentendu, et la réponse du modèle se construit sur les deux plutôt que sur la seule correction. Une fois qu’un modèle a fait fausse route tôt dans une conversation, il a tendance à poursuivre sur cette lancée, et dans les essais, il s’en tirait nettement moins bien sur une tâche répartie sur plusieurs messages que sur la même tâche énoncée en un seul (Laban et al., 2026) (see also the Errors spread through context page, in the LLM lifecycle module) (voir aussi la page Les erreurs se propagent dans le contexte, dans le module Cycle de vie des GML). Quatre signes que vous en êtes là :
- les réponses s’allongent et perdent en pertinence à chaque tour ;
- le modèle s’excuse et répète la même erreur ;
- chaque correction introduit un nouveau problème ;
- l’échange est devenu une négociation sur vos consignes précédentes.
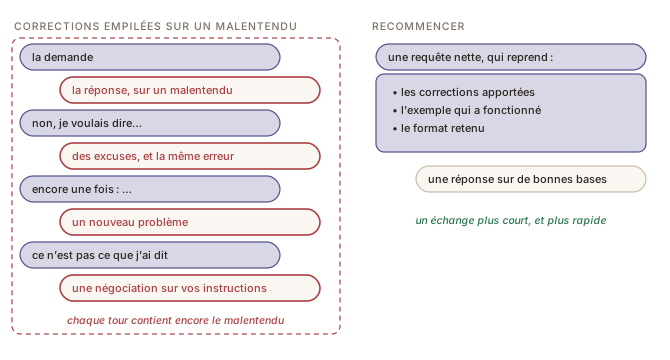
Arrivé à ce point, ouvrez une nouvelle conversation et écrivez une seule requête nette qui reprend ce que vous avez appris : les corrections apportées, l’exemple qui a fini par fonctionner, le format retenu (Figure 9figure 9). Cela peut sembler du gaspillage, mais c’est généralement plus rapide.
Quand une conversation s’est allongée
Une longue conversation échoue d’une autre façon. Les consignes données au début ont tendance à être moins suivies à mesure que la conversation avance, un long contexte est exploité inégalement, et une fois la fenêtre contextuelle remplie, l’application de clavardage abandonne les tours les plus anciens, ou les condense en un résumé rédigé par le modèle lui-même (see also the context window page, in the LLM lifecycle module) (voir aussi la page La fenêtre contextuelle, dans le module Cycle de vie des GML). C’est par exemple ce que fait Claude dans ses forfaits payants.Claude Help Center, How large is the context window on paid Claude plans? : « When your conversation approaches the context window limit, Claude summarizes earlier messages to make room for new content », dans les forfaits payants où l’exécution de code est activée. Consulté le 21 septembre 2026. En pratique, le modèle cesse d’appliquer une décision prise une heure plus tôt. Trois habitudes aident :
- Répétez ce qui compte plus loin dans une longue conversation, plutôt que de supposer que la consigne du début est toujours suivie.
- Ouvrez une nouvelle conversation avec un résumé des décisions prises : demandez-en un au modèle, ou rédigez le vôtre, et vérifiez-le avant de l’utiliser, car un résumé peut perdre une décision.
- N’encombrez pas le contexte de ce dont vous n’avez pas besoin : un document collé dont vous avez fini de vous servir, une longue digression, les dix versions précédant la version actuelle font tous concurrence à vos consignes.
Sources
- Laban, P., Hayashi, H., Zhou, Y., & Neville, J. (2026). LLMs Get Lost In Multi-Turn Conversation. The Fourteenth International Conference on Learning Representations (ICLR 2026). https://openreview.net/forum?id=VKGTGGcwl6
- Zamfirescu-Pereira, J. D., Wong, R. Y., Hartmann, B., & Yang, Q. (2023). Why Johnny Can't Prompt: How Non-AI Experts Try (and Fail) to Design LLM Prompts. Proceedings of the 2023 CHI Conference on Human Factors in Computing Systems (CHI '23), article 437, 1–21. https://doi.org/10.1145/3544548.3581388