LLMs are non-deterministicLes GML ne sont pas déterministes
TRA6008 OptionalFacultatif
How the next token is chosen
Even though a model does not change during inference inferenceinférence machine learningapprentissage automatique The stage in which a trained AI model processes new input to produce a prediction, classification, decision, or generated output.Étape au cours de laquelle un modèle d'IA entraîné traite une nouvelle entrée pour produire une prédiction, une classification, une décision ou une sortie générée. (see also the Inference page) (voir aussi la page Inférence), the same prompt can give different answers, with the same model and an identical context window context windowfenêtre contextuelle language modelsmodèles de langue "The amount of input (like text) that an AI system can process at one time during a task. Think of it as a model's short-term memory. A model can only consider so much text when generating its next response, and once the conversation exceeds its context window, the model starts 'forgetting' prior responses." (Stanford HAI).Quantité d'entrée (du texte, par exemple) qu'un système d'IA peut traiter à la fois pendant une tâche ; en quelque sorte, la mémoire à court terme du modèle. Un modèle ne peut considérer qu'une quantité limitée de texte pour générer sa prochaine réponse et, quand la conversation dépasse sa fenêtre contextuelle, il commence à « oublier » les réponses antérieures (d'après Stanford HAI, traduction libre). . The model works out the same probabilities both times; the difference comes from the step that picks a token from those probabilities.
The model’s computation ends with a probability for every token in its vocabulary, and picking one token from those probabilities is called decoding decodingdécodage language modelsmodèles de langue The process used during text generation to turn a language model's predicted probabilities into an actual sequence of output tokens.Processus qui, pendant la génération de texte, transforme les probabilités prédites par un modèle de langue en une séquence réelle de jetons de sortie. (see also the One token at a time page) (voir aussi la page Un jeton à la fois).
The most likely token, or a random pick
The simplest rule is to take the most probable token every time.
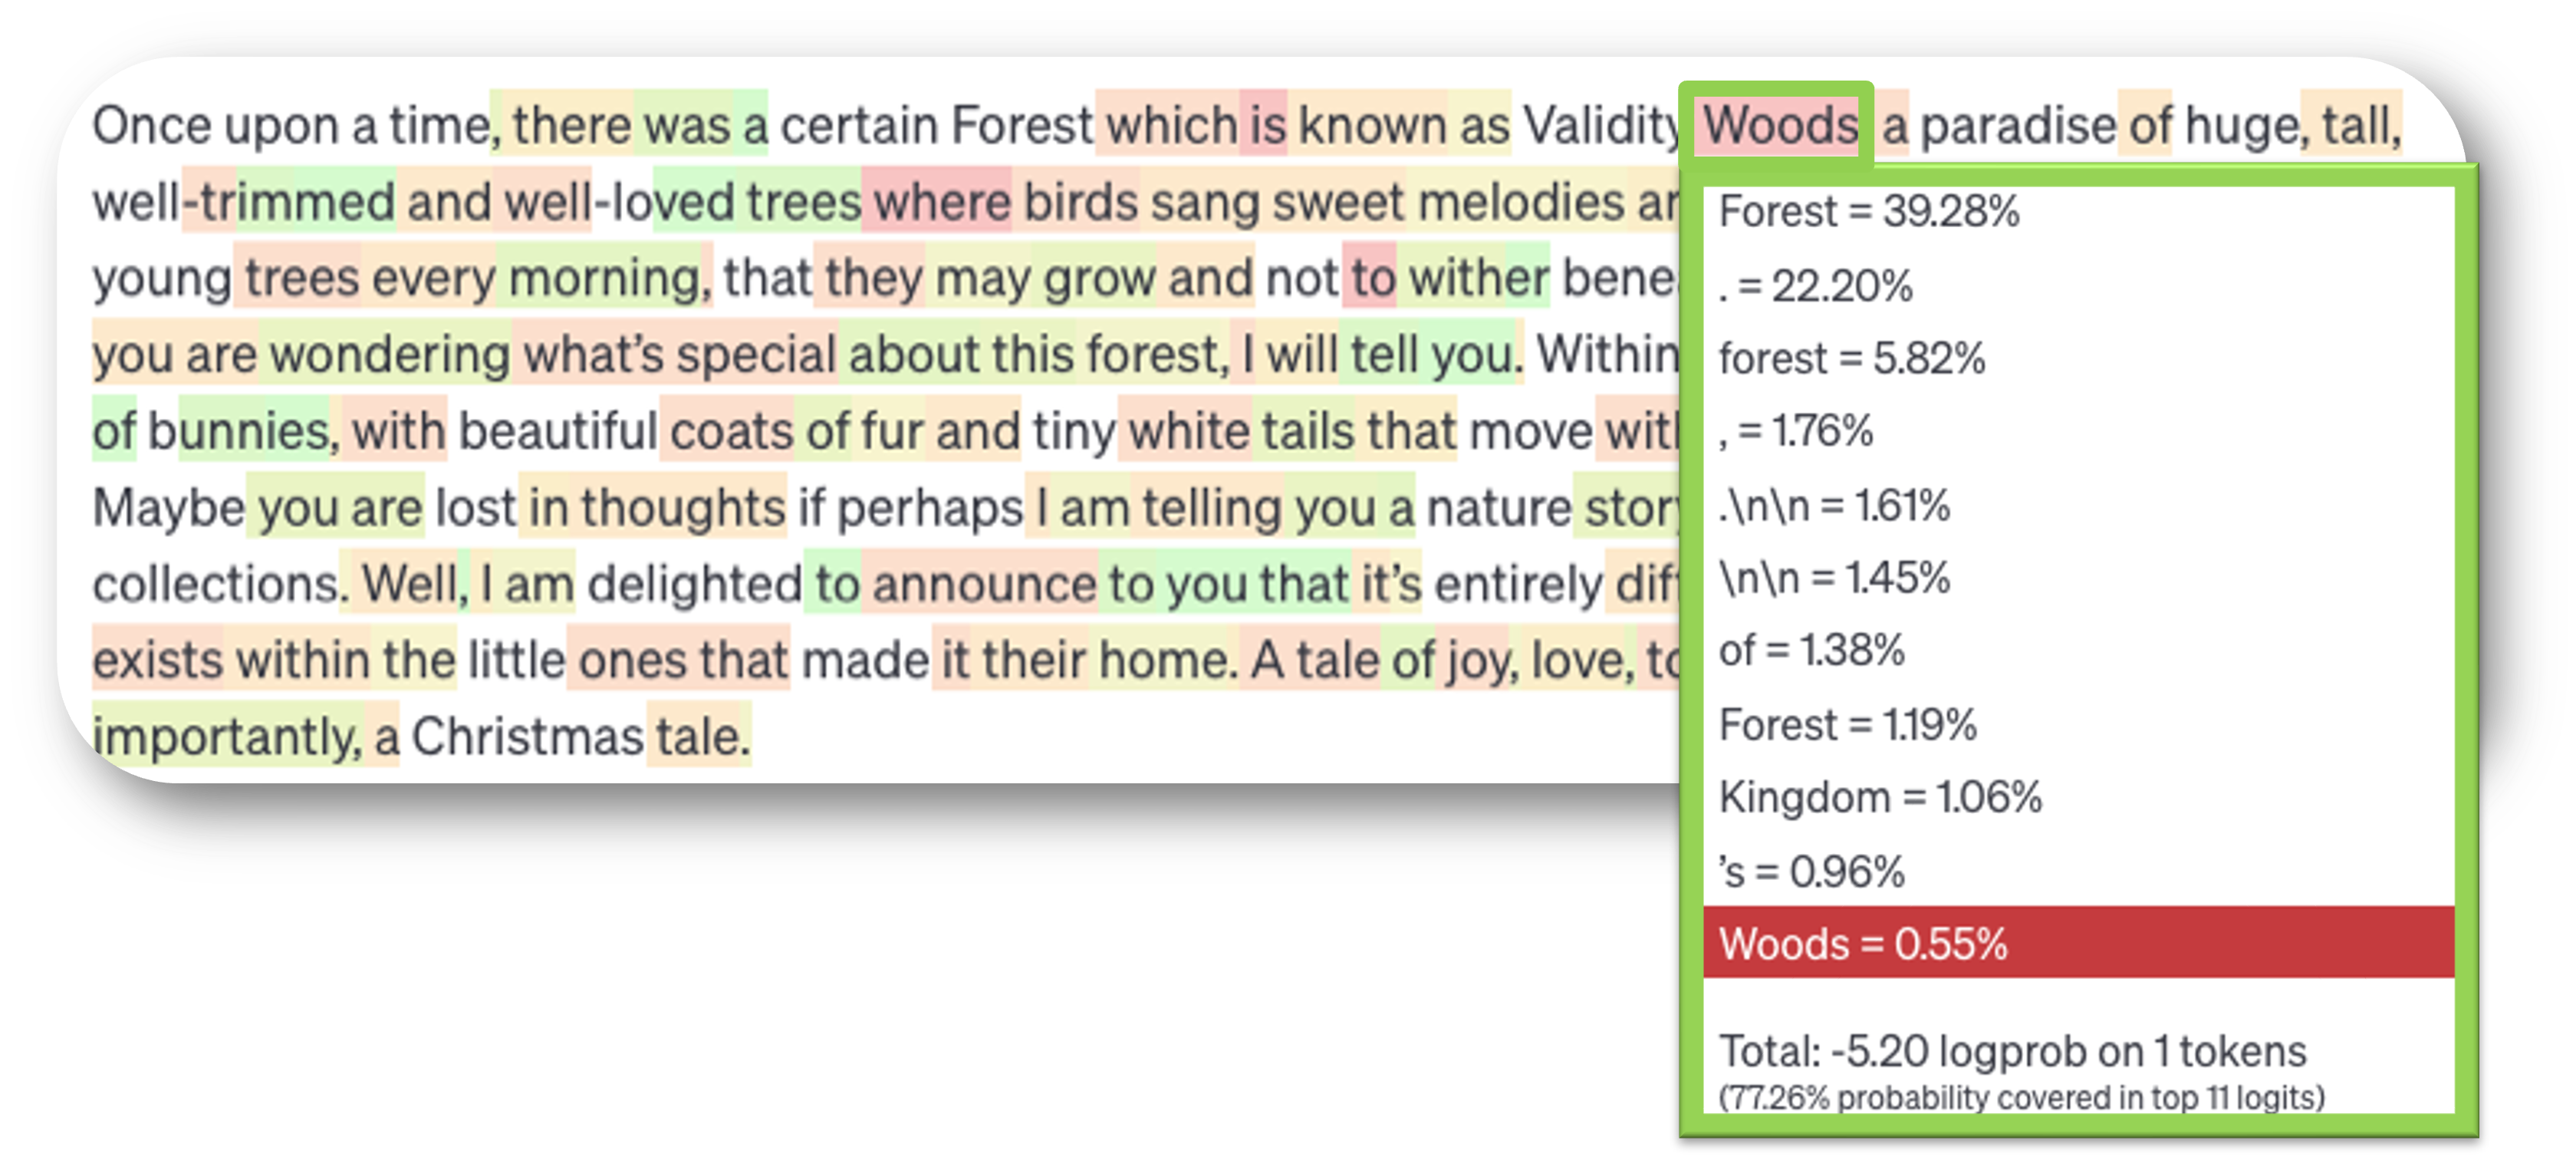
The screenshots on this page were taken in 2024 in OpenAI’s Playground, with gpt-3.5-turbo-instruct, an older model that OpenAI retires on 28 September 2026. The shading shows how probable each token was, from green (likely) to red (unlikely), and each shaded block is a token rather than a word, so a name like “Goldilocks” is shaded in pieces.
In Figure 5figure 5, the model continues “Once upon a time” with the element of chance turned off, so at each step it takes the most probable token. For the girl’s name, that is “Gold”, at 11.29%.
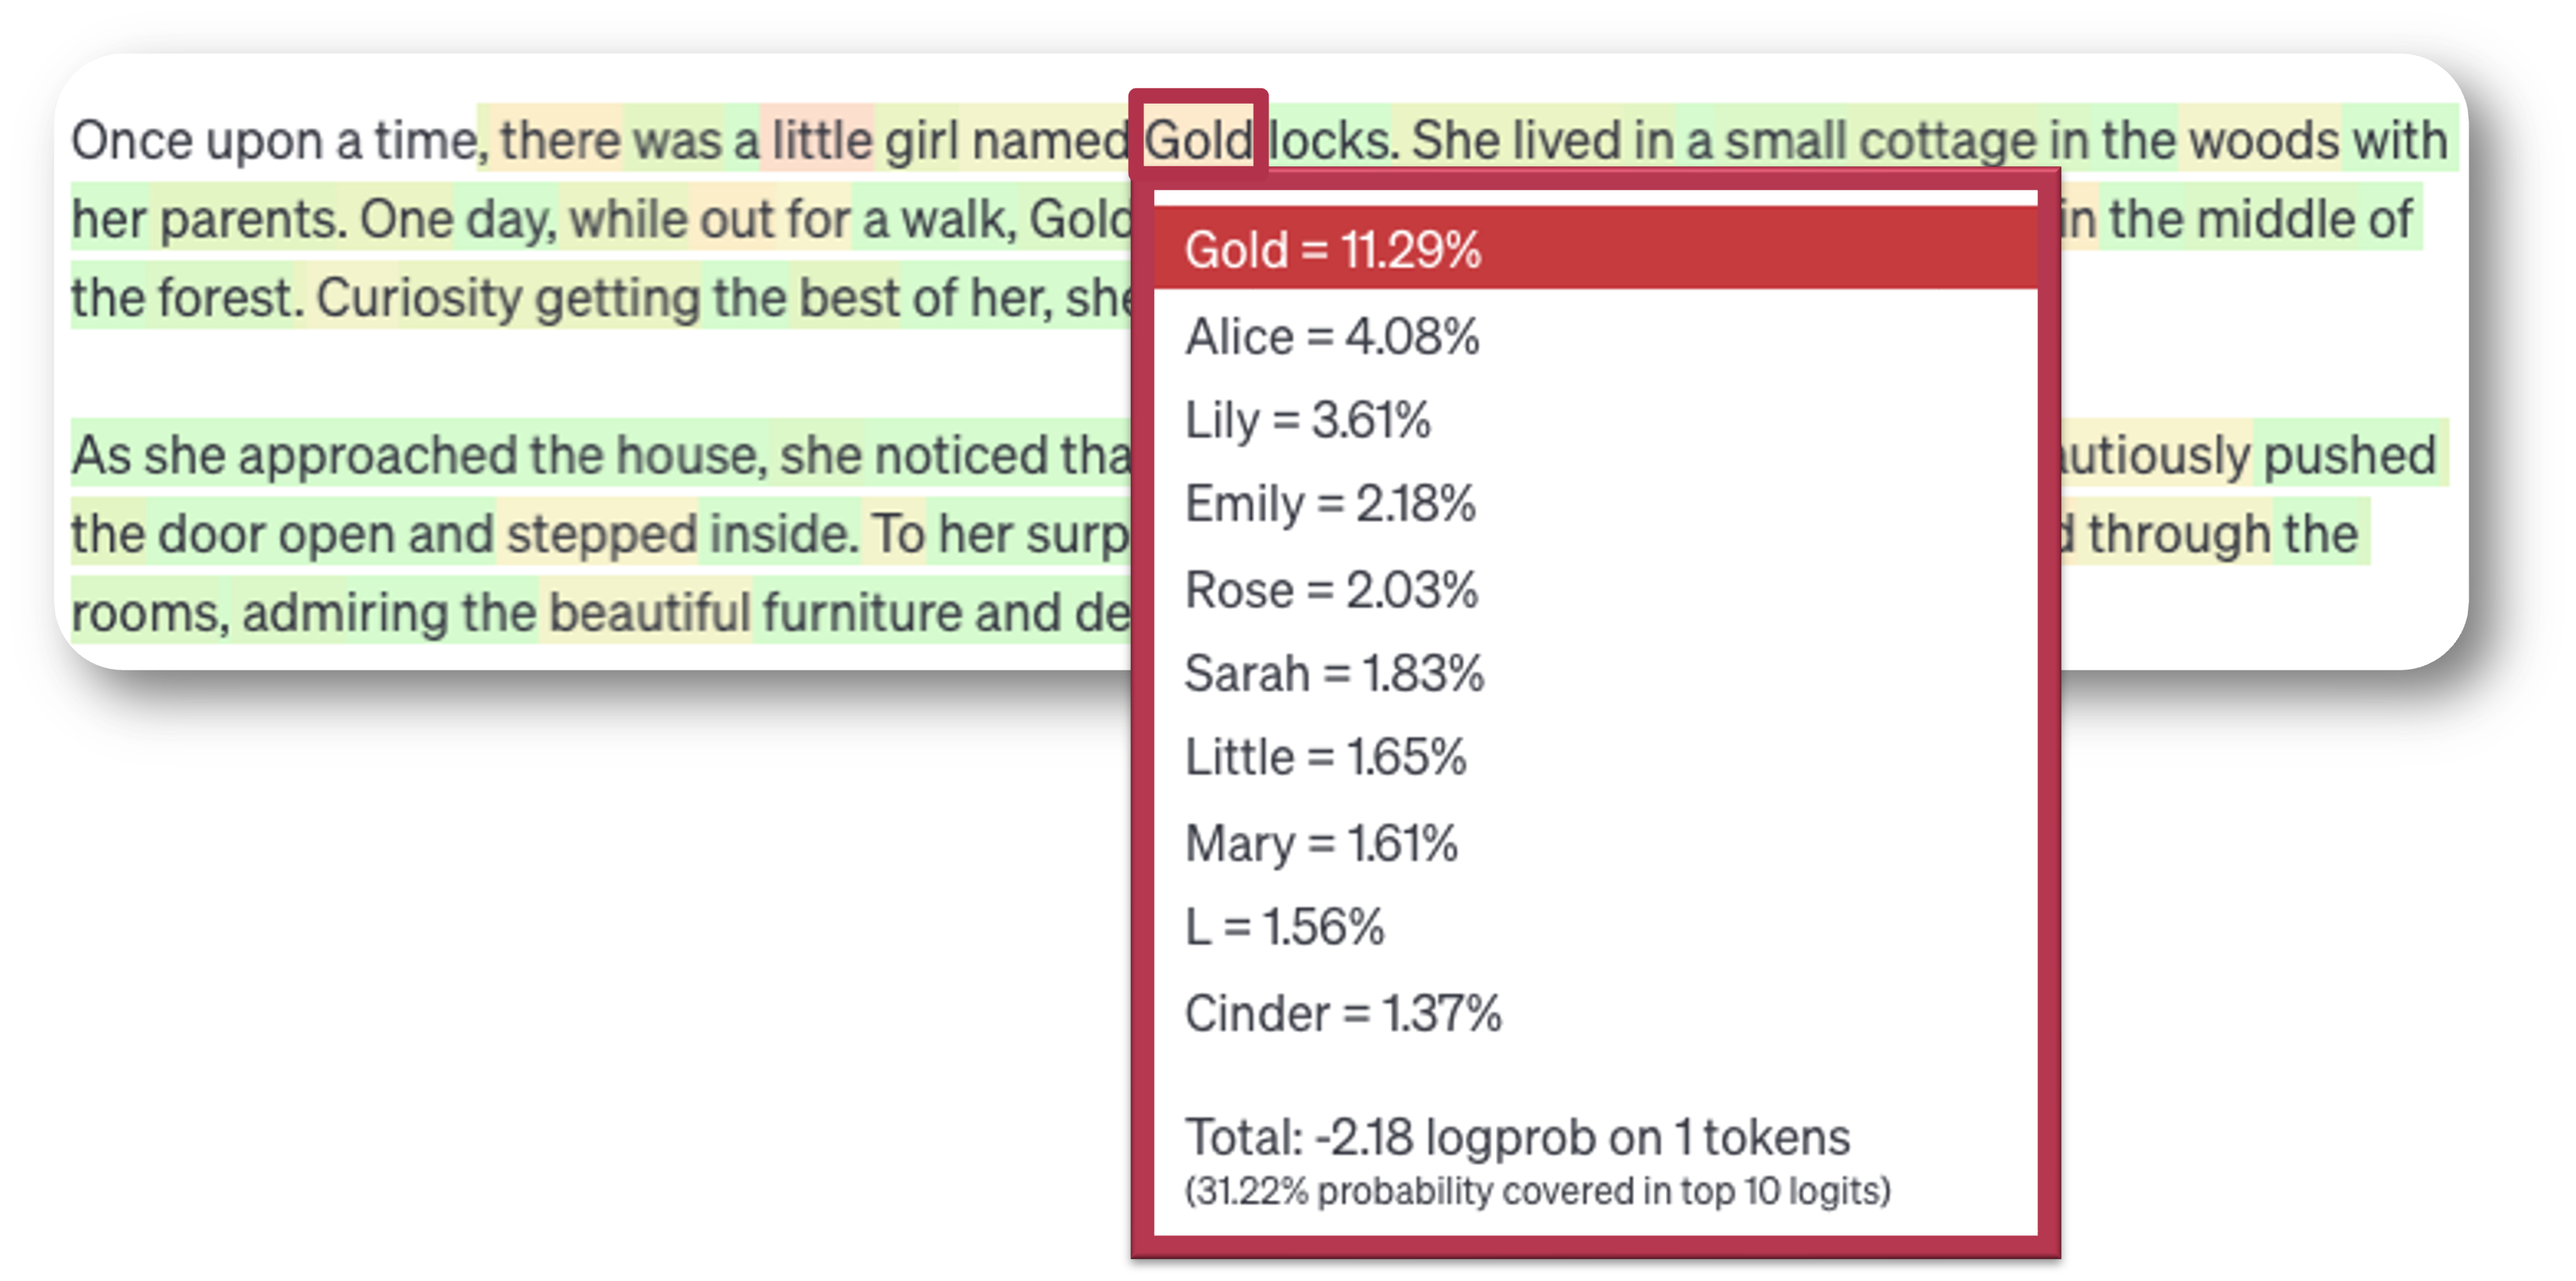
This may seem the safest choice, but it tends to produce poor text: always taking the most probable token leads to repetitions and loops (Holtzman et al., 2020). Most systems therefore add an element of chance.
With sampling, a likely token is more likely to be picked, but it is not certain to be. In a short answer the difference is often small. In a long answer, one different pick early on can change everything written after it.
Figure 6figure 6 shows the same beginning with sampling. The model picked “Woods”, a token with a probability of 0.55%, and the story went in a different direction from there.
Why the same question gives different answers
Chatbots sample their answers, and most of them do not let you turn this off (see also the Temperature, top-p and top-k page) (voir aussi la page Température, top-p et top-k). Even with the element of chance set to zero, the answers are not fully deterministic: Ouyang et al. (2025) found that ChatGPT still gave different answers to identical programming requests.Anthropic’s API documentation says the same of its own models: even at a temperature temperaturetempérature language modelsmodèles de langue A setting that influences how predictable or varied a language model's output will be.Réglage qui influence le caractère prévisible ou varié de la sortie d'un modèle de langue. of 0, identical inputs may produce different outputs. Messages API reference, read 14 September 2026.
This has two consequences:
- One answer proves little. A conclusion drawn from a single answer may not be true the next time, which is why “I tried it and it worked” says little about a system, and why evaluations are based on many answers (see also the Evaluation foundations chapter, in the Evaluating language technology module) (voir aussi le chapitre Fondements de l'évaluation, dans le module L'évaluation des technologies langagières).
- Results are hard to reproduce. Getting the same result twice takes deliberate effort, and even then it is not guaranteed. For research that uses LLMs, this is a real problem: a conclusion drawn from a model’s output may not be confirmed when the study is repeated, which Ouyang et al. (2025) describe as a threat to the validity of such research (see also the Evaluation foundations chapter, in the Evaluating language technology module) (voir aussi le chapitre Fondements de l'évaluation, dans le module L'évaluation des technologies langagières).
Comment le jeton suivant est choisi
Même si un modèle ne change pas pendant l’inférence inferenceinférence machine learningapprentissage automatique The stage in which a trained AI model processes new input to produce a prediction, classification, decision, or generated output.Étape au cours de laquelle un modèle d'IA entraîné traite une nouvelle entrée pour produire une prédiction, une classification, une décision ou une sortie générée. (see also the Inference page) (voir aussi la page Inférence), une même requête peut donner des réponses différentes, avec le même modèle et une fenêtre contextuelle context windowfenêtre contextuelle language modelsmodèles de langue "The amount of input (like text) that an AI system can process at one time during a task. Think of it as a model's short-term memory. A model can only consider so much text when generating its next response, and once the conversation exceeds its context window, the model starts 'forgetting' prior responses." (Stanford HAI).Quantité d'entrée (du texte, par exemple) qu'un système d'IA peut traiter à la fois pendant une tâche ; en quelque sorte, la mémoire à court terme du modèle. Un modèle ne peut considérer qu'une quantité limitée de texte pour générer sa prochaine réponse et, quand la conversation dépasse sa fenêtre contextuelle, il commence à « oublier » les réponses antérieures (d'après Stanford HAI, traduction libre). identique. Le modèle calcule les mêmes probabilités les deux fois ; la différence vient de l’étape qui choisit un jeton parmi ces probabilités.
Le calcul du modèle se termine par une probabilité pour chaque jeton de son vocabulaire, et le choix d’un jeton parmi ces probabilités s’appelle le décodage decodingdécodage language modelsmodèles de langue The process used during text generation to turn a language model's predicted probabilities into an actual sequence of output tokens.Processus qui, pendant la génération de texte, transforme les probabilités prédites par un modèle de langue en une séquence réelle de jetons de sortie. (see also the One token at a time page) (voir aussi la page Un jeton à la fois).
Le jeton le plus probable, ou un choix au hasard
La règle la plus simple consiste à prendre chaque fois le jeton le plus probable.
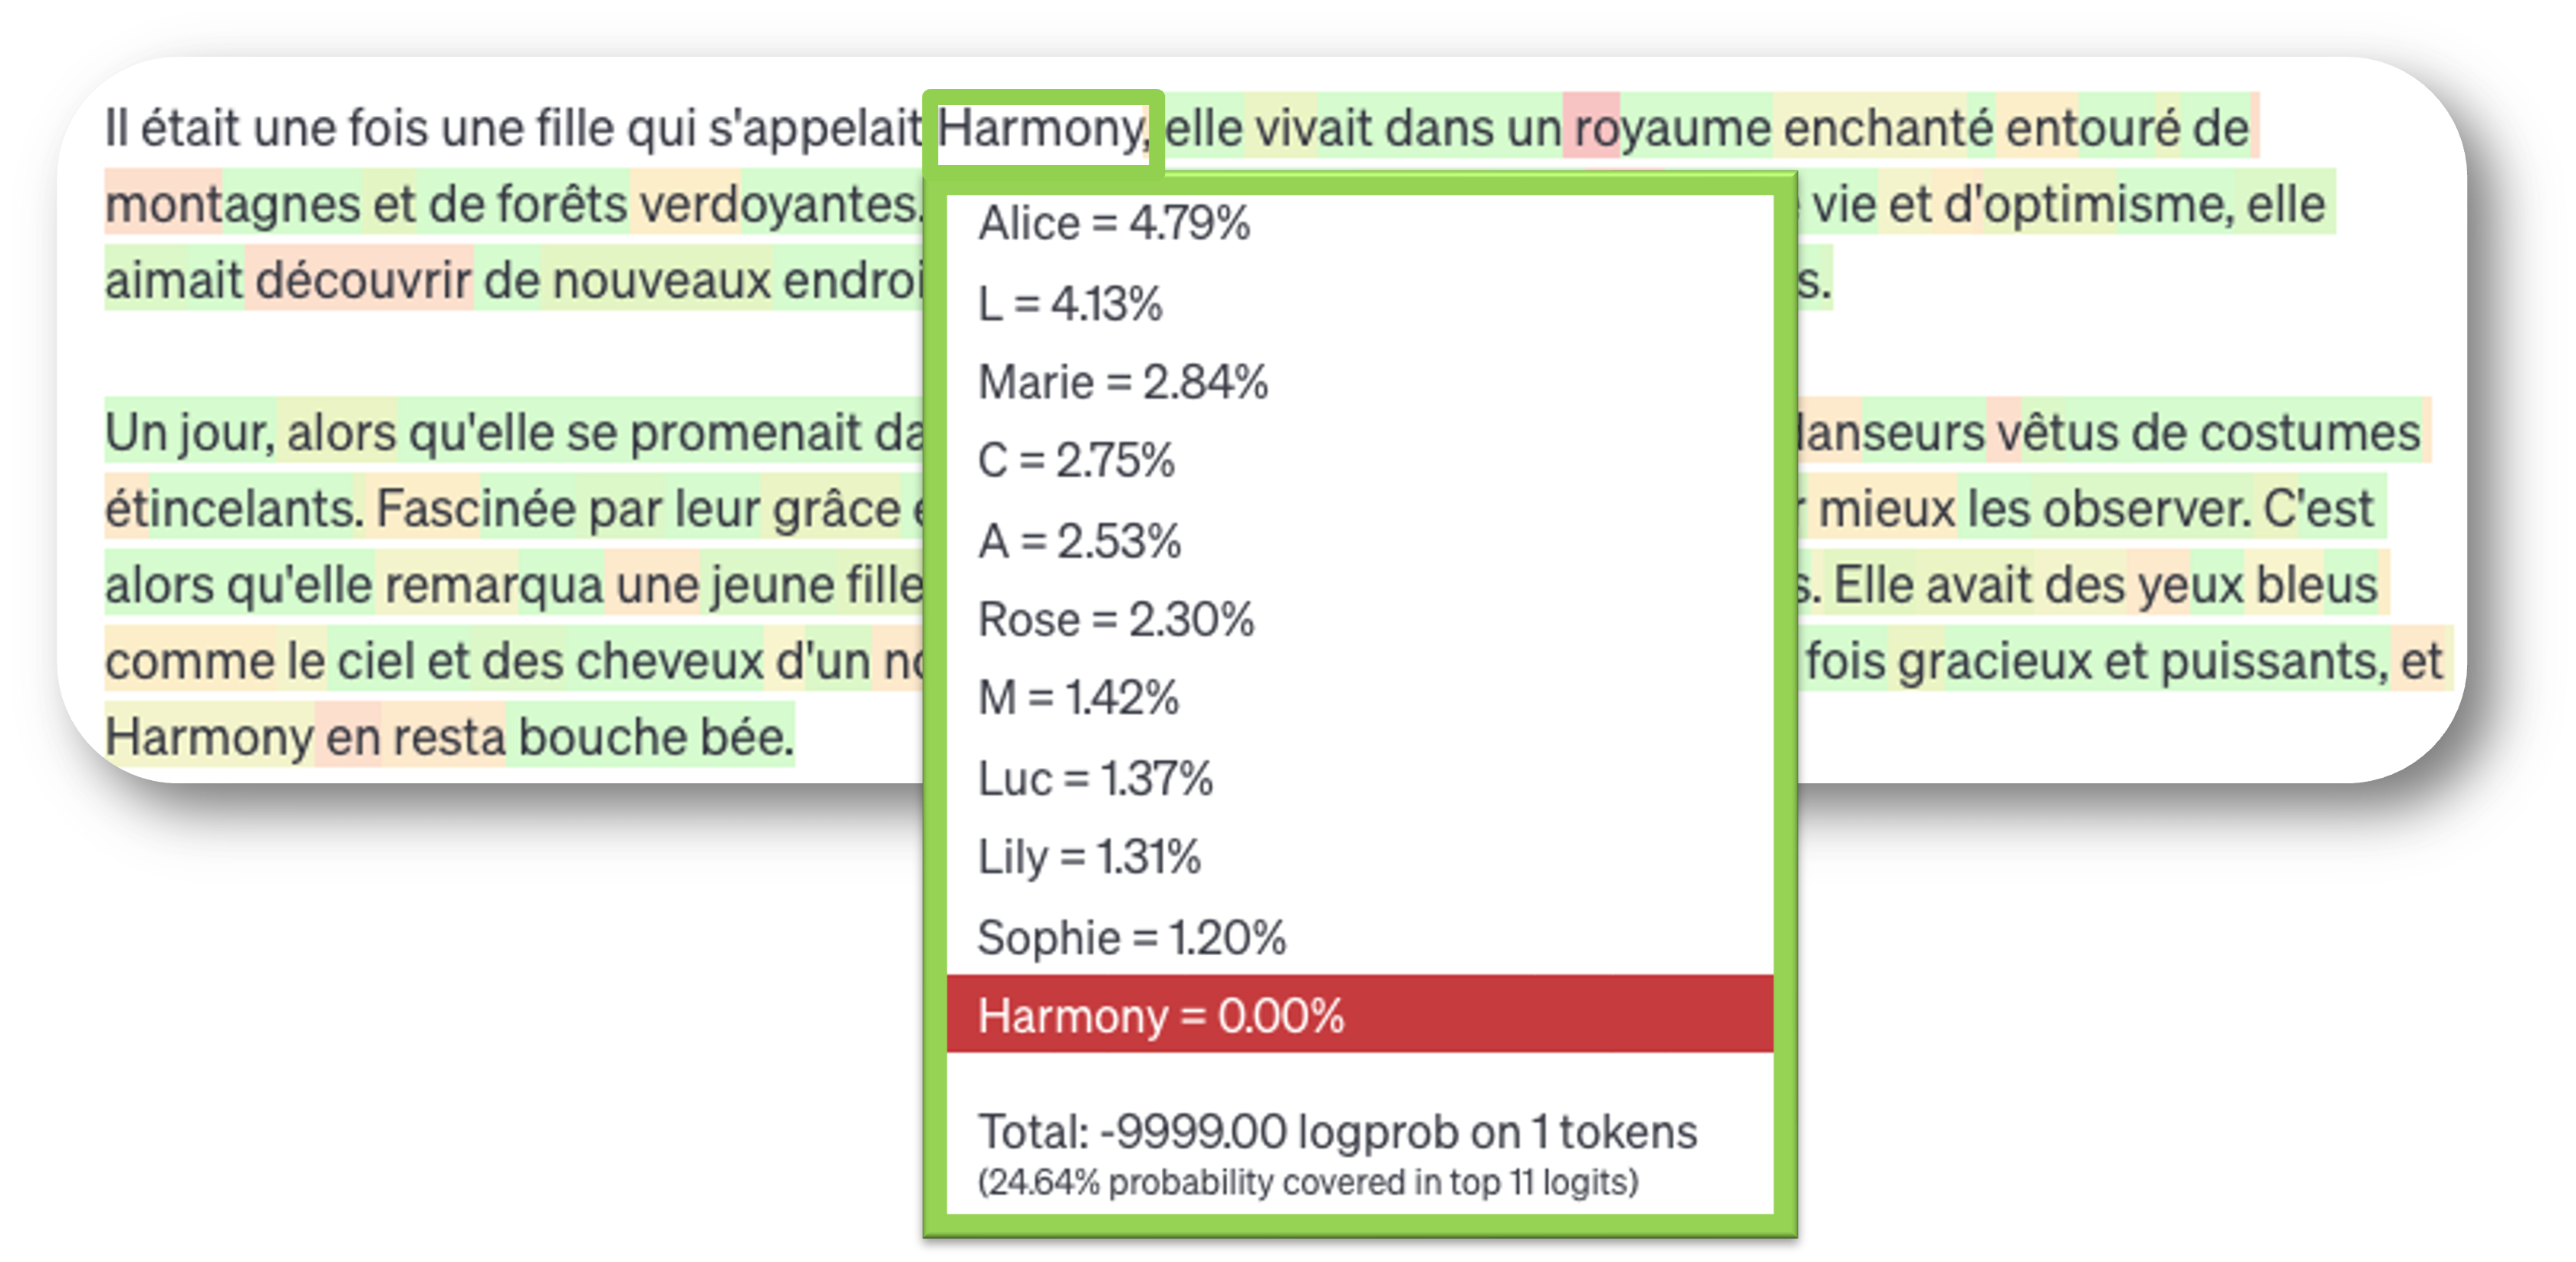
Les captures d’écran de cette page ont été prises en 2024 dans le Playground d’OpenAI, avec gpt-3.5-turbo-instruct, un ancien modèle qu’OpenAI retire le 28 septembre 2026. La couleur indique la probabilité de chaque jeton, du vert (probable) au rouge (peu probable), et chaque bloc coloré est un jeton plutôt qu’un mot, si bien qu’un même mot peut être coloré en plusieurs morceaux.
Dans la Figure 7figure 7, le modèle poursuit « Il était une fois une fille qui s’appelait » sans part de hasard, si bien qu’à chaque étape il prend le jeton le plus probable. Pour le prénom de la fille, il s’agit d’« Alice », à 4,82 %.
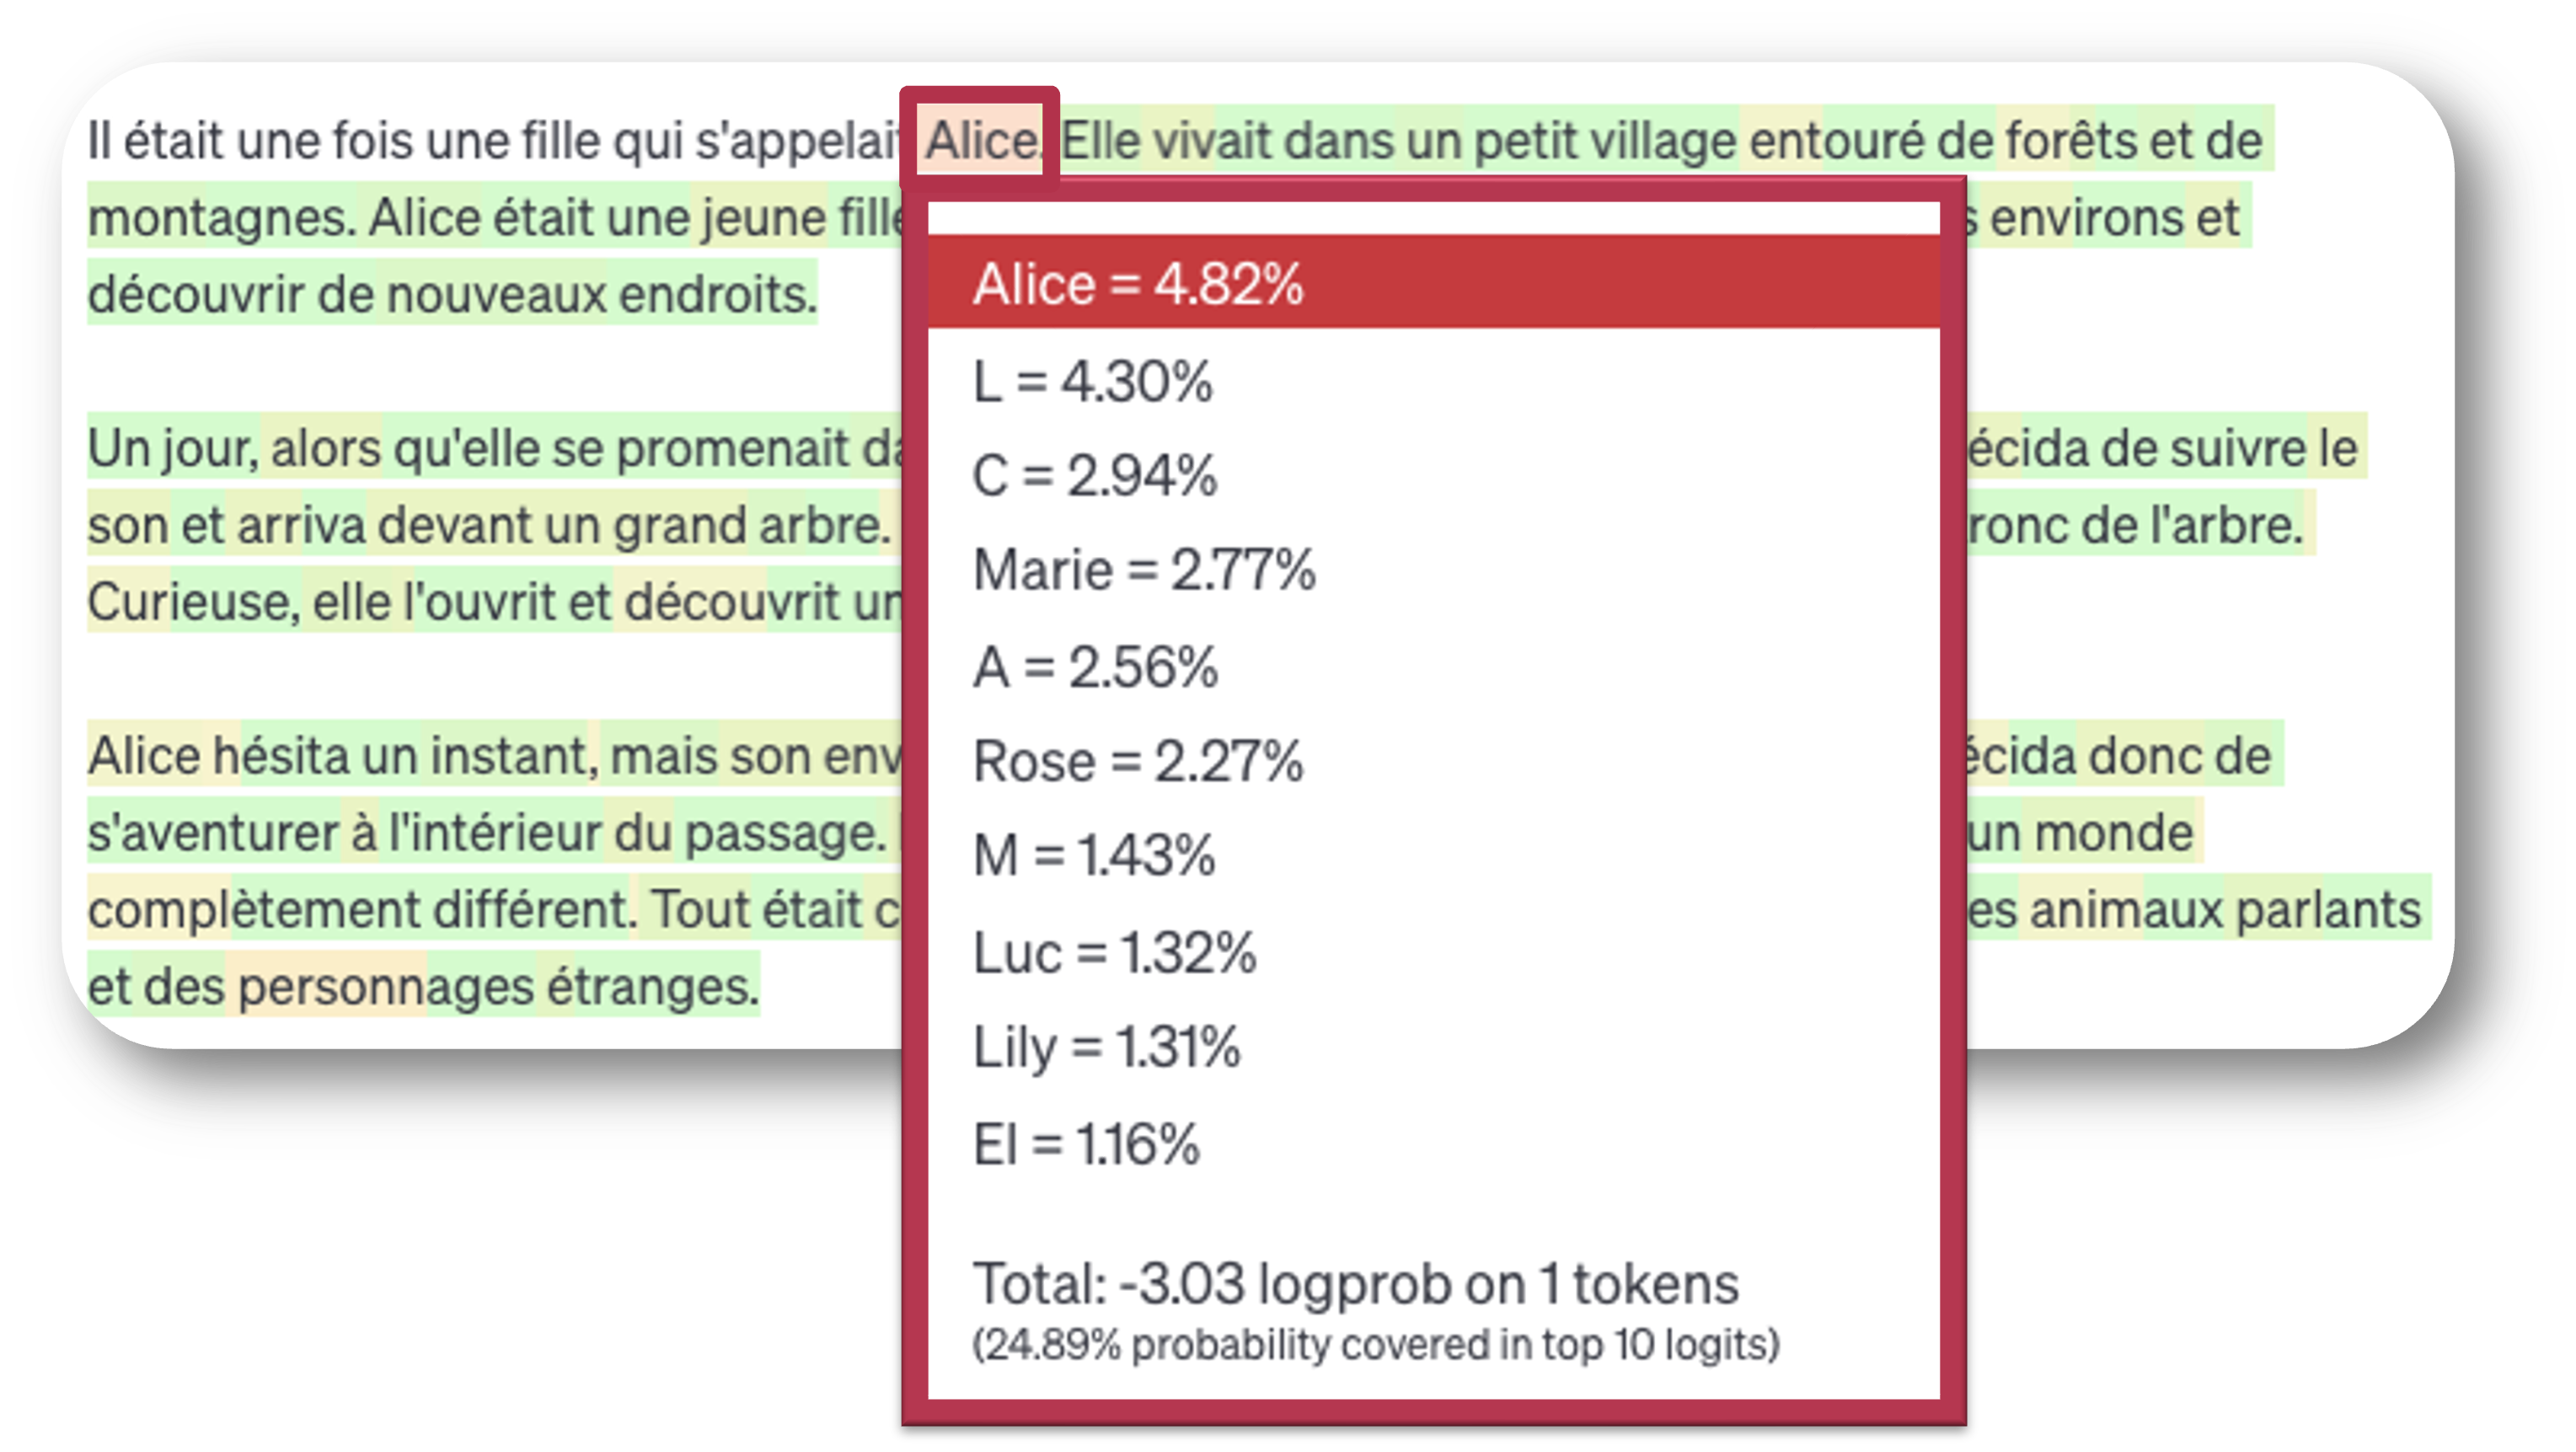
Ce choix peut sembler le plus sûr, mais il tend à produire un texte médiocre : prendre toujours le jeton le plus probable mène à des répétitions et à des boucles (Holtzman et al., 2020). La plupart des systèmes ajoutent donc une part de hasard.
Avec l’échantillonnage, un jeton probable a plus de chances d’être choisi, sans que ce soit certain. Dans une réponse courte, la différence est souvent faible. Dans une longue réponse, un seul choix différent au début peut changer tout ce qui est écrit ensuite.
La Figure 8figure 8 montre le même début avec échantillonnage. Le modèle a choisi « Harmony », un prénom affiché à 0,00 %, en dehors des dix candidats les plus probables, et l’histoire a pris une tout autre direction à partir de là.
Pourquoi la même question donne des réponses différentes
Les agents conversationnels échantillonnent leurs réponses, et la plupart ne permettent pas de désactiver cette part de hasard (see also the Temperature, top-p and top-k page) (voir aussi la page Température, top-p et top-k). Même quand cette part de hasard est réglée à zéro, les réponses ne sont pas entièrement déterministes : Ouyang et al. (2025) ont constaté que ChatGPT donnait encore des réponses différentes à des demandes de programmation identiques.La documentation de l’API d’Anthropic dit la même chose de ses propres modèles : même à une température temperaturetempérature language modelsmodèles de langue A setting that influences how predictable or varied a language model's output will be.Réglage qui influence le caractère prévisible ou varié de la sortie d'un modèle de langue. de 0, des entrées identiques peuvent produire des sorties différentes. Messages API reference, consultée le 14 septembre 2026.
Cela a deux conséquences :
- Une réponse ne prouve pas grand-chose. Une conclusion tirée d’une seule réponse peut ne pas se vérifier la fois suivante ; c’est pourquoi « j’ai essayé et ça a marché » en dit peu sur un système, et pourquoi les évaluations reposent sur de nombreuses réponses (see also the Evaluation foundations chapter, in the Evaluating language technology module) (voir aussi le chapitre Fondements de l'évaluation, dans le module L'évaluation des technologies langagières).
- Les résultats sont difficiles à reproduire. Obtenir deux fois le même résultat demande un effort délibéré, et même alors ce n’est pas garanti. Pour la recherche qui utilise des GML, c’est un vrai problème : une conclusion tirée des sorties d’un modèle peut ne pas tenir quand l’étude est refaite, ce qu’Ouyang et coll. (2025) décrivent comme une menace pour la validité de ce type de recherche (see also the Evaluation foundations chapter, in the Evaluating language technology module) (voir aussi le chapitre Fondements de l'évaluation, dans le module L'évaluation des technologies langagières).
Sources
- Holtzman, A., Buys, J., Du, L., Forbes, M., & Choi, Y. (2020). The Curious Case of Neural Text Degeneration. International Conference on Learning Representations (ICLR 2020). https://openreview.net/forum?id=rygGQyrFvH
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- Ma, I., Domingo, I., Krone-Martins, A., Baldi, P., & Lopes, C. (2025). Memorization: A Close Look at Books. Proceedings of the First Workshop on Large Language Model Memorization (L2M2), 169–182. https://doi.org/10.18653/v1/2025.l2m2-1.13
- Ouyang, S., Zhang, J. M., Harman, M., & Wang, M. (2025). An Empirical Study of the Non-Determinism of ChatGPT in Code Generation. ACM Transactions on Software Engineering and Methodology, 34(2). https://doi.org/10.1145/3697010