Errors spread through contextLes erreurs se propagent dans le contexte
TRA6008 OptionalFacultatif
A token cannot be taken back
An LLM large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. generates text one token at a time, a process called autoregressive generation autoregressive generationgénération autorégressive language modelsmodèles de langue A method of generating a sequence, such as text, one token at a time.Méthode de génération d'une séquence, comme un texte, un jeton à la fois. . Each new token is added to the text, and the next token is predicted from everything written so far, including the tokens the model wrote itself (see also the One token at a time page) (voir aussi la page Un jeton à la fois). Once a token has been written, it stays: the model has no way of going back to change it.
So when the model writes 1851 where the correct date is 1815, that wrong date becomes part of the text, and every token after it is predicted from a text that says 1851 (Figure 19figure 19).
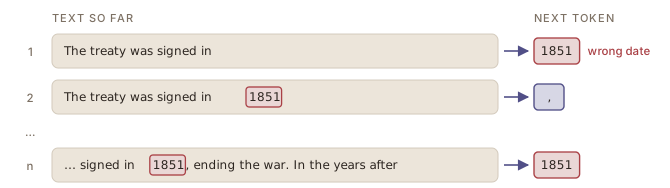
The result can be a long, coherent passage built around a detail that is not true, or an answer that contradicts itself because it cannot change how it began.
Over a whole conversation
The same happens across the messages of a conversation. When a request is spread over several messages, models tend to make assumptions early and attempt a final answer too soon, then build on it; once they have taken a wrong turn, they do not recover (Laban et al., 2026). The models tested did considerably worse on the same tasks when the request came in several messages than when it came in one (see also the Correcting the model or starting over page, in the Using LLMs module) (voir aussi la page Corriger le modèle ou recommencer, dans le module Utiliser les GML).
Un jeton écrit ne se reprend pas
Un grand modèle de langue large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. (GML) génère du texte un jeton à la fois, selon un processus appelé génération autorégressive autoregressive generationgénération autorégressive language modelsmodèles de langue A method of generating a sequence, such as text, one token at a time.Méthode de génération d'une séquence, comme un texte, un jeton à la fois. . Chaque nouveau jeton s’ajoute au texte, et le jeton suivant est prédit à partir de tout ce qui a été écrit jusque-là, y compris les jetons que le modèle a lui-même écrits (see also the One token at a time page) (voir aussi la page Un jeton à la fois). Une fois écrit, un jeton reste : le modèle n’a aucun moyen de revenir en arrière pour le modifier.
Ainsi, quand le modèle écrit 1851 alors que la bonne date est 1815, cette date erronée fait désormais partie du texte, et chaque jeton suivant est prédit à partir d’un texte qui indique 1851 (Figure 19figure 19).
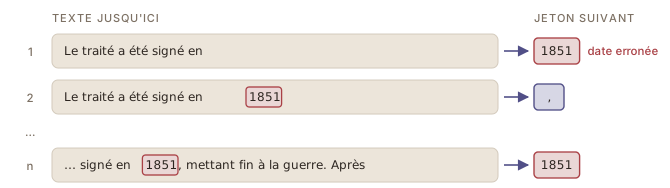
Il peut en résulter un long passage cohérent construit autour d’un détail faux, ou une réponse qui se contredit parce qu’elle ne peut pas changer sa manière de commencer.
Sur toute une conversation
Il en va de même d’un message à l’autre dans une conversation. Quand une demande est répartie sur plusieurs messages, les modèles ont tendance à faire des suppositions dès le début et à tenter trop vite une réponse définitive, puis à s’appuyer dessus ; une fois engagés sur une mauvaise voie, ils ne s’en remettent pas (Laban et al., 2026). Les modèles testés ont obtenu des résultats nettement moins bons sur les mêmes tâches quand la demande était formulée en plusieurs messages plutôt qu’en un seul (see also the Correcting the model or starting over page, in the Using LLMs module) (voir aussi la page Corriger le modèle ou recommencer, dans le module Utiliser les GML).
Sources
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- Laban, P., Hayashi, H., Zhou, Y., & Neville, J. (2026). LLMs Get Lost In Multi-Turn Conversation. The Fourteenth International Conference on Learning Representations (ICLR 2026). https://openreview.net/forum?id=VKGTGGcwl6