Giving examplesDonner des exemples
TRA6008 S3 · in classS3 · en classe
Showing rather than describing
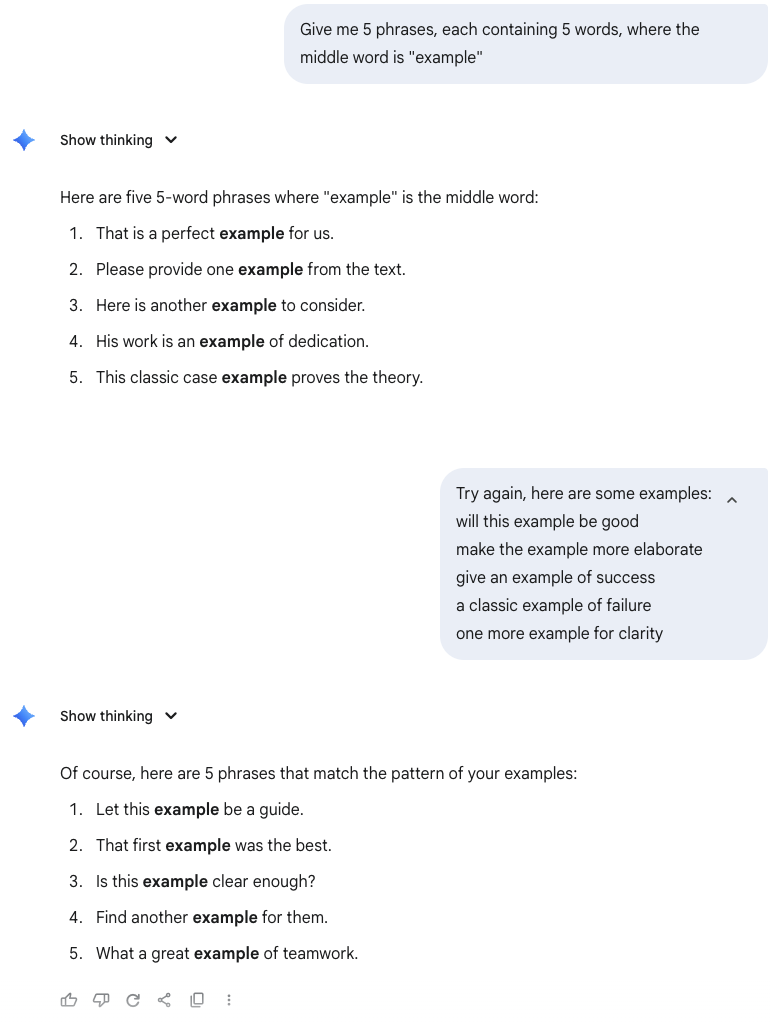
Asked in French for five phrases of five words with exemple as the middle word, a chatbot gave five phrases in which the word appeared anywhere but in the middle. Given a few examples of the pattern, it produced five that fit (Figure 7figure 7). The description had been clear, but the examples were clearer.
Few-shot prompting has been a standard technique since Brown et al. (2020) showed that GPT-3 could carry out new tasks from a few examples, an ability called in-context learning in-context learning (ICL)apprentissage en contexte promptingrequêtes The temporary adaptation of a language model's behaviour to information, instructions, or examples provided in its current prompt or context, without changing the model's parameters.Adaptation temporaire du comportement d'un modèle de langue à des informations, à des instructions ou à des exemples fournis dans sa requête ou son contexte courant, sans modification de ses paramètres. (see also the Zero-shot and few-shot prompting page, in the LLM lifecycle module) (voir aussi la page Requêtes sans exemple et avec quelques exemples, dans le module Cycle de vie des GML), and the providers’ current prompting guides all recommend it.For instance Anthropic, Prompting best practices: “Examples are one of the most reliable ways to steer Claude’s output format, tone, and structure”; OpenAI, Prompt engineering, under “Few-shot learning”; Google, Prompt design strategies: “We recommend to always include few-shot examples in your prompts.” All read 17 September 2026.
When examples help most
Examples are most useful where the result is easier to show than to describe:
- a format: how dates, units, headings or a reference should look;
- a style or register: “formal but not stiff” means different things to different people, and a paragraph written the way you want does not;
- a fixed set of answers: a rating of each customer review as positive, negative or mixed, or a label applied to each sentence of a text.
Choosing your examples
The examples you choose affect the answer in several ways (Schulhoff et al., 2024). Three properties make a difference:
- Correct answers. Larger models follow the answers in the examples closely, so a wrong example is likely to produce wrong answers (Wei et al., 2023b; Shi et al., 2024).Both measured on the models of 2023: GPT-3 and PaLM in Wei et al., Llama 2 in Shi et al. The direction, larger models following their examples more closely, is the finding to keep.
- Examples close to the real task. Cases like the ones you will ask about generally help more than distant ones.
- One consistent format, since the layout of the examples is part of what the model copies.
Their order and the balance of answers among them can change the result too, which is one more reason a few real cases of your own are the way to find out what works for your task (see also the Testing it yourself page) (voir aussi la page Faire vos propres tests).
How many
More examples generally help, particularly with larger models, though the gain levels off (Schulhoff et al., 2024). With long context windows context windowfenêtre contextuelle language modelsmodèles de langue "The amount of input (like text) that an AI system can process at one time during a task. Think of it as a model's short-term memory. A model can only consider so much text when generating its next response, and once the conversation exceeds its context window, the model starts 'forgetting' prior responses." (Stanford HAI).Quantité d'entrée (du texte, par exemple) qu'un système d'IA peut traiter à la fois pendant une tâche ; en quelque sorte, la mémoire à court terme du modèle. Un modèle ne peut considérer qu'une quantité limitée de texte pour générer sa prochaine réponse et, quand la conversation dépasse sa fenêtre contextuelle, il commence à « oublier » les réponses antérieures (d'après Stanford HAI, traduction libre). , hundreds of examples kept improving results on many tasks (Agarwal et al., 2024), but for translation the evidence is mixed: Agarwal et al. (2024) report gains for translation into two low-resource languages, Bemba and Kurdish, while Zou et al. (2025) found no clear gain in translation as examples were added.Agarwal et al. (2024) tested Gemini 1.5 Pro; Zou et al. (2025) tested twelve models of 2024, among them Llama 3.1, Qwen2, Mistral and Gemini 1.5 Pro. Every example also makes each request longer, slower and, on a paid service, more expensive (see also the Counting in tokens page, in the Language as numbers module) (voir aussi la page Compter en jetons, dans le module Le langage en nombres).
Montrer plutôt que décrire
Invité, en français, à écrire cinq phrases de cinq mots avec exemple comme mot du milieu, un agent conversationnel a donné cinq phrases où le mot apparaissait partout sauf au milieu. Après quelques exemples du motif attendu, il en a produit cinq qui convenaient (Figure 7figure 7). La description était claire, mais les exemples l’étaient davantage.
La formulation de requête avec quelques exemples est une technique courante depuis que Brown et al. (2020) ont montré que GPT-3 pouvait accomplir de nouvelles tâches à partir de quelques exemples, une capacité appelée apprentissage en contexte in-context learning (ICL)apprentissage en contexte promptingrequêtes The temporary adaptation of a language model's behaviour to information, instructions, or examples provided in its current prompt or context, without changing the model's parameters.Adaptation temporaire du comportement d'un modèle de langue à des informations, à des instructions ou à des exemples fournis dans sa requête ou son contexte courant, sans modification de ses paramètres. (see also the Zero-shot and few-shot prompting page, in the LLM lifecycle module) (voir aussi la page Requêtes sans exemple et avec quelques exemples, dans le module Cycle de vie des GML), et les guides de rédaction actuels des fournisseurs la recommandent tous.Par exemple Anthropic, Prompting best practices : « Examples are one of the most reliable ways to steer Claude’s output format, tone, and structure » ; OpenAI, Prompt engineering, à la section « Few-shot learning » ; Google, Prompt design strategies : « We recommend to always include few-shot examples in your prompts. » Tous consultés le 17 septembre 2026.
Quand les exemples aident le plus
Les exemples sont le plus utiles quand le résultat est plus facile à montrer qu’à décrire :
- un format : la présentation des dates, des unités, des intertitres ou d’une référence ;
- un style ou un registre : « soutenu sans être guindé » ne veut pas dire la même chose pour tout le monde, alors qu’un paragraphe écrit comme vous le voulez est sans ambiguïté ;
- un ensemble fermé de réponses : l’évaluation de chaque avis de client comme positif, négatif ou mitigé, ou une étiquette attribuée à chaque phrase d’un texte.
Choisir ses exemples
Les exemples que vous choisissez influent sur la réponse de plusieurs façons (Schulhoff et al., 2024). Trois propriétés comptent :
- Des réponses justes. Les grands modèles suivent de près les réponses des exemples : un exemple erroné risque donc de produire des réponses erronées (Wei et al., 2023b ; Shi et al., 2024).Les deux études portent sur des modèles de 2023 : GPT-3 et PaLM chez Wei et al., Llama 2 chez Shi et al. Le constat à retenir est la tendance : plus un modèle est grand, plus il suit ses exemples.
- Des exemples proches de la tâche réelle. Des cas semblables à ceux que vous soumettrez aident en général davantage que des cas éloignés.
- Un format cohérent, puisque la présentation des exemples fait partie de ce que le modèle copie.
Leur ordre et la répartition des réponses entre eux peuvent aussi changer le résultat : raison de plus pour découvrir ce qui fonctionne pour votre tâche avec quelques vrais cas à vous (see also the Testing it yourself page) (voir aussi la page Faire vos propres tests).
Combien d’exemples
Davantage d’exemples aident en général, surtout avec les grands modèles, mais le gain plafonne (Schulhoff et al., 2024). Avec de longues fenêtres contextuelles context windowfenêtre contextuelle language modelsmodèles de langue "The amount of input (like text) that an AI system can process at one time during a task. Think of it as a model's short-term memory. A model can only consider so much text when generating its next response, and once the conversation exceeds its context window, the model starts 'forgetting' prior responses." (Stanford HAI).Quantité d'entrée (du texte, par exemple) qu'un système d'IA peut traiter à la fois pendant une tâche ; en quelque sorte, la mémoire à court terme du modèle. Un modèle ne peut considérer qu'une quantité limitée de texte pour générer sa prochaine réponse et, quand la conversation dépasse sa fenêtre contextuelle, il commence à « oublier » les réponses antérieures (d'après Stanford HAI, traduction libre). , des centaines d’exemples continuaient d’améliorer les résultats pour de nombreuses tâches (Agarwal et al., 2024), mais en traduction, les données sont partagées : Agarwal et al. (2024) observent des gains pour la traduction vers deux langues à faibles ressources, le bemba et le kurde, alors que Zou et al. (2025) ne constatent pas de gain net en traduction à mesure qu’on ajoute des exemples.Agarwal et al. (2024) ont testé Gemini 1.5 Pro ; Zou et al. (2025) ont testé douze modèles de 2024, dont Llama 3.1, Qwen2, Mistral et Gemini 1.5 Pro. Chaque exemple allonge aussi chaque demande, la ralentit et, sur un service payant, la rend plus coûteuse (see also the Counting in tokens page, in the Language as numbers module) (voir aussi la page Compter en jetons, dans le module Le langage en nombres).
Sources
- Agarwal, R., Singh, A., Zhang, L., Bohnet, B., Rosias, L., Chan, S., et al. (2024). Many-Shot In-Context Learning. Advances in Neural Information Processing Systems 37 (NeurIPS 2024). https://proceedings.neurips.cc/paper_files/paper/2024/hash/8cb564df771e9eacbfe9d72bd46a24a9-Abstract-Conference.html
- Brown, T. B., Mann, B., Ryder, N., Subbiah, M., Kaplan, J., Dhariwal, P., et al. (2020). Language Models are Few-Shot Learners. Advances in Neural Information Processing Systems 33 (NeurIPS 2020). https://proceedings.neurips.cc/paper/2020/hash/1457c0d6bfcb4967418bfb8ac142f64a-Abstract.html
- Schulhoff, S., Ilie, M., Balepur, N., Kahadze, K., Liu, A., Si, C., et al. (2024). The Prompt Report: A Systematic Survey of Prompt Engineering Techniques. arXiv:2406.06608 (preprint). https://arxiv.org/abs/2406.06608
- Shi, Z., Wei, J., Xu, Z., & Liang, Y. (2024). Why Larger Language Models Do In-context Learning Differently?. Proceedings of the 41st International Conference on Machine Learning (ICML 2024), PMLR 235, 44991–45013. https://proceedings.mlr.press/v235/shi24f.html
- Wei, J., Wei, J., Tay, Y., Tran, D., Webson, A., Lu, Y., et al. (2023b). Larger language models do in-context learning differently. Preprint, arXiv:2303.03846 (submitted to ICLR 2024). https://openreview.net/forum?id=DRGnEkbiQZ
- Zou, K., Khalifa, M., & Wang, L. (2025). On Many-Shot In-Context Learning for Long-Context Evaluation. Proceedings of the 63rd Annual Meeting of the Association for Computational Linguistics (ACL 2025), 25605–25639. https://doi.org/10.18653/v1/2025.acl-long.1245