Working with long documentsTravailler avec de longs documents
TRA6008 OptionalFacultatif
What happens to a file you attach
When you attach a ten-page contract and ask what it says about liability, the file is not stored somewhere the model consults. Its text is added to the context window context windowfenêtre contextuelle language modelsmodèles de langue "The amount of input (like text) that an AI system can process at one time during a task. Think of it as a model's short-term memory. A model can only consider so much text when generating its next response, and once the conversation exceeds its context window, the model starts 'forgetting' prior responses." (Stanford HAI).Quantité d'entrée (du texte, par exemple) qu'un système d'IA peut traiter à la fois pendant une tâche ; en quelque sorte, la mémoire à court terme du modèle. Un modèle ne peut considérer qu'une quantité limitée de texte pour générer sa prochaine réponse et, quand la conversation dépasse sa fenêtre contextuelle, il commence à « oublier » les réponses antérieures (d'après Stanford HAI, traduction libre). , in one of two ways (Figure 8figure 8):
- whole, when the file is small enough: the model sees every page;
- searched, when the file, or the set of files in a project, is too large: a search picks out the passages that match your question and only those are added, so the model never sees the rest. This is retrieval-augmented generation retrieval-augmented generation (RAG)génération augmentée par récupération (GAR) language modelsmodèles de langue A technique for improving the answers of a large language model by retrieving passages from an external source, such as a document collection or a web search, and adding them to the model's context before it generates its answer.Technique visant à améliorer les réponses d'un grand modèle de langue en extrayant des passages d'une source externe, par exemple une collection de documents ou une recherche Web, et en les ajoutant au contexte du modèle avant qu'il génère sa réponse. (RAG), the mechanism behind most “chat with your documents” features.
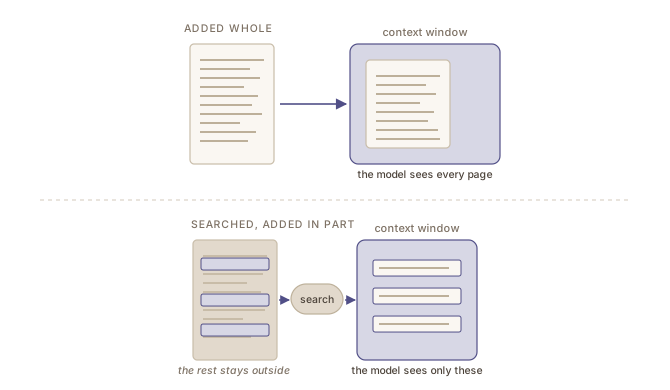
The difference changes what you can ask. A summary of a searched document covers only the passages the search found, and a question whose answer is spread across the document can get an answer built on the wrong extract. As a rule, a file of a few pages is added whole, and a set of long files in a project is searched.Anthropic switches a project to searching its files once they approach the size of the context window: Claude Help Center, RAG for Projects, read 14 September 2026. OpenAI does not say where ChatGPT switches, but it accepts text files of up to 2 million tokens each, more than fits in any current context window: OpenAI Help Center, File Uploads FAQ, read 17 September 2026.
A long input is not read evenly
Even when the whole document is in the context, the model does not use all of it equally well: models do clearly worse on long inputs than on short ones, well within the size they advertise, and some parts of a long input are used less reliably than others (see also the context window page, in the LLM lifecycle module) (voir aussi la page La fenêtre contextuelle, dans le module Cycle de vie des GML). Two practical consequences follow:
- Keep the document and the question clearly apart, and try both orders on your model, since the providers’ guides do not agree on which comes first.Anthropic and Google recommend putting a long document first and the question at the end, while OpenAI’s guide puts the instructions first and the material after them: Anthropic, Prompting best practices, “Long context prompting”; Google, Prompt design strategies; OpenAI, Prompt engineering. All read 17 September 2026.
- Ask about one part at a time when the answer has to be exact: the clause, the section, the chapter, rather than the whole file.
A long answer stops
A model can only write a limited number of tokens in one answer, far fewer than it can read (see also the context window page, in the LLM lifecycle module) (voir aussi la page La fenêtre contextuelle, dans le module Cycle de vie des GML). Asked to rewrite or translate a fifty-page document, a model may do the first pages and offer to continue, stop mid-sentence, or shorten the later pages without saying so. For anything long:
- work in parts of a size the model handles well, a few pages at a time, and keep the parts in a document of your own;
- give each part what it needs: the terms and style decisions taken in earlier parts, and the paragraph before it for continuity, since a new request starts with none of that;
- check the joins, where a term or a tense chosen in one part can differ from the next.
Ce que devient un fichier joint
Quand vous joignez un contrat de dix pages et demandez ce qu’il dit de la responsabilité, le fichier n’est pas rangé quelque part où le modèle irait le consulter. Son texte est ajouté à la fenêtre contextuelle context windowfenêtre contextuelle language modelsmodèles de langue "The amount of input (like text) that an AI system can process at one time during a task. Think of it as a model's short-term memory. A model can only consider so much text when generating its next response, and once the conversation exceeds its context window, the model starts 'forgetting' prior responses." (Stanford HAI).Quantité d'entrée (du texte, par exemple) qu'un système d'IA peut traiter à la fois pendant une tâche ; en quelque sorte, la mémoire à court terme du modèle. Un modèle ne peut considérer qu'une quantité limitée de texte pour générer sa prochaine réponse et, quand la conversation dépasse sa fenêtre contextuelle, il commence à « oublier » les réponses antérieures (d'après Stanford HAI, traduction libre). , de l’une de deux façons (Figure 8figure 8) :
- en entier, quand le fichier est assez petit : le modèle voit chaque page ;
- par recherche, quand le fichier, ou l’ensemble des fichiers d’un projet, est trop volumineux : une recherche repère les passages qui correspondent à votre question, et seuls ceux-là sont ajoutés, si bien que le modèle ne voit jamais le reste. C’est la génération augmentée par récupération retrieval-augmented generation (RAG)génération augmentée par récupération (GAR) language modelsmodèles de langue A technique for improving the answers of a large language model by retrieving passages from an external source, such as a document collection or a web search, and adding them to the model's context before it generates its answer.Technique visant à améliorer les réponses d'un grand modèle de langue en extrayant des passages d'une source externe, par exemple une collection de documents ou une recherche Web, et en les ajoutant au contexte du modèle avant qu'il génère sa réponse. (GAR, angl. RAG), le mécanisme derrière la plupart des fonctionnalités qui permettent de « discuter avec vos documents ».
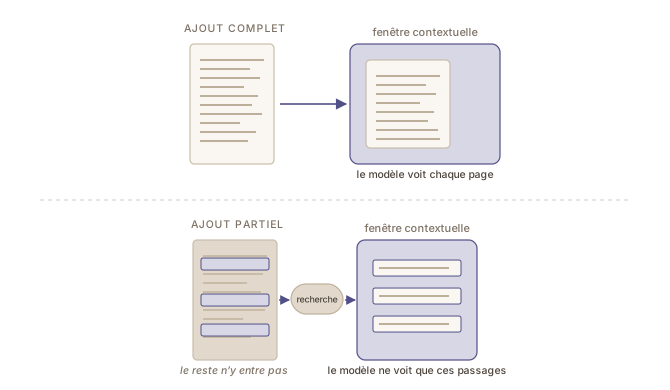
La différence compte pour ce que vous pouvez demander. Le résumé d’un document parcouru par recherche ne porte que sur les passages que la recherche a trouvés, et une question dont la réponse est répartie dans tout le document peut recevoir une réponse fondée sur le mauvais extrait. En règle générale, un fichier de quelques pages est ajouté en entier, et un ensemble de longs fichiers dans un projet est parcouru par recherche.Anthropic fait passer un projet à la recherche dans ses fichiers quand ceux-ci approchent la taille de la fenêtre contextuelle : Claude Help Center, RAG for Projects, consulté le 14 septembre 2026. OpenAI ne dit pas à quel moment ChatGPT change de méthode, mais accepte des fichiers texte de jusqu’à 2 millions de jetons chacun, plus que ne peut en contenir aucune fenêtre contextuelle actuelle : OpenAI Help Center, File Uploads FAQ, consulté le 17 septembre 2026.
Une longue entrée n’est pas lue uniformément
Même quand tout le document est dans le contexte, le modèle ne l’exploite pas partout aussi bien : les modèles font nettement moins bien sur les longues entrées que sur les courtes, bien en deçà de la taille qu’ils annoncent, et certaines parties d’une longue entrée sont exploitées de façon moins fiable que d’autres (see also the context window page, in the LLM lifecycle module) (voir aussi la page La fenêtre contextuelle, dans le module Cycle de vie des GML). Deux conséquences pratiques en découlent :
- Séparez clairement le document et la question, et essayez les deux ordres sur votre modèle, car les guides des fournisseurs ne s’accordent pas sur ce qui vient en premier.Anthropic et Google recommandent de placer un long document en premier et la question à la fin, alors que le guide d’OpenAI place les consignes en premier et le document ensuite : Anthropic, Prompting best practices, « Long context prompting » ; Google, Prompt design strategies ; OpenAI, Prompt engineering. Tous consultés le 17 septembre 2026.
- Interrogez une partie à la fois quand la réponse doit être exacte : l’article, la section, le chapitre, plutôt que le fichier entier.
Une longue réponse s’arrête
Un modèle ne peut écrire qu’un nombre limité de jetons dans une réponse, bien moins qu’il ne peut en lire (see also the context window page, in the LLM lifecycle module) (voir aussi la page La fenêtre contextuelle, dans le module Cycle de vie des GML). Si vous demandez à un modèle de réécrire ou de traduire un document de cinquante pages, il peut traiter les premières pages et proposer de continuer, s’arrêter au milieu d’une phrase, ou raccourcir les pages suivantes sans le dire. Pour tout texte long :
- travaillez par parties d’une taille que le modèle traite bien, quelques pages à la fois, et rassemblez les parties dans un document à vous ;
- donnez à chaque partie ce dont elle a besoin : les termes et les choix de style arrêtés dans les parties précédentes, et le paragraphe qui précède pour la continuité, puisqu’une nouvelle demande ne dispose de rien de tout cela ;
- vérifiez les raccords, où un terme ou un temps de verbe choisi dans une partie peut différer de la suivante.