Chat app, API or your own computerApplication, API ou votre propre ordinateur
TRA6008 S3 · in classS3 · en classe
Three ways in
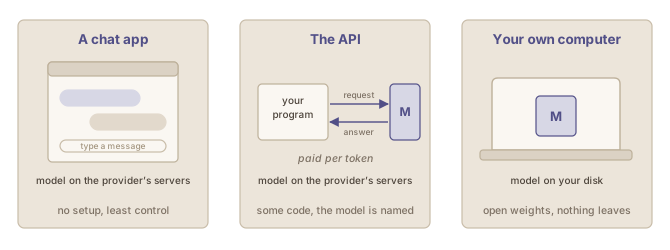
You can reach a model in three ways, which differ in effort, in control, in cost and in who has access to your text (Figure 9figure 9).
| Chat app | API | Your own computer | |
|---|---|---|---|
| Effort | none | some code | hardware and setup |
| Who picks the model | often the product | you | you |
| What it costs | a subscription or a free plan | per token | your hardware and time |
| Who has access to your text | the provider | the provider | you |
A chat app
Most people interact with models through a chat app in the browser or on the phone. A chat app is the easiest arrangement, and the one with the least control:
- easy: nothing to install, a conversation history, file upload, search and other tools built in;
- little control: you do not see the system prompt system promptrequête générative système promptingrequêtes An instruction supplied to a language model before or alongside the user's input that establishes the model's role, task, behavioural rules, tone, or other context for the interaction.Instruction fournie à un modèle de langue avant l'entrée de l'utilisateur, ou en parallèle, qui établit le rôle du modèle, sa tâche, ses règles de conduite, son ton ou d'autres éléments de contexte pour l'interaction. , features change without notice, and which model answers is partly the product’s decision rather than yours (see also the Execution “effort” page) (voir aussi la page L'« effort » d'exécution).
The API
With the API, a program of yours, or a program somebody wrote for you, sends requests to the provider’s servers and receives the answers. The API takes a little code, and gives you more control:
- you name the exact model and effort instead of taking what the product gives you;
- you control the system prompt and some of the settings (see also the Temperature, top-p and top-k page, in the LLM lifecycle module) (voir aussi la page Température, top-p et top-k, dans le module Cycle de vie des GML);
- you can send the same request a hundred times to compare the answers.
Your control over the system prompt is not always complete, though. The long system prompt a chat app adds is not there, but a provider can still add text of its own. Anthropic and OpenAI, for instance, both add text to the system prompt whenever a request uses tools, and OpenAI states that it may also insert instructions of its own that the developer does not see.Anthropic, System prompts (“These system prompt updates do not apply to the Claude API”) and Tool use with Claude, both read 16 September 2026. OpenAI, Function calling (“functions are injected into the system message”) and the Model Spec of 18 August 2026 (“OpenAI may insert system messages into the input to steer the assistant’s behavior”; developers “may not be aware of the existence or contents of the system messages”), both read 18 September 2026. And whatever your system prompt says, the behaviour trained into the model during fine-tuning fine-tuningaffinage machine learningapprentissage automatique Further training of a pretrained model on new data to adapt it for a particular task, domain, or intended behaviour.Poursuite de l'entraînement d'un modèle préentraîné sur un jeu de données généralement plus restreint et spécialisé, afin de l'adapter à une tâche ou à un domaine particulier. still applies (see also the Alignment chapter, in the LLM lifecycle module) (voir aussi le chapitre Alignement, dans le module Cycle de vie des GML).
Each request is paid for by the tokens it sends and receives, under token-based billing token-based billingtarification à l'usage selon le nombre de jetons AIIA A usage-pricing method in which the charge for a model request is calculated from the number and category of tokens processed.Méthode de tarification à l'usage dans laquelle le coût d'une demande au modèle se calcule d'après le nombre et la catégorie des jetons traités. (see also the Counting in tokens page, in the Language as numbers module) (voir aussi la page Compter en jetons, dans le module Le langage en nombres).
A model on your own computer
The third way is to download an open-weight model and run it on your own computer. Compared with the other two ways:
- privacy: nothing leaves your machine, which for confidential material is the only arrangement that removes the question of who has access to your text;
- effort: it takes hardware and setup;
- capability: the models that fit on a laptop are well behind the largest hosted ones, and at the time of writing, even the largest open-weight models, which need a powerful server, generally trail the best hosted models.
Open weights do not make a model open in every sense. What you may do with the model depends on the licence its weights weightpoids machine learningapprentissage automatique A real number attached to one input of a computing unit, learned during training, that sets how much that input counts towards the unit's output.Nombre réel attaché à une entrée d'une unité de calcul, appris pendant l'entraînement, qui détermine l'importance de cette entrée dans la sortie de l'unité. are released under, and the training data and training code usually stay unpublished. An open-weight model is therefore not the same as open-source AI, which would let others study and rebuild how the model was made (Open Source Initiative, 2025).
What paying per token shows
With a subscription, you pay a fixed amount and do not see what each message costs. With the API, you pay for every token, so you see what makes an exchange expensive. Knowing this also helps you understand the limits of a subscription.
- The whole conversation is sent again with every new message. The model keeps nothing between messages: it writes each answer one token at a time, continuing the whole text of the conversation so far, through autoregressive generation autoregressive generationgénération autorégressive language modelsmodèles de langue A method of generating a sequence, such as text, one token at a time.Méthode de génération d'une séquence, comme un texte, un jeton à la fois. (see also the One token at a time page, in the LLM lifecycle module) (voir aussi la page Un jeton à la fois, dans le module Cycle de vie des GML). Your tenth message is therefore sent with the nine messages before it and their answers, so a long exchange costs many times what its last message suggests (see also the context window page, in the LLM lifecycle module) (voir aussi la page La fenêtre contextuelle, dans le module Cycle de vie des GML).
- Output costs more than input. Providers charge several times more per token for what the model writes than for what it reads.
- Reasoning is billed. The tokens a model generates while reasoning count as output, whether or not you are shown them.
On a subscription, the same costs count against your usage limit, which is why you reach the limit sooner in a long conversation with a large model.
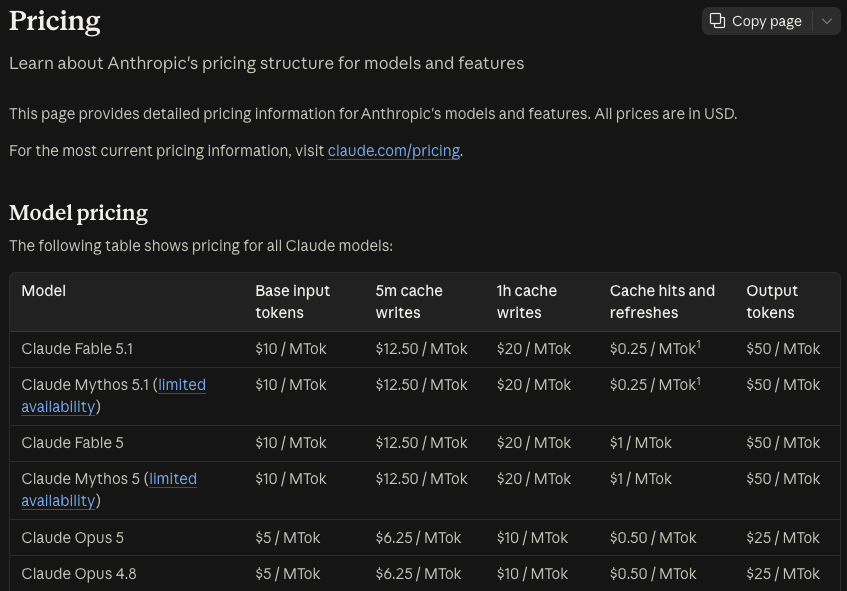
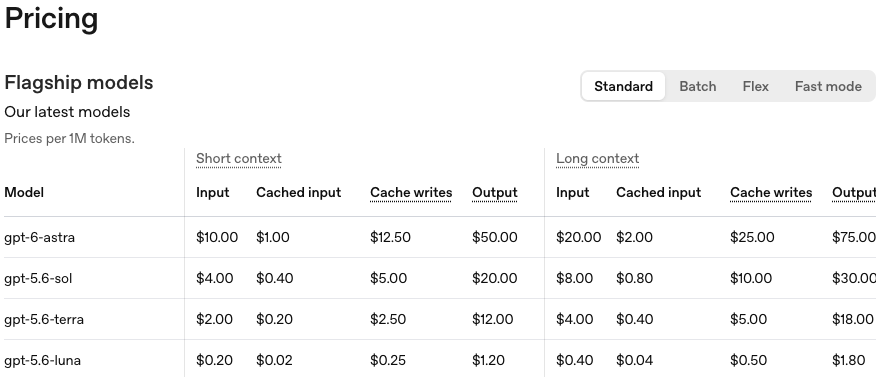
For an idea of scale, here are the smallest and the largest model on both providers’ API price lists, in US dollars per million tokens (Figure 10figure 10 and Figure 11figure 11):Anthropic pricing and OpenAI pricing, both read 16 September 2026.
| Provider | Model | Input | Output |
|---|---|---|---|
| Anthropic, smallest | Claude Haiku 4.5 | 1 | 5 |
| Anthropic, largest | Claude Fable 5.1 | 10 | 50 |
| OpenAI, smallest | GPT-5.6 Luna | 0.20 | 1.20 |
| OpenAI, largest | GPT-6 Astra | 10 | 50 |
Two things stand out:
- output costs five to six times as much as input;
- the largest model costs many times more than the smallest: about ten times more at Anthropic, about fifty times more at OpenAI.
OpenAI also charges more when the context is long.
Trois façons d’accéder à un modèle
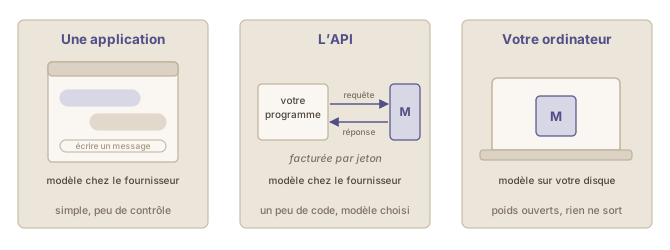
On peut accéder à un modèle de trois façons, qui diffèrent par l’effort demandé, le contrôle, le coût et les personnes qui ont accès à votre texte (Figure 9figure 9).
| Application conversationnelle | API | Votre ordinateur | |
|---|---|---|---|
| Effort | aucun | un peu de code | matériel et installation |
| Qui choisit le modèle | souvent le produit | vous | vous |
| Coût | un abonnement ou un forfait gratuit | au jeton | votre matériel et votre temps |
| Qui a accès à votre texte | le fournisseur | le fournisseur | vous |
Une application conversationnelle
La plupart des gens utilisent les modèles au moyen d’une application conversationnelle, dans le navigateur ou sur le téléphone. Une application conversationnelle est la formule la plus simple, et celle qui laisse le moins de contrôle :
- la simplicité : rien à installer, un historique des conversations, le téléversement de fichiers, la recherche et d’autres outils intégrés ;
- peu de contrôle : vous ne voyez pas la requête générative système system promptrequête générative système promptingrequêtes An instruction supplied to a language model before or alongside the user's input that establishes the model's role, task, behavioural rules, tone, or other context for the interaction.Instruction fournie à un modèle de langue avant l'entrée de l'utilisateur, ou en parallèle, qui établit le rôle du modèle, sa tâche, ses règles de conduite, son ton ou d'autres éléments de contexte pour l'interaction. , les fonctionnalités changent sans préavis, et le modèle qui répond relève en partie du produit plutôt que de vous (see also the Execution “effort” page) (voir aussi la page L'« effort » d'exécution).
L’API
Avec l’interface de programmation d’application (API), un programme à vous, ou écrit pour vous, envoie des requêtes aux serveurs du fournisseur et reçoit les réponses. L’API demande un peu de code, et vous donne plus de contrôle :
- vous désignez le modèle et l’effort exacts au lieu de prendre ce que le produit vous donne ;
- vous contrôlez la requête générative système et une partie des réglages (see also the Temperature, top-p and top-k page, in the LLM lifecycle module) (voir aussi la page Température, top-p et top-k, dans le module Cycle de vie des GML) ;
- vous pouvez envoyer la même requête cent fois pour comparer les réponses.
Votre contrôle sur la requête générative système n’est toutefois pas toujours complet. La longue requête système qu’ajoute une application conversationnelle est absente, mais le fournisseur peut tout de même ajouter un texte de son cru. Anthropic et OpenAI, par exemple, ajoutent tous deux du texte à la requête système chaque fois qu’une requête fait appel à des outils, et OpenAI indique qu’elle peut aussi insérer ses propres instructions, que le développeur ne voit pas.Anthropic, System prompts (« These system prompt updates do not apply to the Claude API ») et Tool use with Claude, tous deux consultés le 16 septembre 2026. OpenAI, Function calling (« functions are injected into the system message ») et la Model Spec du 18 août 2026 (« OpenAI may insert system messages into the input to steer the assistant’s behavior » ; les développeurs « may not be aware of the existence or contents of the system messages »), toutes deux consultées le 18 septembre 2026. Et quoi que dise votre requête système, le comportement appris par le modèle pendant l’affinage fine-tuningaffinage machine learningapprentissage automatique Further training of a pretrained model on new data to adapt it for a particular task, domain, or intended behaviour.Poursuite de l'entraînement d'un modèle préentraîné sur un jeu de données généralement plus restreint et spécialisé, afin de l'adapter à une tâche ou à un domaine particulier. continue de s’appliquer (see also the Alignment chapter, in the LLM lifecycle module) (voir aussi le chapitre Alignement, dans le module Cycle de vie des GML).
Chaque requête est payée selon les jetons qu’elle envoie et reçoit, par tarification à l’usage selon le nombre de jetons token-based billingtarification à l'usage selon le nombre de jetons AIIA A usage-pricing method in which the charge for a model request is calculated from the number and category of tokens processed.Méthode de tarification à l'usage dans laquelle le coût d'une demande au modèle se calcule d'après le nombre et la catégorie des jetons traités. (see also the Counting in tokens page, in the Language as numbers module) (voir aussi la page Compter en jetons, dans le module Le langage en nombres).
Un modèle sur votre ordinateur
La troisième façon consiste à télécharger un modèle à poids ouverts et à le faire tourner sur votre ordinateur. Par rapport aux deux autres façons :
- la confidentialité : rien ne quitte votre machine, ce qui, pour des documents confidentiels, est la seule formule qui règle la question de savoir qui a accès à votre texte ;
- l’effort : il faut du matériel et de l’installation ;
- la capacité : les modèles qui tiennent sur un ordinateur portable sont nettement en retrait des plus grands modèles hébergés, et au moment d’écrire ces lignes, même les plus grands modèles à poids ouverts, qui demandent un serveur puissant, restent généralement derrière les meilleurs modèles hébergés.
Des poids ouverts ne rendent pas un modèle ouvert à tous égards. Ce que vous pouvez faire du modèle dépend de la licence sous laquelle ses poids weightpoids machine learningapprentissage automatique A real number attached to one input of a computing unit, learned during training, that sets how much that input counts towards the unit's output.Nombre réel attaché à une entrée d'une unité de calcul, appris pendant l'entraînement, qui détermine l'importance de cette entrée dans la sortie de l'unité. sont diffusés, et les données et le code d’entraînement restent généralement inédits. Un modèle à poids ouverts n’est donc pas une IA à code source ouvert, qui permettrait à d’autres d’étudier et de refaire la construction du modèle (Open Source Initiative, 2025).
Ce que montre le paiement au jeton
Avec un abonnement, vous payez un montant fixe et ne voyez pas ce que coûte chaque message. Avec l’API, vous payez chaque jeton, et vous voyez donc ce qui rend un échange coûteux. Savoir cela aide aussi à comprendre les limites d’un abonnement.
- La conversation entière est renvoyée avec chaque nouveau message. Le modèle ne garde rien d’un message à l’autre : il écrit chaque réponse un jeton à la fois, en prolongeant tout le texte de la conversation jusque-là, par génération autorégressive autoregressive generationgénération autorégressive language modelsmodèles de langue A method of generating a sequence, such as text, one token at a time.Méthode de génération d'une séquence, comme un texte, un jeton à la fois. (see also the One token at a time page, in the LLM lifecycle module) (voir aussi la page Un jeton à la fois, dans le module Cycle de vie des GML). Votre dixième message est donc envoyé avec les neuf messages précédents et leurs réponses, si bien qu’un long échange coûte bien plus que son dernier message ne le laisse croire (see also the context window page, in the LLM lifecycle module) (voir aussi la page La fenêtre contextuelle, dans le module Cycle de vie des GML).
- La sortie coûte plus cher que l’entrée. Les fournisseurs facturent plusieurs fois plus cher par jeton ce que le modèle écrit que ce qu’il lit.
- Le raisonnement est facturé. Les jetons que génère un modèle pendant qu’il raisonne comptent comme sortie, qu’on vous les montre ou non.
Avec un abonnement, ces mêmes coûts sont déduits de votre limite d’utilisation : c’est pourquoi vous atteignez la limite plus vite dans une longue conversation avec un grand modèle.
Pour donner un ordre de grandeur, voici le plus petit et le plus grand modèle des grilles tarifaires de l’API des deux fournisseurs, en dollars américains par million de jetons (Figure 10figure 10 et Figure 11figure 11) :Anthropic, pricing, et OpenAI, pricing, tous deux consultés le 16 septembre 2026.
| Fournisseur | Modèle | Entrée | Sortie |
|---|---|---|---|
| Anthropic, le plus petit | Claude Haiku 4.5 | 1 | 5 |
| Anthropic, le plus grand | Claude Fable 5.1 | 10 | 50 |
| OpenAI, le plus petit | GPT-5.6 Luna | 0,20 | 1,20 |
| OpenAI, le plus grand | GPT-6 Astra | 10 | 50 |
Deux choses ressortent :
- la sortie coûte cinq à six fois plus cher que l’entrée ;
- le plus grand modèle coûte bien plus que le plus petit : environ dix fois plus chez Anthropic, environ cinquante fois plus chez OpenAI.
OpenAI facture aussi davantage lorsque le contexte est long.
Sources
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- Open Source Initiative (2025). Open Weights: not quite what you've been told. Open Source Initiative. https://opensource.org/ai/open-weights