Execution “effort”L'« effort » d'exécution
TRA6008 S3 · in classS3 · en classe
Choice 4: effort (on the models that offer it)
Once you have decided which model to use, many of the top models at the time of writing let you pick what their providers call “reasoning effort”, or something similar. This setting controls how much computation the chosen model spends on its answer. A higher setting is more expensive and takes more time, but can give better results on tasks that are more complex.
What this looks like in September 2026
The two largest providers at this time, Anthropic and OpenAI, rearranged these controls during 2026, and will likely do so again several times in the coming months and years. This section describes 16 September 2026, and it is the part of this chapter most likely to be out of date when you read it.
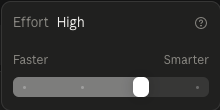
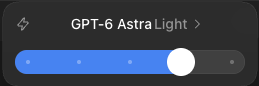
- Claude and ChatGPT Work: you pick a model from a list, then one of five effort levels, low to max in Claude (on every model except the smallest) and light to ultra in ChatGPT Work (Figure 6figure 6 and Figure 7figure 7).
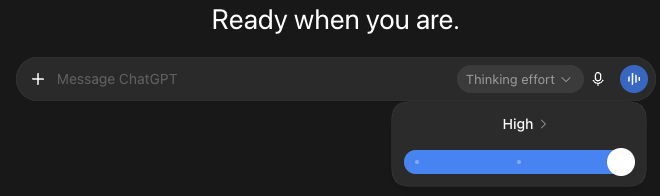
- ChatGPT (chat): you do not pick the model, only a thinking effort, on a slider whose levels depend on your plan: three (Instant, Medium and High) on the first paid plan, with Extra High and Pro added on the higher plans (Figure 8figure 8).
What you can choose depends on your plan. In Claude:
| Plan | What you can choose |
|---|---|
| Free | Claude Sonnet and Claude Haiku |
| Pro | adds Claude Opus; Claude Fable only through usage credits, paid separately |
| Max | more usage; Claude Fable included, up to half of the weekly allowance |
In ChatGPT:
| Plan | What you can choose |
|---|---|
| Free and Go | GPT-5.6 Luna, with a Think button for harder questions |
| Plus, in the chat | GPT-5.6 Sol at Instant, Medium and High |
| Plus, in ChatGPT Work | GPT-6 Astra (with limited use), GPT-5.6 Sol, Terra and Luna |
| Pro, in the chat | every level, including Extra High and Pro, where GPT-6 Astra has a limited number of messages a week |
| Pro, in ChatGPT Work | the same models as on Plus, with more use of GPT-6 Astra |
What is decided for you
Whatever you pick, part of the choice is made for you.
- Your usage allowance. Every plan limits how much you can use, and the allowance runs out sooner when you use larger models with more effort.
- The models on offer. Your plan decides which models and levels you can choose at all.
- The default. Each product and model arrives with a setting chosen by the provider, and many people never change it.
- Sometimes, the model itself. Some products switch automatically to another model, for instance when you reach a usage limit (see also the What a chat product adds to the model page) (voir aussi la page Ce qu'un agent conversationnel ajoute au modèle).
The same prompt promptrequête promptingrequêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. sent twice to exactly the same model can give two different responses (see also the LLMs are non-deterministic page, in the LLM lifecycle module) (voir aussi la page Les GML ne sont pas déterministes, dans le module Cycle de vie des GML), and the choice of model can have a large effect on that answer and on performance in general. Generalizing about LLMs is therefore very difficult: you constantly have to update your ideas about what is possible and what works well.
For the same reason, whenever you report output from an LLM, it is good practice to state:
- the model you used, by its exact name;
- the settings, where they change the result;
- the date.
Choix 4 : effort (sur les modèles qui le proposent)
Une fois le modèle choisi, bon nombre des meilleurs modèles actuels vous permettent de régler ce que leurs fournisseurs appellent l’« effort de raisonnement » (angl. reasoning effort), ou quelque chose d’approchant. Ce réglage détermine la quantité de calcul que le modèle choisi consacre à sa réponse. Un réglage plus élevé coûte plus cher et prend plus de temps, mais peut donner de meilleurs résultats sur les tâches plus complexes.
Ce que cela donne en septembre 2026
Les deux plus grands fournisseurs actuels, Anthropic et OpenAI, ont réorganisé ces réglages au cours de 2026, et le feront probablement encore plusieurs fois dans les mois et les années à venir. Cette section décrit la situation au 16 septembre 2026, et c’est la partie de ce chapitre la plus susceptible d’être dépassée au moment où vous la lisez.
- Claude et ChatGPT Work : vous choisissez un modèle dans une liste, puis l’un de cinq niveaux d’effort, de low à max dans Claude (sur tous les modèles sauf le plus petit) et de light à ultra dans ChatGPT Work (Figure 6figure 6 et Figure 7figure 7).
- ChatGPT (conversation) : vous ne choisissez pas le modèle, seulement un effort de réflexion, sur un curseur dont les niveaux dépendent de votre forfait : trois (Instant, Medium et High) avec le premier forfait payant, Extra High et Pro s’y ajoutant avec les forfaits supérieurs (Figure 8figure 8).
Ce que vous pouvez choisir dépend de votre forfait. Dans Claude :
| Forfait | Ce que vous pouvez choisir |
|---|---|
| Gratuit | Claude Sonnet et Claude Haiku |
| Pro | ajoute Claude Opus ; Claude Fable seulement au moyen de crédits d’utilisation payés à part |
| Max | davantage d’utilisation ; Claude Fable inclus, jusqu’à la moitié du quota hebdomadaire |
Dans ChatGPT :
| Forfait | Ce que vous pouvez choisir |
|---|---|
| Gratuit et Go | GPT-5.6 Luna, avec un bouton « Think » pour les questions plus difficiles |
| Plus, dans la conversation | GPT-5.6 Sol en Instant, Medium et High |
| Plus, dans ChatGPT Work | GPT-6 Astra (avec un usage limité), GPT-5.6 Sol, Terra et Luna |
| Pro, dans la conversation | tous les niveaux, y compris Extra High et Pro, où GPT-6 Astra est limité à un certain nombre de messages par semaine |
| Pro, dans ChatGPT Work | les mêmes modèles qu’avec le forfait Plus, avec un usage plus large de GPT-6 Astra |
Ce qui est décidé pour vous
Quoi que vous choisissiez, une partie du choix est faite à votre place.
- Votre quota d’utilisation. Chaque forfait limite votre utilisation, et le quota s’épuise plus vite avec de plus grands modèles et plus d’effort.
- Les modèles proposés. Votre forfait détermine quels modèles et quels niveaux vous pouvez choisir.
- Le réglage par défaut. Chaque produit et chaque modèle arrive avec un réglage choisi par le fournisseur, que bien des gens ne changent jamais.
- Parfois, le modèle lui-même. Certains produits passent automatiquement à un autre modèle, par exemple quand vous atteignez une limite d’utilisation (see also the What a chat product adds to the model page) (voir aussi la page Ce qu'un agent conversationnel ajoute au modèle).
La même requête promptrequête promptingrequêtes Input given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. envoyée deux fois exactement au même modèle peut donner deux réponses différentes (see also the LLMs are non-deterministic page, in the LLM lifecycle module) (voir aussi la page Les GML ne sont pas déterministes, dans le module Cycle de vie des GML), et le choix du modèle peut avoir un effet important sur cette réponse et sur la performance en général. Il est donc très difficile de généraliser au sujet des grands modèles de langue (GML) : il faut sans cesse mettre à jour ses idées sur ce qui est possible et sur ce qui fonctionne bien.
Pour la même raison, chaque fois que vous rapportez un résultat produit par un GML, il est de bonne pratique d’indiquer :
- le modèle utilisé, sous son nom exact ;
- les réglages, lorsqu’ils comptent ;
- la date.