Testing it yourselfFaire vos propres tests
TRA6008 OptionalFacultatif
One test says little
Suppose you tried Gemini a year ago, gave it a task from your own work, found the result poor and concluded that this was not something a model could do for you. That conclusion is too generalized. In reality, you can only draw that conclusion for that one specific test, on that task, that day. Changing any of the following might have gotten you the answer you wanted:
- another family, whose models happen to suit that kind of task;
- a later generation of the one you tried;
- a larger tier of the same generation;
- a higher effort level on the model you already have;
- a better prompt (see also the Prompting chapter) (voir aussi le chapitre Formulation de requêtes);
- a different harness harnessappareillage agentsagents The software around a language model that turns it into a working system. It determines what the model receives and which tools it may use, carries out the actions the model requests, and passes the results back to it.Logiciel qui entoure un modèle de langue et en fait un système opérationnel. Il détermine ce que le modèle reçoit et quels outils il peut utiliser, exécute les actions que le modèle demande et lui transmet les résultats. : another product built on the same model, or other features switched on (see also the What chat products offer chapter) (voir aussi le chapitre Ce qu'offrent les agents conversationnels).
So do not let a few tests with a single model, a few years or a few months ago, stand as your opinion of what these systems can and cannot do.
The field moves fast
This field moves faster than anyone can follow, including the people who work in it. Models are replaced every few months, the settings around them change with them, and what they manage and what they fail at changes with every release.
The only way to know whether today’s models manage a task is to try them on that task. A leaderboard can point you to the models worth trying, but it averages over other tasks, so it cannot settle the question for you (see also the LLM leaderboards chapter) (voir aussi le chapitre Les classements de GML).
How far to take it
How systematic to be depends on your work. If your tasks vary a lot, a full test set is more than most people keep, and a lighter habit does most of the work:
- when a new model or product comes out, or when you consider switching, give it a few recent tasks whose results you remember well;
- when a model fails at something important to you, note the task, so that you can try it again later.
A more systematic set pays off when you do the same kind of task often, when you choose a tool for a team or an organization, or when the comparison has to be reliable, for instance in research. It then has four parts (Figure 14figure 14):
- three to five tasks from your own work with answers you trust: a typical piece of writing or analysis with your own version as the reference, a question in your field whose answer you know, a document you know well to summarize. For a translator, one of them would be a text you have already translated;
- criteria decided in advance: what counts as good, how long it may take, what it may cost;
- two or three families, at two tiers each, so that a difference between tiers is not mistaken for a difference between providers;
- a record: the model’s exact name, the date, the settings and the prompt, kept with the outputs.
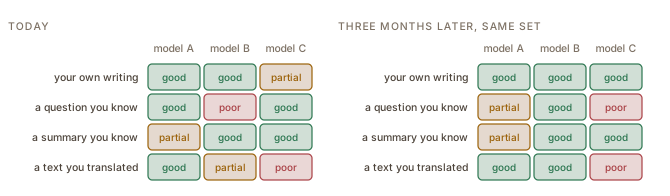
Running the set against a new model takes minutes, and the same set rerun over time shows you what a release changed for your work, which the release notes will not. Progress is not always steady: a new version can do worse on one of your tasks than the one before it, as model A and model C do on the question in Figure 14figure 14.
A rerun is only a fresh test if the product cannot see the earlier runs. With memory persistent memorymémoire persistante promptingrequêtes An AI assistant's ability to retain information from earlier interactions and retrieve relevant information in later conversations, allowing it to maintain continuity and personalize its responses across sessions.Capacité d'un assistant d'IA à retenir de l'information d'interactions antérieures et à en récupérer les éléments pertinents dans des conversations ultérieures, ce qui lui permet d'assurer une continuité et de personnaliser ses réponses d'une session à l'autre. switched on, or with a model allowed to search your past conversations, the new answer may draw on what it said, or what you corrected, the last time. A temporary or incognito chat, or memory switched off for the test, keeps the runs separate (see also the Custom instructions, memory, projects and skills page) (voir aussi la page Instructions personnalisées, mémoire, projets et compétences).
Capability is not the only reason to choose
All of this is about what a model manages. There are other reasons for using one or not using one, and they can be very good ones:
- what happens to the text you send it (see also the Training, retention and privacy settings page) (voir aussi la page Entraînement, conservation et paramètres de confidentialité);
- what the training and the answers cost in energy (see also the Environmental impact chapter, in the Critical issues with LLMs module) (voir aussi le chapitre Impact environnemental, dans le module Enjeux critiques des GML);
- what you make of the company behind it.
Those reasons change more slowly than capability, but they do change: terms of use and privacy settings are revised, so they are worth checking again now and then.
There is also a pull to stay where you are. More and more of what you set up in one product stays in that product: memory, projects, custom instructions custom instructionsinstructions personnalisées promptingrequêtes User-provided preferences, background information, or requirements that an AI assistant stores and applies automatically across conversations, so that they do not need to be repeated in every prompt.Préférences, informations contextuelles ou exigences fournies par l'utilisateur, qu'un assistant d'IA enregistre et applique automatiquement d'une conversation à l'autre, sans qu'il faille les répéter dans chaque requête. and connected services (see also the What a chat product adds to the model page) (voir aussi la page Ce qu'un agent conversationnel ajoute au modèle). None of it automatically comes with you when you switch, which has two consequences:
- switching costs more;
- comparisons are coloured: a product that already knows your preferences can seem better than a fresh account elsewhere, for reasons that have nothing to do with the model.
Un seul test en dit peu
Imaginons que vous ayez essayé Gemini il y a un an, que vous lui ayez confié une tâche tirée de votre travail, que le résultat vous ait paru médiocre et que vous en ayez conclu qu’un modèle ne pouvait pas faire cela pour vous. Cette conclusion est trop générale. En réalité, elle ne vaut que pour ce test précis, sur cette tâche, ce jour-là. En changeant l’un des éléments suivants, vous auriez peut-être obtenu la réponse voulue :
- une autre famille, dont les modèles conviennent mieux à ce genre de tâche ;
- une génération plus récente de celle que vous avez essayée ;
- un niveau supérieur de la même génération ;
- un niveau d’effort plus élevé sur le modèle que vous utilisez déjà ;
- une meilleure requête (see also the Prompting chapter) (voir aussi le chapitre Formulation de requêtes) ;
- un autre appareillage harnessappareillage agentsagents The software around a language model that turns it into a working system. It determines what the model receives and which tools it may use, carries out the actions the model requests, and passes the results back to it.Logiciel qui entoure un modèle de langue et en fait un système opérationnel. Il détermine ce que le modèle reçoit et quels outils il peut utiliser, exécute les actions que le modèle demande et lui transmet les résultats. : un autre produit fondé sur le même modèle, ou d’autres fonctionnalités activées (see also the What chat products offer chapter) (voir aussi le chapitre Ce qu'offrent les agents conversationnels).
Ne laissez donc pas quelques tests faits avec un seul modèle, il y a quelques années ou quelques mois, tenir lieu d’opinion sur ce que ces systèmes peuvent faire ou non.
Le domaine évolue vite
Ce domaine évolue plus vite que quiconque ne peut le suivre, y compris les personnes qui y travaillent. Les modèles sont remplacés tous les quelques mois, les réglages qui les entourent changent avec eux, et ce qu’ils réussissent ou ratent change à chaque nouvelle version.
La seule façon de savoir si les modèles d’aujourd’hui réussissent une tâche est de les essayer sur cette tâche. Un classement peut vous indiquer les modèles qui valent la peine d’être essayés, mais il fait la moyenne sur d’autres tâches et ne peut donc pas trancher à votre place (see also the LLM leaderboards chapter) (voir aussi le chapitre Les classements de GML).
Jusqu’où aller
Le degré de rigueur dépend de votre travail. Si vos tâches varient beaucoup, un ensemble de tests complet dépasse ce que la plupart des gens tiennent à jour, et une habitude plus légère fait l’essentiel du travail :
- quand un nouveau modèle ou produit sort, ou quand vous envisagez de changer, donnez-lui quelques tâches récentes dont vous vous rappelez bien les résultats ;
- quand un modèle échoue sur quelque chose d’important pour vous, notez la tâche pour pouvoir la réessayer plus tard.
Un ensemble plus systématique est rentable quand vous faites souvent le même genre de tâche, quand vous choisissez un outil pour une équipe ou une organisation, ou quand la comparaison doit tenir la route, par exemple en recherche. Il comporte alors quatre éléments (Figure 14figure 14) :
- trois à cinq tâches tirées de votre travail, avec des réponses sûres : un texte ou une analyse typique, avec votre propre version comme référence, une question de votre domaine dont vous connaissez la réponse, un document que vous connaissez bien à résumer. Pour un traducteur ou une traductrice, l’une d’elles serait un texte déjà traduit ;
- des critères fixés d’avance : ce qui compte comme bon, combien de temps cela peut prendre, combien cela peut coûter ;
- deux ou trois familles, à deux niveaux chacune, pour ne pas confondre une différence entre niveaux avec une différence entre fournisseurs ;
- une trace écrite : le nom exact du modèle, la date, les réglages et la requête, conservés avec les résultats.
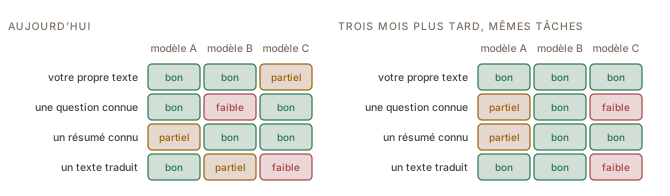
Soumettre l’ensemble à un nouveau modèle prend quelques minutes, et le même ensemble refait au fil du temps vous montre ce qu’une nouvelle version a changé pour votre travail, ce que les notes de version ne diront pas. Les progrès ne sont pas toujours constants : une nouvelle version peut faire moins bien que la précédente sur l’une de vos tâches, comme les modèles A et C sur la question de la Figure 14figure 14.
Un test refait n’est un vrai nouveau test que si le produit ne voit pas les essais précédents. Avec la mémoire persistent memorymémoire persistante promptingrequêtes An AI assistant's ability to retain information from earlier interactions and retrieve relevant information in later conversations, allowing it to maintain continuity and personalize its responses across sessions.Capacité d'un assistant d'IA à retenir de l'information d'interactions antérieures et à en récupérer les éléments pertinents dans des conversations ultérieures, ce qui lui permet d'assurer une continuité et de personnaliser ses réponses d'une session à l'autre. activée, ou avec un modèle autorisé à fouiller vos anciennes conversations, la nouvelle réponse peut s’appuyer sur ce qu’il a dit, ou sur ce que vous avez corrigé, la fois précédente. Une conversation temporaire ou en mode incognito, ou la mémoire désactivée pendant le test, garde les essais séparés (see also the Custom instructions, memory, projects and skills page) (voir aussi la page Instructions personnalisées, mémoire, projets et compétences).
La capacité n’est pas la seule raison de choisir
Tout cela porte sur ce qu’un modèle réussit. Il existe d’autres raisons d’utiliser un modèle ou non, et elles peuvent être très bonnes :
- ce qu’il advient du texte que vous lui envoyez (see also the Training, retention and privacy settings page) (voir aussi la page Entraînement, conservation et paramètres de confidentialité) ;
- ce que l’entraînement et les réponses coûtent en énergie (see also the Environmental impact chapter, in the Critical issues with LLMs module) (voir aussi le chapitre Impact environnemental, dans le module Enjeux critiques des GML) ;
- ce que vous pensez de l’entreprise qui le propose.
Ces raisons changent plus lentement que les capacités, mais elles changent : les conditions d’utilisation et les réglages de confidentialité sont révisés, et il vaut donc la peine de les revérifier de temps à autre.
Il existe aussi une force qui pousse à rester où l’on est. De plus en plus de ce que vous configurez dans un produit reste dans ce produit : la mémoire, les projets, les instructions personnalisées custom instructionsinstructions personnalisées promptingrequêtes User-provided preferences, background information, or requirements that an AI assistant stores and applies automatically across conversations, so that they do not need to be repeated in every prompt.Préférences, informations contextuelles ou exigences fournies par l'utilisateur, qu'un assistant d'IA enregistre et applique automatiquement d'une conversation à l'autre, sans qu'il faille les répéter dans chaque requête. et les services connectés (see also the What a chat product adds to the model page) (voir aussi la page Ce qu'un agent conversationnel ajoute au modèle). Rien de tout cela ne vous suit automatiquement quand vous changez de produit, ce qui a deux conséquences :
- changer coûte plus cher ;
- les comparaisons sont faussées : un produit qui connaît déjà vos préférences peut sembler meilleur qu’un nouveau compte ailleurs, pour des raisons qui n’ont rien à voir avec le modèle.