Training, retention and privacy settingsEntraînement, conservation et paramètres de confidentialité
TRA6008 S3 · in classS3 · en classe
Where a prompt goes
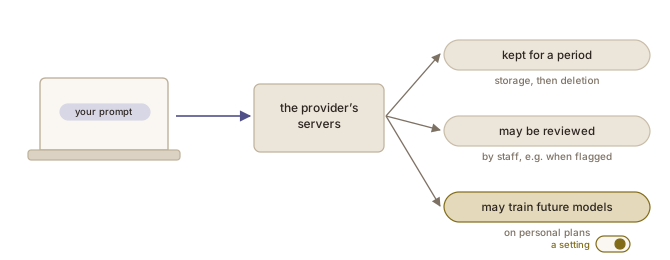
A prompt typed into a chat app leaves your device, is processed on the provider’s servers, and is stored there with the answer as part of your history (Figure 3figure 3). From there, three things may happen to it, depending on the plan and the settings:
- it is kept for a period after you delete it, commonly about thirty days, and longer in several situations: a conversation someone has reviewed, a setting that allows training, a legal obligation;Anthropic removes deleted conversations from its back-end within thirty days and, with the model-improvement setting on, keeps chats in de-identified form for up to five years; OpenAI removes deleted conversations within thirty days (both read 17 September 2026, links in the note under the table below). Google keeps conversations that human reviewers saw for up to three years, and deleting your activity does not delete them: Gemini Apps Privacy Hub, read 22 September 2026.
- it may be read by the provider’s staff or contractors, for instance when a safety system flags it, or to improve the service;Google, for instance, states that “a subset of chats are reviewed by human reviewers” to improve its services: Gemini Apps Privacy Hub, updated 10 August 2026, read 17 September 2026.
- it may be used to train the next models, on personal plans where that is the default or where you have agreed to it.
Text used in training can come back out: Nasr et al. (2025) extracted training data, personal details included, from production models (see also the What happens to the training text page, in the LLM lifecycle module) (voir aussi la page Ce qu'il advient du texte d'entraînement, dans le module Cycle de vie des GML).Shown on the ChatGPT and Gemini models of 2023 and 2024. The authors report that one of their two attacks has since been patched, but not the general problem behind it. The chance that your own paragraph resurfaces is small, but once text has been used to train a model, switching the setting off afterwards does not take it back out of that model.
What differs by plan
Personal plans, business plans and the API generally follow different rules, and the pattern across providers stays the same even where the details change:
| Used for training | Retention | Who it suits | |
|---|---|---|---|
| Free and individual plans | often yes by default, with an opt-out | the provider’s standard period | personal use |
| Business and enterprise plans | generally not | configurable | an organization’s work |
| The API | generally not | a short period | your own programs |
| A model on your own computer | no | your disk | material that may not leave |
On personal plans the details vary from one provider to the next, for instance in whether training is on by default, how the setting is named and how long conversations are kept once training is allowed. A retention period can also be overridden: a court order in a lawsuit brought by the New York Times made one provider keep even deleted conversations for part of 2025.For instance Anthropic: with the “model improvement” setting on, chats are kept in de-identified form for up to five years and may be used for training; with it off, deleted conversations leave the back-end within thirty days; Claude for Work and the API are not used for training (Is my data used for model training?, How long do you store my data?; whether the setting is on by default for a new account is not stated there). OpenAI: conversations on personal plans are used for training unless “Improve the model for everyone” is switched off, deleted conversations leave its systems within thirty days, and business plans and the API are not used by default (How your data is used to improve model performance, updated 13 March 2026; Data Controls FAQ). The court order ended on 26 September 2025, and “limited historical April–September 2025 user data” is kept for the lawsuit (How we’re responding to The New York Times’ data demands, update of 22 October 2025). All read 17 September 2026.
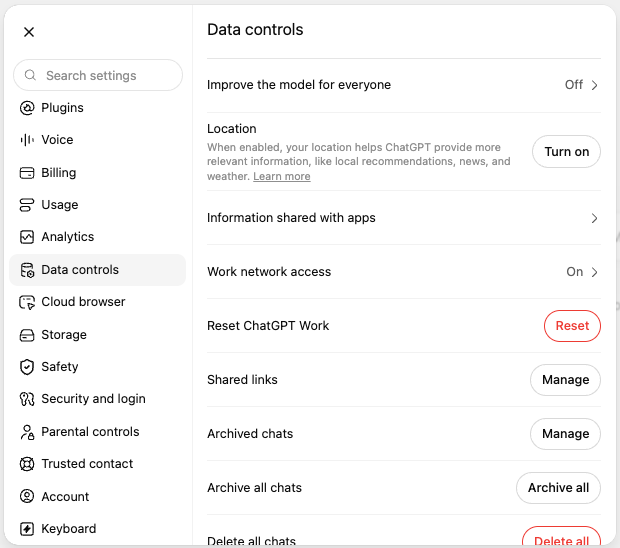
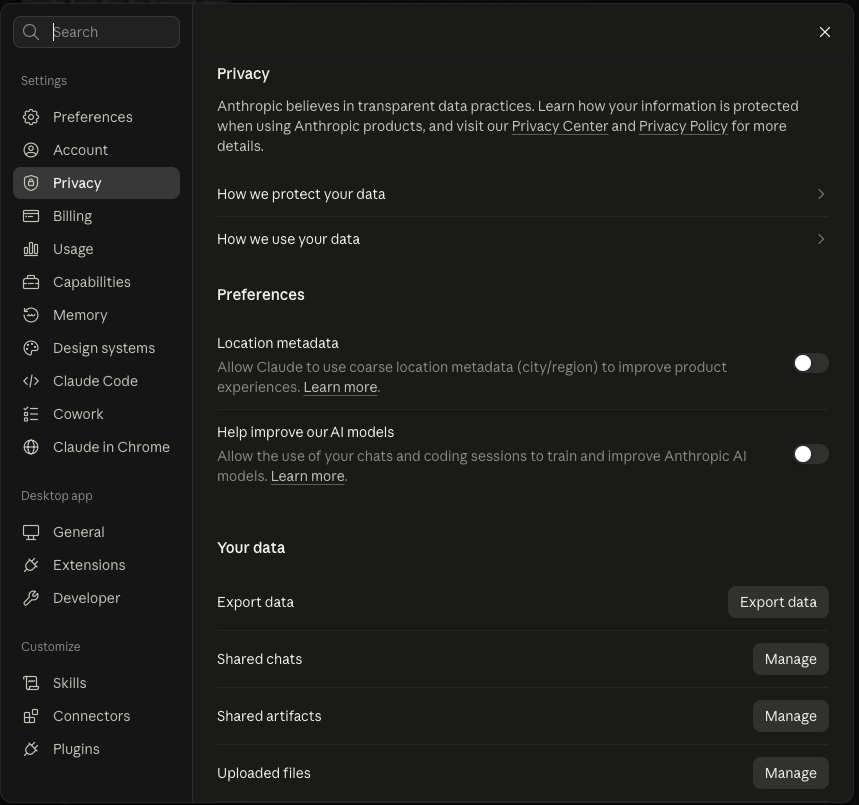
Every chat app has a page in its settings where these choices are made, and most offer a temporary or incognito mode for a conversation that should not enter your history at all.For instance Claude Help Center, Incognito chats; OpenAI Help Center, Temporary Chat FAQ. Both read 15 September 2026. Reading that page once per chat app takes a few minutes, and tells you what happens to your text. The training switch is the one to look for: ChatGPT keeps it under Data controls (Figure 4figure 4) and Claude under Privacy (Figure 5figure 5), and other products put it somewhere comparable under a name of their own.
What this means for confidential work
Some material is not yours to hand over: an employer’s internal document, an unpublished manuscript or a dataset under embargo, a job application or a medical file that names someone, a student’s assignment, and, for a translator, a client’s text under a confidentiality agreement. None of it belongs in a chat app on a personal plan with the default settings. Each needs a deliberate decision, and the decision is not always no: a business plan with training off and a retention period you can defend, or a model running on your own machine, are the arrangements that make it yes (see also the Chat app, API or your own computer page) (voir aussi la page Application, API ou votre propre ordinateur). What you owe a client, an employer, a research ethics board or a professional order, and what privacy law adds, depends on your own contracts and on the law that applies to you.
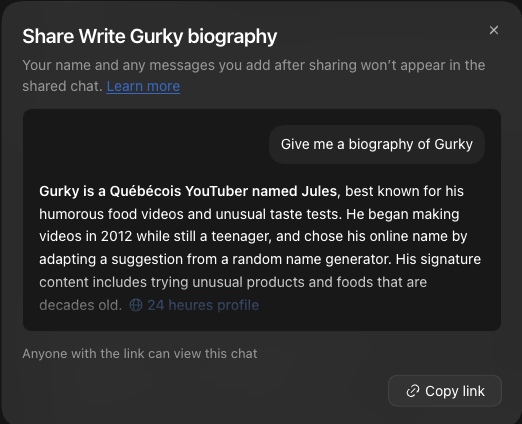
A conversation can also leave on purpose. Chat apps offer a link that anyone can open, and a document or a report can be published the same way (see also the Documents, images, voice and study modes page) (voir aussi la page Documents, images, voix et modes d'étude). The link shows the exchange as it stands, so a conversation is worth reading through before you share it, above all when it contains material or details belonging to someone else. A shared link can also spread further than expected: in July 2025 ChatGPT offered to make a shared conversation findable by search engines, the magazine Fast Company found thousands of them in Google results, and OpenAI withdrew the option within days, saying it gave people too many chances to share something they had not meant to.OpenAI’s security lead called it a short-lived experiment and said indexed content would be removed from the search engines: Karissa Bell, OpenAI is removing ChatGPT conversations from Google, Engadget, 31 July 2025, read 22 September 2026. (Figure 6figure 6).
Où va une requête
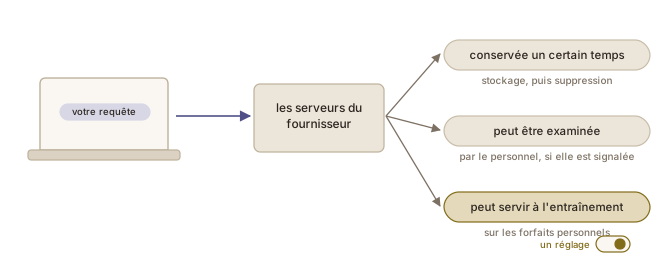
Une requête tapée dans une application de conversation quitte votre appareil, est traitée sur les serveurs du fournisseur et y est conservée avec la réponse, dans votre historique (Figure 3figure 3). De là, trois choses peuvent lui arriver, selon le forfait et les réglages :
- elle est conservée un certain temps après que vous l’avez supprimée, couramment une trentaine de jours, et plus longtemps dans plusieurs cas : une conversation que quelqu’un a examinée, un réglage qui autorise l’entraînement, une obligation légale ;Anthropic retire les conversations supprimées de ses systèmes en moins de trente jours et, quand le réglage d’amélioration des modèles est activé, conserve les conversations sous forme dépersonnalisée jusqu’à cinq ans ; OpenAI retire les conversations supprimées en moins de trente jours (les deux consultés le 17 septembre 2026, liens dans la note sous le tableau ci-dessous). Google conserve jusqu’à trois ans les conversations examinées par des personnes, et supprimer votre activité ne les supprime pas : Gemini Apps Privacy Hub, consulté le 22 septembre 2026.
- elle peut être lue par le personnel du fournisseur ou par des sous-traitants, par exemple quand un système de sécurité la signale, ou pour améliorer le service ;Google, par exemple, indique qu’« un sous-ensemble de conversations est examiné par des évaluateurs humains » pour améliorer ses services : Gemini Apps Privacy Hub, mis à jour le 10 août 2026, consulté le 17 septembre 2026.
- elle peut servir à entraîner les prochains modèles, sur les forfaits personnels où c’est le réglage par défaut ou lorsque vous y avez consenti.
Un texte utilisé pour l’entraînement peut ressortir : Nasr et al. (2025) ont extrait des données d’entraînement, renseignements personnels compris, de modèles en production (see also the What happens to the training text page, in the LLM lifecycle module) (voir aussi la page Ce qu'il advient du texte d'entraînement, dans le module Cycle de vie des GML).Montré sur les modèles de ChatGPT et de Gemini de 2023 et 2024. Les auteurs signalent qu’une de leurs deux attaques a depuis été corrigée, mais pas le problème général qui la rend possible. Le risque que votre paragraphe ressorte est faible, mais une fois qu’un texte a servi à entraîner un modèle, désactiver le réglage après coup ne le retire pas de ce modèle.
Ce qui change selon le forfait
Les forfaits personnels, les forfaits d’entreprise et l’interface de programmation (API) suivent généralement des règles différentes, et le schéma reste le même d’un fournisseur à l’autre même quand les détails changent :
| Sert à l’entraînement | Conservation | À qui cela convient | |
|---|---|---|---|
| Forfaits gratuits et individuels | souvent oui par défaut, avec une option de refus | la durée habituelle du fournisseur | un usage personnel |
| Forfaits d’entreprise | généralement non | configurable | le travail d’une organisation |
| L’interface de programmation | généralement non | une courte durée | vos propres programmes |
| Un modèle sur votre ordinateur | non | votre disque | ce qui ne doit pas sortir |
Sur les forfaits personnels, les détails varient d’un fournisseur à l’autre, par exemple selon que l’entraînement est activé par défaut ou non, selon le nom donné au réglage et selon la durée de conservation une fois l’entraînement autorisé. Une durée de conservation peut aussi être suspendue : dans le procès intenté par le New York Times, une ordonnance a obligé un fournisseur à conserver même les conversations supprimées pendant une partie de 2025.Anthropic, par exemple : avec le réglage « model improvement » activé, les conversations sont conservées sous forme dépersonnalisée jusqu’à cinq ans et peuvent servir à l’entraînement ; désactivé, les conversations supprimées quittent les systèmes en moins de trente jours ; Claude for Work et l’interface de programmation ne servent pas à l’entraînement (Is my data used for model training?, How long do you store my data? ; les pages ne disent pas si le réglage est activé par défaut pour un nouveau compte). OpenAI : sur les forfaits personnels, les conversations servent à l’entraînement à moins de désactiver « Improve the model for everyone », les conversations supprimées quittent les systèmes en moins de trente jours, et les forfaits d’entreprise et l’interface de programmation ne sont pas utilisés par défaut (How your data is used to improve model performance, mis à jour le 13 mars 2026 ; Data Controls FAQ). L’ordonnance a pris fin le 26 septembre 2025, et des « données d’utilisateurs historiques limitées d’avril à septembre 2025 » sont conservées pour le procès (How we’re responding to The New York Times’ data demands, mise à jour du 22 octobre 2025). Tous consultés le 17 septembre 2026.
Chaque application de conversation a une page de réglages où ces choix se font, et la plupart offrent un mode temporaire ou incognito pour une conversation qui ne doit pas entrer dans votre historique.Par exemple Claude Help Center, Incognito chats ; OpenAI Help Center, Temporary Chat FAQ. Les deux consultés le 15 septembre 2026. Lire cette page une fois par application prend quelques minutes et vous dit ce qui arrive à votre texte. C’est le réglage d’entraînement qu’il faut y chercher : ChatGPT le place sous Data controls (Figure 4figure 4) et Claude sous Privacy (Figure 5figure 5), et les autres produits le rangent à un endroit comparable, sous un nom à eux.
Ce que cela implique pour le travail confidentiel
Une partie de ce que vous traitez ne vous appartient pas : un document interne d’un employeur, un manuscrit inédit ou un jeu de données sous embargo, une candidature ou un dossier médical qui nomme quelqu’un, le travail d’un étudiant et, pour un traducteur, le texte d’un client soumis à une entente de confidentialité. Rien de tout cela n’a sa place dans une application de conversation sur un forfait personnel avec les réglages par défaut. Chaque cas demande une décision réfléchie, et la décision n’est pas toujours non : un forfait d’entreprise sans entraînement et avec une durée de conservation défendable, ou un modèle qui tourne sur votre machine, sont les arrangements qui permettent de dire oui (see also the Chat app, API or your own computer page) (voir aussi la page Application, API ou votre propre ordinateur). Ce que vous devez à un client, à un employeur, à un comité d’éthique de la recherche ou à un ordre professionnel, et ce qu’y ajoute le droit de la vie privée, dépend de vos propres contrats et du droit qui s’applique à vous.
Une conversation peut aussi sortir volontairement. Les applications de conversation offrent un lien que n’importe qui peut ouvrir, et un document ou un rapport peut être publié de la même façon (see also the Documents, images, voice and study modes page) (voir aussi la page Documents, images, voix et modes d'étude). Le lien montre l’échange tel quel : une conversation mérite donc d’être relue avant d’être partagée, surtout quand elle contient de la matière ou des renseignements qui appartiennent à quelqu’un d’autre. Un lien partagé peut aussi aller plus loin que prévu : en juillet 2025, ChatGPT proposait de rendre une conversation partagée repérable par les moteurs de recherche, le magazine Fast Company en a trouvé des milliers dans les résultats de Google, et OpenAI a retiré l’option en quelques jours, en expliquant qu’elle donnait trop d’occasions de partager quelque chose sans l’avoir voulu.Le responsable de la sécurité chez OpenAI a parlé d’une expérience de courte durée et annoncé le retrait des contenus indexés des moteurs de recherche : Karissa Bell, OpenAI is removing ChatGPT conversations from Google, Engadget, 31 juillet 2025, consulté le 22 septembre 2026. (Figure 6figure 6).
Sources
- Nasr, M., Rando, J., Carlini, N., Hayase, J., Jagielski, M., Cooper, A. F., et al. (2025). Scalable Extraction of Training Data from Aligned, Production Language Models. Proceedings of the Thirteenth International Conference on Learning Representations (ICLR 2025). https://proceedings.iclr.cc/paper_files/paper/2025/hash/cce0e917b050208170151f77b497fc71-Abstract-Conference.html