Which model for which taskQuel modèle pour quelle tâche
TRA6008 S3 · in classS3 · en classe
Why there is no simple table
Two tasks that look equally hard to you can fall on opposite sides of what a model manages, so no table of tasks and models can tell you which model to use (Dell’Acqua et al., 2026). Where a model stops managing also changes every time a new one comes out, so a recommendation written down today is out of date within months.
The practical answer is to compare:
- open the same task in two or three assistants;
- work through a few exchanges in each;
- keep the one that helps you most.
When I have an important task, I sometimes do exactly that, and after one to three turns it is usually obvious which model is helping me best. Such a comparison tells you about that task, and little about the products in general (see also the Testing it yourself page) (voir aussi la page Faire vos propres tests). I only do it when the task is really important, because running it two or three times also multiplies the cost, in money and in energy.
Matching the tier and the effort
Between families the ordering changes with each release. Inside a family the rule is steadier:
| Task | What usually suffices |
|---|---|
| Chatting, a quick factual question on a well-covered topic, a short email or summary, rephrasing a paragraph, a first draft you will revise anyway | a small model, at a low effort level reasoning efforteffort de raisonnement language modelsmodèles de langue A setting that controls how much computation a model spends on an answer, which in practice means how many tokens it generates.Paramètre qui détermine la quantité de calcul qu'un modèle consacre à une réponse, c'est-à-dire, en pratique, le nombre de jetons qu'il génère. |
| Analyzing data or a long report, planning something with many constraints, comparing options against several criteria, checking a text against a long set of rules such as a style guide, anything with a chain of conditions | a larger model, a higher effort level, or both |
A small model at a low effort level answers sooner, costs less and uses less energy. A larger model, or a higher effort level, spends more computation on the answer, which pays where the task has several parts and being wrong is expensive, and adds only delay and expense where it does not.
Capability, cost and privacy
The three pull against each other, and no option is best on all three (Figure 13figure 13).
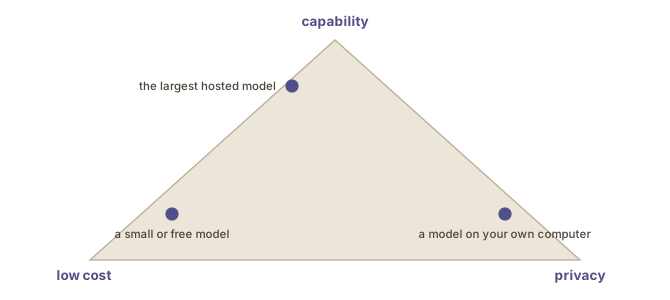
| Option | Capability | Cost | Privacy |
|---|---|---|---|
| The largest hosted model | the highest | the most expensive per use | your text is on the provider’s servers, under its terms |
| A small or free hosted model | lower | the cheapest and easiest | your text is on the provider’s servers, under its terms |
| A model on your own computer | lower | hardware and technical work | nothing leaves your machine |
When the material is confidential, privacy is often the corner that decides, and it is the one least often considered. What a provider may do with your text depends on its terms, and what you may share depends on your obligations to an employer, a client or the people the text is about. Either can rule out an option that would otherwise be better (see also the Training, retention and privacy settings page) (voir aussi la page Entraînement, conservation et paramètres de confidentialité).
Pourquoi il n’existe pas de tableau simple
Deux tâches qui vous semblent aussi difficiles l’une que l’autre peuvent tomber de part et d’autre de ce qu’un modèle réussit : aucun tableau croisant tâches et modèles ne peut donc vous dire quel modèle utiliser (Dell’Acqua et al., 2026). Là où un modèle cesse de réussir change aussi à chaque nouvelle version, si bien qu’une recommandation écrite aujourd’hui est dépassée en quelques mois.
La solution pratique est de comparer :
- soumettez la même tâche à deux ou trois assistants ;
- menez quelques échanges avec chacun ;
- gardez celui qui vous aide le mieux.
Quand j’ai une tâche importante, c’est parfois ce que je fais, et après un à trois échanges, on voit généralement sans peine quel modèle m’aide le mieux. Une telle comparaison vous renseigne sur cette tâche, et peu sur les produits en général (see also the Testing it yourself page) (voir aussi la page Faire vos propres tests). Je ne le fais que lorsque la tâche compte vraiment, parce que la faire deux ou trois fois multiplie aussi le coût, en argent et en énergie.
Choisir le niveau et l’effort
D’une famille à l’autre, le classement change à chaque nouvelle version. Dans une même famille, la règle est plus stable :
| Tâche | Ce qui suffit généralement |
|---|---|
| Converser, poser une question factuelle sur un sujet bien documenté, rédiger un court courriel ou un résumé, reformuler un paragraphe, produire une première version que vous réviserez de toute façon | un petit modèle, à faible niveau d’effort reasoning efforteffort de raisonnement language modelsmodèles de langue A setting that controls how much computation a model spends on an answer, which in practice means how many tokens it generates.Paramètre qui détermine la quantité de calcul qu'un modèle consacre à une réponse, c'est-à-dire, en pratique, le nombre de jetons qu'il génère. |
| Analyser des données ou un long rapport, planifier quelque chose qui comporte beaucoup de contraintes, comparer des options selon plusieurs critères, vérifier un texte selon un long ensemble de règles comme un guide de rédaction, tout ce qui enchaîne des conditions | un modèle plus grand, un niveau d’effort plus élevé, ou les deux |
Un petit modèle à faible niveau d’effort répond plus vite, coûte moins cher et consomme moins d’énergie. Un modèle plus grand, ou un niveau d’effort plus élevé, consacre plus de calcul à la réponse, ce qui est payant quand la tâche comporte plusieurs étapes et qu’une erreur coûte cher, et n’ajoute que du délai et des frais dans le cas contraire.
Capacité, coût et confidentialité
Les trois tirent dans des directions opposées, et aucune option n’est la meilleure sur les trois (Figure 13figure 13).
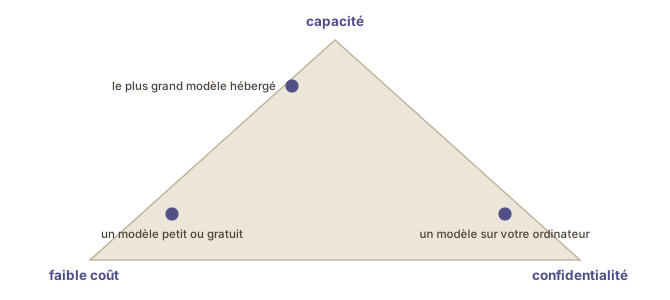
| Option | Capacité | Coût | Confidentialité |
|---|---|---|---|
| Le plus grand modèle hébergé | la plus élevée | le plus cher à l’usage | votre texte se trouve sur les serveurs du fournisseur, selon ses conditions |
| Un petit modèle hébergé ou gratuit | moindre | le moins cher et le plus simple | votre texte se trouve sur les serveurs du fournisseur, selon ses conditions |
| Un modèle sur votre ordinateur | moindre | du matériel et du travail technique | rien ne quitte votre machine |
Quand les documents sont confidentiels, la confidentialité est souvent le critère qui l’emporte, et c’est celui auquel on pense le moins. Ce qu’un fournisseur peut faire de votre texte dépend de ses conditions, et ce que vous pouvez communiquer dépend de vos obligations envers un employeur, un client ou les personnes dont parle le texte. L’un ou l’autre peut écarter une option qui serait autrement meilleure (see also the Training, retention and privacy settings page) (voir aussi la page Entraînement, conservation et paramètres de confidentialité).
Sources
- Dell'Acqua, F., McFowland, E., III, Mollick, E., Lifshitz, H., Kellogg, K. C., Rajendran, S., et al. (2026). Navigating the Jagged Technological Frontier: Field Experimental Evidence of the Effects of Artificial Intelligence on Knowledge Worker Productivity and Quality. Organization Science, 37(2), 403–423. https://doi.org/10.1287/orsc.2025.21838