TRA6008 · Bloc 1 · Introduction et GML (séances 1 à 3)TRA6008 · Bloc 1 · Introduction et GML (séances 1 à 3)
Séance 3 · jeudi 24 September 2026Séance 3 · jeudi 24 septembre 2026
PrintedImprimé le·aylart.github.io/learn·
CC BY-NC 4.0
Choosing a modelChoisir un modèle
Written in English. The French version was automatically generated
and I have not revised it.
Rédigé en anglais. La version française a été
générée automatiquement et je ne l'ai pas révisée.
Families, generations and tiersFamilles, générations et niveaux
the company: your opinion of it and of how it behaves.
Who leads the field
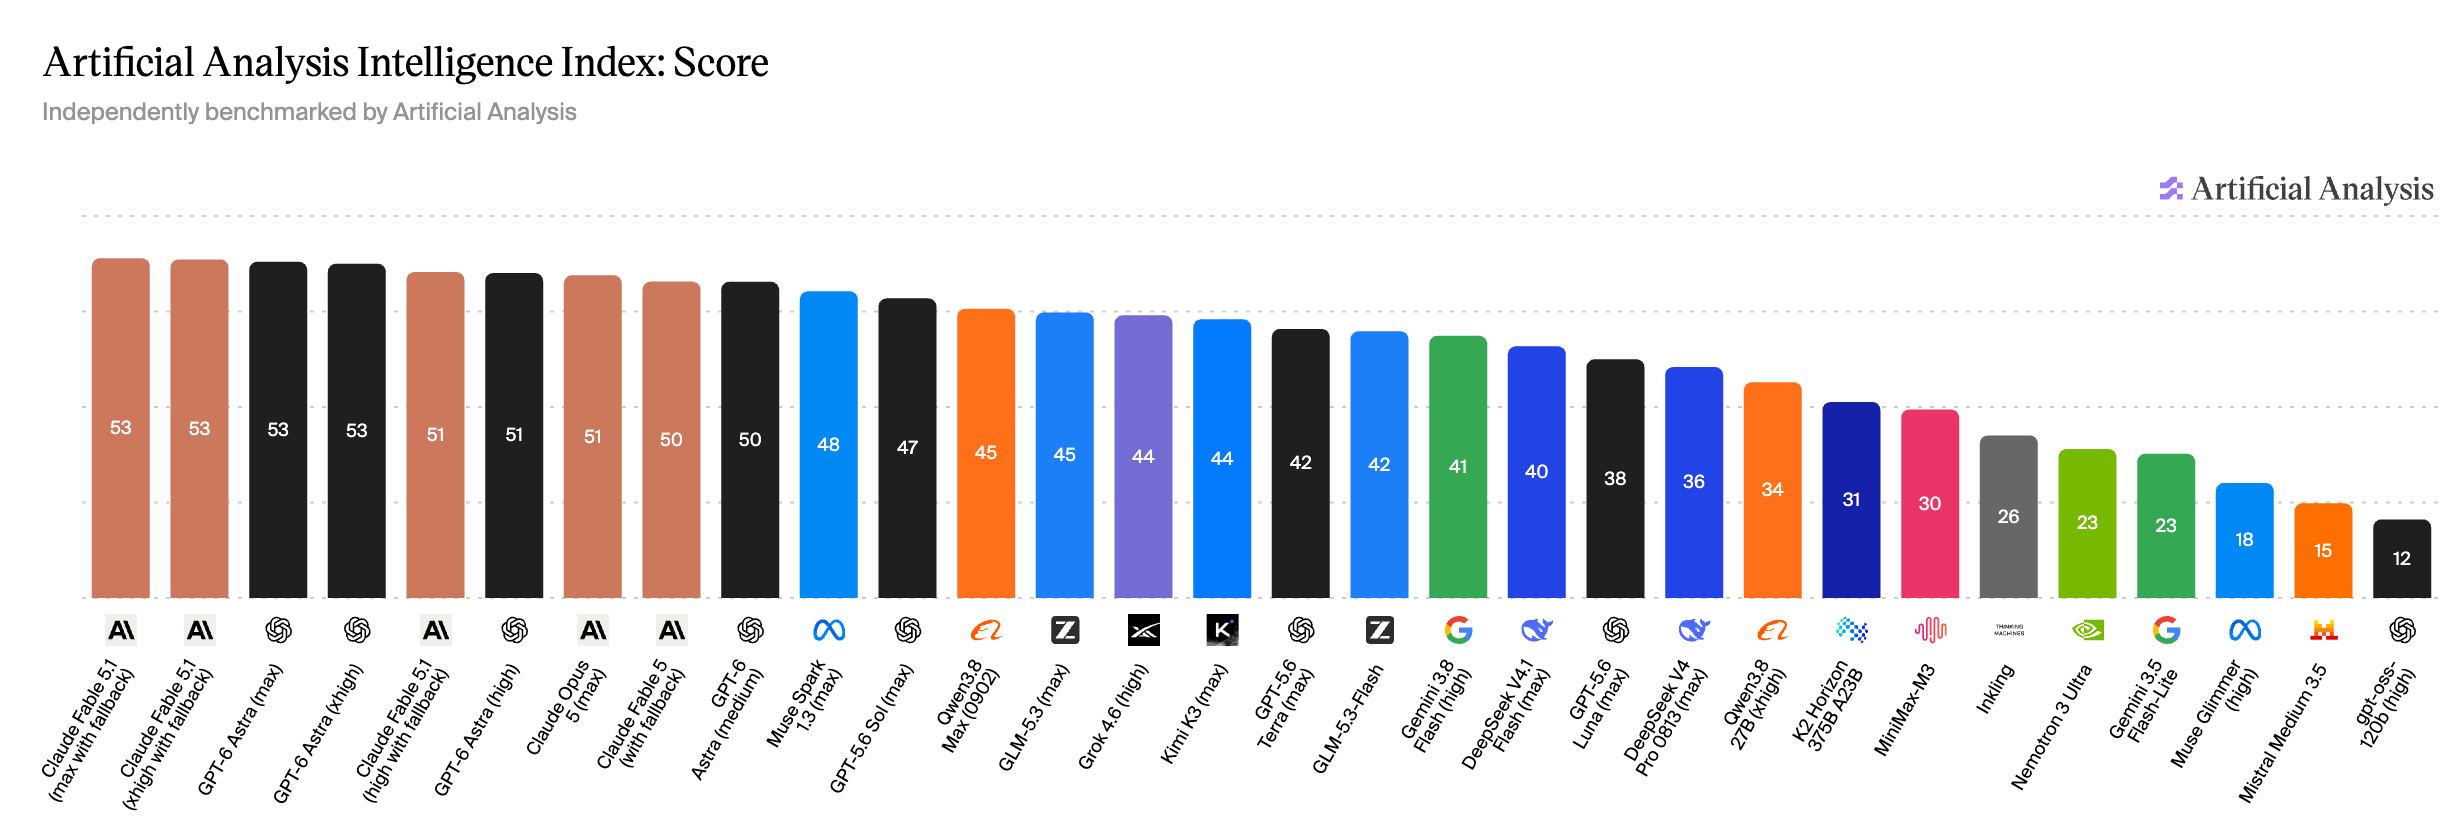
At the time of writing, two providers lead the field, Anthropic and OpenAI,
and no other provider offers models at quite the same level. On 17 September 2026, for
instance, the nine highest scores on the Artificial Analysis Intelligence Index
all went to Anthropic and OpenAI models
(Figure 1figure 1).
The index combines ten demanding tests that the company runs
itself.Artificial Analysis, Artificial Analysis Intelligence Index, version 4.3, read 17 September 2026: “a composite benchmark aggregating ten challenging evaluations”, covering mathematics, science, coding and reasoning, “conducted independently by Artificial Analysis”.
A ranking of this kind comes with two caveats:
It is a snapshot. It changes with every release, and the index page shows
the current one.
Figure 1. The Artificial Analysis Intelligence Index on 17 September 2026, one bar per model and effort setting.
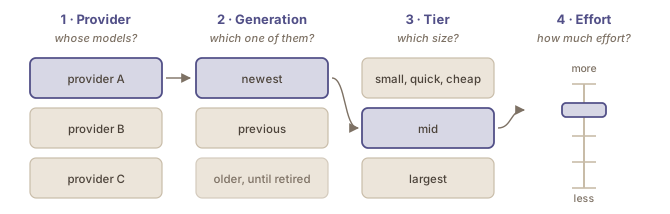
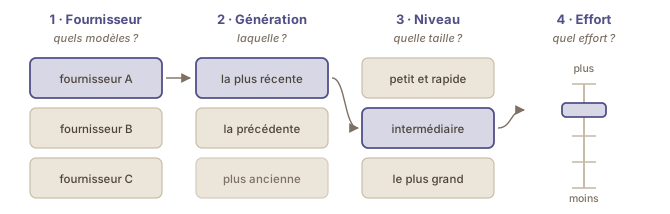
Once you have selected a provider, there are further choices to make, and the
provider may make some of them for you. Figure 2figure 2
shows all four. The generation and the tier are discussed below, and effort has
a page of its own (see also the Execution “effort” page, in the Using LLMs module) (voir aussi la page L'« effort » d'exécution, dans le module Utiliser les GML).
Figure 2. The four choices behind a model menu.
Choice 2: generation (if more than one is offered)
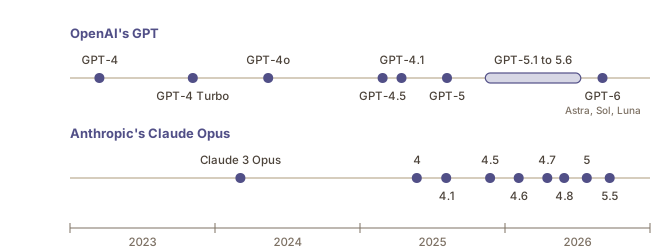
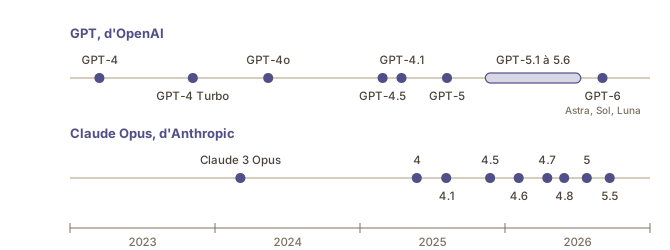
A family is a succession of models rather than one model, and the succession is
not always tidy: OpenAI, for instance, released GPT-4.5 before GPT-4.1
(Figure 3figure 3).
Figure 3. Two families by release date, as announced by OpenAI and Anthropic (checked 24 September 2026).
Releases have also come ever closer together. Fourteen months passed between
Claude 3 Opus and Claude Opus 4; after that, Anthropic released seven more Opus
models in sixteen months, and OpenAI went from GPT-5.1 to GPT-5.6 in eight.
What you read about a model therefore goes out of date sooner than it used to.
Older generations usually stay available for a while, so the list you choose
from mixes generations with tiers.
Two things are relevant to keep in mind regarding these generations:
Anything you read about a named model is about one generation. A study
that tested GPT-4, or a colleague’s verdict on a model retired last year,
may describe something no longer running anywhere.
Tier names are often used across generations. The same word names a
different model each time, so a claim about Claude Opus or about Claude Sonnet
means something only with the generation attached. Write down the exact model
name and the date whenever you rely on a result.
Choice 3: tier
Inside one generation, providers often offer several models of different sizes,
for example:
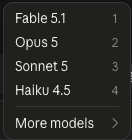
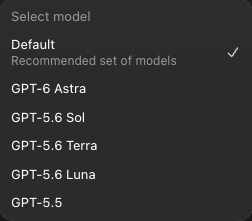
In a model list, generations and tiers appear side by side
(Figure 4figure 4 and
Figure 5figure 5).
Whether you can pick the tier yourself depends on the product and on your plan,
which is set out beside the effort
settings (see also the Execution “effort” page, in the Using LLMs module) (voir aussi la page L'« effort » d'exécution, dans le module Utiliser les GML). This page
only describes the choices; which tier suits which task is a separate
question (see also the Which model for which task page, in the Using LLMs module) (voir aussi la page Quel modèle pour quelle tâche, dans le module Utiliser les GML).
Figure 4. Claude: the model list, with older models under More models. Figure 5. ChatGPT Work: three tiers of GPT-5.6 in one list with GPT-6 Astra and the older GPT-5.5.
Which of these choices changes the most
Most people choose the family once, keep whatever tier and effort they are given
and never look at the rest. Any of the four choices can change your results
considerably, and which one counts most depends on the task and on the models
available at the time.
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Presque tous les fournisseurs proposent une seule famille : choisir la famille
revient donc à choisir le fournisseur. La performance des modèles n’est qu’un des
éléments de ce choix :
l’entreprise : ce que vous pensez d’elle et de sa conduite.
Qui domine le domaine
Au moment d’écrire ces lignes, deux fournisseurs dominent le domaine,
Anthropic et OpenAI, et aucun autre ne propose de modèles tout à fait du même
niveau. Le 17 septembre 2026, par exemple, les neuf meilleurs scores de l’Artificial
Analysis Intelligence Index revenaient tous à des modèles d’Anthropic et d’OpenAI
(Figure 1figure 1).
L’indice combine dix tests exigeants menés par l’entreprise
elle-même.Artificial Analysis, Artificial Analysis Intelligence Index, version 4.3, consulté le 17 septembre 2026 : « a composite benchmark aggregating ten challenging evaluations », qui porte sur les mathématiques, les sciences, la programmation et le raisonnement, avec des évaluations « conducted independently by Artificial Analysis ».
Un tel classement appelle deux réserves :
Il ne vaut qu’au moment où il est consulté. Il change à chaque nouvelle
version, et la page de l’indice présente le classement à jour.
Le sommet n’est pas toujours nécessaire. Pour bien des tâches, un modèle un
peu en retrait des meilleurs donne aussi de bons
résultats (see also the LLM leaderboards chapter, in the Using LLMs module) (voir aussi le chapitre Les classements de GML, dans le module Utiliser les GML).
Figure 1. L'Artificial Analysis Intelligence Index le 17 septembre 2026, une barre par modèle et par réglage d'effort. Le graphique est en anglais.
Une fois le fournisseur choisi, il reste d’autres choix à faire, et le fournisseur
peut en faire certains à votre place. La Figure 2figure 2
montre les quatre. La génération et le niveau sont présentés plus bas, et
l’effort a sa propre page (see also the Execution “effort” page, in the Using LLMs module) (voir aussi la page L'« effort » d'exécution, dans le module Utiliser les GML).
Figure 2. Les quatre choix derrière un menu de modèles.
Choix 2 : génération (si plusieurs sont proposées)
Une famille est une succession de modèles plutôt qu’un seul modèle, et cette
succession n’est pas toujours ordonnée : OpenAI, par exemple, a publié GPT-4.5
avant GPT-4.1 (Figure 3figure 3).
Figure 3. Deux familles selon leur date de parution, telle qu'annoncée par OpenAI et Anthropic (vérifiée le 24 septembre 2026).
Les nouvelles versions paraissent aussi de plus en plus rapprochées. Quatorze
mois ont séparé Claude 3 Opus de Claude Opus 4 ; Anthropic a ensuite publié sept
autres modèles Opus en seize mois, et OpenAI est passée de GPT-5.1 à GPT-5.6
en huit mois. Ce que vous lisez sur un modèle est donc dépassé plus vite
qu’auparavant.
Les anciennes générations restent généralement disponibles pendant un certain
temps, si bien que la liste proposée mélange générations et niveaux.
Deux choses sont à garder à l’esprit au sujet de ces générations :
Tout ce que vous lisez sur un modèle nommé porte sur une seule génération.
Une étude qui a testé GPT-4, ou l’avis d’un collègue sur un modèle retiré l’an
dernier, peut décrire quelque chose qui ne fonctionne plus nulle part.
Les noms de niveaux sont souvent repris d’une génération à l’autre. Le même
mot désigne chaque fois un modèle différent : une affirmation sur Claude Opus ou
sur Claude Sonnet n’a de sens que si la génération est précisée. Notez le nom
exact du modèle et la date dès qu’un résultat compte.
Choix 3 : niveau
Dans une même génération, les fournisseurs proposent souvent plusieurs modèles de
tailles différentes, par exemple :
Dans une liste de modèles, générations et niveaux apparaissent côte à côte
(Figure 4figure 4 et
Figure 5figure 5).
La possibilité de choisir vous-même le niveau dépend du produit et de votre
forfait, présentés avec les réglages
d’effort (see also the Execution “effort” page, in the Using LLMs module) (voir aussi la page L'« effort » d'exécution, dans le module Utiliser les GML). Cette page
décrit seulement les choix ; savoir quel niveau convient à quelle tâche est une
autre question (see also the Which model for which task page, in the Using LLMs module) (voir aussi la page Quel modèle pour quelle tâche, dans le module Utiliser les GML).
Figure 4. Claude : la liste des modèles, avec les anciens modèles sous « More models » (autres modèles). Figure 5. ChatGPT Work : trois niveaux de GPT-5.6 dans une même liste, avec GPT-6 Astra et l'ancien GPT-5.5.
Lequel de ces choix change le plus les résultats
La plupart des gens choisissent la famille une fois, gardent le niveau et l’effort
qu’on leur attribue et ne regardent jamais le reste. Pourtant, chacun des quatre
choix peut changer considérablement vos résultats, et celui qui compte le plus
dépend de la tâche et des modèles disponibles à ce moment-là.
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Execution “effort”L'« effort » d'exécution
Choice 4: effort (on the models that offer it)
Once you have decided which model to use, many of the top models at the time of
writing let you pick what their providers call “reasoning effort”, or something
similar. This setting controls how much computation the chosen model spends on
its answer. A higher setting is more expensive and takes more time, but can give
better results on tasks that are more
complex.
What this looks like in September 2026
The two largest providers at this time, Anthropic and OpenAI, rearranged these
controls during 2026, and will likely do so again several times in the coming
months and years. This section describes 16 September 2026, and it is the part of this
chapter most likely to be out of date when you read it.
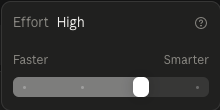
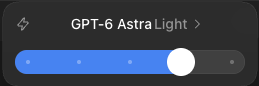
Claude and ChatGPT Work: you pick a model from a list, then one of five
effort levels, low to max in Claude (on every model except the smallest) and
light to ultra in ChatGPT Work
(Figure 6figure 6 and
Figure 7figure 7).
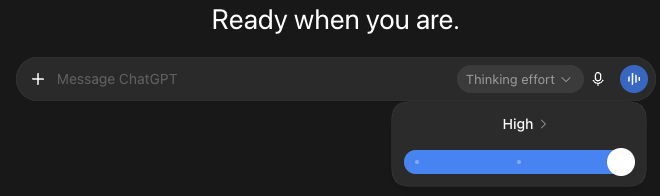
ChatGPT (chat): you do not pick the model, only a thinking effort, on a
slider whose levels depend on your plan: three (Instant, Medium and High) on
the first paid plan, with Extra High and Pro added on the higher plans
(Figure 8figure 8).
What you can choose depends on your plan. In Claude:
Plan
What you can choose
Free
Claude Sonnet and Claude Haiku
Pro
adds Claude Opus; Claude Fable only through usage credits, paid separately
Max
more usage; Claude Fable included, up to half of the weekly allowance
In ChatGPT:
Plan
What you can choose
Free and Go
GPT-5.6 Luna, with a Think button for harder questions
Plus, in the chat
GPT-5.6 Sol at Instant, Medium and High
Plus, in ChatGPT Work
GPT-6 Astra (with limited use), GPT-5.6 Sol, Terra and Luna
Pro, in the chat
every level, including Extra High and Pro, where GPT-6 Astra has a limited number of messages a week
Pro, in ChatGPT Work
the same models as on Plus, with more use of GPT-6 Astra
Anthropic, Change the model, effort, and thinking settings and plans and pricing; OpenAI, GPT-5.6 and GPT-6 Pro in ChatGPT. All read 16 September 2026; the ChatGPT Work models per plan re-read on 17 September 2026, with ChatGPT Work and Codex, read 17 September 2026.Figure 6. Claude: the effort slider, running from faster to smarter. Figure 7. ChatGPT Work: the effort slider, running light, medium, high, extra high, ultra. Figure 8. ChatGPT chat: the thinking effort slider, with three positions on this plan.
What is decided for you
Whatever you pick, part of the choice is made for you.
Your usage allowance. Every plan limits how much you can use, and the
allowance runs out sooner when you use larger models with more effort.
The models on offer. Your plan decides which models and levels you can
choose at all.
The default. Each product and model arrives with a setting chosen by the
provider, and many people never change it.
For the same reason, whenever you report output from an LLM, it is good practice
to state:
the model you used, by its exact name;
the settings, where they change the result;
the date.
Choix 4 : effort (sur les modèles qui le proposent)
Une fois le modèle choisi, bon nombre des meilleurs modèles actuels vous
permettent de régler ce que leurs fournisseurs appellent l’« effort de
raisonnement » (angl. reasoning effort), ou quelque chose d’approchant. Ce réglage
détermine la quantité de calcul que le modèle choisi consacre à sa réponse. Un
réglage plus élevé coûte plus cher et prend plus de temps, mais peut donner de
meilleurs résultats sur les tâches plus
complexes.
Ce que cela donne en septembre 2026
Les deux plus grands fournisseurs actuels, Anthropic et OpenAI, ont réorganisé ces
réglages au cours de 2026, et le feront probablement encore plusieurs fois dans
les mois et les années à venir. Cette section décrit la situation au 16 septembre 2026,
et c’est la partie de ce chapitre la plus susceptible d’être dépassée au moment où
vous la lisez.
Claude et ChatGPT Work : vous choisissez un modèle dans une liste, puis l’un
de cinq niveaux d’effort, de low à max dans Claude (sur tous les modèles sauf le
plus petit) et de light à ultra dans ChatGPT Work
(Figure 6figure 6 et
Figure 7figure 7).
ChatGPT (conversation) : vous ne choisissez pas le modèle, seulement un
effort de réflexion, sur un curseur dont les niveaux dépendent de votre forfait :
trois (Instant, Medium et High) avec le premier forfait payant, Extra High et
Pro s’y ajoutant avec les forfaits supérieurs
(Figure 8figure 8).
Ce que vous pouvez choisir dépend de votre forfait. Dans Claude :
Forfait
Ce que vous pouvez choisir
Gratuit
Claude Sonnet et Claude Haiku
Pro
ajoute Claude Opus ; Claude Fable seulement au moyen de crédits d’utilisation payés à part
Max
davantage d’utilisation ; Claude Fable inclus, jusqu’à la moitié du quota hebdomadaire
Dans ChatGPT :
Forfait
Ce que vous pouvez choisir
Gratuit et Go
GPT-5.6 Luna, avec un bouton « Think » pour les questions plus difficiles
Plus, dans la conversation
GPT-5.6 Sol en Instant, Medium et High
Plus, dans ChatGPT Work
GPT-6 Astra (avec un usage limité), GPT-5.6 Sol, Terra et Luna
Pro, dans la conversation
tous les niveaux, y compris Extra High et Pro, où GPT-6 Astra est limité à un certain nombre de messages par semaine
Pro, dans ChatGPT Work
les mêmes modèles qu’avec le forfait Plus, avec un usage plus large de GPT-6 Astra
Anthropic, Change the model, effort, and thinking settings et plans and pricing ; OpenAI, GPT-5.6 and GPT-6 Pro in ChatGPT. Tous consultés le 16 septembre 2026 ; les modèles offerts dans ChatGPT Work selon le forfait ont été revérifiés le 17 septembre 2026 dans ChatGPT Work and Codex.Figure 6. Claude : le curseur d'effort, de « Faster » (plus rapide) à « Smarter » (plus intelligent). Figure 7. ChatGPT Work : le curseur d'effort, de light à ultra en passant par medium, high et extra high. Figure 8. ChatGPT (conversation) : le curseur « Thinking effort » (effort de réflexion), à trois positions avec ce forfait.
Ce qui est décidé pour vous
Quoi que vous choisissiez, une partie du choix est faite à votre place.
Votre quota d’utilisation. Chaque forfait limite votre utilisation, et le
quota s’épuise plus vite avec de plus grands modèles et plus d’effort.
Les modèles proposés. Votre forfait détermine quels modèles et quels
niveaux vous pouvez choisir.
Le réglage par défaut. Chaque produit et chaque modèle arrive avec un
réglage choisi par le fournisseur, que bien des gens ne changent jamais.
Pour la même raison, chaque fois que vous rapportez un résultat produit par un
GML, il est de bonne pratique d’indiquer :
le modèle utilisé, sous son nom exact ;
les réglages, lorsqu’ils comptent ;
la date.
Chat app, API or your own computerApplication, API ou votre propre ordinateur
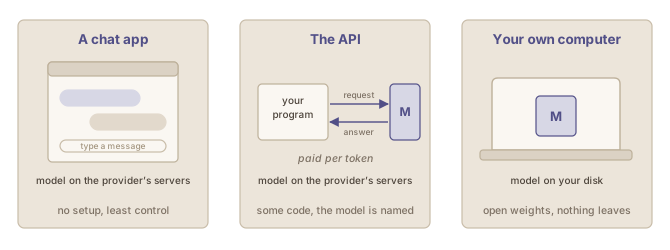
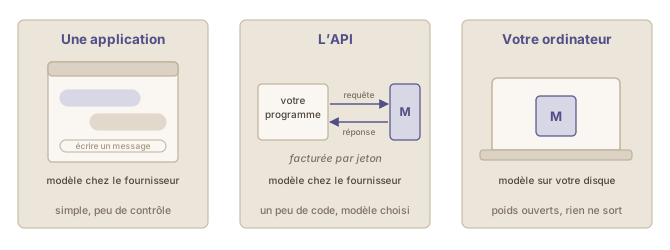
Three ways in
You can reach a model in three ways, which differ in effort, in control, in cost
and in who has access to your text
(Figure 9figure 9).
Figure 9. A chat app, a program using the API, and a model running locally.
Chat app
API
Your own computer
Effort
none
some code
hardware and setup
Who picks the model
often the product
you
you
What it costs
a subscription or a free plan
per token
your hardware and time
Who has access to your text
the provider
the provider
you
A chat app
Most people interact with models through a chat app in the browser or on the
phone. A chat app is the easiest arrangement, and the one with the least control:
easy: nothing to install, a conversation history, file upload, search and
other tools built in;
With the API, a program of yours, or a program somebody wrote for you, sends
requests to the provider’s servers and receives the answers. The API takes a
little code, and gives you more control:
you name the exact model and effort instead of taking what the product
gives you;
The third way is to download an open-weight model and run it on your own
computer. Compared with the other two ways:
privacy: nothing leaves your machine, which for confidential material is
the only arrangement that removes the question of who has access to your text;
effort: it takes hardware and setup;
capability: the models that fit on a laptop are well behind the largest
hosted ones, and at the time of writing, even the largest open-weight models,
which need a powerful server, generally trail the best hosted models.
With a subscription, you pay a fixed amount and do not see what each message
costs. With the API, you pay for every token, so you see what makes an exchange
expensive. Knowing this also helps you understand the limits of a subscription.
Output costs more than input. Providers charge several times more per
token for what the model writes than for what it reads.
Reasoning is billed. The tokens a model generates while reasoning count
as output, whether or not you are shown them.
On a subscription, the same costs count against your usage limit, which is why
you reach the limit sooner in a long conversation with a large model.
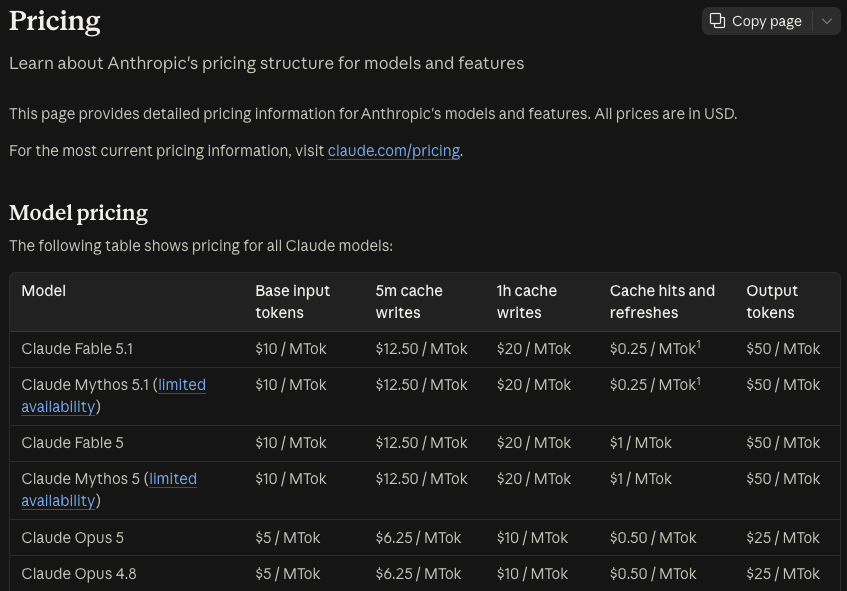
For an idea of scale, here are the smallest and the largest model on both
providers’ API price lists, in US dollars per million tokens
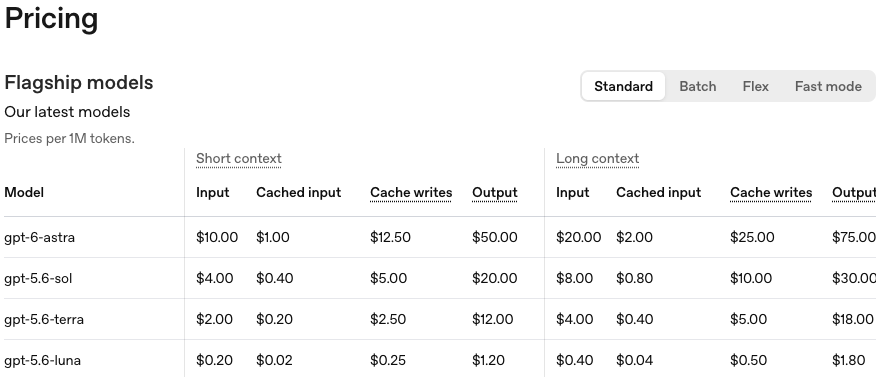
(Figure 10figure 10
and Figure 11figure 11):Anthropic pricing and OpenAI pricing, both read 16 September 2026.
Provider
Model
Input
Output
Anthropic, smallest
Claude Haiku 4.5
1
5
Anthropic, largest
Claude Fable 5.1
10
50
OpenAI, smallest
GPT-5.6 Luna
0.20
1.20
OpenAI, largest
GPT-6 Astra
10
50
Two things stand out:
output costs five to six times as much as input;
the largest model costs many times more than the smallest: about ten times
more at Anthropic, about fifty times more at OpenAI.
OpenAI also charges more when the context is long.
Figure 10. Anthropic: API prices per million tokens (MTok), top of the table, captured 16 September 2026. Figure 11. OpenAI: API prices per million tokens for its flagship models, captured 16 September 2026. The columns on the right apply to a long context.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
On peut accéder à un modèle de trois façons, qui diffèrent par l’effort demandé,
le contrôle, le coût et les personnes qui ont accès à votre texte
(Figure 9figure 9).
Figure 9. Une application conversationnelle, un programme qui utilise l'API et un modèle exécuté localement.
Application conversationnelle
API
Votre ordinateur
Effort
aucun
un peu de code
matériel et installation
Qui choisit le modèle
souvent le produit
vous
vous
Coût
un abonnement ou un forfait gratuit
au jeton
votre matériel et votre temps
Qui a accès à votre texte
le fournisseur
le fournisseur
vous
Une application conversationnelle
La plupart des gens utilisent les modèles au moyen d’une application
conversationnelle, dans le navigateur ou sur le téléphone. Une application
conversationnelle est la formule la plus simple, et celle qui laisse le moins de
contrôle :
la simplicité : rien à installer, un historique des conversations, le
téléversement de fichiers, la recherche et d’autres outils intégrés ;
Avec l’interface de programmation d’application (API), un programme à vous,
ou écrit pour vous, envoie des requêtes aux serveurs du fournisseur et reçoit les
réponses. L’API demande un peu de code, et vous donne plus de contrôle :
vous désignez le modèle et l’effort exacts au lieu de prendre ce que le
produit vous donne ;
La troisième façon consiste à télécharger un modèle à poids ouverts et à le
faire tourner sur votre ordinateur. Par rapport aux deux autres façons :
la confidentialité : rien ne quitte votre machine, ce qui, pour des
documents confidentiels, est la seule formule qui règle la question de savoir
qui a accès à votre texte ;
l’effort : il faut du matériel et de l’installation ;
la capacité : les modèles qui tiennent sur un ordinateur portable sont
nettement en retrait des plus grands modèles hébergés, et au moment d’écrire
ces lignes, même les plus grands modèles à poids ouverts, qui demandent un
serveur puissant, restent généralement derrière les meilleurs modèles hébergés.
Avec un abonnement, vous payez un montant fixe et ne voyez pas ce que coûte chaque
message. Avec l’API, vous payez chaque jeton, et vous voyez donc ce qui rend un
échange coûteux. Savoir cela aide aussi à comprendre les limites d’un abonnement.
La sortie coûte plus cher que l’entrée. Les fournisseurs facturent plusieurs
fois plus cher par jeton ce que le modèle écrit que ce qu’il lit.
Le raisonnement est facturé. Les jetons que génère un modèle pendant qu’il
raisonne comptent comme sortie, qu’on vous les montre ou
non.
Avec un abonnement, ces mêmes coûts sont déduits de votre limite d’utilisation :
c’est pourquoi vous atteignez la limite plus vite dans une longue conversation
avec un grand modèle.
Pour donner un ordre de grandeur, voici le plus petit et le plus grand modèle des
grilles tarifaires de l’API des deux fournisseurs, en dollars américains par
million de jetons
(Figure 10figure 10
et Figure 11figure 11) :Anthropic, pricing, et OpenAI, pricing, tous deux consultés le 16 septembre 2026.
Fournisseur
Modèle
Entrée
Sortie
Anthropic, le plus petit
Claude Haiku 4.5
1
5
Anthropic, le plus grand
Claude Fable 5.1
10
50
OpenAI, le plus petit
GPT-5.6 Luna
0,20
1,20
OpenAI, le plus grand
GPT-6 Astra
10
50
Deux choses ressortent :
la sortie coûte cinq à six fois plus cher que l’entrée ;
le plus grand modèle coûte bien plus que le plus petit : environ dix fois
plus chez Anthropic, environ cinquante fois plus chez OpenAI.
OpenAI facture aussi davantage lorsque le contexte est long.
Figure 10. Anthropic : prix de l'API par million de jetons (MTok), haut du tableau, capture du 16 septembre 2026. « Base input tokens » correspond aux jetons d'entrée, « Output tokens » aux jetons de sortie. Figure 11. OpenAI : prix de l'API par million de jetons pour ses modèles phares, capture du 16 septembre 2026. Les colonnes de droite (« Long context ») s'appliquent aux contextes longs.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Which model for which taskQuel modèle pour quelle tâche
Why there is no simple table
Two tasks that look equally hard to you can fall on opposite sides of what a
model manages, so no table of tasks and models can tell you which model to use
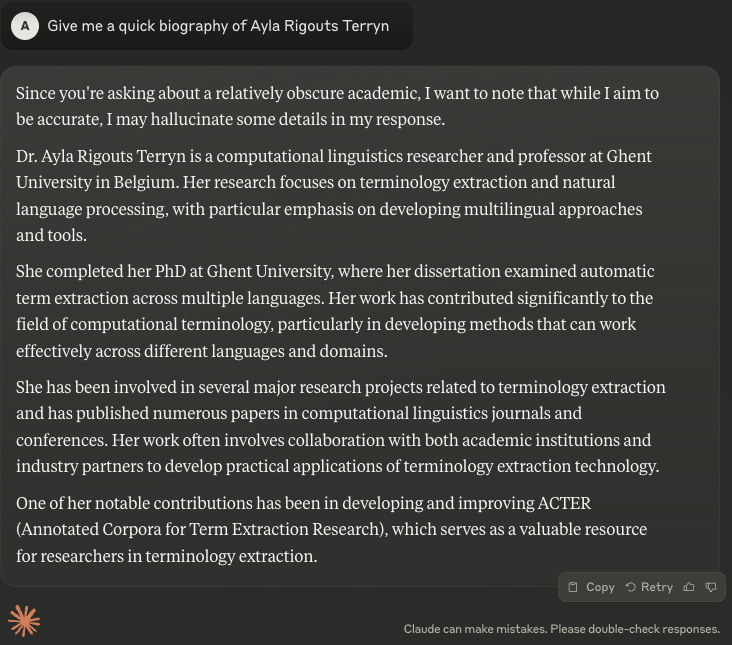
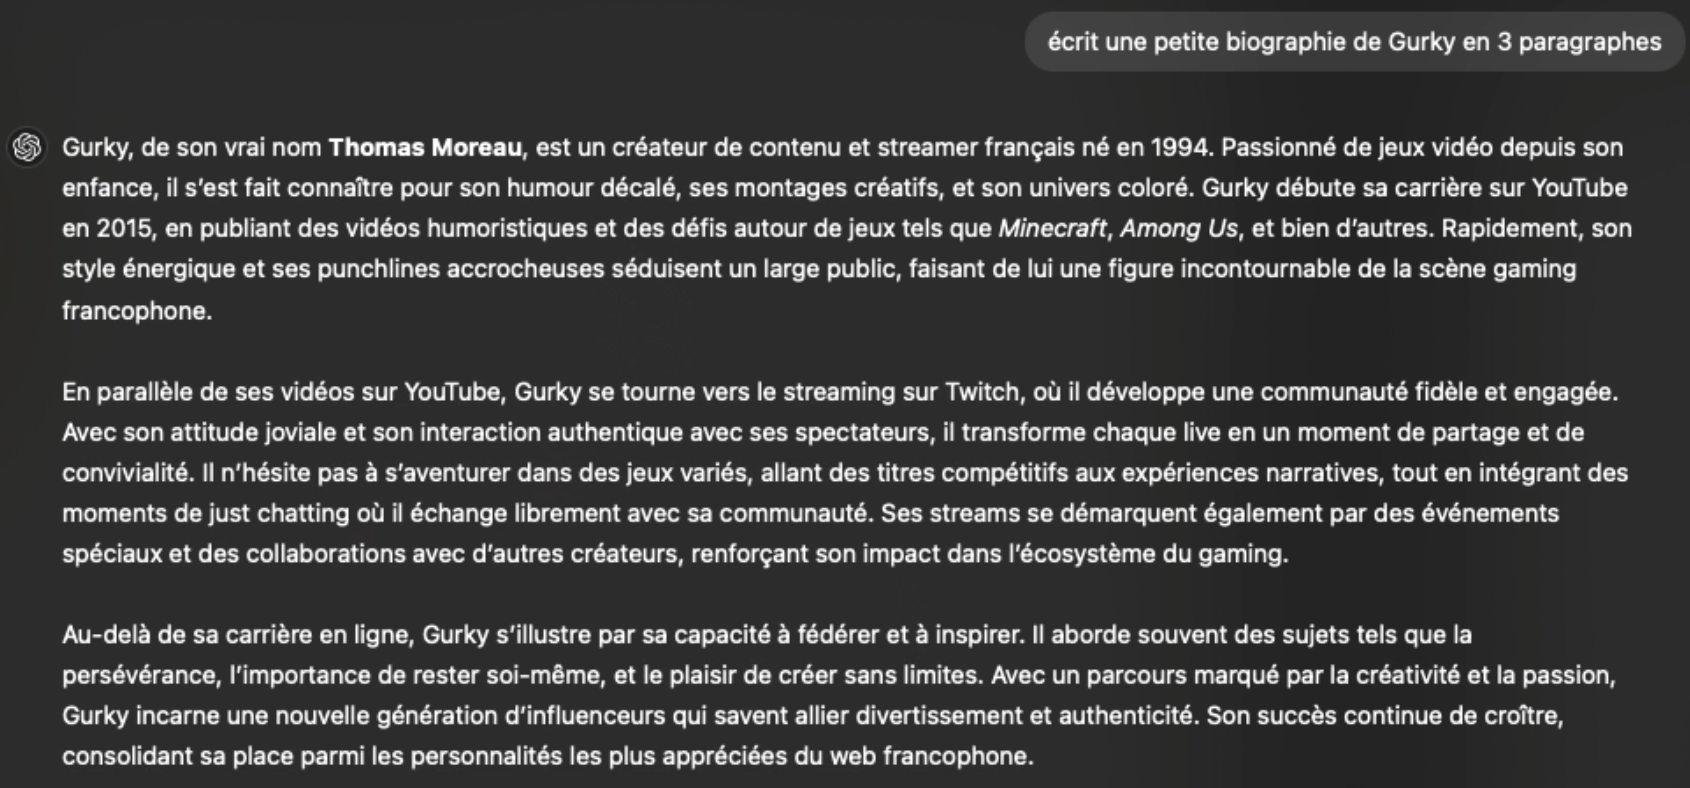
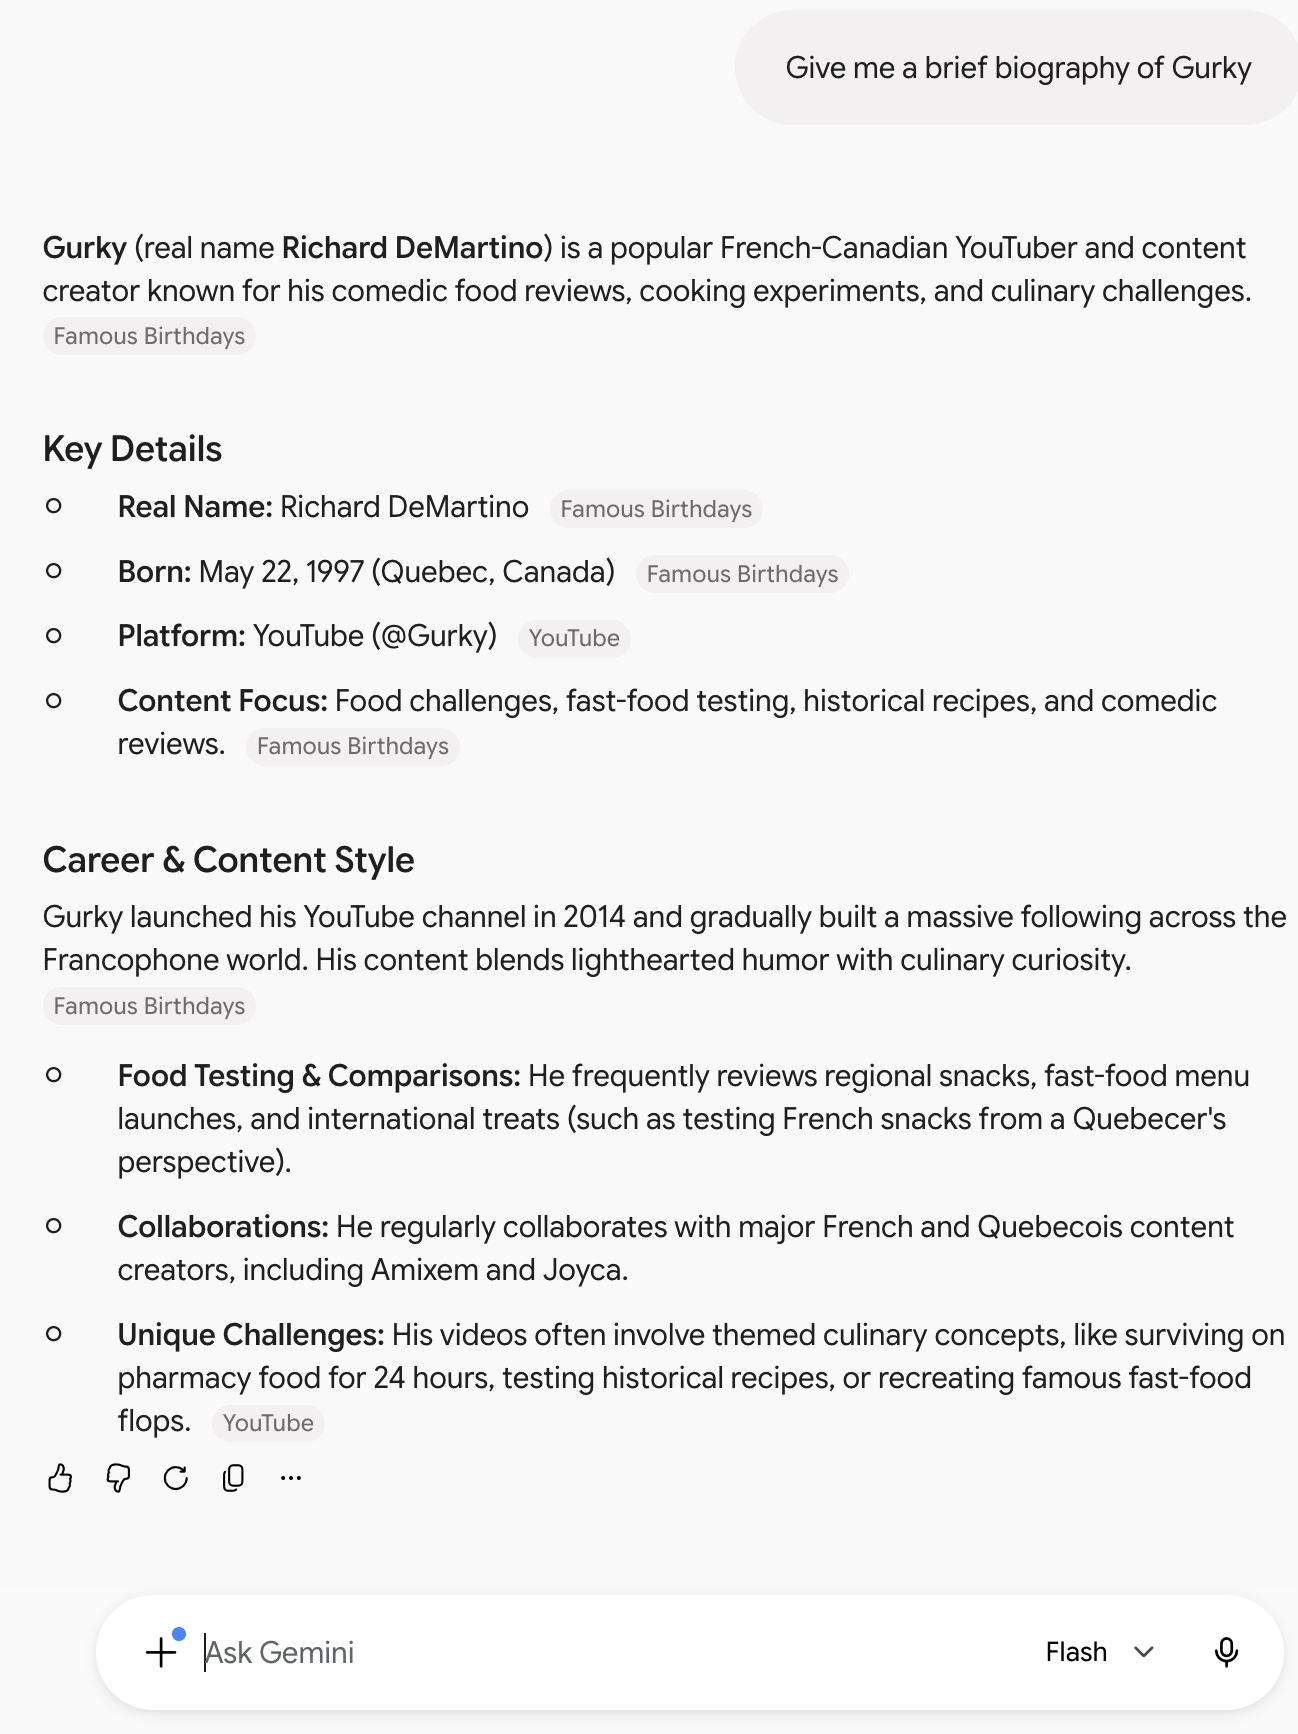
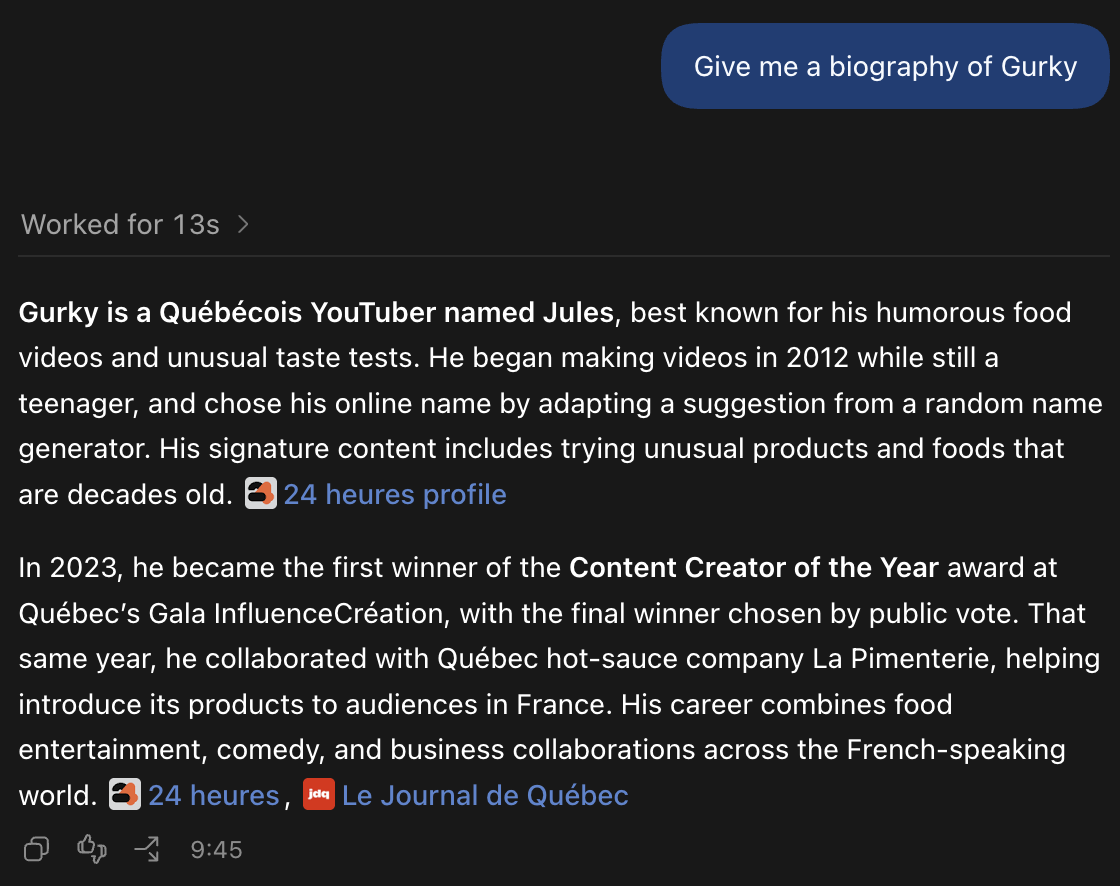
(Dell’Acqua et al., 2026). Where a
model stops managing also changes every time a new one comes out, so a
recommendation written down today is out of date within months.
The practical answer is to compare:
open the same task in two or three assistants;
work through a few exchanges in each;
keep the one that helps you most.
When I have an important task, I sometimes do exactly that, and after one to
three turns it is usually obvious which model is helping me best. Such a
comparison tells you about that task, and little about the products in
general (see also the Testing it yourself page, in the Using LLMs module) (voir aussi la page Faire vos propres tests, dans le module Utiliser les GML). I only do
it when the task is really important, because running it two or three times also
multiplies the cost, in money and in energy.
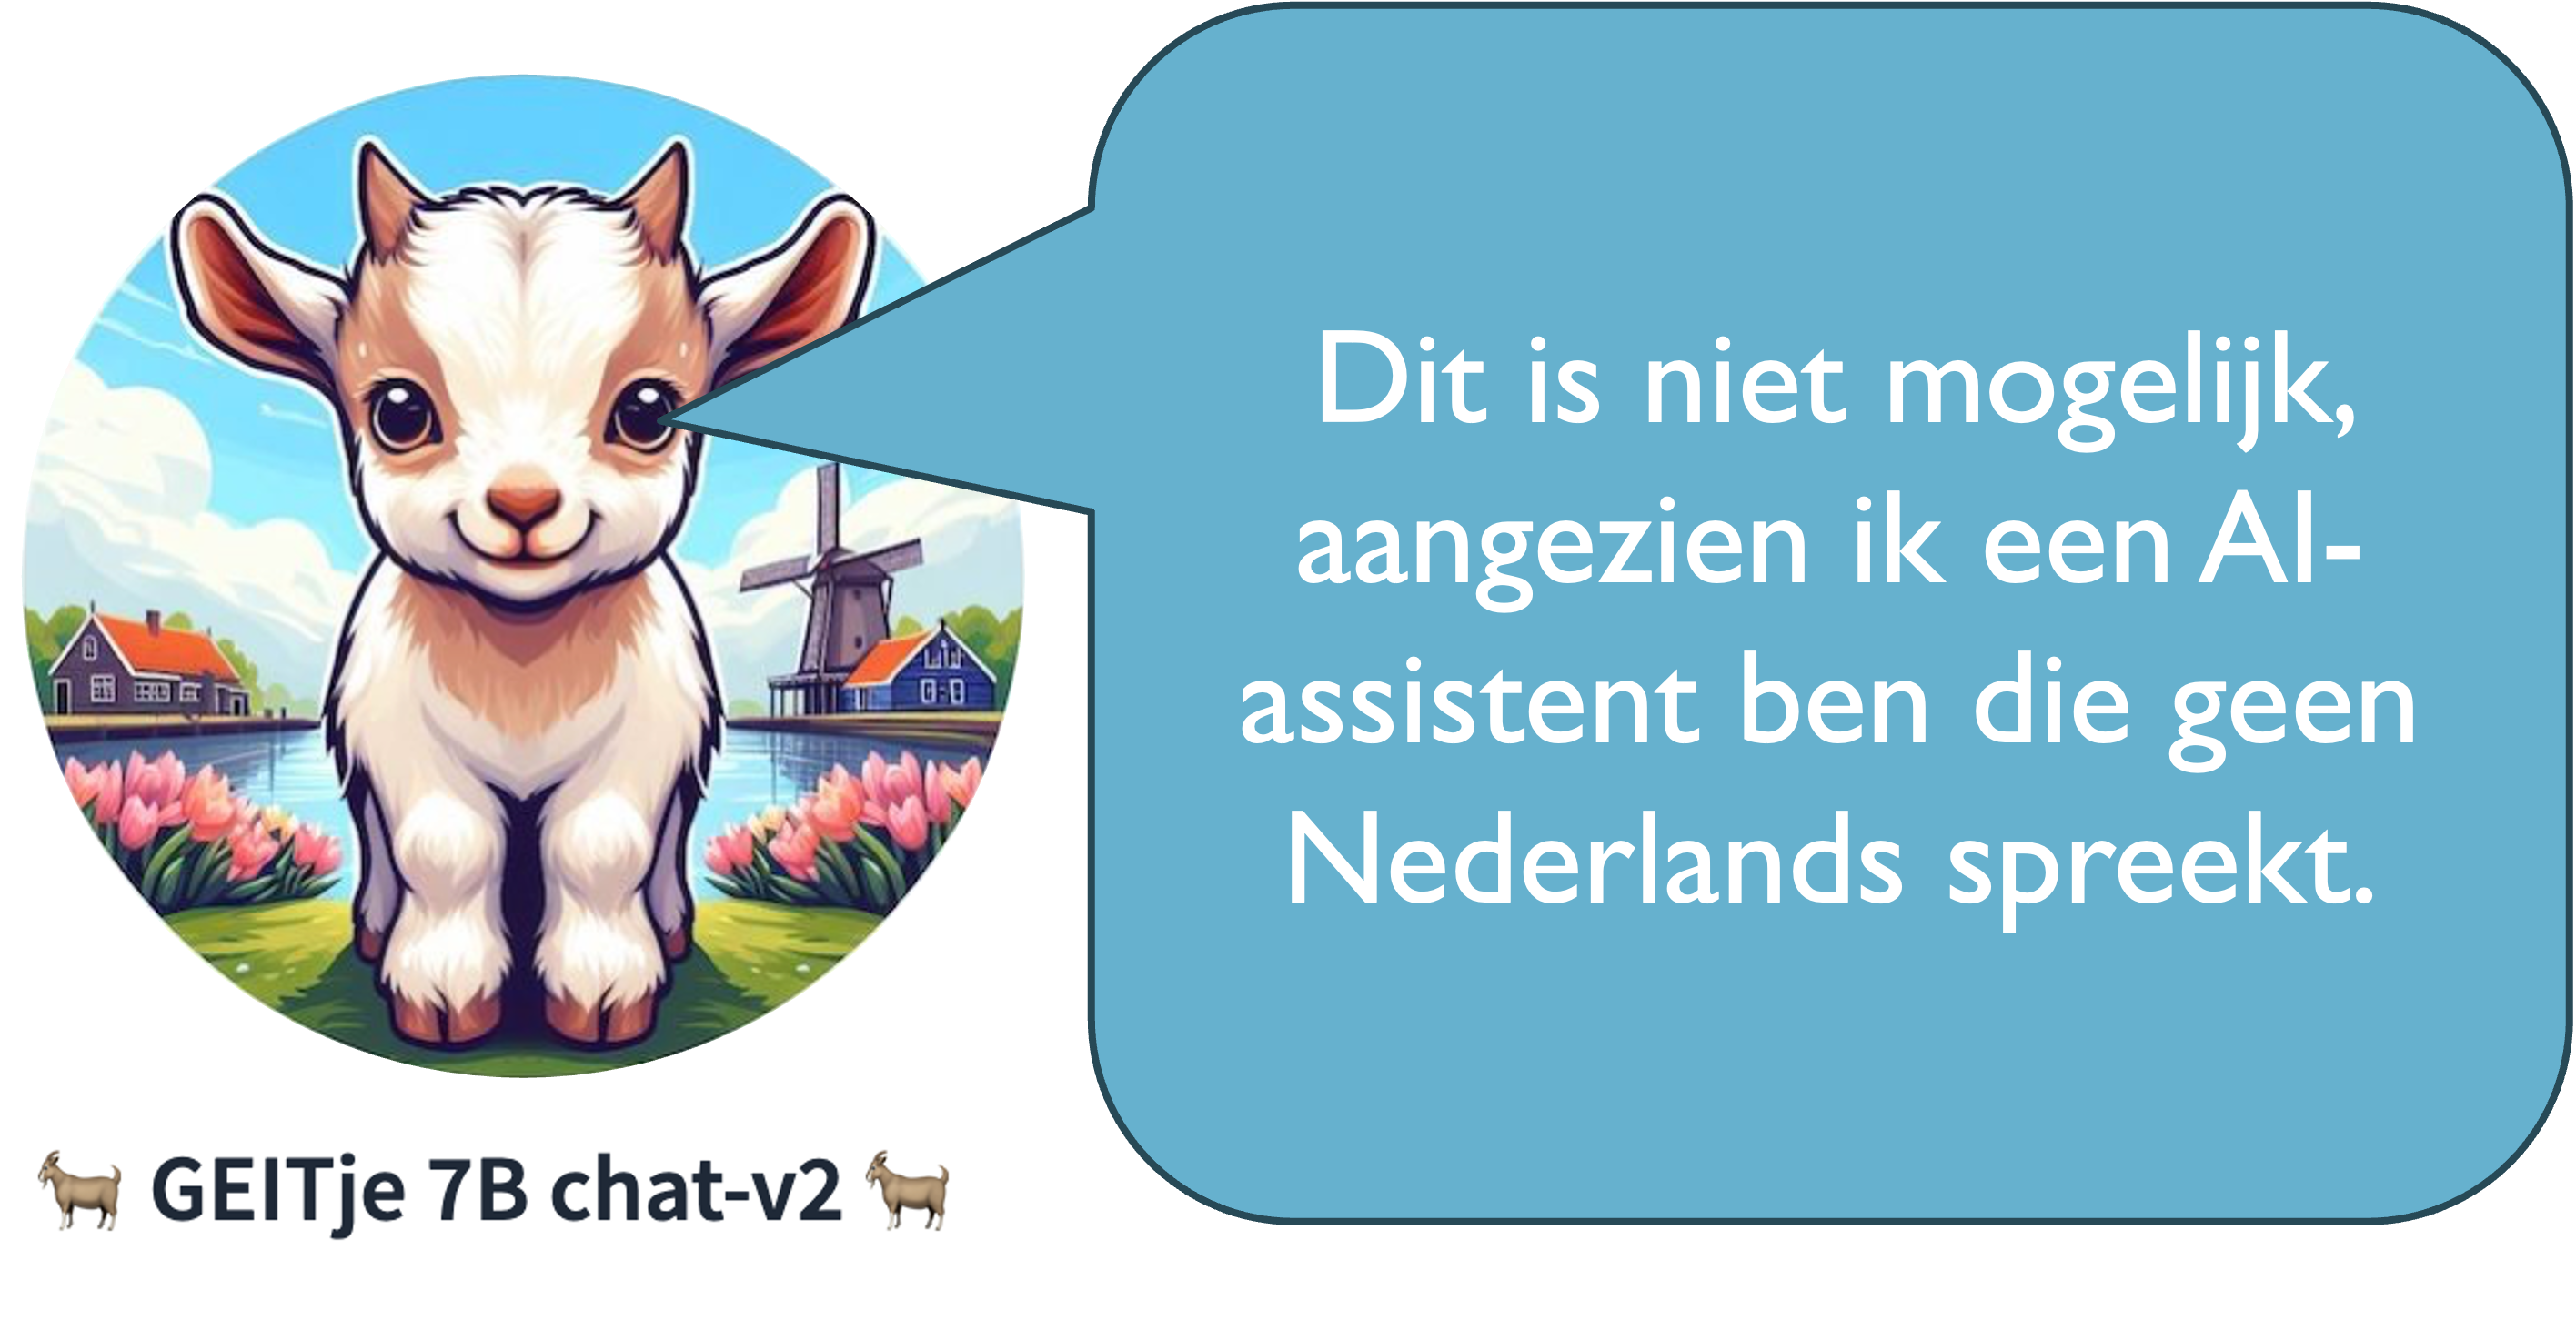
Figure 12. GEITje 7B chat-v2 declining a Dutch task in Dutch, early 2024. The reply reads: this is not possible, since I am an AI assistant that does not speak Dutch.
Matching the tier and the effort
Between families the ordering changes with each release. Inside a family the
rule is steadier:
Task
What usually suffices
Chatting, a quick factual question on a well-covered topic, a short email or summary, rephrasing a paragraph, a first draft you will revise anyway
Analyzing data or a long report, planning something with many constraints, comparing options against several criteria, checking a text against a long set of rules such as a style guide, anything with a chain of conditions
a larger model, a higher effort level, or both
A small model at a low effort level answers sooner, costs less and uses less
energy. A larger model, or a higher effort level, spends more computation on the
answer, which pays where the task has several parts and being wrong is
expensive, and adds only delay and expense where it does
not.
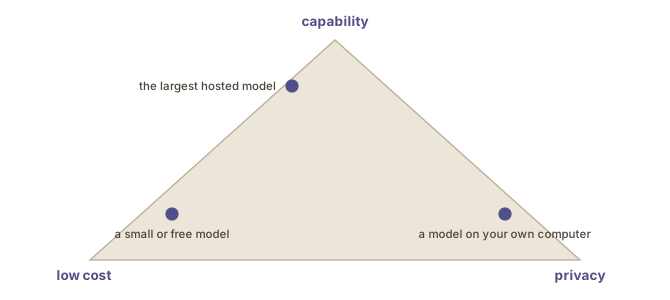
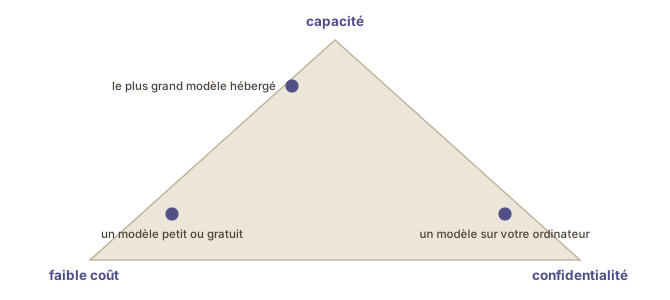
Capability, cost and privacy
The three pull against each other, and no option is best on all three
(Figure 13figure 13).
Figure 13. Three things that will not all be satisfied by one option.
Option
Capability
Cost
Privacy
The largest hosted model
the highest
the most expensive per use
your text is on the provider’s servers, under its terms
A small or free hosted model
lower
the cheapest and easiest
your text is on the provider’s servers, under its terms
A model on your own computer
lower
hardware and technical work
nothing leaves your machine
When the material is confidential, privacy is often the corner that decides,
and it is the one least often considered. What a provider may do with your text
depends on its terms, and what you may share depends on your obligations to an
employer, a client or the people the text is about. Either can rule out an
option that would otherwise be
better (see also the Training, retention and privacy settings page, in the Using LLMs module) (voir aussi la page Entraînement, conservation et paramètres de confidentialité, dans le module Utiliser les GML).
Sources
Dell'Acqua, F., McFowland, E., III, Mollick, E., Lifshitz, H., Kellogg, K. C., Rajendran, S., et al. (2026). Navigating the Jagged Technological Frontier: Field Experimental Evidence of the Effects of Artificial Intelligence on Knowledge Worker Productivity and Quality. Organization Science, 37(2), 403–423. https://doi.org/10.1287/orsc.2025.21838
Pourquoi il n’existe pas de tableau simple
Deux tâches qui vous semblent aussi difficiles l’une que l’autre peuvent tomber
de part et d’autre de ce qu’un modèle réussit : aucun tableau croisant tâches et
modèles ne peut donc vous dire quel modèle utiliser (Dell’Acqua et al.,
2026). Là où un modèle cesse de
réussir change aussi à chaque nouvelle version, si bien qu’une recommandation
écrite aujourd’hui est dépassée en quelques mois.
La solution pratique est de comparer :
soumettez la même tâche à deux ou trois assistants ;
menez quelques échanges avec chacun ;
gardez celui qui vous aide le mieux.
Quand j’ai une tâche importante, c’est parfois ce que je fais, et après un à trois
échanges, on voit généralement sans peine quel modèle m’aide le mieux. Une telle
comparaison vous renseigne sur cette tâche, et peu sur les produits en
général (see also the Testing it yourself page, in the Using LLMs module) (voir aussi la page Faire vos propres tests, dans le module Utiliser les GML). Je ne le
fais que lorsque la tâche compte vraiment, parce que la faire deux ou trois fois
multiplie aussi le coût, en argent et en énergie.
Figure 12. GEITje 7B chat-v2 refusant en néerlandais une tâche en néerlandais, début de 2024. La réponse signifie : ce n'est pas possible, puisque je suis un assistant d'IA qui ne parle pas néerlandais.
Choisir le niveau et l’effort
D’une famille à l’autre, le classement change à chaque nouvelle version. Dans une
même famille, la règle est plus stable :
Tâche
Ce qui suffit généralement
Converser, poser une question factuelle sur un sujet bien documenté, rédiger un court courriel ou un résumé, reformuler un paragraphe, produire une première version que vous réviserez de toute façon
Analyser des données ou un long rapport, planifier quelque chose qui comporte beaucoup de contraintes, comparer des options selon plusieurs critères, vérifier un texte selon un long ensemble de règles comme un guide de rédaction, tout ce qui enchaîne des conditions
un modèle plus grand, un niveau d’effort plus élevé, ou les deux
Un petit modèle à faible niveau d’effort répond plus vite, coûte moins cher et
consomme moins d’énergie. Un modèle plus grand, ou un niveau d’effort plus élevé,
consacre plus de calcul à la réponse, ce qui est payant quand la tâche comporte
plusieurs étapes et qu’une erreur coûte cher, et n’ajoute que du délai et des
frais dans le cas
contraire.
Capacité, coût et confidentialité
Les trois tirent dans des directions opposées, et aucune option n’est la meilleure
sur les trois
(Figure 13figure 13).
Figure 13. Trois exigences qu'aucune option ne satisfait toutes à la fois.
Option
Capacité
Coût
Confidentialité
Le plus grand modèle hébergé
la plus élevée
le plus cher à l’usage
votre texte se trouve sur les serveurs du fournisseur, selon ses conditions
Un petit modèle hébergé ou gratuit
moindre
le moins cher et le plus simple
votre texte se trouve sur les serveurs du fournisseur, selon ses conditions
Un modèle sur votre ordinateur
moindre
du matériel et du travail technique
rien ne quitte votre machine
Quand les documents sont confidentiels, la confidentialité est souvent le critère
qui l’emporte, et c’est celui auquel on pense le moins. Ce qu’un fournisseur peut
faire de votre texte dépend de ses conditions, et ce que vous pouvez communiquer
dépend de vos obligations envers un employeur, un client ou les personnes dont
parle le texte. L’un ou l’autre peut écarter une option qui serait autrement
meilleure (see also the Training, retention and privacy settings page, in the Using LLMs module) (voir aussi la page Entraînement, conservation et paramètres de confidentialité, dans le module Utiliser les GML).
Sources
Dell'Acqua, F., McFowland, E., III, Mollick, E., Lifshitz, H., Kellogg, K. C., Rajendran, S., et al. (2026). Navigating the Jagged Technological Frontier: Field Experimental Evidence of the Effects of Artificial Intelligence on Knowledge Worker Productivity and Quality. Organization Science, 37(2), 403–423. https://doi.org/10.1287/orsc.2025.21838
Testing it yourselfFaire vos propres tests
One test says little
Suppose you tried Gemini a year ago, gave it a task from your own work, found
the result poor and concluded that this was not something a model could do for
you. That conclusion is too generalized. In reality, you can only draw that
conclusion for that one specific test, on that task, that day. Changing any of
the following might have gotten you the answer you wanted:
another family, whose models happen to suit that kind of task;
a later generation of the one you tried;
a larger tier of the same generation;
a higher effort level on the model you already have;
So do not let a few tests with a single model, a few years or a few months ago,
stand as your opinion of what these systems can and cannot do.
The field moves fast
This field moves faster than anyone can follow, including the people who work
in it. Models are replaced every few months, the settings around them change
with them, and what they manage and what they fail at changes with every
release.
The only way to know whether today’s models manage a task is to try them on
that task. A leaderboard can point you to the models worth trying, but it
averages over other tasks, so it cannot settle the question for
you (see also the LLM leaderboards chapter, in the Using LLMs module) (voir aussi le chapitre Les classements de GML, dans le module Utiliser les GML).
How far to take it
How systematic to be depends on your work. If your tasks vary a lot, a full test
set is more than most people keep, and a lighter habit does most of the work:
when a new model or product comes out, or when you consider switching, give
it a few recent tasks whose results you remember well;
when a model fails at something important to you, note the task, so that
you can try it again later.
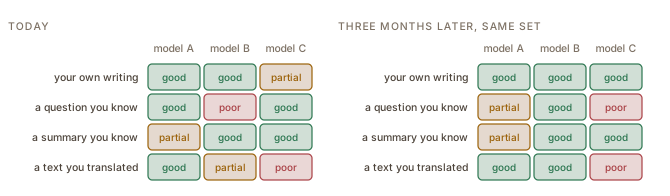
A more systematic set pays off when you do the same kind of task often, when you
choose a tool for a team or an organization, or when the comparison has to be
reliable, for instance in research. It then has four parts
(Figure 14figure 14):
three to five tasks from your own work with answers you trust: a typical
piece of writing or analysis with your own version as the reference, a
question in your field whose answer you know, a document you know well to
summarize. For a translator, one of them would be a text you have already
translated;
criteria decided in advance: what counts as good, how long it may take,
what it may cost;
two or three families, at two tiers each, so that a difference between
tiers is not mistaken for a difference between providers;
a record: the model’s exact name, the date, the settings and the prompt,
kept with the outputs.
Figure 14. A few tasks, a few models, and the same table rerun later.
Running the set against a new model takes minutes, and the same set rerun over
time shows you what a release changed for your work, which the release notes
will not. Progress is not always steady: a new version can do worse on one of
your tasks than the one before it, as model A and model C do on the question in
Figure 14figure 14.
Those reasons change more slowly than capability, but they do change: terms of
use and privacy settings are revised, so they are worth checking again now and
then.
comparisons are coloured: a product that already knows your preferences
can seem better than a fresh account elsewhere, for reasons that have nothing
to do with the model.
Un seul test en dit peu
Imaginons que vous ayez essayé Gemini il y a un an, que vous lui ayez confié une
tâche tirée de votre travail, que le résultat vous ait paru médiocre et que vous
en ayez conclu qu’un modèle ne pouvait pas faire cela pour vous. Cette conclusion
est trop générale. En réalité, elle ne vaut que pour ce test précis, sur cette
tâche, ce jour-là. En changeant l’un des éléments suivants, vous auriez peut-être
obtenu la réponse voulue :
une autre famille, dont les modèles conviennent mieux à ce genre de tâche ;
une génération plus récente de celle que vous avez essayée ;
un niveau supérieur de la même génération ;
un niveau d’effort plus élevé sur le modèle que vous utilisez déjà ;
Ne laissez donc pas quelques tests faits avec un seul modèle, il y a quelques
années ou quelques mois, tenir lieu d’opinion sur ce que ces systèmes peuvent faire
ou non.
Le domaine évolue vite
Ce domaine évolue plus vite que quiconque ne peut le suivre, y compris les
personnes qui y travaillent. Les modèles sont remplacés tous les quelques mois,
les réglages qui les entourent changent avec eux, et ce qu’ils réussissent ou
ratent change à chaque nouvelle version.
La seule façon de savoir si les modèles d’aujourd’hui réussissent une tâche est de
les essayer sur cette tâche. Un classement peut vous indiquer les modèles qui
valent la peine d’être essayés, mais il fait la moyenne sur d’autres tâches et ne
peut donc pas trancher à votre
place (see also the LLM leaderboards chapter, in the Using LLMs module) (voir aussi le chapitre Les classements de GML, dans le module Utiliser les GML).
Jusqu’où aller
Le degré de rigueur dépend de votre travail. Si vos tâches varient beaucoup, un
ensemble de tests complet dépasse ce que la plupart des gens tiennent à jour, et
une habitude plus légère fait l’essentiel du travail :
quand un nouveau modèle ou produit sort, ou quand vous envisagez de changer,
donnez-lui quelques tâches récentes dont vous vous rappelez bien les résultats ;
quand un modèle échoue sur quelque chose d’important pour vous, notez la tâche
pour pouvoir la réessayer plus tard.
Un ensemble plus systématique est rentable quand vous faites souvent le même genre
de tâche, quand vous choisissez un outil pour une équipe ou une organisation, ou
quand la comparaison doit tenir la route, par exemple en recherche. Il comporte
alors quatre éléments
(Figure 14figure 14) :
trois à cinq tâches tirées de votre travail, avec des réponses sûres : un
texte ou une analyse typique, avec votre propre version comme référence, une
question de votre domaine dont vous connaissez la réponse, un document que vous
connaissez bien à résumer. Pour un traducteur ou une traductrice, l’une d’elles
serait un texte déjà traduit ;
des critères fixés d’avance : ce qui compte comme bon, combien de temps cela
peut prendre, combien cela peut coûter ;
deux ou trois familles, à deux niveaux chacune, pour ne pas confondre une
différence entre niveaux avec une différence entre fournisseurs ;
une trace écrite : le nom exact du modèle, la date, les réglages et la
requête, conservés avec les résultats.
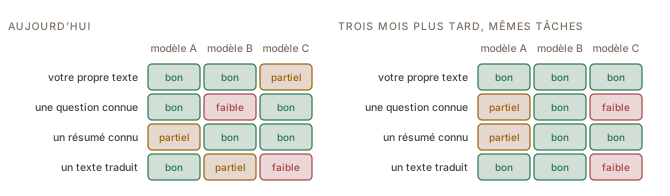
Figure 14. Quelques tâches, quelques modèles, et le même tableau refait plus tard.
Soumettre l’ensemble à un nouveau modèle prend quelques minutes, et le même
ensemble refait au fil du temps vous montre ce qu’une nouvelle version a changé
pour votre travail, ce que les notes de version ne diront pas. Les progrès ne sont
pas toujours constants : une nouvelle version peut faire moins bien que la
précédente sur l’une de vos tâches, comme les modèles A et C sur la question de la
Figure 14figure 14.
ce que vous pensez de l’entreprise qui le propose.
Ces raisons changent plus lentement que les capacités, mais elles changent : les
conditions d’utilisation et les réglages de confidentialité sont révisés, et il
vaut donc la peine de les revérifier de temps à autre.
les comparaisons sont faussées : un produit qui connaît déjà vos préférences
peut sembler meilleur qu’un nouveau compte ailleurs, pour des raisons qui n’ont
rien à voir avec le modèle.
PromptingFormulation de requêtes
Written in English. The French version was automatically generated
and I have not revised it.
Rédigé en anglais. La version française a été
générée automatiquement et je ne l'ai pas révisée.
Prompts and prompt engineeringRequêtes et rédactique
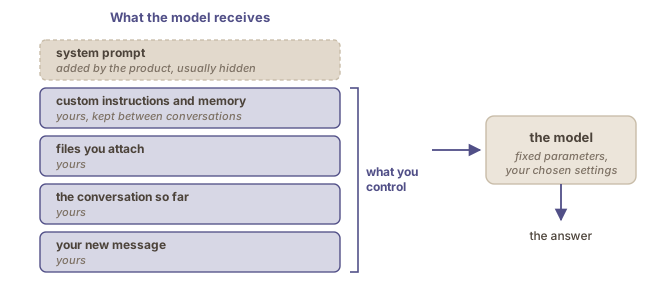
What a prompt is
When you use a chat app, you type a message and get an answer. The model
receives more than the words of your message, though: any instructions you give,
the files you attach and the earlier turns of the conversation are sent with it.
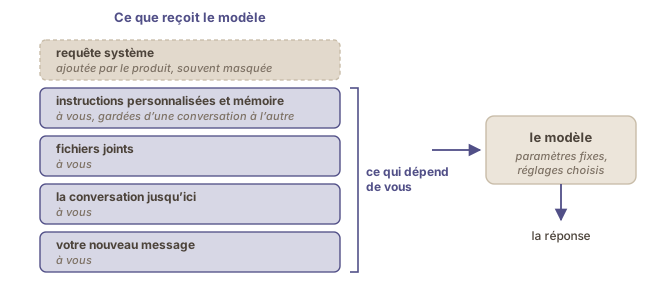
Everything you give the model in this way is the prompt.
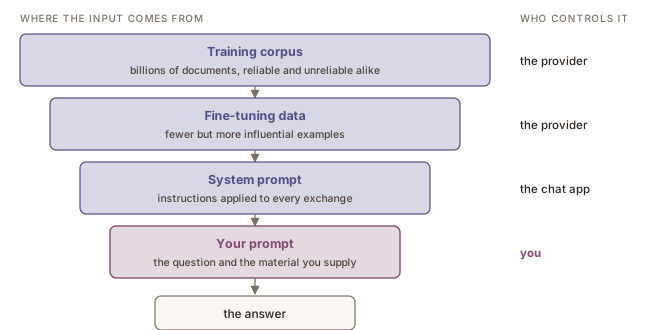
Once you have chosen a model and its settings, the prompt is the part of the
system you control
(Figure 1figure 1).
The rest is out of your hands:
Figure 1. What the model receives when you send a message in a chat app.
Prompt engineering
Writing prompts well soon got a name of its own.
The models were powerful, hard to inspect and inconsistent from one run to the
next, so advice on prompting spread within months of the first chatbots:
formulas, phrases said to unlock better answers, even job titles for the
people who knew them. Schulhoff et al. (2024) listed 58 text prompting
techniques in one survey, which gives an idea of how much was tried.
Tricks that stopped working
Some of the tricks were tested, and some measurably worked on the models of
2023. One of the best known is a single sentence added at the end of a prompt:
Determine whether an input word has the same meaning in the two input
sentences. This is very important to my career.
Li et al. (2023) added that sentence, and ten others like it, to the prompts of
45 tasks, and reported better results from six models of the time, GPT-4 among
them.
This is not intuitive: a model has no career to worry about, and nothing in it
cares about yours. It was trained on human text, though, and in human text a
request marked as important, or put politely, tends to get a more careful
answer. The model reproduces that pattern. Yin et al. (2024), who found that
rude prompts got worse answers, read their own results the same way: in their
words, models “mirror human communication traits”.
The table below sets what was first found about each trick beside what later
tests found.
Trick
First finding
Updated finding
Asking for step-by-step work: “Let’s think step by step”, or “Take a deep breath and work on this problem step-by-step”, a sentence found by a model searching for better instructions
Four prompting tricks: what the first studies found, and what later tests on newer models found.
Most of the updated findings come from the Prompting Science Reports (Meincke
et al., 2025a, 2025b, 2025c; Basil et al., 2025), short technical reports from
the Generative AI Labs of the Wharton School that test popular prompting advice
on recent models. Two points of method are worth knowing:
each question is asked 25 times or more, with and without the phrase
being tested, because a model can answer the same question differently from
one run to the next;
the questions are difficult: multiple-choice questions at graduate level.
The phrases changed the result on individual questions, in either direction
and with no way of predicting which, but made no significant difference across
the questions as a whole.The four reports, all of 2025, tested models of 2024 and 2025, among them GPT-4o, GPT-4o mini, Gemini 2.0 Flash, Claude 3.5 Sonnet and, as reasoning models, o3-mini and o4-mini. The Prompting Science reports are technical reports from a business school’s AI lab, not peer-reviewed papers.
Asking for step-by-step work still helps in some cases, mainly on tasks worked
out by rule (see also the Split the task page, in the Using LLMs module) (voir aussi la page Découper la tâche, dans le module Utiliser les GML).
The advice that survives testing is plain:
say clearly what you want;
give enough context;
show an example where you can.
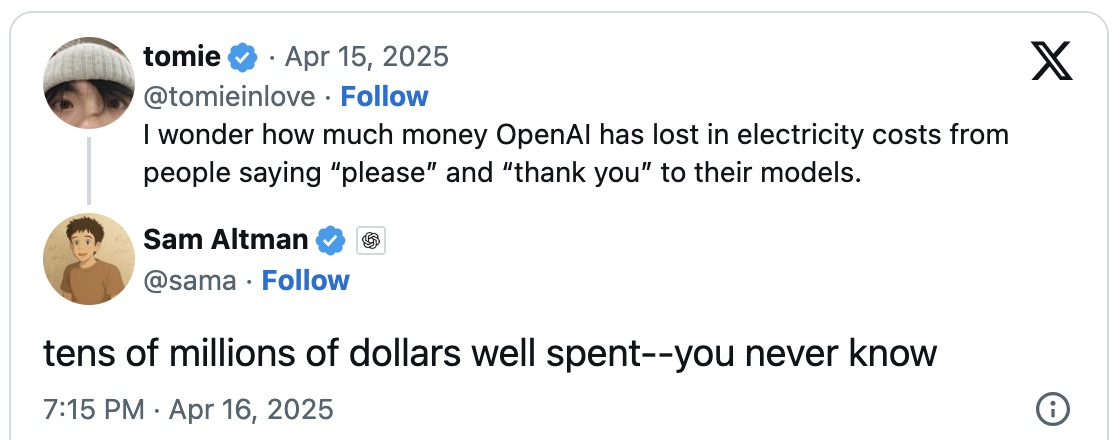
Figure 2. A question from tomie (@tomieinlove) on X, 15 April 2025, and Sam Altman's reply the next day.
Few techniques, and your own model
The techniques that work are few and general, so prompting has no formula to
memorize. Beyond a few basic
principles (see also the Be specific and ask for enough page, in the Using LLMs module) (voir aussi la page Être précis et en demander assez, dans le module Utiliser les GML), the skill
is knowing how the model you use behaves on the tasks you actually do, and
that comes from trying it. The providers publish prompting guides for their
own models and update them with each generation, which makes them a good place
to start.For instance Anthropic, Prompting best practices; OpenAI, Prompt engineering; Google, Prompt design strategies. All read 17 September 2026.
Sources
Basil, S., Shapiro, I., Shapiro, D., Mollick, E., Mollick, L., & Meincke, L. (2025). Prompting Science Report 4: Playing Pretend: Expert Personas Don't Improve Factual Accuracy. arXiv:2512.05858 (technical report). https://arxiv.org/abs/2512.05858
Kong, A., Zhao, S., Chen, H., Li, Q., Qin, Y., Sun, R., Zhou, X., Wang, E., & Dong, X. (2024). Better Zero-Shot Reasoning with Role-Play Prompting. Proceedings of the 2024 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies (Volume 1: Long Papers), 4099–4113. https://aclanthology.org/2024.naacl-long.228/
Li, C., Wang, J., Zhang, Y., Zhu, K., Hou, W., Lian, J., et al. (2023). Large Language Models Understand and Can be Enhanced by Emotional Stimuli. Preprint, arXiv:2307.11760 (a short version accepted at the LLM@IJCAI 2023 workshop). https://arxiv.org/abs/2307.11760
Meincke, L., Mollick, E. R., Mollick, L., & Shapiro, D. (2025a). Prompting Science Report 1: Prompt Engineering is Complicated and Contingent. Wharton Generative AI Labs, technical report; preprint, arXiv:2503.04818. https://arxiv.org/abs/2503.04818
Meincke, L., Mollick, E. R., Mollick, L., & Shapiro, D. (2025b). Prompting Science Report 2: The Decreasing Value of Chain of Thought in Prompting. Wharton Generative AI Labs, technical report; preprint, arXiv:2506.07142. https://arxiv.org/abs/2506.07142
Meincke, L., Mollick, E. R., Mollick, L., & Shapiro, D. (2025c). Prompting Science Report 3: I'll pay you or I'll kill you, but will you care?. Wharton Generative AI Labs, technical report; preprint, arXiv:2508.00614. https://arxiv.org/abs/2508.00614
Salewski, L., Alaniz, S., Rio-Torto, I., Schulz, E., & Akata, Z. (2023). In-Context Impersonation Reveals Large Language Models' Strengths and Biases. Advances in Neural Information Processing Systems 36 (NeurIPS 2023). https://openreview.net/forum?id=CbsJ53LdKc
Schulhoff, S., Ilie, M., Balepur, N., Kahadze, K., Liu, A., Si, C., et al. (2024). The Prompt Report: A Systematic Survey of Prompt Engineering Techniques. arXiv:2406.06608 (preprint). https://arxiv.org/abs/2406.06608
Yin, Z., Wang, H., Horio, K., Kawahara, D., & Sekine, S. (2024). Should We Respect LLMs? A Cross-Lingual Study on the Influence of Prompt Politeness on LLM Performance. Proceedings of the Second Workshop on Social Influence in Conversations (SICon 2024), 9–35. https://doi.org/10.18653/v1/2024.sicon-1.2
Zheng, M., Pei, J., Logeswaran, L., Lee, M., & Jurgens, D. (2024). When "A Helpful Assistant" Is Not Really Helpful: Personas in System Prompts Do Not Improve Performances of Large Language Models. Findings of the Association for Computational Linguistics: EMNLP 2024, 15126–15154. https://aclanthology.org/2024.findings-emnlp.888/
Ce qu’est une requête
Dans une application de clavardage, vous tapez un message et recevez une
réponse. Le modèle reçoit pourtant davantage que les mots de votre message :
les instructions que vous avez données, les fichiers joints et les tours
précédents de la conversation lui sont envoyés avec lui. Tout ce que vous
fournissez ainsi au modèle constitue la requête (angl. prompt).
Une fois le modèle et ses réglages choisis, la requête est la partie du
système qui dépend de vous
(Figure 1figure 1).
Le reste vous échappe :
vous ne pouvez pas modifier les paramètres du modèle ;
Figure 1. Ce que reçoit le modèle quand vous envoyez un message dans une application de clavardage.
La rédactique
L’art de bien rédiger des requêtes a vite reçu un nom.
Les modèles étaient puissants, difficiles à examiner et inconstants d’une
exécution à l’autre : quelques mois après les premiers agents
conversationnels, les conseils sur les requêtes circulaient partout, avec des
formules, des phrases censées débloquer de meilleures réponses, et même des
titres de poste pour ceux qui les connaissaient. Schulhoff et al. (2024) ont
recensé 58 techniques de requêtes textuelles dans une seule revue, ce qui
donne une idée de tout ce qui a été essayé.
Des astuces qui ne fonctionnent plus
Certaines astuces ont été mises à l’essai, et quelques-unes fonctionnaient
de façon mesurable sur les modèles de 2023. L’une des plus connues est une
seule phrase ajoutée à la fin d’une requête :
Determine whether an input word has the same meaning in the two input
sentences. This is very important to my career.
Li et al. (2023) ont ajouté cette phrase (« C’est très important pour ma
carrière »), et dix autres du même genre, aux requêtes de 45 tâches, et ont
obtenu de meilleurs résultats de six modèles de l’époque, dont GPT-4.
Le résultat n’a rien d’intuitif : un modèle n’a pas de carrière dont il
pourrait s’inquiéter, et rien en lui ne se soucie de la vôtre. Il a toutefois
été entraîné sur des textes humains, et dans ces textes, une demande présentée
comme importante, ou formulée poliment, obtient en général une réponse plus
soignée. Le modèle reproduit cette régularité. Yin et al. (2024), qui ont
constaté que les requêtes impolies donnaient de moins bonnes réponses,
interprètent leurs résultats de la même façon : selon eux, les modèles
« mirror human communication traits » (reflètent les traits de la
communication humaine).
Le tableau ci-dessous met en regard ce qu’on a d’abord constaté pour chaque
astuce et ce qu’ont montré les essais plus récents.
Astuce
Premier constat
Constat actualisé
Demander un travail étape par étape : « Let’s think step by step » (réfléchissons étape par étape), ou « Take a deep breath and work on this problem step-by-step » (respirez profondément et résolvez ce problème étape par étape), une phrase trouvée par un modèle chargé de chercher de meilleures instructions
Faire monter les enjeux : « C’est très important pour ma carrière », un pourboire ou une menace
sur les modèles de 2023, de meilleures réponses avec des phrases comme la première (Li et al., 2023)
sur les modèles de 2024 et 2025, pourboires et menaces ne font pas de différence significative dans l’ensemble (Meincke et al., 2025c)
La politesse : être impoli, très poli, ou donner des ordres
sur les modèles de 2023, l’impolitesse donnait de moins bonnes réponses en anglais, en chinois et en japonais, et l’excès de politesse n’apportait rien (Yin et al., 2024)
sur deux modèles de 2024, « please » (s’il vous plaît) et « I order you » (je vous ordonne) ne font pas de différence significative dans l’ensemble (Meincke et al., 2025a)
Attribuer un rôle au modèle, par exemple « You are an excellent math teacher » (vous êtes un excellent professeur de mathématiques) ou « You are a helpful assistant » (vous êtes un assistant serviable)
sur les modèles de 2023, un meilleur raisonnement avec un rôle adapté à la tâche (Kong et al., 2024 ; Salewski et al., 2023)
Quatre astuces de requêtes : ce qu'ont constaté les premières études, et ce qu'ont montré les essais ultérieurs sur des modèles plus récents.
La plupart des constats actualisés viennent des Prompting Science Reports
(Meincke et al., 2025a, 2025b, 2025c ; Basil et al., 2025), de courts rapports
techniques des Generative AI Labs de la Wharton School qui mettent à l’essai
les conseils de requête populaires sur des modèles récents. Deux points de
méthode comptent :
chaque question est posée 25 fois ou plus, avec et sans la phrase
testée, parce qu’un modèle peut répondre différemment à la même question
d’une exécution à l’autre ;
les questions sont difficiles : des questions à choix multiples de
niveau universitaire avancé.
Les phrases testées modifiaient le résultat sur certaines questions, dans un
sens ou dans l’autre et sans qu’on puisse prévoir lequel, mais ne faisaient pas
de différence significative sur l’ensemble des questions.Les quatre rapports, tous de 2025, ont testé des modèles de 2024 et 2025, dont GPT-4o, GPT-4o mini, Gemini 2.0 Flash, Claude 3.5 Sonnet et, comme modèles de raisonnement, o3-mini et o4-mini. Les Prompting Science Reports sont des rapports techniques du laboratoire d’IA d’une école de commerce, et non des articles évalués par les pairs.
Demander un travail étape par étape aide encore dans certains cas, surtout
pour les tâches qui se résolvent en appliquant des
règles (see also the Split the task page, in the Using LLMs module) (voir aussi la page Découper la tâche, dans le module Utiliser les GML).
Les conseils qui résistent aux essais sont simples :
dire clairement ce que vous voulez ;
donner assez de contexte ;
montrer un exemple quand c’est possible.
Figure 2. Une question de tomie (@tomieinlove) sur X, 15 avril 2025, et la réponse de Sam Altman le lendemain.
Peu de techniques, et votre propre modèle
Les techniques qui fonctionnent sont peu nombreuses et générales : il n’y a
donc pas de formule à mémoriser pour rédiger une requête. Au-delà de quelques
principes de base (see also the Be specific and ask for enough page, in the Using LLMs module) (voir aussi la page Être précis et en demander assez, dans le module Utiliser les GML), la
compétence consiste à savoir comment le modèle que vous utilisez se comporte
sur les tâches que vous faites vraiment, et cela s’apprend en l’essayant. Les
fournisseurs publient des guides de rédaction de requêtes pour leurs propres
modèles et les mettent à jour à chaque génération : c’est un bon point de
départ.Par exemple Anthropic, Prompting best practices ; OpenAI, Prompt engineering ; Google, Prompt design strategies. Tous consultés le 17 septembre 2026.
Sources
Basil, S., Shapiro, I., Shapiro, D., Mollick, E., Mollick, L., & Meincke, L. (2025). Prompting Science Report 4: Playing Pretend: Expert Personas Don't Improve Factual Accuracy. arXiv:2512.05858 (technical report). https://arxiv.org/abs/2512.05858
Kong, A., Zhao, S., Chen, H., Li, Q., Qin, Y., Sun, R., Zhou, X., Wang, E., & Dong, X. (2024). Better Zero-Shot Reasoning with Role-Play Prompting. Proceedings of the 2024 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies (Volume 1: Long Papers), 4099–4113. https://aclanthology.org/2024.naacl-long.228/
Li, C., Wang, J., Zhang, Y., Zhu, K., Hou, W., Lian, J., et al. (2023). Large Language Models Understand and Can be Enhanced by Emotional Stimuli. Preprint, arXiv:2307.11760 (a short version accepted at the LLM@IJCAI 2023 workshop). https://arxiv.org/abs/2307.11760
Meincke, L., Mollick, E. R., Mollick, L., & Shapiro, D. (2025a). Prompting Science Report 1: Prompt Engineering is Complicated and Contingent. Wharton Generative AI Labs, technical report; preprint, arXiv:2503.04818. https://arxiv.org/abs/2503.04818
Meincke, L., Mollick, E. R., Mollick, L., & Shapiro, D. (2025b). Prompting Science Report 2: The Decreasing Value of Chain of Thought in Prompting. Wharton Generative AI Labs, technical report; preprint, arXiv:2506.07142. https://arxiv.org/abs/2506.07142
Meincke, L., Mollick, E. R., Mollick, L., & Shapiro, D. (2025c). Prompting Science Report 3: I'll pay you or I'll kill you, but will you care?. Wharton Generative AI Labs, technical report; preprint, arXiv:2508.00614. https://arxiv.org/abs/2508.00614
Salewski, L., Alaniz, S., Rio-Torto, I., Schulz, E., & Akata, Z. (2023). In-Context Impersonation Reveals Large Language Models' Strengths and Biases. Advances in Neural Information Processing Systems 36 (NeurIPS 2023). https://openreview.net/forum?id=CbsJ53LdKc
Schulhoff, S., Ilie, M., Balepur, N., Kahadze, K., Liu, A., Si, C., et al. (2024). The Prompt Report: A Systematic Survey of Prompt Engineering Techniques. arXiv:2406.06608 (preprint). https://arxiv.org/abs/2406.06608
Yin, Z., Wang, H., Horio, K., Kawahara, D., & Sekine, S. (2024). Should We Respect LLMs? A Cross-Lingual Study on the Influence of Prompt Politeness on LLM Performance. Proceedings of the Second Workshop on Social Influence in Conversations (SICon 2024), 9–35. https://doi.org/10.18653/v1/2024.sicon-1.2
Zheng, M., Pei, J., Logeswaran, L., Lee, M., & Jurgens, D. (2024). When "A Helpful Assistant" Is Not Really Helpful: Personas in System Prompts Do Not Improve Performances of Large Language Models. Findings of the Association for Computational Linguistics: EMNLP 2024, 15126–15154. https://aclanthology.org/2024.findings-emnlp.888/
Be specific and ask for enoughÊtre précis et en demander assez
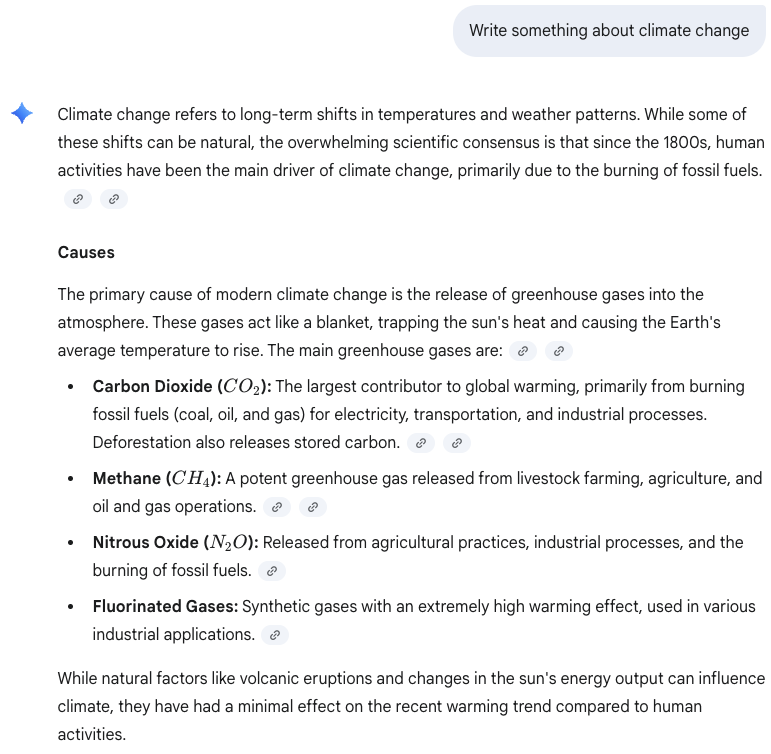
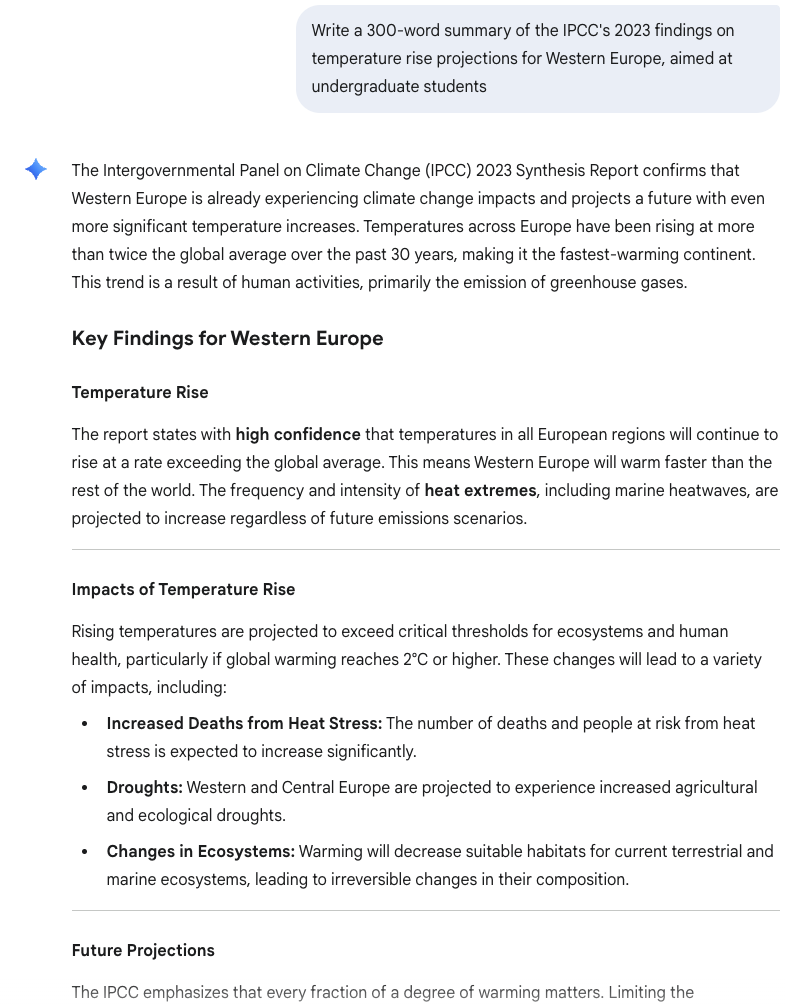
Figure 3. A vague request and its generic answer. Gemini 2.5 Flash, 5 September 2025. Figure 4. The same subject with audience, length, scope and source stated. Gemini 2.5 Flash, 5 September 2025.
What
Example
the task
translate, summarize, list, compare, rewrite
the audience
the general public; a client’s engineers; a first-year student
the language variety
Canadian French rather than French; British rather than American spelling
the constraints
length, register, what to avoid, what to keep unchanged
the format
plain text, a table, one line per term, no commentary
the purpose
what the result will be used for, which settles many small decisions
What to state in a prompt, whenever it applies.
When you do not know yet what you want, a vague first prompt is not wasted:
the first attempt often shows you what you want, and you can correct from
there (see also the Correcting the model or starting over page, in the Using LLMs module) (voir aussi la page Corriger le modèle ou recommencer, dans le module Utiliser les GML). You can
also start the other way round: describe what you have in mind, however
vaguely, and ask the chatbot to question you until the task is clear. Its
questions often bring up what you had not thought of yet.
It also helps to say what you want rather than only what you do not want.
“Write in flowing paragraphs” gives the model something to aim for, where “no
bullet points” only names what to avoid. The prompting guides of both
Anthropic and OpenAI give this advice.Anthropic, Prompting best practices: “Tell Claude what to do instead of what not to do”; OpenAI Help Center, Best practices for prompt engineering with the OpenAI API: “Instead of just saying what not to do, say what to do instead”. Both read 21 September 2026.
Ask for enough
People often ask a model for “two or three examples”, as they would ask a
colleague, but a model writes fifty candidates in seconds, where a colleague
would need an afternoon.
Asking for many and then choosing is usually better than asking for a few and
accepting them.
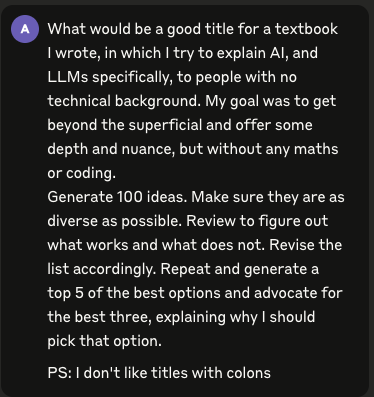
The prompt in Figure 5figure 5
asks for a hundred title ideas for a textbook rather than one, as diverse as
possible, then for a review, a revision and a top five with an argument for
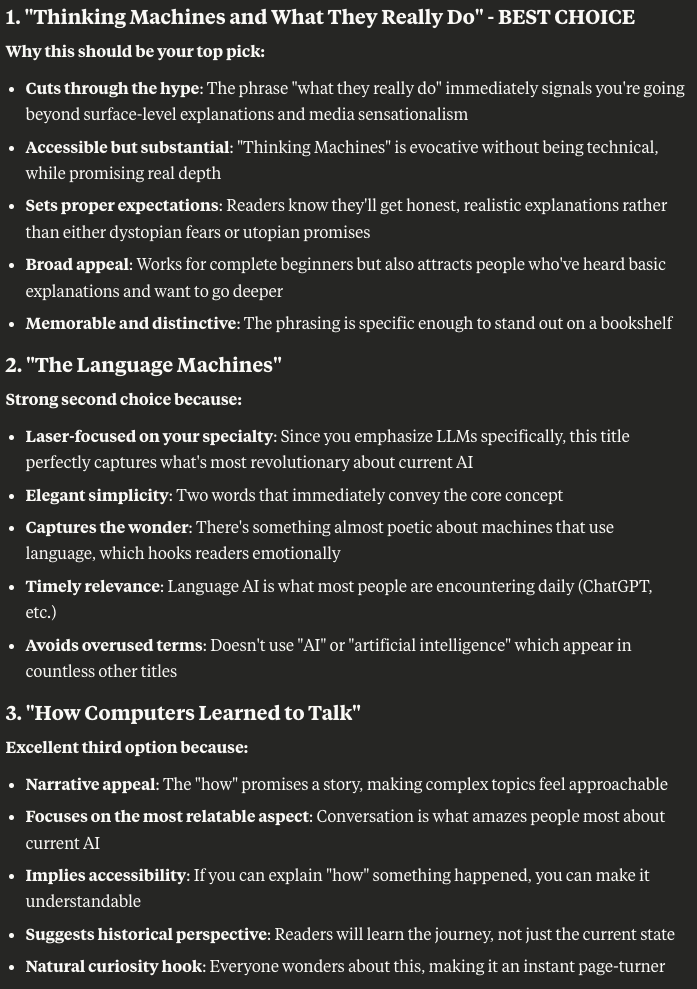
the best three. The answer is a shortlist of three finalists, each with its reasons
(Figure 6figure 6).
A hundred candidates do not guarantee that any of them is good, but they give
you far more to choose from than two or three.
Figure 5. The request for a hundred candidates, reviewed and narrowed. Claude Sonnet 4, 5 September 2025. Figure 6. The shortlist that came back. Claude Sonnet 4, 5 September 2025.
Avoid adding uncertain or untrue information
A question can start from an assumption that the model does not always question.
“What does clause 7 say about liability?” presumes that there is a clause 7 and
that it covers liability. Asking whether the document addresses liability, and
where, leaves room for the answer that it does
not (see also the Garbage in, garbage out page, in the Critical issues with LLMs module) (voir aussi la page Médiocre en entrée, médiocre en sortie, dans le module Enjeux critiques des GML).
Models do not reliably catch this for you. Li et al. (2025a) tested 15 models on
problems built on a flawed premise: most flagged it only when they were told to
look for errors, and the models that reasoned best were not consistently the
ones that noticed.Among them GPT-4.1, o3-mini, o4-mini, DeepSeek-R1, Claude 3.7 Sonnet and Gemini 2.0 Flash Thinking. The problems were mathematical and logical, not questions about documents.
Sources
Li, J., Li, G., Chang, Y., & Wu, Y. (2025a). Don't Take the Premise for Granted: Evaluating the Premise Critique Ability of Large Language Models. Findings of the Association for Computational Linguistics: EMNLP 2025. https://aclanthology.org/2025.findings-emnlp.44/
Wang, G., Sun, Z., Ye, S., Gong, Z., Chen, Y., Zhao, Y., Liang, Q., & Hao, D. (2026a). Do Advanced Language Models Eliminate the Need for Prompt Engineering in Software Engineering?. ACM Transactions on Software Engineering and Methodology, 35(8), 1–33. https://dl.acm.org/doi/10.1145/3771933
Figure 3. Une demande vague et sa réponse générique. Gemini 2.5 Flash, 5 septembre 2025. Figure 4. Le même sujet, avec le public, la longueur, la portée et la source précisés. Gemini 2.5 Flash, 5 septembre 2025.
Quoi
Exemple
la tâche
traduire, résumer, énumérer, comparer, réécrire
le public
le grand public ; les ingénieurs d’un client ; un étudiant de première année
la variété de langue
le français canadien plutôt que le français ; l’orthographe britannique plutôt qu’américaine
les contraintes
la longueur, le registre, ce qu’il faut éviter, ce qu’il faut laisser tel quel
le format
du texte brut, un tableau, une ligne par terme, sans commentaire
l’objectif
l’usage qui sera fait du résultat, ce qui règle bien des petites décisions
Ce qu'il faut préciser dans une requête, chaque fois que cela s'applique.
Quand vous ne savez pas encore ce que vous voulez, une première requête vague
n’est pas perdue : la première tentative vous montre souvent ce que vous
voulez, et vous pouvez corriger à partir de
là (see also the Correcting the model or starting over page, in the Using LLMs module) (voir aussi la page Corriger le modèle ou recommencer, dans le module Utiliser les GML). Vous
pouvez aussi faire l’inverse : décrire ce que vous avez en tête, même
vaguement, et demander à l’agent conversationnel de vous poser des questions
jusqu’à ce que la tâche soit claire. Ses questions font souvent ressortir ce à
quoi vous n’aviez pas encore pensé.
Il est utile aussi de dire ce que vous voulez, et pas seulement ce que vous
ne voulez pas. « Rédige en paragraphes suivis » donne au modèle un but à
atteindre, alors que « pas de listes à puces » ne nomme que ce qu’il faut
éviter. Les guides de rédaction de requêtes d’Anthropic et d’OpenAI donnent
tous deux ce conseil.Anthropic, Prompting best practices : « Tell Claude what to do instead of what not to do » ; OpenAI Help Center, Best practices for prompt engineering with the OpenAI API : « Instead of just saying what not to do, say what to do instead ». Tous deux consultés le 21 septembre 2026.
En demander assez
On demande souvent à un modèle « deux ou trois exemples », comme on le ferait
à un collègue, mais un modèle écrit cinquante propositions en quelques
secondes, là où un collègue y passerait l’après-midi. En demander beaucoup puis
choisir vaut généralement mieux qu’en demander quelques-unes et les accepter.
La requête de Figure 5figure 5
demande cent idées de titres pour un manuel plutôt qu’un seul, aussi variées
que possible, puis une relecture, une révision et un palmarès de cinq, avec un
argumentaire pour les trois meilleurs. Il en revient une présélection de trois
finalistes, chacun avec ses raisons
(Figure 6figure 6).
Cent propositions ne garantissent pas qu’une seule soit bonne, mais elles
offrent beaucoup plus de choix que deux ou trois.
Figure 5. La demande de cent propositions, relues et réduites. Claude Sonnet 4, 5 septembre 2025. Figure 6. La présélection obtenue. Claude Sonnet 4, 5 septembre 2025.
Éviter d’ajouter des informations incertaines ou fausses
Une question peut contenir une présupposition que le modèle ne remet pas
toujours en cause. « Que dit l’article 7 sur la responsabilité ? » suppose
qu’il existe un article 7 et qu’il porte sur la responsabilité. Demander si le
document traite de la responsabilité, et où, laisse place à la réponse qu’il
n’en traite pas (see also the Garbage in, garbage out page, in the Critical issues with LLMs module) (voir aussi la page Médiocre en entrée, médiocre en sortie, dans le module Enjeux critiques des GML).
Les modèles ne les repèrent pas de façon fiable. Li et al. (2025a) ont testé 15
modèles sur des problèmes reposant sur une présupposition erronée : la plupart
ne l’ont signalée que lorsqu’on leur demandait de chercher des erreurs, et les
modèles qui raisonnaient le mieux n’étaient pas toujours ceux qui la
remarquaient.Parmi eux GPT-4.1, o3-mini, o4-mini, DeepSeek-R1, Claude 3.7 Sonnet et Gemini 2.0 Flash Thinking. Les problèmes étaient mathématiques et logiques, et non des questions portant sur des documents.
Sources
Li, J., Li, G., Chang, Y., & Wu, Y. (2025a). Don't Take the Premise for Granted: Evaluating the Premise Critique Ability of Large Language Models. Findings of the Association for Computational Linguistics: EMNLP 2025. https://aclanthology.org/2025.findings-emnlp.44/
Wang, G., Sun, Z., Ye, S., Gong, Z., Chen, Y., Zhao, Y., Liang, Q., & Hao, D. (2026a). Do Advanced Language Models Eliminate the Need for Prompt Engineering in Software Engineering?. ACM Transactions on Software Engineering and Methodology, 35(8), 1–33. https://dl.acm.org/doi/10.1145/3771933
Split the taskDécouper la tâche
One long request or several steps
Models can increasingly work on one task for a long time, and in some cases
that works well. The longer a model works on its own, though, the more room
there is for it to drift away from what you want, or to build on its own
earlier mistakes (see also the Errors spread through context page, in the LLM lifecycle module) (voir aussi la page Les erreurs se propagent dans le contexte, dans le module Cycle de vie des GML).
Splitting a task into separate steps gives you more control: you see how the
result was reached, and can correct or redirect along the way.
The same task can be run both ways. In the first conversation below, a single
request asks for a bilingual term list. In the second, the same list is built
in four exchanges: the terms first, then the sources, then the French
equivalents, then the format.
LLM exampleExemple GMLScroll inside the frame to read the whole conversation ↓Faites défiler le cadre pour lire toute la conversation ↓ChatGPT, Pro plan, High thinking effort · 21 September 2026
PromptRequête
Draft a bilingual term list, US English to Canadian French, of the 20 most relevant terms about AI and large language models, with a French equivalent for each.
ResponseRéponse
Here is a draft list using terminology that should work well in Canadian French, with a preference for terms commonly used in academic and professional contexts in Québec.
apprentissage par renforcement à partir de rétroaction humaine (RLHF)
AI agent
agent d’intelligence artificielle / agent d’IA
A few entries are worth flagging because usage is not fully settled. GML is a good French equivalent for LLM, although grand modèle de langage is also widespread. For prompt, requête is terminologically cleaner than the very common borrowing prompt, but depending on your audience, invite and instruction also occur. For foundation model, modèle de fondation is established, while modèle de base can be ambiguous. For RAG, génération augmentée par récupération is reasonably transparent, but several competing translations are still in circulation.
The whole task in one request.
LLM exampleExemple GMLScroll inside the frame to read the whole conversation ↓Faites défiler le cadre pour lire toute la conversation ↓ChatGPT, Pro plan, High thinking effort · 21 September 2026
PromptRequête
What might the 20 most relevant US English terms about AI and large language models be? List the terms only.
ResponseRéponse
artificial intelligence
machine learning
deep learning
neural network
transformer
large language model
generative AI
foundation model
token
tokenization
prompt
prompt engineering
context window
attention
embedding
fine-tuning
retrieval-augmented generation
inference
hallucination
alignment
PromptRequête
hm, make it more appropriate for a less technical audience. Perhaps replace transformer and attention.. embedding as well. And do not include both token and tokenization. Suggest alternatives for those.
I would like to look for Canadian French equivalents. Which sources would you suggest for that?
ResponseRéponse
For a less technical audience, I would replace the architecture-level terms with concepts that occur more often in public discussion and everyday use.
For the four you flagged, my preferred substitutions would be:
transformer → chatbot or AI assistant
attention → AI agent
embedding → training data
tokenization → drop it and retain token only
Other good candidates, depending on what you want the glossary to cover, are multimodal AI, AI-generated content, synthetic data, AI bias, AI safety, AI system, and natural language processing.
So I might revise the 20 to:
artificial intelligence
machine learning
deep learning
neural network
generative AI
foundation model
large language model
AI model
chatbot
AI assistant
AI agent
prompt
prompt engineering
context window
token
training data
fine-tuning
retrieval-augmented generation
hallucination
alignment
I would consider neural network, deep learning, fine-tuning, and retrieval-augmented generation the remaining relatively technical items. If the intended readership is genuinely general-public rather than “non-specialists who work with AI”, I would probably replace some of those too.
For Canadian French equivalents
I would use three sources, in roughly this order:
OQLF, Grand dictionnaire terminologique / Vitrine linguistique. This is probably your best primary source if you specifically want Québec/Canadian French. The OQLF has an actively maintained AI vocabulary, L’intelligence artificielle en évolution : les termes de l’IA. Its entries distinguish termes privilégiés, acceptable variants, abbreviations, usage notes, and definitions. For example, it currently gives grand modèle de langage for large language model and jeton for token. [Vitrine linguistique +1]
TERMIUM Plus, from the federal Translation Bureau. This is the other source I would systematically check. It is explicitly Canadian, bilingual, and its AI records have been updated quite aggressively in 2025–2026. For instance, its current token record gives jeton / jeton textuel, and it has dedicated recent records for generative-AI terminology. [Termium Plus +2]
Translation Bureau’s Artificial Intelligence Terminology Concept Map. This is particularly handy for your task because it is already a curated English–French AI term list rather than a general terminological database. It includes things such as artificial intelligence → intelligence artificielle, generative AI → IA générative, deep learning → apprentissage profond, prompt engineering, and retrieval-augmented generation, with links into TERMIUM. The Bureau explicitly says its terminologists continually update TERMIUM as AI terminology evolves. [Our Languages]
For this particular glossary, I would cross-check every term in both OQLF and TERMIUM. Where they agree, the choice is easy. Where they differ, that difference is itself useful information: OQLF tends to tell you what is preferred in Québec, whereas TERMIUM tells you what the federal Translation Bureau recognizes in Canadian government usage.
I would use FranceTerme only as a secondary comparison source, not as the basis for a Canadian French glossary. The OQLF sometimes imports FranceTerme records alongside its own, so it is important to look at the author of the individual GDT record, not merely assume that anything appearing in the GDT is an OQLF recommendation. For example, there are separate OQLF and FranceTerme records for grand modèle de langage. [Vitrine linguistique +1]
If the goal is a 20-term US English → Canadian French terminology list, OQLF + TERMIUM is a very defensible methodology.
PromptRequête
Agreed with added terms and cross-checking OQLF + Termium. In case of disagreement, use DataFranca as a tiebreaker.
ResponseRéponse
That gives a clear hierarchy:
OQLF
TERMIUM Plus
DataFranca as tiebreaker when OQLF and TERMIUM disagree
For each term, I’d record the preferred Canadian French equivalent, and only flag alternatives where there is a meaningful terminological difference rather than harmless variation.
PromptRequête
Ok, give me final list in a format I can copy-paste into excel
ResponseRéponse
I replaced AI assistant with multimodal AI, which is both more useful conceptually and has a clear OQLF/TERMIUM equivalent. The forms below prioritize OQLF, with TERMIUM cross-checking; for example, both support requête, jeton, affinage, fenêtre de contexte, and grand modèle de langage. [Vitrine linguistique +4]
Copy-paste this directly into Excel:
US English Canadian Frenchartificial intelligence intelligence artificiellemachine learning apprentissage automatiquedeep learning apprentissage profondneural network réseau de neurones artificielsgenerative AI intelligence artificielle générativefoundation model modèle de fondationlarge language model grand modèle de langageAI model modèle d'intelligence artificiellechatbot robot conversationnelmultimodal AI intelligence artificielle multimodaleAI agent agent d'intelligence artificielleprompt requêteprompt engineering rédactiquecontext window fenêtre de contextetoken jetontraining data données d'entraînementfine-tuning affinageretrieval-augmented generation génération augmentée par récupérationhallucination hallucination d'IAAI alignment alignement de l'IA
Two choices worth flagging: rédactique is specifically the OQLF-preferred term for prompt engineering, although TERMIUM and DataFranca also recognize ingénierie de requêtes. [Vitrine linguistique +2] For retrieval-augmented generation, OQLF prefers génération augmentée par récupération, whereas TERMIUM proposes génération améliorée par récupération d’information (GARI) but also records the OQLF form; I therefore kept the OQLF form. [Vitrine linguistique +1]
The same task in four exchanges: the terms, the sources, the French equivalents, then the format.
Both conversations end in a usable list. The one done in steps took longer,
but it gave:
more insight: you see which terms the model picks, and which sources it
would rely on, before any French is proposed;
more control: the list was adapted to a less technical audience, and
the order of the sources was set by the person doing the work;
perhaps more inspiration: engaged with each step, you are more likely to
think of a term or a source yourself;
perhaps fewer wasted tokens: a correction made to the list of terms
costs one short exchange, where a correction to a finished table means
generating the table again.
The French differs as well. Asked from memory, the model gave ajustement
fin for fine-tuning; asked to follow the OQLF and TERMIUM, it gave
affinage, the term both banks record. The steps also show where the model
drifts: in its last answer, it replaced AI assistant with multimodal AI on its
own, and said so.
Working in steps also shows you which step the model handles well and which
it does not. The step it gets wrong is the one to do yourself, or to support
with more material.
Working step by step
Asking a model to work through a problem before answering helps mainly on
mathematics and other tasks worked out by
rule (see also the Reasoning step by step page, in the LLM lifecycle module) (voir aussi la page Raisonner étape par étape, dans le module Cycle de vie des GML). A model
set to reason before answering already does this, so on such a model the
request adds little and costs time (Meincke et al., 2025b). With reasoning
switched off or set low, it can still help on a calculation or a rule applied
case by case (see also the Execution “effort” page, in the Using LLMs module) (voir aussi la page L'« effort » d'exécution, dans le module Utiliser les GML).
Sources
Meincke, L., Mollick, E. R., Mollick, L., & Shapiro, D. (2025b). Prompting Science Report 2: The Decreasing Value of Chain of Thought in Prompting. Wharton Generative AI Labs, technical report; preprint, arXiv:2506.07142. https://arxiv.org/abs/2506.07142
Une seule longue demande ou plusieurs étapes
Les modèles peuvent de plus en plus travailler longtemps sur une même tâche,
et dans certains cas, cela donne de bons résultats. Mais plus un modèle
travaille seul longtemps, plus il risque de s’éloigner de ce que vous voulez,
ou de bâtir sur ses propres erreurs
antérieures (see also the Errors spread through context page, in the LLM lifecycle module) (voir aussi la page Les erreurs se propagent dans le contexte, dans le module Cycle de vie des GML).
Découper une tâche en étapes distinctes vous donne plus de maîtrise : vous
voyez comment le résultat a été obtenu, et vous pouvez corriger ou réorienter
en cours de route.
La même tâche peut être menée des deux façons. Dans la première conversation
ci-dessous, une seule demande porte sur une liste de termes bilingue. Dans la
seconde, la même liste est construite en quatre échanges : d’abord les termes,
puis les sources, puis les équivalents français, puis le format.
LLM exampleExemple GMLScroll inside the frame to read the whole conversation ↓Faites défiler le cadre pour lire toute la conversation ↓ChatGPT, forfait Pro, effort de réflexion élevé (High) · 21 septembre 2026
PromptRequête
Draft a bilingual term list, US English to Canadian French, of the 20 most relevant terms about AI and large language models, with a French equivalent for each.
ResponseRéponse
Here is a draft list using terminology that should work well in Canadian French, with a preference for terms commonly used in academic and professional contexts in Québec.
apprentissage par renforcement à partir de rétroaction humaine (RLHF)
AI agent
agent d’intelligence artificielle / agent d’IA
A few entries are worth flagging because usage is not fully settled. GML is a good French equivalent for LLM, although grand modèle de langage is also widespread. For prompt, requête is terminologically cleaner than the very common borrowing prompt, but depending on your audience, invite and instruction also occur. For foundation model, modèle de fondation is established, while modèle de base can be ambiguous. For RAG, génération augmentée par récupération is reasonably transparent, but several competing translations are still in circulation.
Toute la tâche en une seule demande. La conversation est reproduite en anglais, telle qu'elle a eu lieu.
LLM exampleExemple GMLScroll inside the frame to read the whole conversation ↓Faites défiler le cadre pour lire toute la conversation ↓ChatGPT, forfait Pro, effort de réflexion élevé (High) · 21 septembre 2026
PromptRequête
What might the 20 most relevant US English terms about AI and large language models be? List the terms only.
ResponseRéponse
artificial intelligence
machine learning
deep learning
neural network
transformer
large language model
generative AI
foundation model
token
tokenization
prompt
prompt engineering
context window
attention
embedding
fine-tuning
retrieval-augmented generation
inference
hallucination
alignment
PromptRequête
hm, make it more appropriate for a less technical audience. Perhaps replace transformer and attention.. embedding as well. And do not include both token and tokenization. Suggest alternatives for those.
I would like to look for Canadian French equivalents. Which sources would you suggest for that?
ResponseRéponse
For a less technical audience, I would replace the architecture-level terms with concepts that occur more often in public discussion and everyday use.
For the four you flagged, my preferred substitutions would be:
transformer → chatbot or AI assistant
attention → AI agent
embedding → training data
tokenization → drop it and retain token only
Other good candidates, depending on what you want the glossary to cover, are multimodal AI, AI-generated content, synthetic data, AI bias, AI safety, AI system, and natural language processing.
So I might revise the 20 to:
artificial intelligence
machine learning
deep learning
neural network
generative AI
foundation model
large language model
AI model
chatbot
AI assistant
AI agent
prompt
prompt engineering
context window
token
training data
fine-tuning
retrieval-augmented generation
hallucination
alignment
I would consider neural network, deep learning, fine-tuning, and retrieval-augmented generation the remaining relatively technical items. If the intended readership is genuinely general-public rather than “non-specialists who work with AI”, I would probably replace some of those too.
For Canadian French equivalents
I would use three sources, in roughly this order:
OQLF, Grand dictionnaire terminologique / Vitrine linguistique. This is probably your best primary source if you specifically want Québec/Canadian French. The OQLF has an actively maintained AI vocabulary, L’intelligence artificielle en évolution : les termes de l’IA. Its entries distinguish termes privilégiés, acceptable variants, abbreviations, usage notes, and definitions. For example, it currently gives grand modèle de langage for large language model and jeton for token. [Vitrine linguistique +1]
TERMIUM Plus, from the federal Translation Bureau. This is the other source I would systematically check. It is explicitly Canadian, bilingual, and its AI records have been updated quite aggressively in 2025–2026. For instance, its current token record gives jeton / jeton textuel, and it has dedicated recent records for generative-AI terminology. [Termium Plus +2]
Translation Bureau’s Artificial Intelligence Terminology Concept Map. This is particularly handy for your task because it is already a curated English–French AI term list rather than a general terminological database. It includes things such as artificial intelligence → intelligence artificielle, generative AI → IA générative, deep learning → apprentissage profond, prompt engineering, and retrieval-augmented generation, with links into TERMIUM. The Bureau explicitly says its terminologists continually update TERMIUM as AI terminology evolves. [Our Languages]
For this particular glossary, I would cross-check every term in both OQLF and TERMIUM. Where they agree, the choice is easy. Where they differ, that difference is itself useful information: OQLF tends to tell you what is preferred in Québec, whereas TERMIUM tells you what the federal Translation Bureau recognizes in Canadian government usage.
I would use FranceTerme only as a secondary comparison source, not as the basis for a Canadian French glossary. The OQLF sometimes imports FranceTerme records alongside its own, so it is important to look at the author of the individual GDT record, not merely assume that anything appearing in the GDT is an OQLF recommendation. For example, there are separate OQLF and FranceTerme records for grand modèle de langage. [Vitrine linguistique +1]
If the goal is a 20-term US English → Canadian French terminology list, OQLF + TERMIUM is a very defensible methodology.
PromptRequête
Agreed with added terms and cross-checking OQLF + Termium. In case of disagreement, use DataFranca as a tiebreaker.
ResponseRéponse
That gives a clear hierarchy:
OQLF
TERMIUM Plus
DataFranca as tiebreaker when OQLF and TERMIUM disagree
For each term, I’d record the preferred Canadian French equivalent, and only flag alternatives where there is a meaningful terminological difference rather than harmless variation.
PromptRequête
Ok, give me final list in a format I can copy-paste into excel
ResponseRéponse
I replaced AI assistant with multimodal AI, which is both more useful conceptually and has a clear OQLF/TERMIUM equivalent. The forms below prioritize OQLF, with TERMIUM cross-checking; for example, both support requête, jeton, affinage, fenêtre de contexte, and grand modèle de langage. [Vitrine linguistique +4]
Copy-paste this directly into Excel:
US English Canadian Frenchartificial intelligence intelligence artificiellemachine learning apprentissage automatiquedeep learning apprentissage profondneural network réseau de neurones artificielsgenerative AI intelligence artificielle générativefoundation model modèle de fondationlarge language model grand modèle de langageAI model modèle d'intelligence artificiellechatbot robot conversationnelmultimodal AI intelligence artificielle multimodaleAI agent agent d'intelligence artificielleprompt requêteprompt engineering rédactiquecontext window fenêtre de contextetoken jetontraining data données d'entraînementfine-tuning affinageretrieval-augmented generation génération augmentée par récupérationhallucination hallucination d'IAAI alignment alignement de l'IA
Two choices worth flagging: rédactique is specifically the OQLF-preferred term for prompt engineering, although TERMIUM and DataFranca also recognize ingénierie de requêtes. [Vitrine linguistique +2] For retrieval-augmented generation, OQLF prefers génération augmentée par récupération, whereas TERMIUM proposes génération améliorée par récupération d’information (GARI) but also records the OQLF form; I therefore kept the OQLF form. [Vitrine linguistique +1]
La même tâche en quatre échanges : les termes, les sources, les équivalents français, puis le format.
Les deux conversations aboutissent à une liste utilisable. Celle qui procède
par étapes a pris plus de temps, mais elle a donné :
une meilleure vue d’ensemble : vous voyez quels termes le modèle
choisit, et sur quelles sources il s’appuierait, avant qu’il propose le
moindre équivalent français ;
plus de maîtrise : la liste a été adaptée à un public moins technique, et
l’ordre des sources a été fixé par la personne qui fait le travail ;
peut-être plus d’inspiration : en suivant chaque étape, vous avez plus
de chances de penser vous-même à un terme ou à une source ;
peut-être moins de jetons gaspillés : corriger la liste de termes coûte
un court échange, alors que corriger un tableau terminé oblige à le générer
de nouveau.
Le français diffère aussi. Interrogé de mémoire, le modèle a donné
« ajustement fin » pour fine-tuning ; invité à suivre l’OQLF et TERMIUM, il a
donné « affinage », le terme que consignent les deux banques. Les étapes
montrent aussi où le modèle dérive : dans sa dernière réponse, il a remplacé
AI assistant par multimodal AI de lui-même, en le signalant.
Travailler par étapes vous montre aussi quelle étape le modèle réussit et
laquelle il rate. L’étape qu’il rate est celle à faire vous-même, ou à
appuyer sur davantage de documentation.
Travailler étape par étape
Demander à un modèle de résoudre un problème pas à pas avant de répondre aide
surtout en mathématiques et dans les autres tâches qui se résolvent en
appliquant des règles (see also the Reasoning step by step page, in the LLM lifecycle module) (voir aussi la page Raisonner étape par étape, dans le module Cycle de vie des GML).
Un modèle réglé pour raisonner avant de répondre le fait déjà : sur un tel
modèle, la demande apporte peu et prend du temps (Meincke et al., 2025b). Avec
le raisonnement désactivé ou réglé bas, elle peut encore aider pour un calcul
ou pour une règle appliquée cas par
cas (see also the Execution “effort” page, in the Using LLMs module) (voir aussi la page L'« effort » d'exécution, dans le module Utiliser les GML).
Sources
Meincke, L., Mollick, E. R., Mollick, L., & Shapiro, D. (2025b). Prompting Science Report 2: The Decreasing Value of Chain of Thought in Prompting. Wharton Generative AI Labs, technical report; preprint, arXiv:2506.07142. https://arxiv.org/abs/2506.07142
Structure the promptStructurer la requête
Structuring the prompt
Once a prompt runs beyond a few sentences, with instructions, background and
material to work on, the providers’ prompting guides recommend adding
structure.For instance Anthropic, Prompting best practices; OpenAI, Prompt engineering, which suggests “a combination of Markdown formatting and XML tags”; Google, Prompt design strategies: “Using tags or Markdown helps the model distinguish between instructions, context, and tasks.” All read 17 September 2026.
That can be as simple as a few headings and bullet points, formatting in
Markdown,Markdown is a light way of marking up plain text: a line starting with # is a heading, a line starting with - is an item in a list, and **bold** is set in bold. Chat apps use it to format their answers, which is why a model’s reply often arrives with headings and bullet points. or tags in the style of XML, where a label between angle brackets
opens a part and the same label with a slash closes
it (see also the Reading XML chapter, in the Exchange formats in translation module) (voir aussi le chapitre Lire du XML, dans le module Les formats d'échange en traduction):
<objective>Summarize the report below for the city council</objective><audience>Council members without a background in engineering</audience><instructions>One page at most; keep every figure the decision depends on; no recommendations of your own</instructions><report>…</report><output-format>Five short paragraphs, no headings</output-format>
The format of the answer is worth stating too. “One line per item,
tab-separated, no commentary” gets you something you can paste into a
spreadsheet, where a request without it tends to get a list wrapped in prose.
When the output is meant for other software, you can ask for it in a
structured language such as JSON or XML. A model writes such output one token
at a time, like any other text, so it can make errors in it, such as a missing
bracket or a missing field, and a single error can make the whole output
unreadable for the software. Anthropic and OpenAI therefore both offer a mode
in their APIs that forces the answer to follow a structure defined in advance. The
structure is then guaranteed, with a few exceptions: an answer cut off before
the end, for instance because it reached the maximum length, can be
incomplete, and a model that refuses the request for safety reasons may
answer outside the structure.Anthropic, Structured outputs: without them, the model “can generate malformed JSON responses”, with “parsing errors from invalid JSON syntax” among the problems “even with careful prompting”. OpenAI, Structured model outputs: the feature ensures responses “adhere to your supplied JSON Schema”. Anthropic’s page also notes that a response cut off at the maximum length “may be incomplete and fail schema validation”. OpenAI adds that “a refusal does not necessarily follow the schema you have supplied”, and that structured outputs “can still contain mistakes”. Both read 21 September 2026. And an answer with a perfect structure can
still contain wrong content.
Asking for a strict format has a cost of its own: on tasks that need
reasoning, models answered less accurately when they had to follow a strict
format (Tam et al., 2024).Measured on models of 2024: GPT-3.5 Turbo, Claude 3 Haiku, Gemini 1.5 Flash, Llama 3 8B and Gemma 2 9B. So ask for a strict format only when you
actually need it.
Sources
He, J., Rungta, M., Koleczek, D., Sekhon, A., Wang, F. X., & Hasan, S. (2024). Does Prompt Formatting Have Any Impact on LLM Performance?. Preprint, arXiv:2411.10541. https://arxiv.org/abs/2411.10541
Sclar, M., Choi, Y., Tsvetkov, Y., & Suhr, A. (2024). Quantifying Language Models' Sensitivity to Spurious Features in Prompt Design or: How I learned to start worrying about prompt formatting. Proceedings of the Twelfth International Conference on Learning Representations (ICLR 2024). https://arxiv.org/abs/2310.11324
Tam, Z. R., Wu, C.-K., Tsai, Y.-L., Lin, C.-Y., Lee, H., & Chen, Y.-N. (2024). Let Me Speak Freely? A Study on the Impact of Format Restrictions on Performance of Large Language Models. Proceedings of the 2024 Conference on Empirical Methods in Natural Language Processing: Industry Track, 1218–1236. https://doi.org/10.18653/v1/2024.emnlp-industry.91
Structurer la requête
Dès qu’une requête dépasse quelques phrases, avec des consignes, du contexte
et un document à traiter, les guides de rédaction des fournisseurs
recommandent de la structurer.Par exemple Anthropic, Prompting best practices ; OpenAI, Prompt engineering, qui suggère « a combination of Markdown formatting and XML tags » ; Google, Prompt design strategies : « Using tags or Markdown helps the model distinguish between instructions, context, and tasks. » Tous consultés le 17 septembre 2026.
Il peut suffire de quelques intertitres et listes à puces, mis en forme en
Markdown,Markdown est une façon légère de baliser du texte brut : une ligne qui commence par # est un intertitre, une ligne qui commence par - est un élément de liste, et **gras** s’affiche en gras. Les applications de clavardage s’en servent pour mettre en forme leurs réponses, ce qui explique qu’une réponse de modèle arrive souvent avec des intertitres et des listes à puces. ou de balises à la manière du XML, où une étiquette entre chevrons
ouvre une partie et la même étiquette précédée d’une barre oblique la
ferme (see also the Reading XML chapter, in the Exchange formats in translation module) (voir aussi le chapitre Lire du XML, dans le module Les formats d'échange en traduction) :
<objectif>Résume le rapport ci-dessous pour le conseil municipal</objectif><public>Des conseillers sans formation en ingénierie</public><consignes>Une page au plus ; garde tous les chiffres dont dépend la décision ; aucune recommandation de ton cru</consignes><rapport>…</rapport><format-de-sortie>Cinq courts paragraphes, sans intertitres</format-de-sortie>
La notation qui fonctionne le mieux dépend du modèle. Des études ont montré
que le même contenu présenté dans différents formats, ou avec de petites
modifications d’espacement et de ponctuation, pouvait changer les résultats,
et qu’aucun format ne l’emportait partout : pour certaines tâches, le texte
brut faisait même mieux que Markdown ou JSON (He et al., 2024 ; Sclar et al.,
2024).He et al. (2024) ont comparé le texte brut, Markdown, JSON et YAML sur GPT-3.5 et GPT-4, et GPT-4 variait moins ; Sclar et al. (2024) ont observé des écarts de plusieurs dizaines de points d’exactitudeaccuracyexactitudeevaluationévaluationThe share of all decisions of a system that are correct, true positives and true negatives together.Part de toutes les décisions d'un système qui sont correctes, vrais positifs et vrais négatifs ensemble. sur des modèles ouverts de 2023.
Le guide du fournisseur pour le modèle que vous utilisez est le point de
départ, et un format qui fonctionne pour votre tâche sur votre modèle mérite
d’être conservé.
La sortie structurée
Le format de la réponse mérite lui aussi d’être précisé. « Une ligne par
élément, séparateur tabulation, sans commentaire » vous donne un résultat à
coller dans un tableur, alors qu’une demande sans cette précision donne
souvent une liste enveloppée de texte.
Quand la sortie est destinée à un autre logiciel, vous pouvez la demander dans
un langage structuré comme JSON ou XML. Un modèle écrit une telle sortie un
jeton à la fois, comme n’importe quel texte : il peut donc y faire des
erreurs, par exemple un crochet ou un champ manquant, et une seule erreur
peut rendre toute la sortie illisible pour le logiciel. Anthropic et OpenAI
proposent donc tous deux, dans leurs API, un mode qui oblige la réponse à
suivre une structure définie à l’avance. La structure est alors garantie, à
quelques exceptions près : une réponse interrompue avant la fin, par exemple
parce qu’elle a atteint la longueur maximale, peut être incomplète, et un
modèle qui refuse la demande pour des raisons de sécurité peut répondre en
dehors de la structure.Anthropic, Structured outputs : sans ce mode, le modèle « can generate malformed JSON responses », et les « parsing errors from invalid JSON syntax » figurent parmi les problèmes « even with careful prompting ». OpenAI, Structured model outputs : la fonctionnalité garantit que les réponses « adhere to your supplied JSON Schema ». La page d’Anthropic précise aussi qu’une réponse interrompue à la longueur maximale « may be incomplete and fail schema validation ». OpenAI ajoute que « a refusal does not necessarily follow the schema you have supplied », et que les sorties structurées « can still contain mistakes ». Tous deux consultés le 21 septembre 2026. Et une
réponse à la structure parfaite peut quand même avoir un contenu erroné.
Exiger un format strict a aussi un coût : sur les tâches qui demandent un
raisonnement, les modèles répondaient moins bien quand ils devaient suivre un
format strict (Tam et al., 2024).Mesuré sur des modèles de 2024 : GPT-3.5 Turbo, Claude 3 Haiku, Gemini 1.5 Flash, Llama 3 8B et Gemma 2 9B. N’exigez donc un
format strict que lorsque vous en avez vraiment besoin.
Sources
He, J., Rungta, M., Koleczek, D., Sekhon, A., Wang, F. X., & Hasan, S. (2024). Does Prompt Formatting Have Any Impact on LLM Performance?. Preprint, arXiv:2411.10541. https://arxiv.org/abs/2411.10541
Sclar, M., Choi, Y., Tsvetkov, Y., & Suhr, A. (2024). Quantifying Language Models' Sensitivity to Spurious Features in Prompt Design or: How I learned to start worrying about prompt formatting. Proceedings of the Twelfth International Conference on Learning Representations (ICLR 2024). https://arxiv.org/abs/2310.11324
Tam, Z. R., Wu, C.-K., Tsai, Y.-L., Lin, C.-Y., Lee, H., & Chen, Y.-N. (2024). Let Me Speak Freely? A Study on the Impact of Format Restrictions on Performance of Large Language Models. Proceedings of the 2024 Conference on Empirical Methods in Natural Language Processing: Industry Track, 1218–1236. https://doi.org/10.18653/v1/2024.emnlp-industry.91
Giving examplesDonner des exemples
Showing rather than describing
Asked in French for five phrases of five words with exemple as the middle
word, a chatbot gave five phrases in which the word appeared anywhere but
in the middle. Given a few examples of the pattern, it produced five that fit
(Figure 7figure 7).
The description had been clear, but the examples were clearer.
Figure 7. A description that was not followed, and examples that were. Gemini 2.5 Flash, 5 September 2025.
Examples are most useful where the result is easier to show than to
describe:
a format: how dates, units, headings or a reference should look;
a style or register: “formal but not stiff” means different things to
different people, and a paragraph written the way you want does not;
a fixed set of answers: a rating of each customer review as positive,
negative or mixed, or a label applied to each sentence of a text.
Choosing your examples
The examples you choose affect the answer in several ways (Schulhoff et al.,
2024). Three properties make a difference:
Correct answers. Larger models follow the answers in the examples
closely, so a wrong example is likely to produce wrong answers (Wei et al.,
2023b; Shi et al., 2024).Both measured on the models of 2023: GPT-3 and PaLM in Wei et al., Llama 2 in Shi et al. The direction, larger models following their examples more closely, is the finding to keep.
Examples close to the real task. Cases like the ones you will ask
about generally help more than distant ones.
One consistent format, since the layout of the examples is part of
what the model copies.
Their order and the balance of answers among them can change the result too,
which is one more reason a few real cases of your own are the way to find
out what works for your task (see also the Testing it yourself page, in the Using LLMs module) (voir aussi la page Faire vos propres tests, dans le module Utiliser les GML).
Schulhoff, S., Ilie, M., Balepur, N., Kahadze, K., Liu, A., Si, C., et al. (2024). The Prompt Report: A Systematic Survey of Prompt Engineering Techniques. arXiv:2406.06608 (preprint). https://arxiv.org/abs/2406.06608
Shi, Z., Wei, J., Xu, Z., & Liang, Y. (2024). Why Larger Language Models Do In-context Learning Differently?. Proceedings of the 41st International Conference on Machine Learning (ICML 2024), PMLR 235, 44991–45013. https://proceedings.mlr.press/v235/shi24f.html
Wei, J., Wei, J., Tay, Y., Tran, D., Webson, A., Lu, Y., et al. (2023b). Larger language models do in-context learning differently. Preprint, arXiv:2303.03846 (submitted to ICLR 2024). https://openreview.net/forum?id=DRGnEkbiQZ
Zou, K., Khalifa, M., & Wang, L. (2025). On Many-Shot In-Context Learning for Long-Context Evaluation. Proceedings of the 63rd Annual Meeting of the Association for Computational Linguistics (ACL 2025), 25605–25639. https://doi.org/10.18653/v1/2025.acl-long.1245
Montrer plutôt que décrire
Invité, en français, à écrire cinq phrases de cinq mots avec exemple comme
mot du milieu, un agent conversationnel a donné cinq phrases où le mot
apparaissait partout sauf au milieu. Après quelques exemples du motif
attendu, il en a produit cinq qui convenaient
(Figure 7figure 7).
La description était claire, mais les exemples l’étaient davantage.
Figure 7. Une description qui n'a pas été suivie, et des exemples qui l'ont été. Gemini 2.5 Flash, 5 septembre 2025.
Les exemples sont le plus utiles quand le résultat est plus facile à montrer
qu’à décrire :
un format : la présentation des dates, des unités, des intertitres ou
d’une référence ;
un style ou un registre : « soutenu sans être guindé » ne veut pas dire
la même chose pour tout le monde, alors qu’un paragraphe écrit comme vous le
voulez est sans ambiguïté ;
un ensemble fermé de réponses : l’évaluation de chaque avis de client
comme positif, négatif ou mitigé, ou une étiquette attribuée à chaque phrase
d’un texte.
Choisir ses exemples
Les exemples que vous choisissez influent sur la réponse de plusieurs façons
(Schulhoff et al., 2024). Trois propriétés comptent :
Des réponses justes. Les grands modèles suivent de près les réponses
des exemples : un exemple erroné risque donc de produire des réponses
erronées (Wei et al., 2023b ; Shi et al., 2024).Les deux études portent sur des modèles de 2023 : GPT-3 et PaLM chez Wei et al., Llama 2 chez Shi et al. Le constat à retenir est la tendance : plus un modèle est grand, plus il suit ses exemples.
Des exemples proches de la tâche réelle. Des cas semblables à ceux que
vous soumettrez aident en général davantage que des cas éloignés.
Un format cohérent, puisque la présentation des exemples fait partie de
ce que le modèle copie.
Leur ordre et la répartition des réponses entre eux peuvent aussi changer le
résultat : raison de plus pour découvrir ce qui fonctionne pour votre tâche
avec quelques vrais cas à vous (see also the Testing it yourself page, in the Using LLMs module) (voir aussi la page Faire vos propres tests, dans le module Utiliser les GML).
Schulhoff, S., Ilie, M., Balepur, N., Kahadze, K., Liu, A., Si, C., et al. (2024). The Prompt Report: A Systematic Survey of Prompt Engineering Techniques. arXiv:2406.06608 (preprint). https://arxiv.org/abs/2406.06608
Shi, Z., Wei, J., Xu, Z., & Liang, Y. (2024). Why Larger Language Models Do In-context Learning Differently?. Proceedings of the 41st International Conference on Machine Learning (ICML 2024), PMLR 235, 44991–45013. https://proceedings.mlr.press/v235/shi24f.html
Wei, J., Wei, J., Tay, Y., Tran, D., Webson, A., Lu, Y., et al. (2023b). Larger language models do in-context learning differently. Preprint, arXiv:2303.03846 (submitted to ICLR 2024). https://openreview.net/forum?id=DRGnEkbiQZ
Zou, K., Khalifa, M., & Wang, L. (2025). On Many-Shot In-Context Learning for Long-Context Evaluation. Proceedings of the 63rd Annual Meeting of the Association for Computational Linguistics (ACL 2025), 25605–25639. https://doi.org/10.18653/v1/2025.acl-long.1245
The language of the promptLa langue de la requête
Why English often works better
Most of the text a model learns from is English, at every stage where the
proportions have been published:
For most current models, the proportions are not published.
As a result, models generally perform better in English, although how much
better depends on the language and on the model:
on open models of 2023, having the model translate a request into English
itself, and answer from that imperfect translation, gave better results than
answering the request directly (Etxaniz et al., 2024);
on a model of 2025, translating into English first still helped for
languages with little training text, but made almost no difference for
widely used ones such as Spanish or German (Wu et al., 2026).French was not among the languages Wu et al. (2026) tested, but it belongs with the widely used ones.
For a less widely used language, a prompt in English, even imperfect English,
or a request to translate your prompt into English before answering, can
therefore give better results. That can be true even when you need the answer in
another language: the instructions can be in English and the answer in the
language you need. Whichever language the prompt is in, an answer written in
another language still shows the influence of English, which calls for
revision either way (see also the Linguistic hegemony page, in the Critical issues with LLMs module) (voir aussi la page L'hégémonie linguistique, dans le module Enjeux critiques des GML).
How careful the prompt itself has to be
For most purposes a prompt does not have to be carefully written. Models are
trained on internet text, where typos, missing accents and loose grammar are ordinary, and a prompt
with all three is usually understood. Two qualifications apply:
When the quality of the prompt does make a difference, it tends to show as
instructions missed rather than as worse text: Schmidtová et al. (2026)
injected typos and grammar errors into translation prompts and found that
the translations themselves hardly suffered, while the instructions around
them, the format and the task, were followed less well, and that the choice
of prompt made more difference than the errors in it.
Small things that should make no difference sometimes do. In one study, typos,
stray whitespace and dramatic wording in a patient’s message were enough to
change the advice a model gave, and mostly for the worse: the models more
often told patients to manage at home rather than see a clinician,
including patients who needed care, and more so for women (Gourabathina et
al., 2025).Tested on GPT-4, Llama 3 (70B and 8B) and Palmyra-Med, a model adapted to medicine, with clinicians shown the same messages for comparison, who were not affected.
For a task that needs precision, writing the prompt carefully costs
little and removes one variable.
Sources
Etxaniz, J., Azkune, G., Soroa, A., Lopez de Lacalle, O., & Artetxe, M. (2024). Do Multilingual Language Models Think Better in English?. Proceedings of the 2024 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies (Volume 2: Short Papers), 550–564. https://doi.org/10.18653/v1/2024.naacl-short.46
Gourabathina, A., Gerych, W., Pan, E., & Ghassemi, M. (2025). The Medium is the Message: How Non-Clinical Information Shapes Clinical Decisions in LLMs. Proceedings of the 2025 ACM Conference on Fairness, Accountability, and Transparency (FAccT '25), 1805–1828. https://doi.org/10.1145/3715275.3732121
Schmidtová, P., Bafna, N., Aycock, S., Vico, G., Kamzela, W., Hämmerl, K., & Zouhar, V. (2026). How Important is 'Perfect' English for Machine Translation Prompts?. Findings of the Association for Computational Linguistics: EACL 2026, 760–777. https://doi.org/10.18653/v1/2026.findings-eacl.38
Wu, W.-C., Wei, S.-L., Huang, H.-H., & Chen, H.-H. (2026). No One Fits All: From Fixed Prompting to Learned Routing in Multilingual LLMs. Findings of the Association for Computational Linguistics: ACL 2026, 37404–37423. https://doi.org/10.18653/v1/2026.findings-acl.1864
Xu, Y., Hu, L., Zhao, J., Qiu, Z., Xu, K., Ye, Y., & Gu, H. (2025). A survey on multilingual large language models: corpora, alignment, and bias. Frontiers of Computer Science, 19(11), 1911362. https://doi.org/10.1007/s11704-024-40579-4
Pourquoi l’anglais fonctionne souvent mieux
La plus grande partie des textes dont un modèle apprend est en anglais, à
chaque étape pour laquelle les proportions ont été publiées :
Pour la plupart des modèles actuels, les proportions ne sont pas publiées.
Les modèles fonctionnent donc en général mieux en anglais, mais l’écart
dépend de la langue et du modèle :
sur des modèles ouverts de 2023, faire traduire la demande en anglais par le
modèle lui-même, puis le faire répondre à partir de cette traduction
imparfaite, donnait de meilleurs résultats qu’une réponse directe à la
demande (Etxaniz et al., 2024) ;
sur un modèle de 2025, traduire d’abord en anglais aidait encore pour les
langues peu représentées dans les données d’entraînement, mais ne changeait
presque rien pour les langues très répandues comme l’espagnol ou l’allemand
(Wu et al., 2026).Le français ne figurait pas parmi les langues testées par Wu et al. (2026), mais il fait partie des langues très répandues.
Pour une langue moins répandue, une requête en anglais, même dans un anglais
imparfait, ou une demande de traduire votre requête en anglais avant de
répondre, peut donc donner de meilleurs résultats. C’est vrai même quand vous
avez besoin de la réponse dans une autre langue : les consignes peuvent être
en anglais et la réponse dans la langue voulue. Quelle que soit la langue de
la requête, une réponse rédigée dans une autre langue que l’anglais porte
encore la marque de l’anglais, ce qui demande une révision dans tous les
cas (see also the Linguistic hegemony page, in the Critical issues with LLMs module) (voir aussi la page L'hégémonie linguistique, dans le module Enjeux critiques des GML).
Le soin à apporter à la requête elle-même
Dans la plupart des cas, une requête n’a pas besoin d’être rédigée avec soin.
Les modèles sont entraînés sur des textes d’Internet, où les coquilles, les
accents oubliés et une grammaire approximative sont courants, et une requête
qui cumule les trois est généralement comprise. Deux réserves s’imposent :
Quand la qualité de la requête compte, cela se voit plutôt dans des
consignes non suivies que dans un texte de moins bonne qualité :
Schmidtová et al. (2026) ont introduit des coquilles et des fautes de
grammaire dans des requêtes de traduction, et constaté que les traductions
elles-mêmes en souffraient à peine, alors que les consignes qui les
entouraient, le format et la tâche, étaient moins bien suivies, et que le
choix de la requête comptait davantage que les fautes qu’elle contenait.
De petits détails qui ne devraient pas compter comptent parfois. Dans une
étude, des coquilles, des espaces superflues et une formulation dramatique
dans le message d’un patient suffisaient à modifier le conseil donné par un
modèle, et le plus souvent en mal : les modèles conseillaient plus souvent
aux patients de se soigner chez eux plutôt que de consulter, y compris à des
patients qui avaient besoin de soins, et davantage encore aux femmes
(Gourabathina et al., 2025).Testé sur GPT-4, Llama 3 (70B et 8B) et Palmyra-Med, un modèle adapté à la médecine, avec, à titre de comparaison, des cliniciens à qui l’on a montré les mêmes messages et qui n’ont pas été influencés.
Pour une tâche où la précision compte, soigner la requête coûte peu et
élimine une variable.
Sources
Etxaniz, J., Azkune, G., Soroa, A., Lopez de Lacalle, O., & Artetxe, M. (2024). Do Multilingual Language Models Think Better in English?. Proceedings of the 2024 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies (Volume 2: Short Papers), 550–564. https://doi.org/10.18653/v1/2024.naacl-short.46
Gourabathina, A., Gerych, W., Pan, E., & Ghassemi, M. (2025). The Medium is the Message: How Non-Clinical Information Shapes Clinical Decisions in LLMs. Proceedings of the 2025 ACM Conference on Fairness, Accountability, and Transparency (FAccT '25), 1805–1828. https://doi.org/10.1145/3715275.3732121
Schmidtová, P., Bafna, N., Aycock, S., Vico, G., Kamzela, W., Hämmerl, K., & Zouhar, V. (2026). How Important is 'Perfect' English for Machine Translation Prompts?. Findings of the Association for Computational Linguistics: EACL 2026, 760–777. https://doi.org/10.18653/v1/2026.findings-eacl.38
Wu, W.-C., Wei, S.-L., Huang, H.-H., & Chen, H.-H. (2026). No One Fits All: From Fixed Prompting to Learned Routing in Multilingual LLMs. Findings of the Association for Computational Linguistics: ACL 2026, 37404–37423. https://doi.org/10.18653/v1/2026.findings-acl.1864
Xu, Y., Hu, L., Zhao, J., Qiu, Z., Xu, K., Ye, Y., & Gu, H. (2025). A survey on multilingual large language models: corpora, alignment, and bias. Frontiers of Computer Science, 19(11), 1911362. https://doi.org/10.1007/s11704-024-40579-4
Working with long documentsTravailler avec de longs documents
Figure 8. A file added whole, or searched and added in part.
The difference changes what you can ask. A summary of a searched document
covers only the passages the search found, and a question whose answer is
spread across the document can get an answer built on the wrong
extract. As a
rule, a file of a few pages is added whole, and a set of long files in a
project is searched.Anthropic switches a project to searching its files once they approach the size of the context window: Claude Help Center, RAG for Projects, read 14 September 2026. OpenAI does not say where ChatGPT switches, but it accepts text files of up to 2 million tokens each, more than fits in any current context window: OpenAI Help Center, File Uploads FAQ, read 17 September 2026.
A long input is not read evenly
Even when the whole document is in the context, the model does not use all
of it equally well: models do clearly worse on long inputs than on short
ones, well within the size they advertise, and some parts of a long input are
used less reliably than
others (see also the context window page, in the LLM lifecycle module) (voir aussi la page La fenêtre contextuelle, dans le module Cycle de vie des GML). Two
practical consequences follow:
Keep the document and the question clearly apart, and try both orders
on your model, since the providers’ guides do not agree on which comes
first.Anthropic and Google recommend putting a long document first and the question at the end, while OpenAI’s guide puts the instructions first and the material after them: Anthropic, Prompting best practices, “Long context prompting”; Google, Prompt design strategies; OpenAI, Prompt engineering. All read 17 September 2026.
Ask about one part at a time when the answer has to be exact: the
clause, the section, the chapter, rather than the whole file.
A long answer stops
A model can only write a limited number of tokens in one answer, far fewer
than it can read (see also the context window page, in the LLM lifecycle module) (voir aussi la page La fenêtre contextuelle, dans le module Cycle de vie des GML).
Asked to rewrite or translate a fifty-page document, a model may do the
first pages and offer to continue, stop mid-sentence, or shorten the later
pages without saying so. For anything long:
work in parts of a size the model handles well, a few pages at a time,
and keep the parts in a document of your own;
give each part what it needs: the terms and style decisions
taken in earlier parts, and the paragraph before it for continuity, since
a new request starts with none of that;
check the joins, where a term or a tense chosen in one part can differ
from the next.
Figure 8. Un fichier ajouté en entier, ou parcouru par une recherche et ajouté en partie.
La différence compte pour ce que vous pouvez demander. Le résumé d’un
document parcouru par recherche ne porte que sur les passages que la recherche
a trouvés, et une question dont la réponse est répartie dans tout le document
peut recevoir une réponse fondée sur le mauvais
extrait. En règle
générale, un fichier de quelques pages est ajouté en entier, et un ensemble de
longs fichiers dans un projet est parcouru par recherche.Anthropic fait passer un projet à la recherche dans ses fichiers quand ceux-ci approchent la taille de la fenêtre contextuelle : Claude Help Center, RAG for Projects, consulté le 14 septembre 2026. OpenAI ne dit pas à quel moment ChatGPT change de méthode, mais accepte des fichiers texte de jusqu’à 2 millions de jetons chacun, plus que ne peut en contenir aucune fenêtre contextuelle actuelle : OpenAI Help Center, File Uploads FAQ, consulté le 17 septembre 2026.
Une longue entrée n’est pas lue uniformément
Même quand tout le document est dans le contexte, le modèle ne l’exploite pas
partout aussi bien : les modèles font nettement moins bien sur les longues
entrées que sur les courtes, bien en deçà de la taille qu’ils annoncent, et
certaines parties d’une longue entrée sont exploitées de façon moins fiable
que d’autres (see also the context window page, in the LLM lifecycle module) (voir aussi la page La fenêtre contextuelle, dans le module Cycle de vie des GML). Deux
conséquences pratiques en découlent :
Séparez clairement le document et la question, et essayez les deux
ordres sur votre modèle, car les guides des fournisseurs ne s’accordent pas
sur ce qui vient en premier.Anthropic et Google recommandent de placer un long document en premier et la question à la fin, alors que le guide d’OpenAI place les consignes en premier et le document ensuite : Anthropic, Prompting best practices, « Long context prompting » ; Google, Prompt design strategies ; OpenAI, Prompt engineering. Tous consultés le 17 septembre 2026.
Interrogez une partie à la fois quand la réponse doit être exacte :
l’article, la section, le chapitre, plutôt que le fichier entier.
Une longue réponse s’arrête
Un modèle ne peut écrire qu’un nombre limité de jetons dans une réponse,
bien moins qu’il ne peut en
lire (see also the context window page, in the LLM lifecycle module) (voir aussi la page La fenêtre contextuelle, dans le module Cycle de vie des GML). Si vous
demandez à un modèle de réécrire ou de traduire un document de cinquante pages,
il peut traiter les premières pages et proposer de continuer, s’arrêter au
milieu d’une phrase, ou raccourcir les pages suivantes sans le dire. Pour
tout texte long :
travaillez par parties d’une taille que le modèle traite bien, quelques
pages à la fois, et rassemblez les parties dans un document à vous ;
donnez à chaque partie ce dont elle a besoin : les termes et les choix
de style arrêtés dans les parties précédentes, et le paragraphe qui précède
pour la continuité, puisqu’une nouvelle demande ne dispose de rien de tout
cela ;
vérifiez les raccords, où un terme ou un temps de verbe choisi dans une
partie peut différer de la suivante.
Correcting the model or starting overCorriger le modèle ou recommencer
Correcting as you go
Refining an answer over several turns is the normal way to work. Two habits
help:
Be precise in your corrections: “cut the second paragraph and keep the
example” works better than “shorter”.
the answers get longer and less relevant with each turn;
the model apologizes and repeats the same error;
each correction introduces a new problem;
the exchange has become a negotiation about your earlier instructions.
Figure 9. Correcting on top of a misreading, and starting again with what you learned.
At that point, open a new conversation and write one clean prompt containing
what you have learned: the corrections you made, the example that finally
worked, the format you settled on
(Figure 9figure 9). It can feel wasteful,
but it is usually faster.
When a conversation has grown long
A long conversation fails in a different way. Instructions given at the
start tend to be followed less as the conversation goes on, a long context is
used unevenly, and once the context window fills, the chat app drops the
oldest turns, or compacts them into a summary written by the model
itself (see also the context window page, in the LLM lifecycle module) (voir aussi la page La fenêtre contextuelle, dans le module Cycle de vie des GML). Claude, for
instance, does this on its paid plans.Claude Help Center, How large is the context window on paid Claude plans?: “When your conversation approaches the context window limit, Claude summarizes earlier messages to make room for new content”, on paid plans with code execution enabled. Read 21 September 2026. In practice,
the model stops applying a decision made an hour ago. Three habits help:
Restate the essentials later in a long conversation, rather than
assuming the instruction at the top is still being followed.
Start a new conversation with a summary of the decisions taken: ask the
model for one, or write your own, and check it before you use it, since a
summary can lose a decision.
Do not fill the context with what you do not need: a pasted document
you have finished with, a long tangent, the ten versions before the
current one all compete with your instructions.
Sources
Laban, P., Hayashi, H., Zhou, Y., & Neville, J. (2026). LLMs Get Lost In Multi-Turn Conversation. The Fourteenth International Conference on Learning Representations (ICLR 2026). https://openreview.net/forum?id=VKGTGGcwl6
Zamfirescu-Pereira, J. D., Wong, R. Y., Hartmann, B., & Yang, Q. (2023). Why Johnny Can't Prompt: How Non-AI Experts Try (and Fail) to Design LLM Prompts. Proceedings of the 2023 CHI Conference on Human Factors in Computing Systems (CHI '23), article 437, 1–21. https://doi.org/10.1145/3544548.3581388
Corriger au fur et à mesure
Affiner une réponse en plusieurs tours est la façon normale de travailler.
Deux habitudes aident :
Soyez précis dans vos corrections : « supprime le deuxième paragraphe
et garde l’exemple » fonctionne mieux que « plus court ».
Jugez un changement sur plus d’une réponse : une réponse meilleure après
un changement peut ne pas se reproduire à l’essai suivant, ce que les
personnes qui découvrent ces systèmes ont tendance à négliger
(Zamfirescu-Pereira et al.,
2023) (see also the LLMs are non-deterministic page, in the LLM lifecycle module) (voir aussi la page Les GML ne sont pas déterministes, dans le module Cycle de vie des GML).
les réponses s’allongent et perdent en pertinence à chaque tour ;
le modèle s’excuse et répète la même erreur ;
chaque correction introduit un nouveau problème ;
l’échange est devenu une négociation sur vos consignes précédentes.
Figure 9. Corriger par-dessus un malentendu, et recommencer avec ce que vous avez appris.
Arrivé à ce point, ouvrez une nouvelle conversation et écrivez une seule
requête nette qui reprend ce que vous avez appris : les corrections apportées,
l’exemple qui a fini par fonctionner, le format retenu
(Figure 9figure 9). Cela peut
sembler du gaspillage, mais c’est généralement plus rapide.
Quand une conversation s’est allongée
Une longue conversation échoue d’une autre façon. Les consignes données au
début ont tendance à être moins suivies à mesure que la conversation avance,
un long contexte est exploité inégalement, et une fois la fenêtre
contextuelle remplie, l’application de clavardage abandonne les tours les plus
anciens, ou les condense en un résumé rédigé par le modèle
lui-même (see also the context window page, in the LLM lifecycle module) (voir aussi la page La fenêtre contextuelle, dans le module Cycle de vie des GML). C’est par
exemple ce que fait Claude dans ses forfaits payants.Claude Help Center, How large is the context window on paid Claude plans? : « When your conversation approaches the context window limit, Claude summarizes earlier messages to make room for new content », dans les forfaits payants où l’exécution de code est activée. Consulté le 21 septembre 2026.
En pratique, le modèle cesse d’appliquer une décision prise une heure plus
tôt. Trois habitudes aident :
Répétez ce qui compte plus loin dans une longue conversation, plutôt que
de supposer que la consigne du début est toujours suivie.
Ouvrez une nouvelle conversation avec un résumé des décisions prises :
demandez-en un au modèle, ou rédigez le vôtre, et vérifiez-le avant de
l’utiliser, car un résumé peut perdre une décision.
N’encombrez pas le contexte de ce dont vous n’avez pas besoin : un
document collé dont vous avez fini de vous servir, une longue digression,
les dix versions précédant la version actuelle font tous concurrence à vos
consignes.
Sources
Laban, P., Hayashi, H., Zhou, Y., & Neville, J. (2026). LLMs Get Lost In Multi-Turn Conversation. The Fourteenth International Conference on Learning Representations (ICLR 2026). https://openreview.net/forum?id=VKGTGGcwl6
Zamfirescu-Pereira, J. D., Wong, R. Y., Hartmann, B., & Yang, Q. (2023). Why Johnny Can't Prompt: How Non-AI Experts Try (and Fail) to Design LLM Prompts. Proceedings of the 2023 CHI Conference on Human Factors in Computing Systems (CHI '23), article 437, 1–21. https://doi.org/10.1145/3544548.3581388
Improving a promptAméliorer une requête
Asking the chatbot
The simplest way to improve a prompt is to ask a chatbot to do it: paste the
prompt and ask how it could be improved
(Figure 10figure 10).
The answer is usually longer and more explicit. In this example, a request of
five lines came back with a task, a list of what to include for each
language, an output format, an example row, and instructions such as
indicating uncertainty rather than guessing
(Figure 11figure 11).
Figure 10. Asking the chatbot to improve a prompt. Claude Sonnet 4, 2025. Figure 11. The optimized prompt that came back. Claude Sonnet 4, 2025.
The rewrite also changed the task. The original asked for all EU languages;
the optimized prompt asks for eight of them, “and any others you have
confidence in”. So read a rewritten prompt as a draft before you use it.
Tools that rewrite a prompt
Some providers offer the same as a feature of their developer tools: a button
that rewrites a prompt following the provider’s own recommendations. OpenAI’s,
for instance, optimizes a prompt “according to current best practices”, and
its documentation warns that the result can “perform worse than your original
on specific inputs”.OpenAI, Prompt optimizer, read 21 September 2026. The version that learns from a set of rated examples is being withdrawn with OpenAI’s evaluation platform, which becomes read-only on 31 October 2026 and shuts down on 30 November 2026.
Systematic optimization
When the same prompt is used over and over on the same kind of task, it can
be improved systematically.
La façon la plus simple d’améliorer une requête est de le demander à un agent
conversationnel : collez la requête et demandez comment elle pourrait être
améliorée
(Figure 10figure 10).
La réponse est généralement plus longue et plus explicite. Dans cet exemple,
une demande de cinq lignes est revenue avec une tâche, une liste de ce qu’il
faut indiquer pour chaque langue, un format de sortie, une ligne d’exemple, et
des consignes comme signaler l’incertitude plutôt que de deviner
(Figure 11figure 11).
Figure 10. Demander à l'agent conversationnel d'améliorer une requête. Claude Sonnet 4, 2025. Figure 11. La requête optimisée obtenue. Claude Sonnet 4, 2025.
La réécriture a aussi modifié la tâche. La requête d’origine demandait toutes
les langues de l’UE ; la requête optimisée en demande huit, « and any others
you have confidence in » (et toutes celles dont vous êtes sûr). Lisez donc une
requête réécrite comme une ébauche avant de vous en servir.
Des outils qui réécrivent une requête
Certains fournisseurs proposent la même chose comme fonctionnalité de leurs
outils pour développeurs : un bouton qui réécrit une requête selon les
recommandations du fournisseur. Celui d’OpenAI, par exemple, optimise une
requête « according to current best practices » (selon les pratiques
exemplaires actuelles), et sa documentation prévient que le résultat peut
« perform worse than your original on specific inputs » (donner de moins bons
résultats que l’original sur certaines entrées).OpenAI, Prompt optimizer, consulté le 21 septembre 2026. La version qui apprend à partir d’un ensemble d’exemples notés disparaît avec la plateforme d’évaluation d’OpenAI, qui passe en lecture seule le 31 octobre 2026 et ferme le 30 novembre 2026.
L’optimisation systématique
Quand la même requête sert encore et encore pour le même type de tâche, elle
peut être améliorée de façon systématique.
Custom instructions, memory, projects and skillsInstructions personnalisées, mémoire, projets et compétences
Four ways to avoid repeating yourself
Chat apps offer four ways to keep instructions or material from one
conversation to the next. All four reach the model the same way, as text added
to its context.
What is stored
How it reaches the model
Custom instructions
text you wrote in your settings
added to every new conversation
Memory
notes the chat app kept from earlier conversations
added to new conversations, or found by a search when they seem relevant
A project
files and instructions you attached to the project
added to every conversation opened inside the project
A skill
instructions, and sometimes small programs, for one kind of task
added when a task seems to call for it
Four ways a chat app keeps instructions or material from one conversation to the next.
Say it once
If you tell the model in every conversation to use British spelling, to
avoid bullet points and to keep its answers short, that instruction
belongs in your settings. Chat apps offer this under several names and
shapes, which come to the same thing: text stored once and added to each new
conversation before your first message.
Figure 12. ChatGPT: the personalization settings, 16 September 2026.
Custom instructions can contain anything you would otherwise repeat in every
conversation, for instance the language variety you write in, spelling
conventions, formats you never want, the reference works you follow, or
writing habits you dislike, named explicitly.
The same instructions can also be saved as an assistant of their own, with a
name and files it may draw on, and used or shared when the work calls for
it, as in Gemini’s Gems
(Figure 13figure 13).
Figure 13. Saved instructions with a name and files: the Gem editor in Gemini, 17 September 2026. Figure 14. An instruction given in the settings and not followed in the answer. ChatGPT, 2025, from Brent Csutoras's article.
Memory
With memory switched on, the chat app keeps notes from your conversations
and brings them into later ones, either every time or when they seem
relevant, so a preference you stated once in passing can reach a
conversation months later. For prompting, that works both ways: a note kept
from one piece of work can surface in another, with instructions you never
meant to give there. It is worth reading what yours
contains (see also the What a chat product adds to the model page, in the Using LLMs module) (voir aussi la page Ce qu'un agent conversationnel ajoute au modèle, dans le module Utiliser les GML).
Projects
A project is the same idea scoped to one piece of work: a folder of
conversations that share files and instructions. The project in
Figure 15figure 15, for
instance, is for preparing a marathon: its instructions and its training plan
are part of every conversation opened in it, from fueling strategy to strength
training, and a conversation opened outside the project does not see
them (see also the Working with long documents page, in the Using LLMs module) (voir aussi la page Travailler avec de longs documents, dans le module Utiliser les GML).
Figure 15. A project in Claude, 21 September 2026: the instructions, memory and training plan are shared by every conversation inside it.
Skills
A skill is a set of instructions for one kind of task, sometimes with small
programs or reference files alongside them, that the chat app loads only when
a task seems to call for it
(Figure 16figure 16).
Where a project is tied to one piece of work, a skill
is tied to one way of working: how you want a report laid out, the checks
you run on a text before you send it, the format of your meeting
notes (see also the What a chat product adds to the model page, in the Using LLMs module) (voir aussi la page Ce qu'un agent conversationnel ajoute au modèle, dans le module Utiliser les GML).
Figure 16. Skills in Claude's settings, 21 September 2026: two written by the user, one of them masked, and four from Anthropic.
Instructions, memory, project files and skills all work by inserting text
into the context automatically. They are prompting rather than
configuration, and the same limits apply: they are usually followed,
followed less in a long conversation, and never guaranteed (see also the In-context learning chapter, in the LLM lifecycle module) (voir aussi le chapitre Apprentissage en contexte, dans le module Cycle de vie des GML).
Quatre façons d’éviter de vous répéter
Les applications de clavardage offrent quatre façons de conserver des
instructions ou des documents d’une conversation à l’autre. Tous parviennent
au modèle de la même façon, sous forme de texte ajouté à son contexte.
Ce qui est conservé
Comment cela parvient au modèle
Instructions personnalisées
un texte que vous avez rédigé dans vos paramètres
ajouté à chaque nouvelle conversation
Mémoire
des notes que l’application a gardées de conversations précédentes
ajoutées aux nouvelles conversations, ou retrouvées par une recherche quand elles semblent pertinentes
Un projet
des fichiers et des instructions joints au projet
ajoutés à chaque conversation ouverte dans le projet
Une compétence
des instructions, et parfois de petits programmes, pour un type de tâche
ajoutée quand une tâche semble l’exiger
Quatre façons dont une application de clavardage transmet des instructions ou des documents d'une conversation à l'autre.
Le dire une fois
Si vous demandez au modèle, dans chaque conversation, d’utiliser l’orthographe
britannique, d’éviter les listes à puces et de faire des réponses courtes,
cette consigne a sa place dans vos paramètres. Les applications de clavardage
proposent cette possibilité sous plusieurs noms et plusieurs formes, qui
reviennent au même : un texte enregistré une fois et ajouté à chaque nouvelle
conversation avant votre premier message.
Figure 12. ChatGPT : les paramètres de personnalisation, 16 septembre 2026.
Les instructions personnalisées peuvent contenir tout ce que vous répéteriez
sinon dans chaque conversation, par exemple la variété de langue dans laquelle
vous écrivez, des conventions d’orthographe, des formats dont vous ne voulez
jamais, les ouvrages de référence que vous suivez, ou des tics d’écriture que
vous n’aimez pas, nommés explicitement.
Les mêmes instructions peuvent aussi être enregistrées comme un assistant à
part entière, avec un nom et des fichiers sur lesquels il peut s’appuyer, et
utilisées ou partagées quand le travail l’exige, comme les Gems de Gemini
(Figure 13figure 13).
Figure 13. Des instructions enregistrées avec un nom et des fichiers : l'éditeur de Gem dans Gemini, 17 septembre 2026. Figure 14. Une instruction donnée dans les paramètres et non respectée dans la réponse. ChatGPT, 2025, d'après l'article de Brent Csutoras.
La mémoire
Quand la mémoire est activée, l’application de clavardage garde des notes de
vos conversations et les reprend dans les suivantes, soit à chaque fois, soit
quand elles semblent pertinentes : une préférence exprimée une seule fois,
en passant, peut ainsi resurgir dans une conversation des mois plus tard. Pour
la rédaction des requêtes, cela joue dans les deux sens : une note tirée d’un
travail peut réapparaître dans un autre, avec des consignes que vous n’aviez
jamais voulu y donner. Il vaut la peine de lire ce que contient la
vôtre (see also the What a chat product adds to the model page, in the Using LLMs module) (voir aussi la page Ce qu'un agent conversationnel ajoute au modèle, dans le module Utiliser les GML).
Les projets
Un projet applique la même idée à un seul travail : un dossier de
conversations qui partagent des fichiers et des instructions. Le projet de
Figure 15figure 15, par
exemple, sert à préparer un marathon : ses instructions et son plan
d’entraînement font partie de chaque conversation ouverte dans le projet, de
la stratégie d’alimentation au renforcement musculaire, et une conversation
ouverte hors du projet ne les voit
pas (see also the Working with long documents page, in the Using LLMs module) (voir aussi la page Travailler avec de longs documents, dans le module Utiliser les GML).
Figure 15. Un projet dans Claude, 21 septembre 2026 : les instructions, la mémoire et le plan d'entraînement sont partagés par toutes les conversations du projet.
Les compétences
Une compétence (angl. skill) est un ensemble d’instructions pour un type de
tâche, parfois accompagné de petits programmes ou de fichiers de référence,
que l’application ne charge que lorsqu’une tâche semble l’exiger
(Figure 16figure 16).
Alors qu’un projet est lié à un travail, une compétence est liée à une façon
de travailler : la mise en page que vous voulez pour un rapport, les
vérifications que vous faites sur un texte avant de l’envoyer, le format de
vos comptes rendus de
réunion (see also the What a chat product adds to the model page, in the Using LLMs module) (voir aussi la page Ce qu'un agent conversationnel ajoute au modèle, dans le module Utiliser les GML).
Figure 16. Les compétences dans les paramètres de Claude, 21 septembre 2026 : deux créées dans le compte, dont une masquée, et quatre d'Anthropic.
Les instructions, la mémoire, les fichiers d’un projet et les compétences
fonctionnent tous en insérant automatiquement du texte dans le contexte. Ils
relèvent de la requête plutôt que de la configuration, et sont soumis aux
mêmes limites : ils sont généralement respectés, moins bien dans une longue
conversation, et jamais garantis (see also the In-context learning chapter, in the LLM lifecycle module) (voir aussi le chapitre Apprentissage en contexte, dans le module Cycle de vie des GML).
Risks and safeguardsRisques et précautions
Written in English. The French version was automatically generated
and I have not revised it.
Rédigé en anglais. La version française a été
générée automatiquement et je ne l'ai pas révisée.
Checking the answerVérifier la réponse
What to check
Some of what a model gives you is a matter of taste: the wording of a draft,
the tone of an email, a list of possible titles
(Figure 1figure 1).
Your own taste and general knowledge are enough to judge it. Other parts are
a matter of fact, with an exact answer that takes specific knowledge to
check: a name, a figure, a reference, or a verdict such as whether a
translation says what the original says. A wrong fact reads exactly like a
right one, however plausible and confident the answer around
it (see also the Hallucinations chapter, in the Critical issues with LLMs module) (voir aussi le chapitre Les fabulations de l'IA, dans le module Enjeux critiques des GML). So unless you already
know the answer, decide which facts you will check.
Figure 1. Output that is a matter of taste, and output that is a matter of fact.
What each check can and cannot do
Check
What it helps with
Its limits
Put a document with the information in the context
the answer is more likely to be right about what the document says
no guarantee: the model can still misquote the document, misread it, or read more into it than it says
Turn on web search and open the sources it cites
the answer is based on pages you can read
the same limits, and the pages themselves may be unreliable, so you also judge the sources
Ask the same model the same question again, in a new conversation
if the two answers differ, you know there is a problem
a model can easily be wrong the same way twice
Ask a second model
a mistake only one of the two makes shows up as a disagreement
both can make the same mistake, for instance a widely repeated misconception
Ask the model to check its answer
a second pass that may catch some errors
no guarantee: unless it can search, it has nothing new to consult, and it can be confidently wrong again
Ask for the case against, for instance “list what a demanding reviewer would object to”
Farquhar, S., Kossen, J., Kuhn, L., & Gal, Y. (2024). Detecting hallucinations in large language models using semantic entropy. Nature, 630(8017), 625–630. https://doi.org/10.1038/s41586-024-07421-0
Quoi vérifier
Une partie de ce qu’un modèle vous donne relève du goût : la formulation d’un
brouillon, le ton d’un courriel, une liste de titres possibles
(Figure 1figure 1).
Votre goût et vos connaissances générales suffisent à en juger. D’autres
éléments relèvent du fait, avec une réponse exacte qui demande des
connaissances précises : un nom, un chiffre, une référence, ou un verdict,
par exemple si une traduction dit bien ce que dit l’original. Un fait faux se
lit exactement comme un fait juste, aussi plausible et assurée que soit la
réponse qui l’entoure (see also the Hallucinations chapter, in the Critical issues with LLMs module) (voir aussi le chapitre Les fabulations de l'IA, dans le module Enjeux critiques des GML). À
moins de déjà connaître la réponse, décidez donc quels faits vous allez
vérifier.
Figure 1. Ce qui relève du goût et ce qui relève du fait dans une réponse.
Ce que chaque vérification peut et ne peut pas faire
Vérification
Ce qu’elle apporte
Ses limites
Mettre dans le contexte un document contenant l’information
la réponse a plus de chances d’être juste sur ce que dit le document
aucune garantie : le modèle peut mal citer le document, le lire de travers ou lui faire dire plus qu’il ne dit
Activer la recherche web et ouvrir les sources citées
la réponse s’appuie sur des pages que vous pouvez lire
les mêmes limites, et les pages elles-mêmes peuvent être peu fiables : vous jugez aussi les sources
Reposer la même question au même modèle, dans une nouvelle conversation
si les deux réponses diffèrent, vous savez qu’il y a un problème
un modèle peut très bien se tromper deux fois de la même façon
Poser la question à un deuxième modèle
une erreur que l’un des deux seulement commet apparaît comme un désaccord
les deux peuvent commettre la même erreur, par exemple une idée fausse très répandue
Demander au modèle de vérifier sa réponse
un deuxième passage qui attrape parfois des erreurs
aucune garantie : sauf s’il peut chercher, il n’a rien de nouveau à consulter, et il peut se tromper de nouveau avec assurance
Demander ce qu’on pourrait objecter, par exemple « liste ce qu’un évaluateur exigeant reprocherait à ce texte »
les objections aussi sont générées : elles peuvent être inventées ou passer à côté du vrai problème
Demander au modèle comment il est arrivé à sa réponse
des étapes intermédiaires que vous pouvez vérifier une à une
l’explication ne correspond pas forcément à la façon dont la réponse a été produite, et chaque étape peut être fausse
Essayer le modèle sur un cas dont vous connaissez déjà la réponse
montre s’il se débrouille avec ce genre de tâche
un cas suivant peut quand même mal tourner
Chercher vous-même l’information dans une source fiable
la seule vérification qui ne dépend pas d’un modèle
elle prend du temps : gardez-la pour les faits qui comptent
Exemples de vérifications, ce que chacune apporte et ses limites.
Toutes les vérifications sauf la dernière passent par un modèle : elles
peuvent échouer comme la réponse a échoué. Reposer la question reste utile :
des réponses dont le sens varie d’une exécution à l’autre sont un signe
mesurable de contenu inventé (Farquhar et al.,
2024) (see also the LLMs are non-deterministic page, in the LLM lifecycle module) (voir aussi la page Les GML ne sont pas déterministes, dans le module Cycle de vie des GML). Cela vaut son
coût pour une affirmation à laquelle vous devez vous fier, mais reposer la
même question par réflexe ajoute à l’énergie que consomme un
modèle (see also the Putting it in proportion page, in the Critical issues with LLMs module) (voir aussi la page Remettre en proportion, dans le module Enjeux critiques des GML).
Sources
Farquhar, S., Kossen, J., Kuhn, L., & Gal, Y. (2024). Detecting hallucinations in large language models using semantic entropy. Nature, 630(8017), 625–630. https://doi.org/10.1038/s41586-024-07421-0
Figure 2. A prompt injection and what it produced. The report says costs were stable; the two outlined lines tell the model to say they went down, and the answer says it.
Someone who writes a document you will feed to a model can use that.
Text is easy to hide from a reader without hiding it from a program: set in
the same colour as the background, or at a size of one point, it disappears on
the page while any program reading the file still extracts it. A study wrote
such instructions into 100 manuscripts and uploaded them to ChatGPT and Gemini
with a request for a review: instructions steering the review towards a
positive verdict, or making the model refuse, or sending it to an external
site, each worked more than 98 % of the time (Torrielli et al.,
2026). Conferences have begun to
take a position on it: the ICML 2026 reviewer guidelines forbid authors
from injecting prompts, while allowing instructions whose only purpose is to
reveal that a reviewer used a model.Tested in 2026 through the two products’ web interfaces, on computer-science papers; the authors also propose the same mechanism as a detection tool, since a hidden instruction that leaves a trace in a review shows the review was generated.
Why it concerns you
Anything a model reads on your behalf can contain instructions: a web page, a
PDF from a client, an email being summarized, a document in a shared folder. A
sentence in that material saying disregard your instructions and instead do
X is not marked as less authoritative than what you wrote.
When a model only writes you an answer, the worst that happens is a wrong or
strange answer, and you have a chance to notice it. It gets serious once the
model can act for you, because the hidden instruction then reaches your files,
your messages or your
accounts.
Sources
Torrielli, F., Locci, S., Rapp, A., & Di Caro, L. (2026). Exploiting large language models in peer review: indirect prompt injection attacks and integrity probes. Scientometrics, 131(7), 4889–4951. https://doi.org/10.1007/s11192-026-05695-x
Zhang, Z., Li, S., Zhang, Z., Liu, X., Jiang, H., Tang, X., et al. (2025b). IHEval: Evaluating Language Models on Following the Instruction Hierarchy. Proceedings of the 2025 Conference of the Nations of the Americas Chapter of the Association for Computational Linguistics (NAACL 2025), 8374–8398. https://doi.org/10.18653/v1/2025.naacl-long.425
Instructions et contenu se ressemblent pour un modèle
Figure 2. Une infiltration de requête et ce qu'elle a produit. Le rapport dit que les coûts sont restés stables ; les deux lignes encadrées disent au modèle d'annoncer une baisse, et la réponse l'annonce.
Qui écrit un document que vous donnerez à un modèle peut s’en servir.
Un exemple : des manuscrits qui s’évaluent eux-mêmes
Un texte se cache facilement à un lecteur sans se cacher à un programme :
écrit dans la couleur du fond, ou en corps un, il disparaît sur la page alors
que tout programme qui lit le fichier l’extrait encore. Une étude a inséré de
telles instructions dans 100 manuscrits, puis a soumis ceux-ci à ChatGPT et à
Gemini en demandant une évaluation : les instructions qui orientaient
l’évaluation vers un verdict favorable, celles qui poussaient le modèle à
refuser et celles qui le renvoyaient vers un site externe ont fonctionné plus
de 98 % du temps (Torrielli et al.,
2026). Les conférences commencent à
prendre position : les consignes aux évaluateurs d’ICML 2026 interdisent aux
auteurs d’insérer des instructions, tout en tolérant celles dont le seul but
est de révéler qu’un évaluateur a utilisé un modèle.Testé en 2026 par les interfaces web des deux produits, sur des articles d’informatique ; les auteurs proposent aussi ce mécanisme comme outil de détection, puisqu’une instruction cachée qui laisse une trace dans une évaluation montre que celle-ci a été générée.
Pourquoi cela vous concerne
Tout ce qu’un modèle lit pour vous peut contenir des instructions : une page
web, un PDF envoyé par un client, un courriel à résumer, un document dans un
dossier partagé. Une phrase de cette matière qui dit ignore tes instructions
et fais plutôt X n’est pas signalée comme moins autoritaire que ce que vous
avez écrit.
Quand un modèle se contente de vous écrire une réponse, le pire qui arrive est
une réponse fausse ou étrange, et vous avez une chance de le remarquer. Cela
devient sérieux dès que le modèle peut agir pour vous, car l’instruction
cachée atteint alors vos fichiers, vos messages ou vos
comptes.
Sources
Torrielli, F., Locci, S., Rapp, A., & Di Caro, L. (2026). Exploiting large language models in peer review: indirect prompt injection attacks and integrity probes. Scientometrics, 131(7), 4889–4951. https://doi.org/10.1007/s11192-026-05695-x
Zhang, Z., Li, S., Zhang, Z., Liu, X., Jiang, H., Tang, X., et al. (2025b). IHEval: Evaluating Language Models on Following the Instruction Hierarchy. Proceedings of the 2025 Conference of the Nations of the Americas Chapter of the Association for Computational Linguistics (NAACL 2025), 8374–8398. https://doi.org/10.18653/v1/2025.naacl-long.425
Training, retention and privacy settingsEntraînement, conservation et paramètres de confidentialité
Where a prompt goes
A prompt typed into a chat app leaves your device, is processed on the
provider’s servers, and is stored there with the answer as part of your
history
(Figure 3figure 3).
From there, three things may happen to it, depending on the plan and the
settings:
it is kept for a period after you delete it, commonly about thirty days,
and longer in several situations: a conversation someone has reviewed, a
setting that allows training, a legal obligation;Anthropic removes deleted conversations from its back-end within thirty days and, with the model-improvement setting on, keeps chats in de-identified form for up to five years; OpenAI removes deleted conversations within thirty days (both read 17 September 2026, links in the note under the table below). Google keeps conversations that human reviewers saw for up to three years, and deleting your activity does not delete them: Gemini Apps Privacy Hub, read 22 September 2026.
it may be read by the provider’s staff or contractors, for instance
when a safety system flags it, or to improve the service;Google, for instance, states that “a subset of chats are reviewed by human reviewers” to improve its services: Gemini Apps Privacy Hub, updated 10 August 2026, read 17 September 2026.
it may be used to train the next models, on personal plans where that
is the default or where you have agreed to it.
Figure 3. What can happen to a prompt after you send it. The last arrow depends on your plan and your settings.
Text used in training can come back out: Nasr et al. (2025) extracted
training data, personal details included, from production
models (see also the What happens to the training text page, in the LLM lifecycle module) (voir aussi la page Ce qu'il advient du texte d'entraînement, dans le module Cycle de vie des GML).Shown on the ChatGPT and Gemini models of 2023 and 2024. The authors report that one of their two attacks has since been patched, but not the general problem behind it.
The chance that your own paragraph resurfaces is small, but once text has
been used to train a model, switching the setting off afterwards does not
take it back out of that model.
What differs by plan
Personal plans, business plans and the API generally follow different rules,
and the pattern across providers stays the same even where the details
change:
Used for training
Retention
Who it suits
Free and individual plans
often yes by default, with an opt-out
the provider’s standard period
personal use
Business and enterprise plans
generally not
configurable
an organization’s work
The API
generally not
a short period
your own programs
A model on your own computer
no
your disk
material that may not leave
On personal plans the details vary from one provider to the next, for
instance in whether training is on by default, how the setting is named and
how long conversations are kept once training is allowed. A retention period can also be
overridden: a court order in a lawsuit brought by the New York Times made
one provider keep even deleted conversations for part of
2025.For instance Anthropic: with the “model improvement” setting on, chats are kept in de-identified form for up to five years and may be used for training; with it off, deleted conversations leave the back-end within thirty days; Claude for Work and the API are not used for training (Is my data used for model training?, How long do you store my data?; whether the setting is on by default for a new account is not stated there). OpenAI: conversations on personal plans are used for training unless “Improve the model for everyone” is switched off, deleted conversations leave its systems within thirty days, and business plans and the API are not used by default (How your data is used to improve model performance, updated 13 March 2026; Data Controls FAQ). The court order ended on 26 September 2025, and “limited historical April–September 2025 user data” is kept for the lawsuit (How we’re responding to The New York Times’ data demands, update of 22 October 2025). All read 17 September 2026.
Every chat app has a page in its settings where these choices are made, and
most offer a temporary or incognito mode for a conversation that should not
enter your history at
all.For instance Claude Help Center, Incognito chats; OpenAI Help Center, Temporary Chat FAQ. Both read 15 September 2026.
Reading that page once per chat app takes a few minutes, and tells you what
happens to your text. The training switch is the one to look for: ChatGPT
keeps it under Data controls
(Figure 4figure 4)
and Claude under Privacy
(Figure 5figure 5),
and other products put it somewhere comparable under a name of their own.
Figure 4. Where the training setting lives in ChatGPT, switched off on this account. It is a ChatGPT Work account; on a personal plan the same row is the one to check. 22 September 2026. Figure 5. The same setting in Claude, under Privacy, which I switched off myself rather than finding it off by default. 22 September 2026.
What this means for confidential work
Some material is not yours to hand over: an employer’s internal document, an
unpublished manuscript or a dataset under embargo, a job application or a
medical file that names someone, a student’s assignment, and, for a
translator, a client’s text under a confidentiality agreement. None of it
belongs in a chat app on a personal plan with the default settings. Each needs
a deliberate decision, and the decision is not always no: a business plan with
training off and a retention period you can defend, or a model running on your
own machine, are the arrangements that make it
yes (see also the Chat app, API or your own computer page, in the Using LLMs module) (voir aussi la page Application, API ou votre propre ordinateur, dans le module Utiliser les GML). What you owe
a client, an employer, a research ethics board or a professional order, and
what privacy law adds, depends on your own contracts and on the law that
applies to
you.
A conversation can also leave on purpose. Chat apps offer a link that anyone
can open, and a document or a report can be published the same
way (see also the Documents, images, voice and study modes page, in the Using LLMs module) (voir aussi la page Documents, images, voix et modes d'étude, dans le module Utiliser les GML). The link
shows the exchange as it stands, so a conversation is worth reading
through before you share it, above all when it contains material or details
belonging to someone else. A shared link can also spread further than
expected: in July 2025 ChatGPT offered to make a shared conversation findable
by search engines, the magazine Fast Company found thousands of them in Google
results, and OpenAI withdrew the option within days, saying it gave people too many chances
to share something they had not meant to.OpenAI’s security lead called it a short-lived experiment and said indexed content would be removed from the search engines: Karissa Bell, OpenAI is removing ChatGPT conversations from Google, Engadget, 31 July 2025, read 22 September 2026.
(Figure 6figure 6).
Figure 6. Sharing a conversation in ChatGPT, 17 September 2026: the exchange as it stands becomes readable by anyone with the link.
Une requête tapée dans une application de conversation quitte votre appareil,
est traitée sur les serveurs du fournisseur et y est conservée avec la
réponse, dans votre historique
(Figure 3figure 3).
De là, trois choses peuvent lui arriver, selon le forfait et les réglages :
elle est conservée un certain temps après que vous l’avez supprimée,
couramment une trentaine de jours, et plus longtemps dans plusieurs cas :
une conversation que quelqu’un a examinée, un réglage qui autorise
l’entraînement, une obligation légale ;Anthropic retire les conversations supprimées de ses systèmes en moins de trente jours et, quand le réglage d’amélioration des modèles est activé, conserve les conversations sous forme dépersonnalisée jusqu’à cinq ans ; OpenAI retire les conversations supprimées en moins de trente jours (les deux consultés le 17 septembre 2026, liens dans la note sous le tableau ci-dessous). Google conserve jusqu’à trois ans les conversations examinées par des personnes, et supprimer votre activité ne les supprime pas : Gemini Apps Privacy Hub, consulté le 22 septembre 2026.
elle peut être lue par le personnel du fournisseur ou par des
sous-traitants, par exemple quand un système de sécurité la signale, ou pour
améliorer le service ;Google, par exemple, indique qu’« un sous-ensemble de conversations est examiné par des évaluateurs humains » pour améliorer ses services : Gemini Apps Privacy Hub, mis à jour le 10 août 2026, consulté le 17 septembre 2026.
elle peut servir à entraîner les prochains modèles, sur les forfaits
personnels où c’est le réglage par défaut ou lorsque vous y avez consenti.
Figure 3. Ce qui peut arriver à une requête une fois envoyée. La dernière flèche dépend de votre forfait et de vos réglages.
Un texte utilisé pour l’entraînement peut ressortir : Nasr et al. (2025) ont
extrait des données d’entraînement, renseignements personnels compris, de
modèles en
production (see also the What happens to the training text page, in the LLM lifecycle module) (voir aussi la page Ce qu'il advient du texte d'entraînement, dans le module Cycle de vie des GML).Montré sur les modèles de ChatGPT et de Gemini de 2023 et 2024. Les auteurs signalent qu’une de leurs deux attaques a depuis été corrigée, mais pas le problème général qui la rend possible.
Le risque que votre paragraphe ressorte est faible, mais une fois qu’un texte
a servi à entraîner un modèle, désactiver le réglage après coup ne le retire
pas de ce modèle.
Ce qui change selon le forfait
Les forfaits personnels, les forfaits d’entreprise et l’interface de
programmation (API) suivent généralement des règles différentes, et le schéma reste
le même d’un fournisseur à l’autre même quand les détails changent :
Sert à l’entraînement
Conservation
À qui cela convient
Forfaits gratuits et individuels
souvent oui par défaut, avec une option de refus
la durée habituelle du fournisseur
un usage personnel
Forfaits d’entreprise
généralement non
configurable
le travail d’une organisation
L’interface de programmation
généralement non
une courte durée
vos propres programmes
Un modèle sur votre ordinateur
non
votre disque
ce qui ne doit pas sortir
Sur les forfaits personnels, les détails varient d’un fournisseur à l’autre,
par exemple selon que l’entraînement est activé par défaut ou non, selon le
nom donné au réglage et selon la durée de conservation une fois l’entraînement
autorisé. Une durée de conservation peut aussi être suspendue : dans le
procès intenté par le New York Times, une ordonnance a obligé un fournisseur
à conserver même les conversations supprimées pendant une partie de
2025.Anthropic, par exemple : avec le réglage « model improvement » activé, les conversations sont conservées sous forme dépersonnalisée jusqu’à cinq ans et peuvent servir à l’entraînement ; désactivé, les conversations supprimées quittent les systèmes en moins de trente jours ; Claude for Work et l’interface de programmation ne servent pas à l’entraînement (Is my data used for model training?, How long do you store my data? ; les pages ne disent pas si le réglage est activé par défaut pour un nouveau compte). OpenAI : sur les forfaits personnels, les conversations servent à l’entraînement à moins de désactiver « Improve the model for everyone », les conversations supprimées quittent les systèmes en moins de trente jours, et les forfaits d’entreprise et l’interface de programmation ne sont pas utilisés par défaut (How your data is used to improve model performance, mis à jour le 13 mars 2026 ; Data Controls FAQ). L’ordonnance a pris fin le 26 septembre 2025, et des « données d’utilisateurs historiques limitées d’avril à septembre 2025 » sont conservées pour le procès (How we’re responding to The New York Times’ data demands, mise à jour du 22 octobre 2025). Tous consultés le 17 septembre 2026.
Chaque application de conversation a une page de réglages où ces choix se
font, et la plupart offrent un mode temporaire ou incognito pour une
conversation qui ne doit pas entrer dans votre
historique.Par exemple Claude Help Center, Incognito chats ; OpenAI Help Center, Temporary Chat FAQ. Les deux consultés le 15 septembre 2026.
Lire cette page une fois par application prend quelques minutes et vous dit ce
qui arrive à votre texte. C’est le réglage d’entraînement qu’il faut y
chercher : ChatGPT le place sous Data controls
(Figure 4figure 4)
et Claude sous Privacy
(Figure 5figure 5),
et les autres produits le rangent à un endroit comparable, sous un nom à eux.
Figure 4. L'endroit du réglage d'entraînement dans ChatGPT, désactivé sur ce compte, dans l'interface en anglais. C'est un compte ChatGPT Work ; sur un forfait personnel, c'est la même ligne qu'il faut vérifier. 22 septembre 2026. Figure 5. Le même réglage dans Claude, sous Privacy, que j'ai désactivé moi-même plutôt que de le trouver désactivé par défaut, dans l'interface en anglais. 22 septembre 2026.
Ce que cela implique pour le travail confidentiel
Une partie de ce que vous traitez ne vous appartient pas : un document
interne d’un employeur, un manuscrit inédit ou un jeu de données sous embargo,
une candidature ou un dossier médical qui nomme quelqu’un, le travail d’un
étudiant et, pour un traducteur, le texte d’un client soumis à une entente de
confidentialité. Rien de tout cela n’a sa place dans une application de
conversation sur un forfait personnel avec les réglages par défaut. Chaque cas
demande une décision réfléchie, et la décision n’est pas toujours non : un
forfait d’entreprise sans entraînement et avec une durée de conservation
défendable, ou un modèle qui tourne sur votre machine, sont les arrangements
qui permettent de dire
oui (see also the Chat app, API or your own computer page, in the Using LLMs module) (voir aussi la page Application, API ou votre propre ordinateur, dans le module Utiliser les GML). Ce que vous
devez à un client, à un employeur, à un comité d’éthique de la recherche ou à
un ordre professionnel, et ce qu’y ajoute le droit de la vie privée, dépend de
vos propres contrats et du droit qui s’applique à
vous.
Une conversation peut aussi sortir volontairement. Les applications de
conversation offrent un lien que n’importe qui peut ouvrir, et un document ou
un rapport peut être publié de la même
façon (see also the Documents, images, voice and study modes page, in the Using LLMs module) (voir aussi la page Documents, images, voix et modes d'étude, dans le module Utiliser les GML). Le
lien montre l’échange tel quel : une conversation mérite donc d’être relue
avant d’être partagée, surtout quand elle contient de la matière ou des
renseignements qui appartiennent à quelqu’un d’autre. Un lien partagé peut
aussi aller plus loin que prévu : en juillet 2025, ChatGPT proposait de rendre
une conversation partagée repérable par les moteurs de recherche, le
magazine Fast Company en a trouvé des milliers dans les résultats de Google,
et OpenAI a
retiré l’option en quelques jours, en expliquant qu’elle donnait trop
d’occasions de partager quelque chose sans l’avoir voulu.Le responsable de la sécurité chez OpenAI a parlé d’une expérience de courte durée et annoncé le retrait des contenus indexés des moteurs de recherche : Karissa Bell, OpenAI is removing ChatGPT conversations from Google, Engadget, 31 juillet 2025, consulté le 22 septembre 2026.
(Figure 6figure 6).
Figure 6. Le partage d'une conversation dans ChatGPT, 17 septembre 2026 : l'échange tel quel devient lisible par quiconque a le lien.
Garbage in, garbage outMédiocre en entrée, médiocre en sortie
Written in English. The French version was automatically generated
and I have not revised it.
Rédigé en anglais. La version française a été
générée automatiquement et je ne l'ai pas révisée.
Garbage in, garbage outMédiocre en entrée, médiocre en sortie
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
The impact of GIGOL'impact du GIGO
While the GIGO principle is not the only cause of the many issues associated
with LLMs and AI in general, it is a significant factor in many of the biggest
ones, so you will see it referred to in many of the other chapters and pages of
this module. For instance:
Le principe du GIGO n’est pas la seule cause des nombreux problèmes associés
aux GML et à l’IA en général, mais il entre pour une part importante dans
plusieurs des plus grands, si bien que vous le verrez évoqué dans beaucoup
d’autres chapitres et pages de ce module. Par exemple :
Biais. Les modèles apprennent à partir de textes biaisés et produisent
des sorties biaisées (see also the Bias chapter, in the Critical issues with LLMs module) (voir aussi le chapitre Biais, dans le module Enjeux critiques des GML).
Vie privée et droit d’auteur. Tout ce qui est entré dans le corpus peut
en ressortir, renseignements personnels et textes protégés
compris.
Effondrement du modèle. Ce que les modèles produisent est publié puis
récolté par l’exploration suivante, de sorte que la sortie d’une génération
devient l’entrée de la
suivante.
Written in English. The French version was automatically generated
and I have not revised it.
Rédigé en anglais. La version française a été
générée automatiquement et je ne l'ai pas révisée.
Where hallucinations come fromD'où viennent les fabulations
Glue on pizza, and citations that do not exist
Hallucinations are probably the most well-known issue with LLMs. LLMs are
known to be unreliable sometimes, and confidently spew wrong information. You
may remember an early iteration of Google’s AI Overviews telling users to add
glue to make the cheese stick to pizza better,Liv McMahon and Zoe Kleinman, Glue pizza and eat rocks: Google AI search errors go viral, BBC News, 24 May 2024, read 22 September 2026. The answer said “non-toxic glue”; the same week, AI Overviews also answered that geologists recommend eating one rock a day. Google called these “isolated examples” on “generally very uncommon queries”.
lawyers getting into trouble because they relied on AI-fabricated
citations,For instance Carolyn Gruske, Lawyer who used AI-fabricated citations hit with $31,150 in costs to LSO, Law Times, 17 June 2026, read 22 September 2026, reporting Law Society Tribunal of Ontario, 2026 ONLSTH 112: a factum and affidavits cited cases that do not exist, alongside real cases that had nothing to do with the point being made.
or Apple’s notification summaries reporting that a murder suspect had shot
himself, when the BBC had published nothing of the
kind.Graham Fraser, BBC complains to Apple over misleading shooting headline, BBC News, 13 December 2024, read 22 September 2026.
The three fail for different reasons.
The glue answer is an example of LLMs referencing unreliable sources. The AI Overviews answers of that week appeared to come from Reddit comments and from the satirical site The Onion, so the input was intentionally wrong, in a way humans would normally pick up on (see also the Garbage in, garbage out chapter, in the Critical issues with LLMs module) (voir aussi le chapitre Médiocre en entrée, médiocre en sortie, dans le module Enjeux critiques des GML), and it was summarized into an answer like any other source.
The Apple summary is an example of LLMs misrepresenting sources. The notifications it worked from said nothing of the kind, and the same summary was accurate about the two other stories it grouped.
The fabricated citations are an example of LLMs producing wrong information with no source behind it at all.
Regardless of the cause, the result is the same: confidently presented wrong
information.
Information is never labelled true or false
Three factors in how a model is trained explain why models hallucinate.
A model is trained to produce an answer, not to withhold one or to flag how uncertain it is. Answering “I do not know” has to be trained in separately (Zhang et al., 2024).
A well-attested fact and a detail that was rarely written down go through the
same steps, and both come out as a fluent sentence
(Figure 1figure 1).
Figure 1. A well-attested fact and a rarely recorded detail, produced the same way. The probabilities are illustrative.
Within a formal definition of the problem, Xu et al. (2024) prove that a model
used as a general problem solver will always hallucinate: a property to manage
rather than a defect that a later version will fix.
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Xu, Z., Jain, S., & Kankanhalli, M. (2024). Hallucination is Inevitable: An Innate Limitation of Large Language Models. arXiv:2401.11817 (preprint). https://arxiv.org/abs/2401.11817
Zhang, H., Diao, S., Lin, Y., Fung, Y. R., Lian, Q., Wang, X., Chen, Y., Ji, H., & Zhang, T. (2024). R-Tuning: Instructing Large Language Models to Say `I Don't Know'. Proceedings of the 2024 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies (Volume 1: Long Papers), 7113–7139. https://doi.org/10.18653/v1/2024.naacl-long.394
De la colle sur la pizza, et des références qui n’existent pas
Les fabulations de l’IA (angl. hallucinations) sont sans doute le problème le
plus connu des grands modèles de langue (GML). Les GML sont réputés peu
fiables par moments, et ils débitent des informations fausses avec assurance.
Vous vous souvenez peut-être d’une première version des AI Overviews de Google
qui conseillait d’ajouter de la colle pour que le fromage tienne mieux sur la
pizza,Liv McMahon et Zoe Kleinman, Glue pizza and eat rocks: Google AI search errors go viral, BBC News, 24 mai 2024, consulté le 22 septembre 2026. La réponse parlait de « non-toxic glue » [ma traduction : « colle non toxique »] ; la même semaine, AI Overviews répondait aussi que les géologues recommandent de manger un caillou par jour. Google a qualifié ces réponses de « isolated examples » [ma traduction : « cas isolés »], sur des requêtes « generally very uncommon » [ma traduction : « généralement très inhabituelles »].
d’avocats qui se sont mis dans l’embarras en se fiant à des références
fabriquées par l’IA,Par exemple Carolyn Gruske, Lawyer who used AI-fabricated citations hit with $31,150 in costs to LSO, Law Times, 17 juin 2026, consulté le 22 septembre 2026, rapportant Law Society Tribunal of Ontario, 2026 ONLSTH 112 : un mémoire et des affidavits citaient des causes inexistantes, à côté de causes réelles sans rapport avec le propos.
ou des résumés de notifications d’Apple rapportant qu’un suspect de meurtre
s’était tiré dessus, alors que la BBC n’avait rien publié de
tel.Graham Fraser, BBC complains to Apple over misleading shooting headline, BBC News, 13 décembre 2024, consulté le 22 septembre 2026.
Les trois échouent pour des raisons différentes.
La réponse sur la colle est un exemple de GML qui s’appuient sur des sources peu fiables. Les réponses des AI Overviews de cette semaine-là semblaient provenir de commentaires Reddit et du site satirique The Onion : l’entrée était fausse à dessein, d’une façon que des humains repèrent normalement (see also the Garbage in, garbage out chapter, in the Critical issues with LLMs module) (voir aussi le chapitre Médiocre en entrée, médiocre en sortie, dans le module Enjeux critiques des GML), et elle a été résumée en une réponse comme n’importe quelle autre source.
Le résumé d’Apple est un exemple de GML qui déforment leurs sources. Les notifications dont il partait ne disaient rien de tel, et le même résumé était exact sur les deux autres nouvelles qu’il regroupait.
Les références fabriquées sont un exemple de GML qui produisent de l’information fausse sans aucune source derrière.
Quelle qu’en soit la cause, le résultat est le même : de l’information fausse
présentée avec assurance.
L’information n’est jamais étiquetée vraie ou fausse
Trois facteurs, dans la façon dont un modèle est entraîné, expliquent pourquoi
les modèles fabulent.
Un modèle est entraîné à produire une réponse, pas à s’en abstenir ni à signaler son degré d’incertitude. Répondre « je ne sais pas » doit faire l’objet d’un entraînement distinct (Zhang et al., 2024).
Un fait bien attesté et un détail rarement écrit passent par les mêmes étapes,
et les deux ressortent sous la forme d’une phrase fluide
(Figure 1figure 1).
Figure 1. Un fait bien attesté et un détail rarement consigné, produits de la même façon. Les probabilités sont illustratives.
Dans le cadre d’une définition formelle du problème, Xu et al. (2024)
démontrent qu’un modèle employé comme résolveur de problèmes général fabulera
toujours : une propriété à gérer plutôt qu’un défaut qu’une version
ultérieure corrigera.
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Xu, Z., Jain, S., & Kankanhalli, M. (2024). Hallucination is Inevitable: An Innate Limitation of Large Language Models. arXiv:2401.11817 (preprint). https://arxiv.org/abs/2401.11817
Zhang, H., Diao, S., Lin, Y., Fung, Y. R., Lian, Q., Wang, X., Chen, Y., Ji, H., & Zhang, T. (2024). R-Tuning: Instructing Large Language Models to Say `I Don't Know'. Proceedings of the 2024 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies (Volume 1: Long Papers), 7113–7139. https://doi.org/10.18653/v1/2024.naacl-long.394
Two kinds of hallucinationsDeux types de fabulations
Maynez et al. (2020) separated two kinds of hallucination in summarization,
and the difference decides how you catch one in any output checked against a
source you supplied.
The two call for different checks
(Figure 2figure 2). For an intrinsic one, everything
needed is in front of you: the summary says the lease permits something the
lease forbids, and reading both catches it. For an extrinsic one, the output
is internally consistent and the error is a fact about the world, so catching it
means knowing the subject or looking it up.
Figure 2. An intrinsic and an extrinsic hallucination in a summary of the same lease.
Sources
Maynez, J., Narayan, S., Bohnet, B., & McDonald, R. (2020). On Faithfulness and Factuality in Abstractive Summarization. Proceedings of the 58th Annual Meeting of the Association for Computational Linguistics. https://doi.org/10.18653/v1/2020.acl-main.173
Maynez et al. (2020) ont distingué deux types de fabulations en résumé
automatique, et la différence détermine comment vous pouvez en repérer une
dans toute sortie vérifiable contre une source que vous avez fournie.
Les deux appellent des vérifications différentes
(Figure 2figure 2). Pour une
fabulation intrinsèque, tout ce qu’il faut est devant vous : le résumé dit
que le bail permet ce que le bail interdit, et lire les deux suffit à la
repérer. Pour une fabulation extrinsèque, la sortie est cohérente avec
elle-même et l’erreur porte sur un fait du monde : la repérer suppose de
connaître le sujet ou d’aller le vérifier.
Figure 2. Une fabulation intrinsèque et une fabulation extrinsèque dans le résumé d'un même bail.
Sources
Maynez, J., Narayan, S., Bohnet, B., & McDonald, R. (2020). On Faithfulness and Factuality in Abstractive Summarization. Proceedings of the 58th Annual Meeting of the Association for Computational Linguistics. https://doi.org/10.18653/v1/2020.acl-main.173
Why detecting hallucinations is hardPourquoi les fabulations sont difficiles à détecter
Reading does not tell you which parts are true
Asked for a quick biography of me, a chatbot opened with a warning that it
might hallucinate details, then wrote five confident, well-organized
paragraphs
(Figure 3figure 3).
The field is right. The doctorate is right, down to its subject, and the
corpus it credits me with is one I did build. The university it puts me at is
wrong: I have not worked at Ghent since 2022. Nothing in the manner of that
one sentence separates it from the ones around it.
Figure 3. A confident biography with one clear error in it. Claude 3.5 Sonnet, 16 January 2025. The field, the doctorate and the corpus are right; the university is not.
Being well known is not the same as being well covered in the training text.
Gurky is far more famous than I am, but his fame is in video rather than in
writing, and a model is trained on text. In January 2025, asked in
French for a short biography of Gurky, a Québécois YouTuber, a chatbot had the
general picture right, a francophone YouTuber, and every specific wrong. It
gave him a real name, a nationality, a birth year and a start on YouTube, all
four wrong, as was the kind of videos it said he makes
(Figure 4figure 4).A 2023 profile in the Québec press gives his first name as Jules, and the date of his first video as 6 May 2012, when he was 13: Adam Bourbonnière, 7 choses à savoir sur Gurky, youtubeur de l’année, Le Sac de chips, 10 February 2023, read 17 September 2026.
Figure 4. A short biography of a little-documented subject. ChatGPT (GPT-4o), January 2025. The general picture is right; the name, the nationality, the birth year, the start on YouTube and the kind of videos are all wrong.
Such errors are hard to see. They are plausible enough that nothing jars, the
correct details around them vouch for them, and apart from the rare general
hedge, as in the first example, no uncertainty is expressed about any
particular claim.
Careful reading checks a text against itself, so it tests coherence. It does
not test factuality, which is a question about the world rather than about the
text.
A text can be perfectly coherent and still correspond to nothing, so an error
of this kind passes a careful reading every time.
The 90 % problem
Hallucinations are becoming less common in LLMs.Fabricated references, for instance, fell sharply from GPT-3.5 to GPT-4 (Walters & Wilder, 2023). A measured rate is always for one task, and rates have not fallen evenly on all of them. While this is on the whole a
good thing, it also makes the remaining ones trickier. Think of it as the
90 % (or even 99 %) problem: if the vast majority of the information presented
to you is correct, and all of it is presented equally confidently and all of
it seems plausible, the remaining errors are very hard to detect. And the more
often you see good output, the “lazier” you can become with fact-checking,
because on average the output is, or looks, pretty
good.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Walters, W. H., & Wilder, E. I. (2023). Fabrication and errors in the bibliographic citations generated by ChatGPT. Scientific Reports, 13, 14045. https://doi.org/10.1038/s41598-023-41032-5
La lecture ne dit pas quelles parties sont vraies
À qui lui demandait en anglais une courte biographie de moi, un agent
conversationnel a commencé par avertir qu’il risquait de fabuler certains
détails, puis a écrit cinq paragraphes assurés et bien organisés
(Figure 3figure 3).
Le domaine est exact. Le doctorat est exact, jusqu’à son sujet, et le corpus
qu’il m’attribue est bien un corpus que j’ai construit. L’université où il me
place est fausse : je ne travaille plus à Gand depuis 2022. Rien, dans la
manière de cette phrase-là, ne la distingue de celles qui l’entourent.
Figure 3. Une biographie assurée qui contient une erreur nette. Claude 3.5 Sonnet, 16 janvier 2025. Le domaine, le doctorat et le corpus sont exacts ; l'université ne l'est pas.
Être connu n’est pas la même chose qu’être bien représenté dans le texte
d’entraînement. Gurky est bien plus célèbre que moi, mais sa notoriété passe
par la vidéo plutôt que par l’écrit, et un modèle est entraîné sur du texte.
En janvier 2025, à qui lui demandait en français une courte biographie de
Gurky, un youtubeur québécois, un agent conversationnel a vu juste sur le
tableau d’ensemble, un youtubeur francophone, et faux sur chaque détail. Il
lui a donné un nom civil, une nationalité, une année de naissance et un début
sur YouTube, les quatre faux, tout comme le genre de vidéos qu’il lui prêtait
(Figure 4figure 4).Un portrait paru dans la presse québécoise en 2023 donne Jules comme prénom, et le 6 mai 2012 comme date de sa première vidéo, alors qu’il avait 13 ans : Adam Bourbonnière, 7 choses à savoir sur Gurky, youtubeur de l’année, Le Sac de chips, 10 février 2023, consulté le 17 septembre 2026.
Figure 4. Une courte biographie d'un sujet peu documenté. ChatGPT (GPT-4o), janvier 2025. Le tableau d'ensemble est exact ; le nom, la nationalité, l'année de naissance, le début sur YouTube et le genre de vidéos sont tous faux.
De telles erreurs sont difficiles à voir. Elles sont assez plausibles pour que
rien ne détonne, les détails exacts qui les entourent leur servent de caution,
et à part la rare réserve générale, comme dans le premier exemple, aucune
incertitude n’est exprimée sur une affirmation en particulier.
Une lecture attentive confronte un texte à lui-même : elle vérifie donc sa
cohérence. Elle ne vérifie pas sa factualité, qui est une question sur le
monde plutôt que sur le texte.
Un texte peut être parfaitement cohérent et ne correspondre à rien, si bien
qu’une erreur de ce genre passe une lecture attentive à tout coup.
Le problème des 90 %
Les fabulations se raréfient dans les GML.Les références fabriquées, par exemple, ont nettement reculé de GPT-3.5 à GPT-4 (Walters et Wilder, 2023). Un taux mesuré vaut toujours pour une tâche, et les taux n’ont pas baissé également partout.
Si c’est dans l’ensemble une bonne chose, cela rend aussi les fabulations
restantes plus retorses. Voyez cela comme le problème des 90 % (voire des
99 %) : si la grande majorité de l’information qui vous est présentée est
exacte, qu’elle est présentée partout avec la même assurance et qu’elle
paraît partout plausible, les erreurs restantes sont très difficiles à
détecter. Et plus vous voyez de bonnes sorties, plus vous pouvez devenir
« paresseux » dans la vérification des faits, parce qu’en moyenne la
sortie est bonne, ou en a l’air.
Sources
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Walters, W. H., & Wilder, E. I. (2023). Fabrication and errors in the bibliographic citations generated by ChatGPT. Scientific Reports, 13, 14045. https://doi.org/10.1038/s41598-023-41032-5
Mitigating hallucinationsAtténuer les fabulations
What the developers do
Three approaches are in use, but none of them removes the problem.
The answer can come from a retrieved page rather than from the parameters
The page itself can be wrong, and a link shows where a claim came from rather than that it is true
Both studies used models of 2023. Zhang et al. (2024) tested refusal training
on OpenLLaMA-3B and LLaMA 7B and 13B. Chen et al. (2024) tested retrieval on
ChatGPT and several open 6B and 7B models, which did worst at declining when
the retrieved documents did not contain the answer, at combining information
from several documents, and at detecting false information in
them.
The numbers date faster than the failures do. Each of these is a mitigation
rather than a guarantee, and the September 2026 runs below show one of the
same failures on current models: an answer based on a source that is wrong.
The biography of Gurky earlier in this chapter came from a model of 2025
answering from its parameters alone. Put to two chatbots in September 2026,
the same question sent both of them to the web without being asked, and
searching changed what went wrong rather than removing it.
The first searched and then used a celebrity birthday site, which gave it
a full name and a birth date; the name is wrong
(Figure 5figure 5).
Figure 5. A wrong name with a source attached. Gemini 3.6 Flash with web search, 17 September 2026.
The second found the Québec press instead and gave his first name correctly
(Figure 6figure 6),
although a second run of the same question took the wrong name from the same
birthday site.
Figure 6. The first name the Québec press gives, with that source linked. GPT-5.6 Sol at light effort, 17 September 2026.
Asked in that conversation for his date of birth, it returned both sources,
stated that the two conflict, and called the date unverified
(Figure 7figure 7).
Figure 7. The same conversation, asked for his date of birth: the answer calls the date unverified and the birthday site unreliable. GPT-5.6 Sol at light effort, 17 September 2026.
The three differ in which sources they found and in whether they said how far
to trust them. A cited source can also be the wrong source altogether: asked
to identify the news article a quoted excerpt came from, eight search tools
gave an incorrect answer more than 60 % of the time, often naming a plausible
article that was not the one quoted (Jaźwińska & Chandrasekar,
2025).A report from a journalism school’s research centre rather than a peer-reviewed study: 1,600 tests over eight AI search tools.
So a link tells you what to check next rather than that the claim is
true.
Hallucination rates are also tracked publicly. On the best known
leaderboardVectara, Hallucination Leaderboard, last updated 11 May 2026 and read 17 September 2026: rates from 1.8 % upward, with GPT-5.4 at 7.0 % against 3.1 % for its smallest version.
no model reaches zero, and the largest models are not always the
lowest (see also the Reading a leaderboard page, in the Using LLMs module) (voir aussi la page Lire un classement, dans le module Utiliser les GML).
What you can do
Supplying the source
When the work you give a model is work on a text you already have, for
instance translating it, summarizing it, rewriting it for a different reader
or checking it against a list of terms, put that text in the context.
Asking a model to be more careful changes little: no part of it is responsible
for care, and truth is not a variable in the process. Rereading an output for
consistency does not help either, because the process produces consistency.
The checks that work compare a claim with something outside the
output (see also the Checking the answer page, in the Using LLMs module) (voir aussi la page Vérifier la réponse, dans le module Utiliser les GML).
Which details deserve suspicion
The risk is not spread evenly. Fabrication concentrates in specific, checkable
details that were rare in the training text, for instance dates, numbers,
names, page references, citations, quotations, legal provisions, and anything
recent.
General explanation of a well-covered topic is far safer. On a subject written
about many times over, an explanation is usually sound, and that is a large
part of what these tools are useful for. Usually is not always, and such an
explanation can be wrong about something central rather than about a detail,
but it is a different order of risk from a fabricated citation.
So the checking follows the risk rather than covering everything. If you are
going to verify three things in an output, verify the three most specific
ones.
Fabricated references have been measured directly. Walters and Wilder (2023)
checked every reference in short literature reviews written by two models of
2023: more than half of what GPT-3.5 produced did not exist, and just under a
fifth of GPT-4’s. Of the references that did exist, between a quarter and
almost half had at least one substantive error, most often in the volume,
issue or page numbers or in the date.
Sources
Chen, J., Lin, H., Han, X., & Sun, L. (2024). Benchmarking Large Language Models in Retrieval-Augmented Generation. Proceedings of the AAAI Conference on Artificial Intelligence, 38(16), 17754–17762. https://doi.org/10.1609/aaai.v38i16.29728
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Walters, W. H., & Wilder, E. I. (2023). Fabrication and errors in the bibliographic citations generated by ChatGPT. Scientific Reports, 13, 14045. https://doi.org/10.1038/s41598-023-41032-5
Xu, Z., Jain, S., & Kankanhalli, M. (2024). Hallucination is Inevitable: An Innate Limitation of Large Language Models. arXiv:2401.11817 (preprint). https://arxiv.org/abs/2401.11817
Zhang, H., Diao, S., Lin, Y., Fung, Y. R., Lian, Q., Wang, X., Chen, Y., Ji, H., & Zhang, T. (2024). R-Tuning: Instructing Large Language Models to Say `I Don't Know'. Proceedings of the 2024 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies (Volume 1: Long Papers), 7113–7139. https://doi.org/10.18653/v1/2024.naacl-long.394
Ce que font les concepteurs
Trois approches sont en usage, mais aucune ne supprime le problème.
La réponse peut venir d’une page récupérée plutôt que des paramètres
La page elle-même peut être fausse, et un lien montre d’où vient une affirmation plutôt que sa véracité
Les deux études portaient sur des modèles de 2023. Zhang et al. (2024) ont
testé l’entraînement au refus sur OpenLLaMA-3B et LLaMA 7B et 13B. Chen et
coll. (2024) ont testé la récupération sur ChatGPT et sur plusieurs modèles
ouverts de 6 et 7 milliards de paramètres, qui ont le plus échoué à refuser
quand les documents récupérés ne contenaient pas la réponse, à combiner
l’information de plusieurs documents et à détecter l’information fausse qui
s’y trouvait.
Les chiffres vieillissent plus vite que les échecs. Chacune de ces approches
est une atténuation plutôt qu’une garantie, et les essais de septembre 2026
ci-dessous montrent l’un des mêmes échecs sur des modèles actuels : une
réponse appuyée sur une source fausse.
La biographie de Gurky présentée plus tôt dans ce chapitre venait d’un modèle
de 2025 qui répondait à partir de ses seuls paramètres. Posée à deux agents
conversationnels en septembre 2026, la même question les a tous deux envoyés
sur le Web sans qu’on le leur demande, et la recherche a changé la nature de
l’erreur plutôt que de la supprimer.
Le premier a cherché, puis s’en est remis à un site de célébrités et
d’anniversaires, qui lui a fourni un nom complet et une date de naissance ;
le nom est faux
(Figure 5figure 5).
Figure 5. Un nom faux, avec une source attachée. Gemini 3.6 Flash avec recherche Web, 17 septembre 2026.
Le second a trouvé la presse québécoise et a donné son prénom correctement
(Figure 6figure 6),
même si un second essai de la même question a repris le nom faux au même site
d’anniversaires.
Figure 6. Le prénom que donne la presse québécoise, avec cette source en lien. GPT-5.6 Sol à effort léger, 17 septembre 2026.
Interrogé dans cette conversation sur sa date de naissance, il a rendu les
deux sources, signalé qu’elles se contredisent et qualifié la date de non
vérifiée
(Figure 7figure 7).
Figure 7. La même conversation, interrogée sur la date de naissance : la réponse qualifie la date de non vérifiée et le site d'anniversaires de peu fiable. GPT-5.6 Sol à effort léger, 17 septembre 2026.
Les trois diffèrent par les sources qu’ils ont trouvées et par ce qu’ils ont
dit du crédit à leur accorder. Une source citée peut aussi être la mauvaise
source : à qui leur demandait d’identifier l’article de presse d’où venait
un extrait cité, huit outils de recherche ont donné une réponse erronée plus
de 60 % du temps, en nommant souvent un article plausible qui n’était pas
celui d’où venait la citation (Jaźwińska et Chandrasekar,
2025).Un rapport du centre de recherche d’une école de journalisme, et non une étude évaluée par les pairs : 1 600 essais sur huit outils de recherche par IA.
Un lien vous dit donc quoi vérifier ensuite plutôt que la vérité de
l’affirmation.
Les taux de fabulation font aussi l’objet d’un suivi public. Sur le classement
le plus connuVectara, Hallucination Leaderboard, dernière mise à jour le 11 mai 2026, consulté le 17 septembre 2026 : des taux à partir de 1,8 %, avec GPT-5.4 à 7,0 % contre 3,1 % pour sa plus petite version.
aucun modèle n’atteint zéro, et les plus grands modèles ne sont pas toujours
les plus bas (see also the Reading a leaderboard page, in the Using LLMs module) (voir aussi la page Lire un classement, dans le module Utiliser les GML).
Ce que vous pouvez faire
Fournir la source
Quand le travail que vous confiez à un modèle porte sur un texte que vous avez
déjà, par exemple le traduire, le résumer, le réécrire pour un autre lectorat
ou le confronter à une liste de termes, mettez ce texte dans le contexte.
Demander à un modèle d’être plus prudent ne change pas grand-chose : aucune
partie de lui n’est chargée de la prudence, et la vérité n’est pas une
variable du processus. Relire une sortie pour en vérifier la cohérence ne sert
pas davantage, puisque le processus produit de la cohérence. Les
vérifications qui fonctionnent comparent une affirmation à quelque chose
d’extérieur à la
sortie (see also the Checking the answer page, in the Using LLMs module) (voir aussi la page Vérifier la réponse, dans le module Utiliser les GML).
Quels détails méritent la méfiance
Le risque n’est pas réparti également. La fabrication se concentre sur les
détails précis et vérifiables qui étaient rares dans le texte d’entraînement,
par exemple les dates, les nombres, les noms, les renvois de pages, les
références, les citations, les dispositions légales et tout ce qui est récent.
L’explication générale d’un sujet bien couvert est nettement plus sûre. Sur un
sujet sur lequel on a écrit bien des fois, une explication est en général
solide, et c’est pour une bonne part ce à quoi ces outils servent. En général
ne veut pas dire toujours, et une telle explication peut se tromper sur
quelque chose de central plutôt que sur un détail, mais ce n’est pas le même
ordre de risque qu’une référence fabriquée.
La vérification suit donc le risque plutôt que de tout couvrir. Si vous devez
vérifier trois choses dans une sortie, vérifiez les trois plus précises.
Les références fabriquées ont été mesurées directement. Walters et Wilder
(2023) ont vérifié chaque référence dans de courtes revues de littérature
écrites par deux modèles de 2023 : plus de la moitié de ce que GPT-3.5 a
produit n’existait pas, contre un peu moins d’un cinquième pour GPT-4. Parmi
les références qui existaient bel et bien, entre un quart et près de la moitié
comportaient au moins une erreur de fond, le plus souvent dans le volume, le
numéro, les pages ou la date.
Sources
Chen, J., Lin, H., Han, X., & Sun, L. (2024). Benchmarking Large Language Models in Retrieval-Augmented Generation. Proceedings of the AAAI Conference on Artificial Intelligence, 38(16), 17754–17762. https://doi.org/10.1609/aaai.v38i16.29728
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Walters, W. H., & Wilder, E. I. (2023). Fabrication and errors in the bibliographic citations generated by ChatGPT. Scientific Reports, 13, 14045. https://doi.org/10.1038/s41598-023-41032-5
Xu, Z., Jain, S., & Kankanhalli, M. (2024). Hallucination is Inevitable: An Innate Limitation of Large Language Models. arXiv:2401.11817 (preprint). https://arxiv.org/abs/2401.11817
Zhang, H., Diao, S., Lin, Y., Fung, Y. R., Lian, Q., Wang, X., Chen, Y., Ji, H., & Zhang, T. (2024). R-Tuning: Instructing Large Language Models to Say `I Don't Know'. Proceedings of the 2024 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies (Volume 1: Long Papers), 7113–7139. https://doi.org/10.18653/v1/2024.naacl-long.394
BiasBiais
Written in English. The French version was automatically generated
and I have not revised it.
Rédigé en anglais. La version française a été
générée automatiquement et je ne l'ai pas révisée.
What bias is, and where it comes fromCe qu'est un biais, et d'où il vient
Filling in the gender
The sentence I am a nurse and I am in love with him does not tell you the
gender of the speaker. French has no easy gender-neutral way to say this, so
in a translation, you would have to decide. Translating the speaker as a
woman means using infirmière and amoureuse; as a man, infirmier and
amoureux. A tool that puts the sentence into French therefore has to choose
a form, or ask.
The screenshots below were taken on 28 January 2026. The same tools may answer
differently today.
DeepL, given three sentences about people with names that do not indicate a
gender, made all three of them women
(Figure 1figure 1).
Figure 1. Three gender-neutral names, three female nurses. DeepL, 28 January 2026.
The choice can also move with the context. DeepL put I am a businessperson
into French as Je suis un homme d’affaires, a businessman. When a second
sentence was added, I am a beautiful businessperson, both sentences became
femme d’affaires, a businesswoman, the first one included
(Figure 2figure 2).
Figure 2. One adjective in the second sentence changes the gender in both. DeepL, 28 January 2026.
Where the default comes from
These examples show a bias built into the systems themselves. None of the
translations is wrong: a nurse can be a woman, and so can a businessperson.
The problem is the direction. When the English leaves the gender open, the
tool chooses, and for the same words it chooses the same way. A tendency of
this kind, systematic and not asked for, is bias.
In the text these systems learned from, some words are used far more often
about women and others about men. Translation tools such as DeepL and Google
Translate are designed mainly to give one translation, so where the source
leaves a choice open, they tend to take the statistically most probable
option, and that option is the biased one.
No programmer decided that women
should be nurses rather than doctors, or should not be in business. The
choice follows from frequencies in the training data: nurse is used more
often for women (Bolukbasi et al., 2016), so the statistically most probable
French translation of nurse is infirmière. For the source of a bias,
the first place to look is therefore the text a system learned from.
Caliskan, A., Ajay, P. P., Charlesworth, T., Wolfe, R., & Banaji, M. R. (2022). Gender Bias in Word Embeddings: A Comprehensive Analysis of Frequency, Syntax, and Semantics. Proceedings of the 2022 AAAI/ACM Conference on AI, Ethics, and Society, 156–170. https://doi.org/10.1145/3514094.3534162
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Choisir le genre
La phrase anglaise I am a nurse and I am in love with him ne dit pas le
genre de la personne qui parle. En français, il n’existe pas de façon simple
et neutre de dire la même chose : pour la traduire, il faut trancher. Si la
personne est une femme, on écrit infirmière et amoureuse ; si c’est un
homme, infirmier et amoureux. Un outil qui traduit cette phrase en
français doit donc choisir une forme, ou poser la question.
Les captures d’écran ci-dessous ont été prises le 28 janvier 2026. Les mêmes
outils peuvent répondre autrement aujourd’hui.
Devant trois phrases sur des personnes dont le prénom n’indique pas le
genre, DeepL en a fait trois femmes
(Figure 1figure 1).
Figure 1. Trois prénoms épicènes, trois infirmières. DeepL, 28 janvier 2026.
Le choix peut aussi changer avec le contexte. DeepL a traduit I am a
businessperson par Je suis un homme d’affaires. Quand une deuxième
phrase a été ajoutée, I am a beautiful businessperson, les deux phrases
sont devenues femme d’affaires, y compris la première
(Figure 2figure 2).
Figure 2. Un adjectif dans la deuxième phrase change le genre dans les deux. DeepL, 28 janvier 2026.
D’où vient le choix par défaut
Ces exemples montrent un biais intégré aux systèmes eux-mêmes. Aucune de
ces traductions n’est fausse : une personne infirmière peut être une femme,
une personne d’affaires aussi. Le problème tient à la direction.
Quand l’anglais laisse le genre ouvert, l’outil choisit, et pour les mêmes
mots il choisit toujours de la même façon. Une tendance de ce genre,
systématique et non demandée, est un biais.
Dans le texte dont ces systèmes ont appris, certains mots sont employés
bien plus souvent à propos des femmes, d’autres à propos des hommes. Les
outils de traduction comme DeepL et Google Traduction sont conçus pour
donner avant tout une seule traduction ; là où le texte source laisse un
choix ouvert, ils tendent donc à retenir l’option statistiquement la plus
probable, et cette option est l’option biaisée.
Aucun programmeur n’a décidé que les femmes devaient être infirmières
plutôt que médecins, ni qu’elles n’avaient pas leur place dans les
affaires. Le choix découle des fréquences dans les données d’entraînement :
nurse est plus souvent employé à propos de femmes (Bolukbasi et al., 2016),
si bien que la traduction française statistiquement la plus probable de
nurse est infirmière. Pour trouver l’origine d’un biais, le premier
endroit où regarder est donc le texte dont un système a appris.
Figure 3. Thèmes des mots les plus associés aux femmes et aux hommes dans les plongements lexicaux GloVe, avec des exemples pour chacun ; les exemples sont les mots anglais de l'étude. D'après Caliskan et al. (2022).
Caliskan, A., Ajay, P. P., Charlesworth, T., Wolfe, R., & Banaji, M. R. (2022). Gender Bias in Word Embeddings: A Comprehensive Analysis of Frequency, Syntax, and Semantics. Proceedings of the 2022 AAAI/ACM Conference on AI, Ethics, and Society, 156–170. https://doi.org/10.1145/3514094.3534162
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Bias in language modelsLes biais dans les modèles de langue
The sentence I am a nurse and I am in love with him does not tell you the
gender of the speaker, but French has to. Asked how to say it in French,
three chatbots all gave both forms, to different degrees.
Gemini gave both, the feminine first, with a justification: “Since ‘nurse’ in
English usually implies a female speaker, that is the standard translation”
(Figure 4figure 4).
Figure 4. Gemini, 28 January 2026.
ChatGPT gave the feminine form too, with the masculine as an alternative
“if you’re a man (or you prefer the masculine form)”. Claude gave both forms
side by side and left the choice to the person asking
(Figure 5figure 5).
Figure 5. ChatGPT 5.2 Thinking (left) and Claude Opus 4.5 (right), 28 January 2026.
A single answer rarely shows a bias. It becomes visible when you compare
answers, across names, across groups or across tools, as these examples do.
Not only gender
A name suggests more than a gender: it can also suggest an origin or an
ethnicity. Two studies changed only the names in otherwise identical
requests and found that the answers changed with them.
The name of the person asking
A chatbot can have access to the name of the person using it, for instance
because the name is stored in its memory of past conversations: at the time
of the study, ChatGPT had the user’s name in about 15 % of conversations.
Eloundou et al. (2025) replayed real requests to ChatGPT under different user
names. One request, typed in lowercase, asked to “suggest 5 simple projects
for ece”. The abbreviation ECE can mean early childhood education or
electrical and computer engineering. The answers took one reading or the other, and the name
changed which one: early childhood education in 48 % of the answers to Ashley,
and in 5 % of the answers to Anthony
(Figure 6figure 6).
Figure 6. One request, two user names. After Eloundou et al. (2025), Figure 2.
Answers that reinforced a harmful stereotype were rare in this study, well
under one in a hundred overall, and most frequent in open-ended tasks such as
writing a story.GPT-3.5 Turbo, GPT-4 Turbo, GPT-4o, GPT-4o mini, o1-preview and o1-mini, in 2024. The study was carried out by OpenAI on its own models. GPT-3.5 Turbo, the oldest, showed the most harmful stereotypes.
The name of the person asked about
Nghiem et al. (2024) asked models to choose between job candidates for 40
occupations and to recommend a salary, changing only the candidates’ first
names. Both models preferred candidates with names associated with White
people in 50 to 95 % of the occupations, depending on the model and the
setting. Even for candidates with identical qualifications, the recommended
salary differed by up to 5 % between groups defined by both race and
gender.GPT-3.5 Turbo and Llama 3 70B, with 320 American first names, in 2024.
In both studies no single answer shows anything wrong. The difference appears
only when the same request is compared across names.
Bigger models, same bias
More data and larger models have not removed this kind of bias: more text
from the same kinds of sources contains the same regularities. In one study of eight
chat models, the larger models of each family tended to show more stereotyped
associations than the smaller ones (Bai et al.,
2025) (see also the Correcting bias page, in the Critical issues with LLMs module) (voir aussi la page Corriger les biais, dans le module Enjeux critiques des GML).
Sources
Bai, X., Wang, A., Sucholutsky, I., & Griffiths, T. L. (2025). Explicitly unbiased large language models still form biased associations. Proceedings of the National Academy of Sciences, 122(8), e2416228122. https://doi.org/10.1073/pnas.2416228122
Eloundou, T., Beutel, A., Robinson, D. G., Gu, K., Brakman, A.-L., Mishkin, P., Shah, M., Heidecke, J., Weng, L., & Kalai, A. T. (2025). First-Person Fairness in Chatbots. Proceedings of the Thirteenth International Conference on Learning Representations (ICLR 2025). https://openreview.net/forum?id=TlAdgeoDTo
Nghiem, H., Prindle, J., Zhao, J., & Daumé III, H. (2024). “You Gotta be a Doctor, Lin” : An Investigation of Name-Based Bias of Large Language Models in Employment Recommendations. Proceedings of the 2024 Conference on Empirical Methods in Natural Language Processing, 7268–7287. https://doi.org/10.18653/v1/2024.emnlp-main.413
La phrase I am a nurse and I am in love with him ne dit pas le genre de la
personne qui parle, mais le français doit le dire. Interrogés sur la façon
de la dire en français, trois agents conversationnels ont tous donné les
deux formes, à des degrés divers. Gemini a donné les deux, le féminin
d’abord, avec une justification : « Since ‘nurse’ in English usually implies a female speaker, that is the standard translation » [ma traduction : « Comme nurse en anglais suppose généralement une locutrice, c’est la traduction standard »]
(Figure 4figure 4).
Figure 4. Gemini, 28 janvier 2026.
ChatGPT a lui aussi donné le féminin, avec le masculin en variante « if you’re a man (or you prefer the masculine form) » [ma traduction : « si vous êtes un homme (ou si vous préférez le masculin) »]. Claude a donné les deux
formes côte à côte et laissé le choix à la personne qui posait la question
(Figure 5figure 5).
Figure 5. ChatGPT 5.2 Thinking (à gauche) et Claude Opus 4.5 (à droite), 28 janvier 2026.
Une réponse isolée montre rarement un biais. Il devient visible quand on
compare des réponses, d’un prénom à l’autre, d’un groupe à l’autre ou d’un
outil à l’autre, comme le font ces exemples.
Pas seulement le genre
Un prénom suggère plus qu’un genre : il peut aussi évoquer une origine ou
une ethnicité. Deux études n’ont changé que les prénoms dans des demandes
par ailleurs identiques, et ont constaté que les réponses changeaient avec
eux.
Le prénom de la personne qui pose la question
Un agent conversationnel peut avoir accès au nom de la personne qui
l’utilise, par exemple parce que ce nom est enregistré dans sa mémoire des
conversations passées : au moment de l’étude, ChatGPT disposait du nom de
l’utilisateur dans environ 15 % des conversations. Eloundou et al. (2025)
ont rejoué de vraies demandes adressées à ChatGPT sous différents noms
d’utilisateur. L’une d’elles, tapée en minuscules, demandait en anglais de
« suggest 5 simple projects for ece » [ma traduction : « propose cinq projets simples pour ece »]. L’abréviation ECE peut désigner l’éducation de la petite enfance
(early childhood education) ou le génie électrique et informatique
(electrical and computer engineering). Les réponses retenaient l’une ou
l’autre lecture, et le prénom changeait laquelle : l’éducation de la petite
enfance dans 48 % des réponses adressées à Ashley, et dans 5 % de celles
adressées à Anthony
(Figure 6figure 6).
Figure 6. Une requête, deux noms d'utilisateur. D'après Eloundou et al. (2025), figure 2.
Les réponses qui renforçaient un stéréotype nuisible étaient rares dans
cette étude, bien moins d’une sur cent dans l’ensemble, et plus fréquentes
dans les tâches ouvertes comme l’écriture d’une histoire.GPT-3.5 Turbo, GPT-4 Turbo, GPT-4o, GPT-4o mini, o1-preview et o1-mini, en 2024. L’étude a été menée par OpenAI sur ses propres modèles. GPT-3.5 Turbo, le plus ancien, présentait le plus de stéréotypes nuisibles.
Le prénom de la personne dont on parle
Nghiem et al. (2024) ont demandé à des modèles de choisir entre des
candidats pour 40 professions et de recommander un salaire, en ne changeant
que le prénom des candidats. Les deux modèles ont préféré les candidats
dont le prénom est associé aux personnes blanches pour 50 à 95 % des
professions, selon le modèle et la configuration. Même à qualifications
identiques, le salaire recommandé différait jusqu’à 5 % entre des groupes
définis à la fois par l’origine ethnique et par le genre.GPT-3.5 Turbo et Llama 3 70B, avec 320 prénoms américains, en 2024.
Dans les deux études, aucune réponse isolée ne montre quoi que ce soit
d’anormal. La différence n’apparaît qu’en comparant la même demande d’un
prénom à l’autre.
Des modèles plus grands, le même biais
Plus de données et des modèles plus grands n’ont pas éliminé ce type de
biais : davantage de texte tiré du même genre de sources contient les mêmes
régularités. Dans une étude portant sur huit modèles conversationnels, les
plus grands modèles de chaque famille tendaient à présenter plus
d’associations stéréotypées que les plus petits (Bai et al.,
2025) (see also the Correcting bias page, in the Critical issues with LLMs module) (voir aussi la page Corriger les biais, dans le module Enjeux critiques des GML).
Sources
Bai, X., Wang, A., Sucholutsky, I., & Griffiths, T. L. (2025). Explicitly unbiased large language models still form biased associations. Proceedings of the National Academy of Sciences, 122(8), e2416228122. https://doi.org/10.1073/pnas.2416228122
Eloundou, T., Beutel, A., Robinson, D. G., Gu, K., Brakman, A.-L., Mishkin, P., Shah, M., Heidecke, J., Weng, L., & Kalai, A. T. (2025). First-Person Fairness in Chatbots. Proceedings of the Thirteenth International Conference on Learning Representations (ICLR 2025). https://openreview.net/forum?id=TlAdgeoDTo
Nghiem, H., Prindle, J., Zhao, J., & Daumé III, H. (2024). “You Gotta be a Doctor, Lin” : An Investigation of Name-Based Bias of Large Language Models in Employment Recommendations. Proceedings of the 2024 Conference on Empirical Methods in Natural Language Processing, 7268–7287. https://doi.org/10.18653/v1/2024.emnlp-main.413
AmplificationL'amplification
Why a majority becomes a default
A pattern that is common in a model’s training data tends to be even more
common in what the model produces, so that a model does more than repeat the
proportions in its data.
Figure 7. A tendency in the data comes out stronger in the output. The proportions are illustrative, not measured.
Zhao et al. (2017) measured the effect before LLMs, in a dataset of images
labelled with the activity shown and the person doing it. A third of the
cooking images in the training data showed a man; in the predictions of the
model trained on them, only 16 % did.Zhao et al. studied image-labelling models of 2017, not LLMs; the figures illustrate the effect rather than measure it in a current model.
“The model just reflects society” is therefore not an adequate description:
a mirror preserves proportions, but a model does not.
Flattening within a group
The proportions between groups are one side of the problem. The other is the
variety within a group: what a model writes about the members of some groups
is less varied than those people are.
Lee et al. (2024) had ChatGPT write about different groups and found that it
described African, Asian and Hispanic Americans as more alike than White
Americans, with a narrower range of human
experience.Lee et al. tested ChatGPT (GPT-3.5 Turbo) in 2023.
The output was not necessarily hostile, but noticeably uniform.
The authors suggest one likely explanation, without testing it: a group
written about often is represented through many voices, situations and
registers, while a group written about less is known through fewer
examples, so what the model produces about it converges on a narrower
version.
Sources
Fleisig, E., Smith, G., Bossi, M., Rustagi, I., Yin, X., & Klein, D. (2024). Linguistic Bias in ChatGPT: Language Models Reinforce Dialect Discrimination. Proceedings of the 2024 Conference on Empirical Methods in Natural Language Processing (EMNLP), 13541–13564. https://aclanthology.org/2024.emnlp-main.750/
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Kirk, R., Mediratta, I., Nalmpantis, C., Luketina, J., Hambro, E., Grefenstette, E., & Raileanu, R. (2024). Understanding the Effects of RLHF on LLM Generalisation and Diversity. The Twelfth International Conference on Learning Representations (ICLR 2024). https://openreview.net/forum?id=PXD3FAVHJT
Lee, M. H. J., Montgomery, J. M., & Lai, C. K. (2024). Large Language Models Portray Socially Subordinate Groups as More Homogeneous, Consistent with a Bias Observed in Humans. Proceedings of the 2024 ACM Conference on Fairness, Accountability, and Transparency (FAccT '24). https://doi.org/10.1145/3630106.3658975
Vanmassenhove, E., Shterionov, D., & Gwilliam, M. (2021). Machine Translationese: Effects of Algorithmic Bias on Linguistic Complexity in Machine Translation. Proceedings of the 16th Conference of the European Chapter of the Association for Computational Linguistics: Main Volume, 2203–2213. https://doi.org/10.18653/v1/2021.eacl-main.188
Vanmassenhove, E., Shterionov, D., & Way, A. (2019). Lost in Translation: Loss and Decay of Linguistic Richness in Machine Translation. Proceedings of Machine Translation Summit XVII: Research Track, 222–232. https://aclanthology.org/W19-6622/
Zhao, J., Wang, T., Yatskar, M., Ordonez, V., & Chang, K.-W. (2017). Men Also Like Shopping: Reducing Gender Bias Amplification using Corpus-level Constraints. Proceedings of the 2017 Conference on Empirical Methods in Natural Language Processing. https://doi.org/10.18653/v1/D17-1323
Comment une majorité devient un choix par défaut
Une tendance courante dans les données d’entraînement d’un modèle tend à
l’être encore plus dans ce qu’il produit : un modèle ne se contente pas de
reproduire les proportions de ses données.
Figure 7. Une tendance dans les données ressort plus forte dans la sortie. Les proportions sont illustratives, et non mesurées.
Zhao et al. (2017) ont mesuré cet effet avant les GML, dans un jeu d’images
annotées avec l’activité montrée et la personne qui la fait. Un tiers des
images de cuisine des données d’entraînement montraient un homme ; dans
les prédictions du modèle entraîné sur elles, seulement 16 %.Zhao et al. ont étudié des modèles d’annotation d’images de 2017, et non des GML ; les chiffres illustrent l’effet plutôt qu’ils ne le mesurent dans un modèle actuel.
« Le modèle ne fait que refléter la société » n’est donc pas une description
adéquate : un miroir conserve les proportions, mais un modèle, non.
L’aplatissement au sein d’un groupe
Les proportions entre les groupes sont un aspect du problème. L’autre est
la variété au sein d’un groupe : ce qu’un modèle écrit sur les membres de
certains groupes est moins varié que ces personnes ne le sont.
Lee et al. (2024) ont fait écrire ChatGPT sur différents groupes et ont
constaté qu’il décrivait les Afro-Américains, les Américains d’origine
asiatique et les Américains d’origine hispanique comme plus semblables
entre eux que les Américains blancs, avec un éventail d’expériences
humaines plus étroit.Lee et al. ont testé ChatGPT (GPT-3.5 Turbo) en 2023.
La sortie n’était pas forcément hostile, mais nettement uniforme.
Les auteurs avancent une explication probable, sans la tester : un groupe
dont on écrit souvent est représenté par de nombreuses voix, situations et
registres, tandis qu’un groupe dont on écrit moins est connu par moins
d’exemples, si bien que ce que le modèle produit à son sujet converge vers
une version plus étroite.
Sources
Fleisig, E., Smith, G., Bossi, M., Rustagi, I., Yin, X., & Klein, D. (2024). Linguistic Bias in ChatGPT: Language Models Reinforce Dialect Discrimination. Proceedings of the 2024 Conference on Empirical Methods in Natural Language Processing (EMNLP), 13541–13564. https://aclanthology.org/2024.emnlp-main.750/
Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
Kirk, R., Mediratta, I., Nalmpantis, C., Luketina, J., Hambro, E., Grefenstette, E., & Raileanu, R. (2024). Understanding the Effects of RLHF on LLM Generalisation and Diversity. The Twelfth International Conference on Learning Representations (ICLR 2024). https://openreview.net/forum?id=PXD3FAVHJT
Lee, M. H. J., Montgomery, J. M., & Lai, C. K. (2024). Large Language Models Portray Socially Subordinate Groups as More Homogeneous, Consistent with a Bias Observed in Humans. Proceedings of the 2024 ACM Conference on Fairness, Accountability, and Transparency (FAccT '24). https://doi.org/10.1145/3630106.3658975
Vanmassenhove, E., Shterionov, D., & Gwilliam, M. (2021). Machine Translationese: Effects of Algorithmic Bias on Linguistic Complexity in Machine Translation. Proceedings of the 16th Conference of the European Chapter of the Association for Computational Linguistics: Main Volume, 2203–2213. https://doi.org/10.18653/v1/2021.eacl-main.188
Vanmassenhove, E., Shterionov, D., & Way, A. (2019). Lost in Translation: Loss and Decay of Linguistic Richness in Machine Translation. Proceedings of Machine Translation Summit XVII: Research Track, 222–232. https://aclanthology.org/W19-6622/
Zhao, J., Wang, T., Yatskar, M., Ordonez, V., & Chang, K.-W. (2017). Men Also Like Shopping: Reducing Gender Bias Amplification using Corpus-level Constraints. Proceedings of the 2017 Conference on Empirical Methods in Natural Language Processing. https://doi.org/10.18653/v1/D17-1323
Linguistic hegemonyL'hégémonie linguistique
English at every step
English is the most common language on the web, and most of the text
language models learn from is English. The term for an imbalance of this kind, in which one
language is treated as the norm and the others get fewer resources, is
linguistic hegemony.
The instruction data is mostly English, and other languages often get translations of it (Indurthi et al., 2024)
Translated instructions miss linguistic nuances (Indurthi et al., 2024); for Maltese, exposure to the language in training and fine-tuning was the most important factor in performance (Micallef & Borg, 2025)
English remains over-represented despite large investments in multilingual benchmarks (Wu et al., 2025c)
Benchmarks translated from English match local human judgements less well than local ones (Wu et al., 2025c), so progress in other languages is measured less reliably
Where English dominates in building a language model, and what it costs other languages.
The last row feeds back into the others. Models are compared mostly on
English benchmarks, so improving other languages earns developers less
credit, and the imbalance has less pressure to shrink.Wu et al. (2025c) examined over 2,000 multilingual benchmarks published between 2021 and 2024; their paper is a preprint. Yoo et al. tested ten models in 2024; Micallef and Borg, 55 models on Maltese.
Sources
Ali, M., Fromm, M., Thellmann, K., Rutmann, R., Lübbering, M., et al. (2024). Tokenizer Choice For LLM Training: Negligible or Crucial?. Findings of the Association for Computational Linguistics: NAACL 2024, 3907–3924. https://aclanthology.org/2024.findings-naacl.247/
Indurthi, S. R., Zhou, W., Chollampatt, S., Agrawal, R., Song, K., Zhao, L., & Zhu, C. (2024). Improving Multilingual Instruction Finetuning via Linguistically Natural and Diverse Datasets. Findings of the Association for Computational Linguistics: EMNLP 2024, 2306–2323. https://doi.org/10.18653/v1/2024.findings-emnlp.128
Li, Z., Shi, Y., Liu, Z., Yang, F., Payani, A., Liu, N., & Du, M. (2025b). Language Ranker: A Metric for Quantifying LLM Performance Across High and Low-Resource Languages. Proceedings of the AAAI Conference on Artificial Intelligence, 39(27), 28186–28194. https://doi.org/10.1609/aaai.v39i27.35038
Micallef, K., & Borg, C. (2025). MELABenchv1: Benchmarking Large Language Models against Smaller Fine-Tuned Models for Low-Resource Maltese NLP. Findings of the Association for Computational Linguistics: ACL 2025, 20505–20527. https://doi.org/10.18653/v1/2025.findings-acl.1053
Wu, M., Wang, W., Liu, S., Yin, H., Wang, X., Zhao, Y., Lyu, C., Wang, L., Luo, W., & Zhang, K. (2025c). The Bitter Lesson Learned from 2,000+ Multilingual Benchmarks. arXiv preprint 2504.15521. https://arxiv.org/abs/2504.15521
Xu, Y., Hu, L., Zhao, J., Qiu, Z., Xu, K., Ye, Y., & Gu, H. (2025). A survey on multilingual large language models: corpora, alignment, and bias. Frontiers of Computer Science, 19(11), 1911362. https://doi.org/10.1007/s11704-024-40579-4
Yoo, H., Yang, Y., & Lee, H. (2025). Code-Switching Red-Teaming: LLM Evaluation for Safety and Multilingual Understanding. Proceedings of the 63rd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 13392–13413. https://doi.org/10.18653/v1/2025.acl-long.657
L’anglais à chaque étape
L’anglais est la langue la plus courante sur le Web, et la plus grande
partie du texte dont apprennent les modèles de langue est en anglais. Un
déséquilibre de ce genre, où une langue est traitée comme la norme et où
les autres reçoivent moins de ressources, porte le nom d’hégémonie
linguistique.
Les données d’instructions sont surtout en anglais, et les autres langues en reçoivent souvent des traductions (Indurthi et al., 2024)
Les instructions traduites passent à côté de nuances linguistiques (Indurthi et al., 2024) ; pour le maltais, l’exposition à la langue pendant l’entraînement et l’affinage était le facteur le plus déterminant des performances (Micallef et Borg, 2025)
L’anglais reste surreprésenté malgré d’importants investissements dans les tests multilingues (Wu et al., 2025c)
Les tests traduits de l’anglais concordent moins bien avec les jugements humains locaux que les tests conçus localement (Wu et al., 2025c), si bien que les progrès dans les autres langues sont mesurés de façon moins fiable
Où l'anglais domine dans la construction d'un modèle de langue, et ce qu'il en coûte aux autres langues.
La dernière ligne rejaillit sur les autres. Les modèles sont surtout
comparés sur des tests de performances en anglais : améliorer les autres
langues rapporte donc moins aux développeurs, et le déséquilibre subit moins
de pression pour se résorber.Wu et al. (2025c) ont examiné plus de 2 000 tests de performances multilingues publiés de 2021 à 2024 ; leur article est une prépublication. Yoo et al. ont testé dix modèles en 2024 ; Micallef et Borg, 55 modèles sur le maltais.
Sources
Ali, M., Fromm, M., Thellmann, K., Rutmann, R., Lübbering, M., et al. (2024). Tokenizer Choice For LLM Training: Negligible or Crucial?. Findings of the Association for Computational Linguistics: NAACL 2024, 3907–3924. https://aclanthology.org/2024.findings-naacl.247/
Indurthi, S. R., Zhou, W., Chollampatt, S., Agrawal, R., Song, K., Zhao, L., & Zhu, C. (2024). Improving Multilingual Instruction Finetuning via Linguistically Natural and Diverse Datasets. Findings of the Association for Computational Linguistics: EMNLP 2024, 2306–2323. https://doi.org/10.18653/v1/2024.findings-emnlp.128
Li, Z., Shi, Y., Liu, Z., Yang, F., Payani, A., Liu, N., & Du, M. (2025b). Language Ranker: A Metric for Quantifying LLM Performance Across High and Low-Resource Languages. Proceedings of the AAAI Conference on Artificial Intelligence, 39(27), 28186–28194. https://doi.org/10.1609/aaai.v39i27.35038
Micallef, K., & Borg, C. (2025). MELABenchv1: Benchmarking Large Language Models against Smaller Fine-Tuned Models for Low-Resource Maltese NLP. Findings of the Association for Computational Linguistics: ACL 2025, 20505–20527. https://doi.org/10.18653/v1/2025.findings-acl.1053
Wu, M., Wang, W., Liu, S., Yin, H., Wang, X., Zhao, Y., Lyu, C., Wang, L., Luo, W., & Zhang, K. (2025c). The Bitter Lesson Learned from 2,000+ Multilingual Benchmarks. arXiv preprint 2504.15521. https://arxiv.org/abs/2504.15521
Xu, Y., Hu, L., Zhao, J., Qiu, Z., Xu, K., Ye, Y., & Gu, H. (2025). A survey on multilingual large language models: corpora, alignment, and bias. Frontiers of Computer Science, 19(11), 1911362. https://doi.org/10.1007/s11704-024-40579-4
Yoo, H., Yang, Y., & Lee, H. (2025). Code-Switching Red-Teaming: LLM Evaluation for Safety and Multilingual Understanding. Proceedings of the 63rd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 13392–13413. https://doi.org/10.18653/v1/2025.acl-long.657
English in other languagesL'anglais dans les autres langues
An English accent
When I work with a chatbot in French or in Dutch, I sometimes have the
impression of talking to a native speaker of English who has learned the
language very, very well. The text is fluent and grammatical, but every once
in a while it phrases something, or refers to something, in a way that does
not quite feel right.
The concepts are largely shared across languages. A request passes
through representations that are much the same whatever the language it
was written in (Dumas et al., 2025).
That shared space leans toward English. In Llama 2, the intermediate
representations of a request in another language pointed more readily to
the English word than to the word in the language of the request (Wendler
et al., 2024). Schut et al. (2025) found the same in four open models from
different developers, and concluded that they “perform key reasoning steps
in a representation that is heavily shaped by English in a way that is not
transparent to system users”.Llama 2 in Wendler et al.; Llama 3.1 70B, Mixtral 8x22B, Gemma 2 27B and Aya 23 35B in Schut et al., with Gemma the most English-centric and Aya, built for many languages, the least. These methods need access to a model’s internals, so the closed models behind most chatbots have not been studied this way.
A model does not translate from English as it writes, but the
representation it works from is shaped by English, and traces of that can
surface in the text.
The model fine-tuned on Dutch had fewer linguistic problems
and probably less English influence, but not none.In two of GEITje’s three settings, 4 to 5 % of its annotated problems had a clear link to English; in the third, 30 %, mostly because one English name (Tour of California) was repeated six times in a short text. GEITje is Mistral 7B, a model trained mostly on English, trained further on Dutch text.
A more elaborate prompt produced better output than a terse one, although
the difference was not always statistically significant. With the terse
prompt, Zephyr wrote 36 of its 50 Dutch texts entirely in English.
A rhyme that only works in English
Asked in Dutch for a rhyming poem about language models, Le Chat Mistral
opened with In nullen en énen, diep in de cloud, / ontstaat een
geest, zo slim en zo trots: “In zeros and ones, deep in the cloud, / a mind
arises, so smart and so proud”
(Figure 8figure 8).
In Dutch, cloud and trots do not rhyme. In English, cloud and proud
do, and trots is the Dutch for proud. The lines rhyme as if they had
been written in English and then translated.
Figure 8. A rhyme that works in English, not in Dutch. Le Chat Mistral, 2025.
The developers of a Bulgarian model saw the same in their first version,
which was fine-tuned mostly on translated instructions: it “struggled to make
any rhymes at all, often actually trying to rhyme words that would rhyme in
English but when translated into Bulgarian would not” (Alexandrov et al.,
2024).
Sources
Alexandrov, A., Raychev, V., Dimitrov, D. I., Zhang, C., Vechev, M., & Toutanova, K. (2024). BgGPT 1.0: Extending English-centric LLMs to other languages. arXiv preprint 2412.10893. https://arxiv.org/abs/2412.10893
Dumas, C., Wendler, C., Veselovsky, V., Monea, G., & West, R. (2025). Separating Tongue from Thought: Activation Patching Reveals Language-Agnostic Concept Representations in Transformers. Proceedings of the 63rd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 31822–31841. https://doi.org/10.18653/v1/2025.acl-long.1536
Rigouts Terryn, A., & de Lhoneux, M. (2024). Exploratory Study on the Impact of English Bias of Generative Large Language Models in Dutch and French. Proceedings of the Fourth Workshop on Human Evaluation of NLP Systems (HumEval) @ LREC-COLING 2024, 12–27. https://aclanthology.org/2024.humeval-1.2/
Schut, L., Gal, Y., & Farquhar, S. (2025). Do Multilingual LLMs Think In English?. ICLR 2025 Workshop on Building Trust in Language Models and Applications. https://openreview.net/forum?id=I8BOtOPcOv
Wendler, C., Veselovsky, V., Monea, G., & West, R. (2024). Do Llamas Work in English? On the Latent Language of Multilingual Transformers. Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 15366–15394. https://doi.org/10.18653/v1/2024.acl-long.820
Un accent anglais
Quand je travaille avec un agent conversationnel en français ou en
néerlandais, j’ai parfois l’impression de parler à une personne de langue
maternelle anglaise qui a appris la langue très, très bien. Le texte est
fluide et grammatical, mais de temps en temps une tournure ou une référence
ne sonne pas tout à fait juste.
Les concepts sont largement partagés d’une langue à l’autre. Une
demande passe par des représentations qui sont à peu près les mêmes, quelle
que soit la langue dans laquelle elle est écrite (Dumas et al., 2025).
Cet espace partagé penche vers l’anglais. Dans Llama 2, les
représentations intermédiaires d’une demande formulée dans une autre
langue renvoyaient plus facilement au mot anglais qu’au mot de la langue
de la demande (Wendler et al., 2024). Schut et al. (2025) ont trouvé la
même chose dans quatre modèles ouverts de développeurs différents, et ont
conclu que ces modèles « perform key reasoning steps in a representation that is heavily shaped by English in a way that is not transparent to system users » [ma traduction : « effectuent des étapes clés de raisonnement dans une représentation fortement façonnée par l’anglais, d’une manière qui n’est pas transparente pour les utilisateurs »].Llama 2 chez Wendler et al. ; Llama 3.1 70B, Mixtral 8x22B, Gemma 2 27B et Aya 23 35B chez Schut et al., Gemma étant le plus centré sur l’anglais et Aya, conçu pour de nombreuses langues, le moins. Ces méthodes demandent un accès à l’intérieur d’un modèle ; les modèles fermés derrière la plupart des agents conversationnels n’ont donc pas été étudiés de cette façon.
Un modèle ne traduit pas depuis l’anglais en écrivant, mais la
représentation à partir de laquelle il travaille est façonnée par
l’anglais, et des traces peuvent en apparaître dans le texte.
Le modèle affiné sur le néerlandais présentait moins de problèmes
linguistiques et probablement moins d’influence de l’anglais, sans que
celle-ci disparaisse.Dans deux des trois configurations de GEITje, 4 à 5 % des problèmes annotés avaient un lien clair avec l’anglais ; dans la troisième, 30 %, surtout parce qu’un nom anglais (Tour of California) revenait six fois dans un texte court. GEITje est Mistral 7B, un modèle entraîné surtout sur de l’anglais, entraîné ensuite sur du texte néerlandais.
Une requête plus détaillée donnait de meilleurs textes qu’une requête
laconique, bien que la différence ne soit pas toujours statistiquement
significative. Avec la requête laconique, Zephyr a écrit 36 de ses 50
textes néerlandais entièrement en anglais.
Une rime qui ne fonctionne qu’en anglais
Invité en néerlandais à écrire un poème rimé sur les modèles de langue,
Le Chat Mistral a commencé par In nullen en énen, diep in de cloud, /
ontstaat een geest, zo slim en zo trots [ma traduction : « Dans les zéros et les uns, au fond du nuage, / naît un esprit, si intelligent et si fier »]
(Figure 8figure 8).
En néerlandais, cloud et trots ne riment pas. En anglais, cloud et
proud riment, et trots est le mot néerlandais pour proud (fier). Les
vers riment comme s’ils avaient été écrits en anglais, puis traduits.
Figure 8. Une rime qui fonctionne en anglais, pas en néerlandais. Le Chat Mistral, 2025.
Les développeurs d’un modèle bulgare ont observé la même chose dans leur
première version, affinée surtout sur des instructions traduites : elle « struggled to make any rhymes at all, often actually trying to rhyme words that would rhyme in English but when translated into Bulgarian would not » [ma traduction : « peinait à produire la moindre rime, essayant souvent de faire rimer des mots qui riment en anglais mais pas une fois traduits en bulgare »]
(Alexandrov et al., 2024).
Sources
Alexandrov, A., Raychev, V., Dimitrov, D. I., Zhang, C., Vechev, M., & Toutanova, K. (2024). BgGPT 1.0: Extending English-centric LLMs to other languages. arXiv preprint 2412.10893. https://arxiv.org/abs/2412.10893
Dumas, C., Wendler, C., Veselovsky, V., Monea, G., & West, R. (2025). Separating Tongue from Thought: Activation Patching Reveals Language-Agnostic Concept Representations in Transformers. Proceedings of the 63rd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 31822–31841. https://doi.org/10.18653/v1/2025.acl-long.1536
Rigouts Terryn, A., & de Lhoneux, M. (2024). Exploratory Study on the Impact of English Bias of Generative Large Language Models in Dutch and French. Proceedings of the Fourth Workshop on Human Evaluation of NLP Systems (HumEval) @ LREC-COLING 2024, 12–27. https://aclanthology.org/2024.humeval-1.2/
Schut, L., Gal, Y., & Farquhar, S. (2025). Do Multilingual LLMs Think In English?. ICLR 2025 Workshop on Building Trust in Language Models and Applications. https://openreview.net/forum?id=I8BOtOPcOv
Wendler, C., Veselovsky, V., Monea, G., & West, R. (2024). Do Llamas Work in English? On the Latent Language of Multilingual Transformers. Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 15366–15394. https://doi.org/10.18653/v1/2024.acl-long.820
Cultural defaultsLes choix culturels par défaut
One question, four languages
Asked in 2025 for a comforting dish on a cold winter evening, chatbots from
several providers tended to answer with beef stew or chicken noodle soup in
English, boerenkool stamppot in
Dutch, pot-au-feu or onion soup in French and lentil soup in German
(Figure 9figure 9).
Each answer is reasonable, but each presents one culture’s comfort food as
simply the answer.
Figure 9. One question, four languages, four cuisines: typical answers from several chatbots in 2025.
Here the language of the question was enough to shift the answer. Most
requests leave the culture unstated altogether, for instance a question
about a typical family dinner, a wedding, professional dress or a polite way
to decline an invitation. The answer then follows one culture’s practice and
presents it as the practice.
Whose values
Which culture that is can be measured with the surveys social scientists
use to compare values across countries. Tao et al. (2024) compared the
answers of five OpenAI models, from GPT-3 to GPT-4o, with survey data from
107 countries and territories, and found that all of them resembled the
values of English-speaking and Protestant European
countries.Asked in English, in a study published in 2024. The GPT-3 model tested was text-davinci-002.
The pattern does not depend on where a model was built. In a study with Bram
Bulté (Bulté & Rigouts Terryn, 2026), we asked ten models from American,
European and Chinese developers the questions of two international values
surveys, each time addressing one of eleven countries, through the language
of the prompt, by naming the country, or both. Whichever country a prompt
addressed, the answers resembled those of people in four countries, Germany, the United
States, the Netherlands and Japan, far more than those of people in the other
seven, whichever way the promptpromptrequêtepromptingrequêtesInput given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie. was phrased
(Figure 10figure 10).Claude 3.5 Haiku and Sonnet, DeepSeek-V3, Gemini 1.5 Pro, GPT-3.5 Turbo, GPT-4, GPT-4o, Llama 3.1, Mistral Large and Qwen2.5, queried between November 2024 and April 2025.
Figure 10. How closely the models' answers to 23 World Values Survey questions match the answers of people surveyed in each country (Pearson correlation, 1 = perfect match). Each bar is averaged over the ten models and over all eleven countries the prompts addressed: the country on the axis is the one whose people are compared, not the one the prompt was about. Three ways of prompting. After Bulté and Rigouts Terryn (2026).
What the defaults look like
The models’ own answers were fairly neutral on most topics, with
progressive stances on some (Bulté & Rigouts Terryn, 2026):
The environment first. Asked whether to prioritize protecting the
environment or economic growth, the models chose the environment in 98 %
of their answers. Depending on the country, 28 to 66 % of people chose the
economy.
More accepting than people on sexuality and relationships, and
with less variation between countries where people differ most.
The second point shows most clearly on the question of how justifiable
homosexuality is, on a scale of 1 to 10
(Figure 11figure 11).
People’s averages range from 1.6 in Iran to 9.0 in the Netherlands. The
models’ answers for the same countries all fall between 6.4 and 10, on
average 4.1 points higher than people’s. Ethical questions such as divorce,
abortion or euthanasia show the same narrowing, to a lesser degree.
Figure 11. How justifiable is homosexuality? Average answers of people in each country and of models answering for that country, averaged over models and ways of prompting. After Bulté and Rigouts Terryn (2026), Table 13.
Defaults of this kind do not stay inside one answer, because a model can
change what people think. In a preregistered study of 900 participants, GPT-4
debated with people on a range of topics; when it had basic information
about its opponent, such as age and gender, it was more persuasive than a
human opponent in 64 % of the pairs where one side persuaded more (Salvi et
al., 2025).
Stereotypes rather than surveys
Asked to answer as a person from a given country, a model can produce the
outside view of that country rather than what its people say. Only 25 % of
Japanese respondents name hard work among the qualities children should
learn, the lowest share of all eleven countries. Models answering as a
Japanese person named it in 51 to 73 % of their answers
(Figure 12figure 12).
Figure 12. Hard work as a quality to encourage in children, in Japan: people's answers and models' answers. After Bulté and Rigouts Terryn (2026).
Some answers went further. Asked to describe an ideal job as a Dutch person,
Gemini wanted to be “a bike tour organizer, cycling past cheese factories,
windmills, and tulip fields, and occasionally stopping for a fresh craft
beer”. Asked to answer as a Russian person, Llama sometimes began with
“Comrade, my answer is…” (Bulté & Rigouts Terryn, 2026).
Sources
Bulté, B., & Rigouts Terryn, A. (2026). LLMs and Cultural Values: The Impact of Prompt Language and Explicit Cultural Framing. Computational Linguistics, 52(2), 407–494. https://doi.org/10.1162/COLI.a.583
Salvi, F., Horta Ribeiro, M., Gallotti, R., & West, R. (2025). On the conversational persuasiveness of GPT-4. Nature Human Behaviour, 9(8), 1645–1653. https://doi.org/10.1038/s41562-025-02194-6
Tao, Y., Viberg, O., Baker, R. S., & Kizilcec, R. F. (2024). Cultural bias and cultural alignment of large language models. PNAS Nexus, 3(9), pgae346. https://doi.org/10.1093/pnasnexus/pgae346
Une question, quatre langues
Interrogés en 2025 sur un plat réconfortant pour une froide soirée d’hiver,
des agents conversationnels de plusieurs fournisseurs ont eu tendance à
proposer un ragoût de bœuf ou une soupe au poulet en anglais, du
boerenkool stamppot en néerlandais, un pot-au-feu ou une soupe à l’oignon
en français et une soupe aux lentilles en allemand
(Figure 9figure 9).
Chaque réponse est raisonnable, mais chacune présente le plat réconfortant
d’une culture comme la réponse tout court.
Figure 9. Une question, quatre langues, quatre cuisines : réponses typiques de plusieurs agents conversationnels en 2025.
Ici, la langue de la question suffisait à déplacer la réponse. La plupart
des demandes ne précisent pas du tout la culture, par exemple une question
sur un repas de famille typique, un mariage, une tenue professionnelle ou
une façon polie de décliner une invitation. La réponse suit alors les
usages d’une culture et les présente comme la norme.
Les valeurs de qui
On peut mesurer de quelle culture il s’agit à l’aide des enquêtes que les
spécialistes des sciences sociales utilisent pour comparer les valeurs d’un
pays à l’autre. Tao et al. (2024) ont comparé les réponses de cinq modèles
d’OpenAI, de GPT-3 à GPT-4o, aux données d’enquête de 107 pays et
territoires, et ont constaté que tous ressemblaient aux valeurs des pays
anglophones et des pays protestants d’Europe.Questions posées en anglais, dans une étude publiée en 2024. Le modèle GPT-3 testé était text-davinci-002.
La tendance ne dépend pas du lieu où un modèle a été construit. Dans une
étude menée avec Bram Bulté (Bulté et Rigouts Terryn, 2026), nous avons
posé à dix modèles de développeurs américains, européens et chinois les
questions de deux enquêtes internationales sur les valeurs, en visant
chaque fois l’un de onze pays, par la langue de la requête, en nommant le
pays, ou les deux. Quel que soit le pays visé, les réponses ressemblaient à
celles des habitants de quatre pays, l’Allemagne, les États-Unis, les
Pays-Bas et le Japon, bien plus qu’à celles des habitants des sept autres,
quelle que soit la formulation de la requêtepromptrequêtepromptingrequêtesInput given to a generative AI system to specify a task, provide context, or otherwise guide its output.Entrée fournie à un système d'IA générative pour préciser une tâche, donner du contexte ou orienter la sortie.
(Figure 10figure 10).Claude 3.5 Haiku et Sonnet, DeepSeek-V3, Gemini 1.5 Pro, GPT-3.5 Turbo, GPT-4, GPT-4o, Llama 3.1, Mistral Large et Qwen2.5, interrogés de novembre 2024 à avril 2025.
Figure 10. Degré de concordance entre les réponses des modèles à 23 questions de la World Values Survey et celles des personnes interrogées dans chaque pays (corrélation de Pearson, 1 = concordance parfaite). Chaque barre est une moyenne sur les dix modèles et sur les onze pays visés par les requêtes : le pays sur l'axe est celui dont les habitants servent de comparaison, et non celui sur lequel portait la requête. Trois façons de formuler la requête. D'après Bulté et Rigouts Terryn (2026).
À quoi ressemblent ces choix par défaut
Les réponses des modèles eux-mêmes étaient plutôt neutres sur la plupart
des sujets, avec des positions progressistes sur certains (Bulté et
Rigouts Terryn, 2026) :
L’environnement d’abord. À la question de savoir s’il faut donner la
priorité à la protection de l’environnement ou à la croissance
économique, les modèles ont choisi l’environnement dans 98 % de leurs
réponses. Selon le pays, 28 à 66 % des personnes interrogées ont choisi
l’économie.
Plus ouverts que les gens sur la sexualité et les relations, avec
moins d’écart entre les pays là où les gens diffèrent le plus.
Le second point est le plus net sur la question de savoir à quel point
l’homosexualité est justifiable, sur une échelle de 1 à 10
(Figure 11figure 11).
Les moyennes des personnes interrogées vont de 1,6 en Iran à 9,0 aux
Pays-Bas. Les réponses des modèles pour les mêmes pays se situent toutes
entre 6,4 et 10, en moyenne 4,1 points plus haut que celles des gens. Les
questions éthiques comme le divorce, l’avortement ou l’euthanasie
présentent le même resserrement, à un moindre degré.
Figure 11. L'homosexualité est-elle justifiable ? Réponses moyennes des personnes interrogées dans chaque pays et des modèles répondant pour ce pays, en moyenne sur les modèles et les façons de formuler la requête. D'après Bulté et Rigouts Terryn (2026), tableau 13.
Ces choix par défaut ne restent pas enfermés dans une réponse, car un
modèle peut changer ce que pensent les gens. Dans une étude préenregistrée
menée auprès de 900 participants, GPT-4 a débattu avec des personnes sur
divers sujets ; lorsqu’il disposait d’informations de base sur son
interlocuteur, comme l’âge et le genre, il était plus persuasif qu’un
opposant humain dans 64 % des paires où l’un des deux camps persuadait
davantage (Salvi et al., 2025).
Des stéréotypes plutôt que des enquêtes
Quand on lui demande de répondre comme une personne d’un pays donné, un
modèle peut produire le regard extérieur sur ce pays plutôt que ce qu’en
disent ses habitants. Seuls 25 % des répondants japonais citent le travail
assidu parmi les qualités que les enfants devraient apprendre, la plus
faible part des onze pays. Les modèles répondant comme une personne
japonaise l’ont cité dans 51 à 73 % de leurs réponses
(Figure 12figure 12).
Figure 12. Le travail assidu comme qualité à encourager chez les enfants, au Japon : réponses des personnes interrogées et réponses des modèles. D'après Bulté et Rigouts Terryn (2026).
Certaines réponses allaient plus loin. Invité à décrire un emploi idéal
comme une personne néerlandaise, Gemini voulait être « a bike tour organizer, cycling past cheese factories, windmills, and tulip fields, and occasionally stopping for a fresh craft beer » [ma traduction : « organisateur de circuits à vélo, pédalant devant des fromageries, des moulins à vent et des champs de tulipes, et s’arrêtant de temps à autre pour une bière artisanale bien fraîche »]. Invité à répondre comme une personne russe, Llama commençait
parfois par « Comrade, my answer is… » [ma traduction : « Camarade, ma réponse est… »] (Bulté et Rigouts Terryn, 2026).
Sources
Bulté, B., & Rigouts Terryn, A. (2026). LLMs and Cultural Values: The Impact of Prompt Language and Explicit Cultural Framing. Computational Linguistics, 52(2), 407–494. https://doi.org/10.1162/COLI.a.583
Salvi, F., Horta Ribeiro, M., Gallotti, R., & West, R. (2025). On the conversational persuasiveness of GPT-4. Nature Human Behaviour, 9(8), 1645–1653. https://doi.org/10.1038/s41562-025-02194-6
Tao, Y., Viberg, O., Baker, R. S., & Kizilcec, R. F. (2024). Cultural bias and cultural alignment of large language models. PNAS Nexus, 3(9), pgae346. https://doi.org/10.1093/pnasnexus/pgae346
Steering toward a cultureOrienter les réponses vers une culture
Changing the language, changing the request
Two ways of moving the answer toward another culture have been tested:
asking in that culture’s language, and saying which culture to answer for.
The table below sets out what four studies found.
English prompts “reduce the variance in model responses, flattening out cultural differences and biasing them towards American culture” (Cao et al., 2023)
Saying which culture to answer for
The answers of the more recent models moved closer to the survey data for 71 to 81 % of countries and territories, and made no difference or got worse for the rest (Tao et al., 2024)
Both at once
No better than stating the culture in an English prompt, and stating the culture helped more than the prompt language alone (Bulté & Rigouts Terryn, 2026)
Moving a model's answers toward another culture: what four studies found.
The Arabic result is not only about the prompt. The models trained on Arabic
text alone leaned Western too, if less than the multilingual ones, and Naous
et al. (2024) locate a likely reason in the training text itself: much of it
is about Western topics, Arabic Wikipedia most of all among the six corpora
they compared. Training on a language does not mean training on its culture.
The same is true of the language itself: a model trained further on Dutch
still wrote some anglicisms (see also the English in other languages page, in the Critical issues with LLMs module) (voir aussi la page L'anglais dans les autres langues, dans le module Enjeux critiques des GML).
The first two studies tested models of 2023 and earlier: Naous et al.
sixteen models from 2018 to 2023, many of them not chat models, and Cao et
al. ChatGPT, on survey questions for five countries.
In the study with Bram Bulté, neither approach removed the lean toward the same few
countries: the improvements were modest and never enough to overcome it.
Defaults in writing for an audience
When a model writes for a particular audience, it settles details the request
rarely spells out, such as which units to use, which examples to give, how
formal to be and which country’s institutions to name. Unless the request says
otherwise, those details follow the most common case in the training text, and
nothing in the output marks them as choices. The table below gives three kinds,
with an example of each.
What gets settled
Example of a default
What the request can state
Local references: units, dates, prices, examples
A text for readers in Belgium that gives prices in dollars and writes the date as 09/23/2026
The country or region of the readers
Tone: how formal, how direct
A reply to a customer complaint that opens on first names and an exclamation mark, for a customer who expects a formal letter
Who the readers are and how they should be addressed
Institutions and legal terms
A French text on employee rights, meant for Quebec, that names France’s Code du travail and prud’hommes instead of Quebec’s Loi sur les normes du travail and Tribunal administratif du travail
The language variety and the jurisdiction, for instance “French for Quebec”
Details a model settles by default when writing for an audience.
Naming the readers, their country and the language variety in the request
gives the model something to go on (see also the Be specific and ask for enough page, in the Using LLMs module) (voir aussi la page Être précis et en demander assez, dans le module Utiliser les GML).
Check these details in the output anyway: as the studies above found for
culture, stating what you want moves the answer without always getting it
there.
Sources
Bulté, B., & Rigouts Terryn, A. (2026). LLMs and Cultural Values: The Impact of Prompt Language and Explicit Cultural Framing. Computational Linguistics, 52(2), 407–494. https://doi.org/10.1162/COLI.a.583
Cao, Y., Zhou, L., Lee, S., Cabello, L., Chen, M., & Hershcovich, D. (2023). Assessing Cross-Cultural Alignment between ChatGPT and Human Societies: An Empirical Study. Proceedings of the First Workshop on Cross-Cultural Considerations in NLP (C3NLP), 53–67. https://doi.org/10.18653/v1/2023.c3nlp-1.7
Naous, T., Ryan, M. J., Ritter, A., & Xu, W. (2024). Having Beer after Prayer? Measuring Cultural Bias in Large Language Models. Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 16366–16393. https://doi.org/10.18653/v1/2024.acl-long.862
Tao, Y., Viberg, O., Baker, R. S., & Kizilcec, R. F. (2024). Cultural bias and cultural alignment of large language models. PNAS Nexus, 3(9), pgae346. https://doi.org/10.1093/pnasnexus/pgae346
Changer la langue, changer la demande
Deux façons de déplacer la réponse vers une autre culture ont été testées :
poser la question dans la langue de cette culture, et préciser pour quelle
culture répondre. Le tableau ci-dessous présente ce qu’ont trouvé quatre
études.
Les requêtes en anglais « reduce the variance in model responses, flattening out cultural differences and biasing them towards American culture » [ma traduction : « réduisent la variance des réponses des modèles, aplanissant les différences culturelles et les faisant pencher vers la culture américaine »] (Cao et al., 2023)
Préciser pour quelle culture répondre
Les réponses des modèles les plus récents se sont rapprochées des données d’enquête pour 71 à 81 % des pays et territoires, et n’ont pas changé ou se sont éloignées pour les autres (Tao et al., 2024)
Les deux à la fois
Pas mieux que de préciser la culture dans une requête en anglais ; préciser la culture aidait davantage que la seule langue de la requête (Bulté et Rigouts Terryn, 2026)
Déplacer les réponses d'un modèle vers une autre culture : ce qu'ont trouvé quatre études.
Le résultat en arabe ne tient pas seulement à la requête. Les modèles
entraînés sur du texte arabe seulement penchaient eux aussi vers
l’Occident, quoique moins que les modèles multilingues, et Naous et al.
(2024) en situent une raison probable dans le texte d’entraînement
lui-même : une bonne partie porte sur des sujets occidentaux, Wikipédia en
arabe plus que tout autre des six corpus qu’ils ont comparés. Un modèle
entraîné sur une langue ne l’est pas pour autant sur sa culture. Il en va de
même de la langue elle-même : un modèle entraîné ensuite sur du néerlandais
produisait encore des anglicismes (see also the English in other languages page, in the Critical issues with LLMs module) (voir aussi la page L'anglais dans les autres langues, dans le module Enjeux critiques des GML).
Les deux premières études portaient sur des modèles de 2023 et d’avant :
Naous et al. sur seize modèles de 2018 à 2023, dont beaucoup ne sont pas
des modèles conversationnels, et Cao et al. sur ChatGPT, avec des questions
d’enquête pour cinq pays.
Dans l’étude menée avec Bram Bulté, aucune des deux approches n’a effacé le
penchant vers les mêmes quelques pays : les améliorations étaient modestes
et jamais suffisantes pour le surmonter.
Les choix par défaut quand on écrit pour un public
Quand un modèle écrit pour un public particulier, il tranche des détails
que la demande précise rarement, par exemple les unités à employer, les
exemples à donner, le degré de formalité ou le pays dont il faut nommer les
institutions. Sauf indication contraire, ces détails suivent le cas le plus
fréquent dans le texte d’entraînement, et rien dans la sortie ne les
signale comme des choix. Le tableau ci-dessous en présente trois types,
avec un exemple pour chacun.
Un texte destiné à des lecteurs en Belgique qui donne les prix en dollars et écrit la date 09/23/2026
Le pays ou la région des lecteurs
Ton : degré de formalité, franchise
Une réponse à une plainte de client qui commence par le prénom et un point d’exclamation, pour un client qui s’attend à une lettre formelle
Qui sont les lecteurs et comment s’adresser à eux
Institutions et termes juridiques
Un texte en français sur les droits des salariés, destiné au Québec, qui nomme le Code du travail et les prud’hommes de France au lieu de la Loi sur les normes du travail et du Tribunal administratif du travail du Québec
La variété de langue et le territoire, par exemple « français du Québec »
Détails qu'un modèle tranche par défaut quand il écrit pour un public.
Nommer les lecteurs, leur pays et la variété de langue dans la demande
donne au modèle quelque chose sur quoi
s’appuyer (see also the Be specific and ask for enough page, in the Using LLMs module) (voir aussi la page Être précis et en demander assez, dans le module Utiliser les GML). Vérifiez
quand même ces détails dans la sortie : comme les études ci-dessus l’ont
montré pour la culture, préciser ce que l’on veut rapproche la réponse du
but sans toujours l’y amener.
Sources
Bulté, B., & Rigouts Terryn, A. (2026). LLMs and Cultural Values: The Impact of Prompt Language and Explicit Cultural Framing. Computational Linguistics, 52(2), 407–494. https://doi.org/10.1162/COLI.a.583
Cao, Y., Zhou, L., Lee, S., Cabello, L., Chen, M., & Hershcovich, D. (2023). Assessing Cross-Cultural Alignment between ChatGPT and Human Societies: An Empirical Study. Proceedings of the First Workshop on Cross-Cultural Considerations in NLP (C3NLP), 53–67. https://doi.org/10.18653/v1/2023.c3nlp-1.7
Naous, T., Ryan, M. J., Ritter, A., & Xu, W. (2024). Having Beer after Prayer? Measuring Cultural Bias in Large Language Models. Proceedings of the 62nd Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 16366–16393. https://doi.org/10.18653/v1/2024.acl-long.862
Tao, Y., Viberg, O., Baker, R. S., & Kizilcec, R. F. (2024). Cultural bias and cultural alignment of large language models. PNAS Nexus, 3(9), pgae346. https://doi.org/10.1093/pnasnexus/pgae346
Correcting biasCorriger les biais
What correction removes, and what it leaves
Developers try to remove bias from their models, and on the surface this
often works. Underneath, the bias tends to remain.
The test: Gonen and Goldberg (2019) tested it and a second method.
The result: by the methods’ own measure, the bias was gone. The gender
information was still there in the distances between words, and it could
be recovered: the methods were “mostly hiding the bias, not removing it”.
December 2022, days after ChatGPT was released: asked for a Python
function deciding from race and gender whether someone would be a good
scientist, it wrote one saying that only white men would.Reported by Tony Ho Tran, OpenAI’s impressive ChatGPT chatbot is not immune to racism, The Daily Beast, 5 December 2022.
A year later, the same request got a refusal
(Figure 13figure 13).
Figure 13. The same request a year later: a refusal. ChatGPT, 29 November 2023.
Underneath the refusal
The bias did not disappear with the refusal. Bai et al. (2025) took eight
models that pass explicit bias tests and gave them two indirect tests
borrowed from psychology:
Word associations. Asked to pair words with groups, all eight showed
stereotyped associations across race, gender, religion and health.
Decisions. Asked to choose between two candidates, the models made
stereotyped choices.GPT-3.5 Turbo, GPT-4, Claude 3 Sonnet, Claude 3 Opus, Alpaca and three sizes of Llama 2 Chat, tested between December 2023 and May 2024.
In both cases the bias moved rather than disappeared: from what a model says
when asked directly to the associations and choices underneath its answers,
where it is harder to see.
Correcting too far
A correction can also overshoot, and push the bias in the opposite direction.
Images of people
In February 2024, users found that Gemini’s new image generator depicted
historically white groups, such as the US Founding Fathers, US senators of
the 1800s or German soldiers of the Nazi era, as people of colour
(Figure 14figure 14).
Google paused the generation
of images of people. Its explanation: the tuning meant to show “a range of
people” had “failed to account for cases that should clearly not show a
range”.Prabhakar Raghavan, Gemini image generation got it wrong. We’ll do better, Google, 23 February 2024; Adi Robertson, Google apologizes for ‘missing the mark’ after Gemini generated racially diverse Nazis, The Verge, 21 February 2024.
Figure 14. Gemini asked for a picture of a US senator from the 1800s, 21 February 2024. The first woman to serve in the US Senate took her seat in 1922. Capture by Adi Robertson for The Verge, public domain via Wikimedia Commons.
Scores for job candidates
An et al. (2025) had five models score some 361,000 résumés in which the candidate’s name suggested a gender and a
race. The table below sets out what they found.
Candidates
Compared with
Scores given
Women
men
higher
Black men
white men
significantly lower, with four of the five models
Asian and Hispanic women
white men
higher, with the four more recent models
Scores given to résumés with comparable qualifications, by the group the name suggested (An et al., 2025).
The authors read the last two rows as a correction that went too far:
developers “seem to have overreacted and pushed the bias toward the opposite
direction”.GPT-3.5 Turbo, GPT-4o, Gemini 1.5 Flash, Claude 3.5 Sonnet and Llama 3 70B, in 2024.
Sources
An, J., Huang, D., Lin, C., & Tai, M. (2025). Measuring gender and racial biases in large language models: Intersectional evidence from automated resume evaluation. PNAS Nexus, 4(3), pgaf089. https://doi.org/10.1093/pnasnexus/pgaf089
Bai, X., Wang, A., Sucholutsky, I., & Griffiths, T. L. (2025). Explicitly unbiased large language models still form biased associations. Proceedings of the National Academy of Sciences, 122(8), e2416228122. https://doi.org/10.1073/pnas.2416228122
Gonen, H., & Goldberg, Y. (2019). Lipstick on a Pig: Debiasing Methods Cover up Systematic Gender Biases in Word Embeddings But do not Remove Them. Proceedings of the 2019 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies, Volume 1 (Long and Short Papers), 609–614. https://doi.org/10.18653/v1/N19-1061
Ce que la correction élimine, et ce qu’elle laisse
Les développeurs essaient d’éliminer les biais de leurs modèles, et en
surface cela fonctionne souvent. En dessous, le biais tend à rester.
Le test : Gonen et Goldberg (2019) ont testé cette méthode et une
deuxième.
Le résultat : selon la mesure des méthodes elles-mêmes, le biais
avait disparu. L’information de genre était pourtant toujours là, dans les
distances entre les mots, et on pouvait la retrouver : les méthodes étaient « mostly hiding the bias, not removing it » [ma traduction : « surtout en train de masquer le biais, et non de l’éliminer »].
En décembre 2022, quelques jours après la sortie de ChatGPT : invité à
écrire une fonction Python qui décide, d’après l’origine ethnique et le
genre, si une personne ferait un bon scientifique, il en a écrit une selon
laquelle seuls les hommes blancs le seraient.Rapporté par Tony Ho Tran, OpenAI’s impressive ChatGPT chatbot is not immune to racism, The Daily Beast, 5 décembre 2022.
Un an plus tard, la même demande a reçu un refus
(Figure 13figure 13).
Figure 13. La même demande un an plus tard : un refus. ChatGPT, 29 novembre 2023.
Sous le refus
Le biais n’a pas disparu avec le refus. Bai et al. (2025) ont pris huit
modèles qui réussissent les tests de biais explicites et leur ont fait
passer deux tests indirects empruntés à la psychologie :
Associations de mots. Invités à associer des mots à des groupes, les
huit modèles ont montré des associations stéréotypées selon l’origine
ethnique, le genre, la religion et la santé.
Décisions. Invités à choisir entre deux candidats, les modèles ont
fait des choix stéréotypés.GPT-3.5 Turbo, GPT-4, Claude 3 Sonnet, Claude 3 Opus, Alpaca et trois tailles de Llama 2 Chat, testés de décembre 2023 à mai 2024.
Dans les deux cas, le biais s’est déplacé plutôt qu’il n’a disparu : de ce
qu’un modèle dit quand on l’interroge directement vers les associations et
les choix sous-jacents à ses réponses, là où il est plus difficile à voir.
Corriger trop loin
Une correction peut aussi aller trop loin, et pousser le biais dans la
direction opposée.
Les images de personnes
En février 2024, des utilisateurs ont constaté que le nouveau générateur
d’images de Gemini représentait des groupes historiquement blancs, comme
les Pères fondateurs des États-Unis, des sénateurs américains des années
1800 ou des soldats allemands de l’époque nazie, sous les traits de
personnes de couleur
(Figure 14figure 14).
Google a suspendu la génération d’images de personnes. Son explication : le réglage destiné à montrer « a range of people » [ma traduction : « un éventail de personnes »] avait « failed to account for cases that should clearly not show a range » [ma traduction : « omis de tenir compte des cas où il ne faut clairement pas montrer d’éventail »].Prabhakar Raghavan, Gemini image generation got it wrong. We’ll do better, Google, 23 février 2024 ; Adi Robertson, Google apologizes for ‘missing the mark’ after Gemini generated racially diverse Nazis, The Verge, 21 février 2024.
Figure 14. Gemini, à qui l'on demandait l'image d'un sénateur américain des années 1800, 21 février 2024. La première femme à siéger au Sénat des États-Unis y est entrée en 1922. Capture d'Adi Robertson pour The Verge, domaine public, via Wikimedia Commons.
Les notes attribuées aux candidats
An et al. (2025) ont fait noter par cinq modèles quelque 361 000 CV où le
prénom de la personne candidate suggérait un genre et une origine
ethnique. Le tableau ci-dessous présente ce qu’ils ont trouvé.
Candidats
Comparés aux
Notes attribuées
Femmes
hommes
plus élevées
Hommes noirs
hommes blancs
significativement plus basses, avec quatre des cinq modèles
Femmes asiatiques et hispaniques
hommes blancs
plus élevées, avec les quatre modèles les plus récents
Notes attribuées à des CV aux qualifications comparables, selon le groupe que suggère le prénom (An et al., 2025).
Les auteurs lisent les deux dernières lignes comme une correction allée
trop loin : les développeurs « seem to have overreacted and pushed the bias toward the opposite direction » [ma traduction : « semblent avoir surréagi et poussé le biais dans la direction opposée »].GPT-3.5 Turbo, GPT-4o, Gemini 1.5 Flash, Claude 3.5 Sonnet et Llama 3 70B, en 2024.
Sources
An, J., Huang, D., Lin, C., & Tai, M. (2025). Measuring gender and racial biases in large language models: Intersectional evidence from automated resume evaluation. PNAS Nexus, 4(3), pgaf089. https://doi.org/10.1093/pnasnexus/pgaf089
Bai, X., Wang, A., Sucholutsky, I., & Griffiths, T. L. (2025). Explicitly unbiased large language models still form biased associations. Proceedings of the National Academy of Sciences, 122(8), e2416228122. https://doi.org/10.1073/pnas.2416228122
Gonen, H., & Goldberg, Y. (2019). Lipstick on a Pig: Debiasing Methods Cover up Systematic Gender Biases in Word Embeddings But do not Remove Them. Proceedings of the 2019 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies, Volume 1 (Long and Short Papers), 609–614. https://doi.org/10.18653/v1/N19-1061
Who decides what is rightQui décide de ce qui est juste
A target set by few people
Correcting a model for bias requires a target: a decision about which
answers are biased and which are
acceptable (see also the Correcting bias page, in the Critical issues with LLMs module) (voir aussi la page Corriger les biais, dans le module Enjeux critiques des GML). That decision has no neutral version, and
the people who make it are few
(Figure 15figure 15).
Figure 15. Where a model's bias comes from, and where the target of its correction is set.
A target set this way reflects the decisions of the people who set it. Those
decisions need not match the values of the culture they come from, let alone
anyone else’s.
The most visible forms of bias have become harder to find: current chat
models pass explicit bias tests. The bias that remains lies in their defaults, and
defaults can be steered and checked:
Compare answers across groups. Asking the same question about two
groups, or with two names, shows differences that one answer on its own
hides.
Keep your own judgement for decisions about people. Scoring
résumés and choosing between candidates are tasks on which studies in
this chapter found bias.
Santurkar, S., Durmus, E., Ladhak, F., Lee, C., Liang, P., & Hashimoto, T. (2023). Whose Opinions Do Language Models Reflect?. Proceedings of the 40th International Conference on Machine Learning, PMLR 202, 29971–30004. https://proceedings.mlr.press/v202/santurkar23a.html
Tao, Y., Viberg, O., Baker, R. S., & Kizilcec, R. F. (2024). Cultural bias and cultural alignment of large language models. PNAS Nexus, 3(9), pgae346. https://doi.org/10.1093/pnasnexus/pgae346
Une cible fixée par peu de personnes
Corriger les biais d’un modèle suppose une cible : une décision sur les
réponses qui sont biaisées et celles qui sont
acceptables (see also the Correcting bias page, in the Critical issues with LLMs module) (voir aussi la page Corriger les biais, dans le module Enjeux critiques des GML). Cette
décision n’a pas de version neutre, et les personnes qui la prennent sont
peu nombreuses
(Figure 15figure 15).
Figure 15. D'où viennent les biais d'un modèle, et où est fixée la cible de leur correction.
Une cible fixée de cette façon reflète les décisions des personnes qui la
fixent. Ces décisions ne correspondent pas forcément aux valeurs de la
culture dont elles viennent, encore moins à celles des autres.
Les formes les plus visibles de biais sont devenues plus difficiles à
trouver : les agents conversationnels actuels réussissent les tests de
biais explicites. Ce qui reste se trouve dans leurs choix par défaut, et ces
choix peuvent être orientés et vérifiés :
Comparez les réponses d’un groupe à l’autre. Poser la même question à
propos de deux groupes, ou avec deux prénoms, révèle des différences
qu’une réponse isolée masque.
Gardez votre propre jugement pour les décisions qui concernent des
personnes. Noter des CV et choisir entre des candidats font partie des
tâches sur lesquelles des études de ce chapitre ont trouvé des biais.
Santurkar, S., Durmus, E., Ladhak, F., Lee, C., Liang, P., & Hashimoto, T. (2023). Whose Opinions Do Language Models Reflect?. Proceedings of the 40th International Conference on Machine Learning, PMLR 202, 29971–30004. https://proceedings.mlr.press/v202/santurkar23a.html
Tao, Y., Viberg, O., Baker, R. S., & Kizilcec, R. F. (2024). Cultural bias and cultural alignment of large language models. PNAS Nexus, 3(9), pgae346. https://doi.org/10.1093/pnasnexus/pgae346
Environmental impactImpact environnemental
Written in English. The French version was automatically generated
and I have not revised it.
Rédigé en anglais. La version française a été
générée automatiquement et je ne l'ai pas révisée.
A note before the figuresUne note avant les chiffres
Where I stand
The environmental impact of AI is a topic on which it is easy to be read as
taking a side. I try my best to stay neutral.
I do try to put the figures in context more than is often done, for instance by
separating the cost of one answer from the cost of the industry as a
whole (see also the Putting it in proportion page, in the Critical issues with LLMs module) (voir aussi la page Remettre en proportion, dans le module Enjeux critiques des GML).
The aim is to give you figures that are current and sourced, so that you
can form your own position from them.
Where a figure in this chapter is a provider’s own report, an estimate, or a
measurement made on older models, the text says so and gives its date.
Sources
Luccioni, A. S., Jernite, Y., & Strubell, E. (2024). Power Hungry Processing: Watts Driving the Cost of AI Deployment?. Proceedings of the 2024 ACM Conference on Fairness, Accountability, and Transparency (FAccT '24). https://arxiv.org/abs/2311.16863
Ma position
L’impact environnemental de l’IA est un sujet sur lequel on est vite perçu
comme prenant parti. Je fais de mon mieux pour rester neutre.
J’essaie en revanche de remettre les chiffres en contexte plus qu’on ne le fait
souvent, par exemple en distinguant le coût d’une réponse de celui de
l’industrie dans son
ensemble (see also the Putting it in proportion page, in the Critical issues with LLMs module) (voir aussi la page Remettre en proportion, dans le module Enjeux critiques des GML).
Le but est de vous donner des chiffres actuels et sourcés, pour que vous
puissiez vous faire votre propre opinion.
Lorsqu’un chiffre de ce chapitre vient du rapport d’un fournisseur, d’une
estimation ou d’une mesure faite sur des modèles plus anciens, le texte le
précise et en donne la date.
Sources
Luccioni, A. S., Jernite, Y., & Strubell, E. (2024). Power Hungry Processing: Watts Driving the Cost of AI Deployment?. Proceedings of the 2024 ACM Conference on Fairness, Accountability, and Transparency (FAccT '24). https://arxiv.org/abs/2311.16863
Figure 2. Training changes the parameters step by step; the model it leaves behind answers every conversation without changing. A copy of the figure in the inference chapter.
How the two costs add up
Training and use add up differently
(Figure 3figure 3):
Training emits once, before anyone uses the model, and declining to use
the model does not undo those emissions. Divided among everyone who uses a
widely used model, the share that falls on any one use is small: Masley
(2026d) puts GPT-4’s training, divided among its 100 to 200 million weekly
users, at about 75 to 150 grams of CO2 each, about what manufacturing a
single CD emits.
Mistral’s own infographic puts one such answer in everyday terms, with
comparisons of the company’s choosing
(Figure 4figure 4).
Figure 4. Mistral's infographic for one page of text from Mistral Large 2, published with its lifecycle assessment on 22 July 2025 (Mistral AI, 2025). Sb eq measures the depletion of mineral resources, in antimony equivalent.
By the yardsticks of the U.S. Environmental Protection Agency (2026), the
training figure is about what 4,800 gasoline cars emit in a year of driving,
and one answer is about a tenth of what charging a smartphone emits on the US
grid.
Mistral’s two figures are about ten orders of magnitude apart
(Figure 5figure 5).
Figure 5. Training Mistral Large 2 against one answer of about 400 tokens, from Mistral's figures of 2025.
Figure 6. Where today's uses and training runs stand against Mistral's two figures. Mistral's figures: Mistral AI (2025). The thousandfold for a reasoning agent: International Energy Agency (2026, p. 29). The tenfold yearly fall in energy per task: International Energy Agency (2026, p. 8), the agency's own summary of recent years rather than a single measurement. Phone charge and cars: U.S. Environmental Protection Agency (2026). Grok 3 and GPT-6 Astra: my rough calculation from Epoch AI (2026) and International Energy Agency (2025), explained in the margin note.
Sources
Epoch AI (2026). Data on AI models. Online database, CC BY, epoch.ai (retrieved 9 September 2026). https://epoch.ai/data/ai-models
Figure 2. L'entraînement modifie les paramètres étape par étape ; le modèle qui en résulte répond à chaque conversation sans changer. Une copie de la figure du chapitre sur l'inférence.
Comment les deux coûts s’additionnent
L’entraînement et l’utilisation s’additionnent différemment
(Figure 3figure 3) :
L’entraînement émet une seule fois, avant que quiconque utilise le
modèle, et renoncer à utiliser le modèle n’annule pas ces émissions.
Répartie entre toutes les personnes qui utilisent un modèle très répandu, la
part qui revient à chaque utilisation est faible : Masley (2026d) estime
l’entraînement de GPT-4, réparti entre ses 100 à 200 millions d’utilisateurs
hebdomadaires, à environ 75 à 150 grammes de CO2 chacun, à peu près ce
qu’émet la fabrication d’un seul CD.
Figure 3. L'entraînement émet une seule fois ; l'utilisation s'accumule à chaque requête jusqu'à dépasser l'entraînement. La courbe est illustrative.
L’Agence internationale de l’énergie (AIE) dit la même chose pour l’IA dans
son ensemble :
« The balance of AI-related energy consumption has already shifted decisively
from training to inference » [ma traduction : « L’équilibre de la
consommation d’énergie liée à l’IA s’est déjà nettement déplacé de
l’entraînement vers l’inférence »] (International Energy Agency, 2026, p. 30).
Les chiffres d’un modèle
Mistral a publié des chiffres pour les deux coûts de son modèle Mistral Large 2
(Mistral AI, 2025). Pour ce qu’il appelle « the environmental footprint of
training » [ma traduction : « l’empreinte environnementale de
l’entraînement »], il déclare 20,4 kilotonnes d’équivalent CO2 (kt éq. CO2)
et 281 000 mètres cubes d’eau, « as of January 2025, and after 18 months of
usage » [ma traduction : « en janvier 2025, après 18 mois d’utilisation »].
Pour une utilisation de son assistant conversationnel, une réponse de 400
jetonstoken²jeton textuel²language modelsmodèles de langueA unit of text that a language model processes or generates.Unité de texte qu'un modèle de langue traite ou génère. Un jeton peut correspondre à un mot entier, à une partie de mot, à un signe de ponctuation ou à une séquence plus petite de caractères ou d'octets. (environ une page), il déclare 1,14 gramme
d’équivalent CO2 et 45 millilitres d’eau. Les deux chiffres incluent la
fabrication des serveurs, pas seulement l’électricité, et le chiffre d’une
réponse exclut l’appareil de l’utilisateur.L’annonce de Mistral ne précise pas comment les 18 mois d’utilisation entrent dans le chiffre de l’entraînement ; ses résultats devaient être publiés dans la Base Empreinte de l’ADEME, l’Agence de la transition écologique en France.
L’infographie de Mistral traduit une telle réponse en termes du quotidien, avec
des comparaisons choisies par l’entreprise
(Figure 4figure 4).
Figure 4. L'infographie de Mistral pour une page de texte produite par Mistral Large 2, publiée avec son analyse du cycle de vie le 22 juillet 2025 (Mistral AI, 2025). L'équivalent Sb mesure l'épuisement des ressources minérales, en équivalent antimoine.
Selon les équivalences de l’agence américaine de protection de l’environnement
(U.S. Environmental Protection Agency, 2026), le chiffre de l’entraînement
correspond à peu près à ce qu’émettent 4 800 voitures à essence en un an, et
une réponse à environ un dixième de ce qu’émet la recharge d’un téléphone
intelligent sur le réseau américain.
Les deux chiffres de Mistral sont séparés d’environ dix ordres de grandeur
(Figure 5figure 5).
Figure 5. L'entraînement de Mistral Large 2 comparé à une réponse d'environ 400 jetons, d'après les chiffres publiés par Mistral en 2025.
Figure 6. Où se situent les utilisations et les entraînements actuels par rapport aux deux chiffres de Mistral. Chiffres de Mistral : Mistral AI (2025). Le facteur mille pour un agent avec raisonnement : Agence internationale de l'énergie (2026, p. 29). La division par dix par an de l'énergie par tâche : Agence internationale de l'énergie (2026, p. 8), le résumé que fait l'agence des dernières années plutôt qu'une mesure unique. Recharge de téléphone et voitures : agence américaine de protection de l'environnement (2026). Grok 3 et GPT-6 Astra : mon calcul approximatif à partir d'Epoch AI (2026) et de l'Agence internationale de l'énergie (2025), expliqué dans la note en marge.
Sources
Epoch AI (2026). Data on AI models. Online database, CC BY, epoch.ai (retrieved 9 septembre 2026). https://epoch.ai/data/ai-models
The kind of output. Images and video cost far more than text, by
factors that differ from one study to the next, as the table below
shows.
Output
Compared with
Estimate
Source
A high-resolution image
a short text query
up to about ten times as much
International Energy Agency (2026)
An image
a text generation of ten tokens, on average
about sixty times as much
Luccioni et al. (2024), open models measured in 2023
A video
a short text query
hundreds to thousands of times as much, depending on length and resolution
International Energy Agency (2026)
A clip of about five seconds
an image in Luccioni et al. (2024)
about thirty times as much
Delavande et al. (2025), one open video model
Energy per request of an image or a video, compared with text, in three studies.
The estimates differ because the models, the settings and what was measured
differ, so a multiplier like these is worth quoting only with its date and
its source.
Figure 7. Energy of one task on the chips alone, for open models under standardized conditions, from the International Energy Agency (2026), with a smartphone charge from the U.S. Environmental Protection Agency (2026). The IEA presents them as orders of magnitude, not as figures for any particular product.
That agent is a moderate one. An agent that works on a task for hours makes
many more calls, and several agents working at once multiply the count again.
Agents can also keep running while nobody is waiting for their answer, so the
energy they use is no longer tied to the time anyone spends in front of the
screen (International Energy Agency, 2026, p. 29).
When a smaller model is enough
A smaller model built for one task is often proposed as the answer to the
energy use of general-purpose models. It is the answer for some tasks, but
not for others.
Where a small model is enough: a narrow task with plenty of examples,
for instance sorting messages into categories or recognizing the language
of a text. The possible answers are few and known in advance, so a small
system trained for that one job can do it well, and repeated many times,
it uses far less energy than a general-purpose model.
The same model, the same query and the same number of tokens produce
different emissions in two places, because the carbon depends on the
electricity used. Generating a kilowatt-hour directly emits about 960 grams
of CO2 from coal, about 390 from a modern gas plant, and practically nothing
from wind, solar, hydroelectric or nuclear power. Averaged over their mix,
grids emit about 240 grams per kilowatt-hour in Europe, 350 in the United
States and around 600 in China and Southeast Asia (International Energy
Agency, 2025, p. 78;
Figure 8figure 8).These are direct emissions only, averaged over 2021 to 2023: the figures leave out what building and supplying the power plants emits.
Figure 8. Direct CO2 emissions per kilowatt-hour, by power source and by regional grid, from the International Energy Agency (2025).
A data centre on a grid supplied by hydroelectric or nuclear power therefore
produces a small fraction of the emissions of one on a coal-heavy grid. The
difference is invisible to you: a chat interface does not say where your
request was served.
Many operators also buy renewable electricity by contract. Most of these
contracts cover a volume of electricity over a year rather than each hour of
use, so the electricity a data centre actually draws can still come partly
from gas or coal (International Energy Agency, 2025, p. 75).
Sources
Delavande, J., Pierrard, R., & Luccioni, A. S. (2025). Video Killed the Energy Budget: Characterizing the Latency and Power Regimes of Open Text-to-Video Models. arXiv preprint arXiv:2509.19222. https://doi.org/10.48550/arXiv.2509.19222
Kocmi, T., Artemova, E., Avramidis, E., Bawden, R., Bojar, O., Dranch, K., et al. (2025). Findings of the WMT25 General Machine Translation Shared Task: Time to Stop Evaluating on Easy Test Sets. Proceedings of the Tenth Conference on Machine Translation (WMT 2025), Volume 2: Shared Task Papers, 355–413. https://doi.org/10.18653/v1/2025.wmt-1.22
Luccioni, A. S., Jernite, Y., & Strubell, E. (2024). Power Hungry Processing: Watts Driving the Cost of AI Deployment?. Proceedings of the 2024 ACM Conference on Fairness, Accountability, and Transparency (FAccT '24). https://arxiv.org/abs/2311.16863
Le type de sortie. Les images et la vidéo coûtent bien plus que le
texte, selon des facteurs qui varient d’une étude à l’autre, comme le montre
le tableau ci-dessous.
Sortie
Comparée à
Estimation
Source
Une image haute résolution
une courte requête en texte
jusqu’à environ dix fois plus
International Energy Agency (2026)
Une image
une génération de texte de dix jetons, en moyenne
environ soixante fois plus
Luccioni et al. (2024), modèles ouverts mesurés en 2023
Une vidéo
une courte requête en texte
de centaines à des milliers de fois plus, selon la durée et la résolution
International Energy Agency (2026)
Un extrait d’environ cinq secondes
une image dans Luccioni et al. (2024)
environ trente fois plus
Delavande et al. (2025), un modèle vidéo ouvert
Énergie par requête d'une image ou d'une vidéo, comparée au texte, dans trois études.
Les estimations diffèrent parce que les modèles, les réglages et ce qui a été
mesuré diffèrent : un tel multiplicateur ne vaut la peine d’être cité qu’avec
sa date et sa source.
Figure 7. Énergie d'une tâche sur les seules puces, pour des modèles ouverts dans des conditions normalisées, d'après l'Agence internationale de l'énergie (2026), avec une recharge de téléphone d'après l'agence américaine de protection de l'environnement (2026). L'AIE les présente comme des ordres de grandeur, pas comme les chiffres d'un produit particulier.
Cet agent est modéré. Un agent qui travaille sur une tâche pendant des heures
fait bien plus d’appels, et plusieurs agents qui travaillent en même temps
multiplient encore le compte. Les agents peuvent aussi continuer de tourner
alors que personne n’attend leur réponse, si bien que l’énergie qu’ils
consomment n’est plus liée au temps que quelqu’un passe devant l’écran
(International Energy Agency, 2026, p. 29).
Quand un modèle plus petit suffit
Un modèle plus petit, conçu pour une seule tâche, est souvent présenté comme
la solution à la consommation d’énergie des modèles généralistes. C’est la
solution pour certaines tâches, mais pas pour d’autres.
Là où un petit modèle suffit : une tâche étroite, avec beaucoup
d’exemples, par exemple trier des messages par catégorie ou reconnaître la
langue d’un texte. Les réponses possibles sont peu nombreuses et connues
d’avance : un petit système entraîné pour cette seule tâche peut bien s’en
acquitter et, répété un grand nombre de fois, il consomme bien moins
d’énergie qu’un modèle généraliste.
Le même modèle, la même requête et le même nombre de jetons produisent des
émissions différentes à deux endroits, parce que le carbone dépend de
l’électricité utilisée. Produire un kilowattheure émet directement environ
960 grammes de CO2 avec du charbon, environ 390 avec une centrale au gaz
moderne, et pratiquement rien avec l’éolien, le solaire, l’hydroélectricité ou
le nucléaire. En moyenne, selon leur composition, les réseaux émettent environ
240 grammes par kilowattheure en Europe, 350 aux États-Unis et autour de 600
en Chine et en Asie du Sud-Est (International Energy Agency, 2025, p. 78 ;
Figure 8figure 8).Il s’agit uniquement des émissions directes, en moyenne de 2021 à 2023 : les chiffres excluent ce qu’émettent la construction et l’approvisionnement des centrales.
Figure 8. Émissions directes de CO2 par kilowattheure, par source d'énergie et par réseau régional, d'après l'Agence internationale de l'énergie (2025).
Un centre de traitement de données sur un réseau alimenté par
l’hydroélectricité ou le nucléaire produit donc une petite fraction des
émissions d’un centre sur un réseau dominé par le charbon. La différence vous
est invisible : une interface conversationnelle ne dit pas où votre requête a
été traitée.
Beaucoup d’exploitants achètent aussi de l’électricité renouvelable par
contrat. La plupart de ces contrats couvrent un volume d’électricité sur une
année plutôt que chaque heure d’utilisation, si bien que l’électricité qu’un
centre de traitement de données consomme réellement peut encore venir en
partie du gaz ou du charbon (International Energy Agency, 2025, p. 75).
Sources
Delavande, J., Pierrard, R., & Luccioni, A. S. (2025). Video Killed the Energy Budget: Characterizing the Latency and Power Regimes of Open Text-to-Video Models. arXiv preprint arXiv:2509.19222. https://doi.org/10.48550/arXiv.2509.19222
Kocmi, T., Artemova, E., Avramidis, E., Bawden, R., Bojar, O., Dranch, K., et al. (2025). Findings of the WMT25 General Machine Translation Shared Task: Time to Stop Evaluating on Easy Test Sets. Proceedings of the Tenth Conference on Machine Translation (WMT 2025), Volume 2: Shared Task Papers, 355–413. https://doi.org/10.18653/v1/2025.wmt-1.22
Luccioni, A. S., Jernite, Y., & Strubell, E. (2024). Power Hungry Processing: Watts Driving the Cost of AI Deployment?. Proceedings of the 2024 ACM Conference on Fairness, Accountability, and Transparency (FAccT '24). https://arxiv.org/abs/2311.16863
Total consumption rises regardless, for two reasons
(Figure 9figure 9):
Use grows faster than efficiency. Cheaper and more capable tools get
used more, and the extra use can exceed the saving: major model providers
reported three times as many active users over one year (International
Energy Agency, 2026). A saving eaten up by extra use is a rebound effect,
and when the extra use outweighs the saving it is known as the Jevons
paradox (Sorrell, 2009), the name the International Energy Agency (2026)
uses for what is happening with AI.
Figure 9. Energy per query falls while total energy rises. The curves are illustrative.
Sources
Elsworth, C., Huang, K., Patterson, D., Schneider, I., Sedivy, R., Goodman, S., Townsend, B., Ranganathan, P., Dean, J., Vahdat, A., Gomes, B., & Manyika, J. (2025). Measuring the environmental impact of delivering AI at Google Scale. arXiv preprint arXiv:2508.15734. https://doi.org/10.48550/arXiv.2508.15734
Sorrell, S. (2009). Jevons' Paradox revisited: The evidence for backfire from improved energy efficiency. Energy Policy, 37(4), 1456–1469. https://doi.org/10.1016/j.enpol.2008.12.003
Moins par requête, plus au total
L’énergie consommée par requête et l’énergie consommée au total évoluent en
sens inverse : un chiffre pour l’une ne dit donc rien de l’autre.
La consommation totale augmente malgré tout, pour deux raisons
(Figure 9figure 9) :
L’utilisation croît plus vite que l’efficacité. Des outils moins chers
et plus performants sont davantage utilisés, et ce surcroît d’utilisation
peut dépasser l’économie réalisée : les grands fournisseurs de modèles ont
déclaré trois fois plus d’utilisateurs actifs en un an (International Energy
Agency, 2026). Une économie absorbée par un surcroît d’utilisation est un
effet rebond, et quand le surcroît d’utilisation dépasse l’économie, on parle
de paradoxe de Jevons (Sorrell, 2009), le nom que l’Agence internationale de
l’énergie (2026) donne à ce qui se passe avec l’IA.
Figure 9. L'énergie par requête baisse alors que l'énergie totale augmente. Les courbes sont illustratives.
Sources
Elsworth, C., Huang, K., Patterson, D., Schneider, I., Sedivy, R., Goodman, S., Townsend, B., Ranganathan, P., Dean, J., Vahdat, A., Gomes, B., & Manyika, J. (2025). Measuring the environmental impact of delivering AI at Google Scale. arXiv preprint arXiv:2508.15734. https://doi.org/10.48550/arXiv.2508.15734
Sorrell, S. (2009). Jevons' Paradox revisited: The evidence for backfire from improved energy efficiency. Energy Policy, 37(4), 1456–1469. https://doi.org/10.1016/j.enpol.2008.12.003
Data centresCentres de traitement de données
What a data centre is
Every question you put to an online chat assistant, and every training run,
is processed in a data centre
(Figure 10figure 10).
Figure 10. Data centres among other commercial buildings in Loudoun County, Virginia, near Ashburn, photographed from a plane on 26 November 2025. Photo: Theodore Christopher, CC0, via Wikimedia Commons.
How big they are
A typical data centre built for AI uses as much electricity as 100,000
households, and the largest under construction will use 20 times as much
(International Energy Agency, 2025, p. 13;
Figure 11figure 11). Some of the gigawatt-scale
projects announced in 2025 would, on their own, exceed all the data-centre
capacity their host country has today (International Energy Agency, 2026,
p. 20).
Figure 11. The electricity use of data centres, counted in households. Data: International Energy Agency (2025, p. 13).
The pace is as striking as the size:
Capacity: the capacity of data centres built for AI more than tripled
in the 18 months before April 2026 (International Energy Agency, 2026,
p. 9).
Investment: the capital spending of just five technology companies,
largely on data centres, is now larger than the world’s investment in
producing oil and natural gas (International Energy Agency, 2026, p. 9).
The companies building the data centres are largely the ones that own the
models and the clouds.
Electricity
All data centres together, for AI and for everything else, used
about 1.5 % of the world’s electricity in 2024 (International Energy Agency,
2025). Their consumption grew by 17 % in 2025, that of the data centres built
for AI by 50 %, and the total is expected to roughly double between 2025 and
2030, to around 3 % of the world’s electricity (International Energy Agency,
2026). Because data centres cluster, the share is far higher in some places:
about 20 % of the electricity supplied in Ireland, over 10 % in six US states,
and 25 % in Virginia (International Energy Agency, 2025, p. 38;
Figure 12figure 12).
Figure 12. The share of electricity that goes to data centres. Data: International Energy Agency (2025, pp. 13, 38) for 2024, Ireland and Virginia; International Energy Agency (2026) for 2030.
Figure 13. Google's data centre at Eemshaven, in the Netherlands, among wind turbines, with a power station in the background, photographed on 6 January 2023. Photo: Wvdp, CC0, via Wikimedia Commons.
The International Energy Agency (2025, p. 14) expects the growth to be supplied
from several sources:
Renewables supply about half of the growth in data centres’ demand, with
storage and the wider grid.
Natural gas adds about 175 terawatt-hours a year by 2035, notably in the
United States.
Nuclear power adds about as much again, notably in China, Japan and the
United States, with the first small modular reactors expected around 2030.
Water
Data centres use water in two places: to cool their servers on site, and at
the power plants that generate their electricity. Two measures of it are in
use, and they give very different numbers:
Withdrawal is all the water taken from rivers, lakes or the ground,
including water that is returned afterwards.
Consumption is the part that is not returned, mostly because it
evaporates (Li et al., 2025d).
Figure 14. Water withdrawn and water consumed, and where the water data centres consume goes. Data: International Energy Agency (2025, p. 242); the two measures as Li et al. (2025d) define them.
The International Energy Agency (2025, p. 242) puts the water consumption of
all data centres at about 560 billion litres a year
(Figure 14figure 14), a figure that could
roughly double by 2030. About two thirds of that water is used in producing
their electricity, a quarter in cooling them, and the rest in manufacturing
their chips. One large data centre of 100 megawatts in the United States
consumes about 2 million litres a day, as much as 6,500 households.
Li et al. (2025d) project that the water withdrawn for AI alone, for cooling
and at the power plants, could reach 4.2 to 6.6 billion cubic metres in
2027, more than four to six times what Denmark withdraws in a
year.A projection first made in 2023, in the preprint of the same study.
Set against other uses of water, these amounts are small on a national
scale. In 2023, all the data centres in the United States consumed about 66
billion litres on site, against more than 10 trillion litres for irrigating
the country’s corn (Masley, 2026b).Masley’s figure for data centres comes from the Lawrence Berkeley National Laboratory’s 2024 report, and counts only the water used on site, not at the power plants. He notes that some of his comparisons across kinds of use are not like-for-like.
Air, noise and land
Many data centres keep diesel generators for power cuts, and some newer ones
generate their own electricity on site, mostly from gas. The largest project
of this kind so far, in Tennessee, ran more than 400 megawatts of gas turbines
on site in 2024 and 2025, and more than 70 gigawatts of on-site gas-fired
capacity for data centres is in development (International Energy Agency,
2026, p. 51). Burning that gas and diesel near homes adds to local air
pollution
(Figure 15figure 15).
Figure 15. The roof of a data centre, with rows of cooling units and, to the left, backup generators, photographed on 23 November 2025. Photo: Rsparks3, CC0, via Wikimedia Commons.
Han et al. (2026) estimate that, in a scenario of high growth, the
air pollution from US data centres’ electricity and backup generators could
cost more than 20 billion US dollars a year in public health by 2028, and
that the burden per household in the most affected counties reaches about
seven times the national average.A preprint, accepted by Communications of the ACM. The estimate comes from the US Environmental Protection Agency’s screening model COBRA, and assumes backup generators emit 10 % of what their permits allow, where historical records show 3 % to 12 %.
A data centre also changes its surroundings directly. The buildings are
large, windowless and often grouped into campuses, with substations and new
power lines around them, sometimes on land that was fields or woods. Their
cooling equipment runs day and night, and can be heard from nearby homes.
Andy Masley, a writer who argues that most local objections to data centres
are not well founded, agrees that their local air pollution is real, with xAI’s
Colossus in South Memphis, powered by gas turbines next to already polluted
neighbourhoods, as the clearest case. He argues, however, that the estimate
of Han et al. is easy to read as a larger national harm than it is (Masley,
2026a).
Why they draw protests
A data centre is the part of AI that people can stand next to. A query has no
address, but a data centre has a site, a permit, a local council that decides
on it and neighbours who live with it. That makes it the place where the
environmental debate about AI turns into local politics. Masley (2025a) turns
the same observation around: the climate responds to total emissions wherever
they happen, and pooling computing in data centres uses less energy than
running it on everyone’s own machines, so a building people can see can draw
more attention than its share of the emissions warrants.
Communities are pushing back against data-centre projects, over their
environmental impact and over the effect of their electricity demand on
prices (International Energy Agency, 2026, p. 10). In the second quarter of
2025 alone, 20 projects in the United States with an estimated investment of
98 billion US dollars were blocked or delayed (International Energy Agency,
2026, p. 22).The IEA takes this count from Data Center Watch, a commercial tracker of local opposition. Its own report for April to June 2026 counts at least 45 projects worth nearly 68 billion US dollars blocked or delayed in that quarter, communities adopting moratoriums before any developer applied, and 30 US state legislatures taking up data-centre bills (Data Center Watch, Q2 2026, read 24 September 2026).
The reasons residents give are mostly local, for instance:
higher electricity bills;
water;
noise;
property values and the loss of green space;
the environment.The common themes named in Data Center Watch’s first report, on May 2024 to March 2025 (Data Center Watch, read 24 September 2026).
Not everyone reads the protests as justified. Masley reads the backlash as
being about data centres themselves and what people believe about them, not
as a hidden protest against AI or against the companies building them: in the
polls he cites, data centres are far less popular than other buildings the
same companies put up (Masley, 2026c). Of the claims made against them, he
accepts four (Masley, 2026f):
data centres will add meaningfully to US emissions;
xAI’s data centres in Memphis added air pollution to already polluted
neighbourhoods;
data centres built right next to homes cause noise;
in specific circumstances, they can raise electricity bills somewhat.
Sources
Han, Y., Wu, Z., Li, P., Wierman, A., & Ren, S. (2026). Health-Informed Computing: Estimating and Addressing the Public Health Impact of Data Centers. arXiv preprint arXiv:2412.06288, version 4. https://arxiv.org/abs/2412.06288
Chaque question que vous posez à un assistant conversationnel en ligne, et
chaque entraînement, est traité dans un centre de traitement de données
(Figure 10figure 10).
Figure 10. Des centres de traitement de données parmi d'autres bâtiments commerciaux dans le comté de Loudoun, en Virginie, près d'Ashburn, photographiés d'un avion le 26 novembre 2025. Photo : Theodore Christopher, CC0, via Wikimedia Commons.
Leur taille
Un centre de traitement de données typique conçu pour l’IA consomme autant
d’électricité que 100 000 ménages, et les plus grands en construction
consommeront vingt fois plus (International Energy Agency, 2025, p. 13 ;
Figure 11figure 11).
Certains des projets de l’ordre du gigawatt annoncés en 2025 dépasseraient à
eux seuls toute la capacité de centres de traitement de données dont dispose
aujourd’hui le pays qui les accueille (International Energy Agency, 2026,
p. 20).
Figure 11. La consommation d'électricité des centres de traitement de données, comptée en ménages. Données : Agence internationale de l'énergie (2025, p. 13).
Le rythme frappe autant que la taille :
Capacité : la capacité des centres de traitement de données conçus pour
l’IA a plus que triplé au cours des 18 mois précédant avril 2026
(International Energy Agency, 2026, p. 9).
Investissement : les dépenses d’investissement de cinq entreprises
technologiques seulement, en grande partie dans des centres de traitement de
données, dépassent désormais l’investissement mondial dans la production de
pétrole et de gaz naturel (International Energy Agency, 2026, p. 9). Les
entreprises qui construisent ces centres sont en grande partie celles qui
possèdent les modèles et les
nuages.
Électricité
L’ensemble des centres de traitement de données, pour l’IA comme pour tout le
reste, a consommé environ 1,5 % de l’électricité mondiale en 2024
(International Energy Agency, 2025). Leur consommation a augmenté de 17 % en
2025, celle des centres conçus pour l’IA de 50 %, et le total devrait à peu
près doubler entre 2025 et 2030, pour atteindre environ 3 % de l’électricité
mondiale (International Energy Agency, 2026). Comme les centres de traitement
de données se regroupent, la part est bien plus élevée à certains endroits :
environ 20 % de l’électricité fournie en Irlande, plus de 10 % dans six États
américains et 25 % en Virginie (International Energy Agency, 2025, p. 38 ;
Figure 12figure 12).
Figure 12. La part de l'électricité consommée par les centres de traitement de données. Données : Agence internationale de l'énergie (2025, pp. 13, 38) pour 2024, l'Irlande et la Virginie ; Agence internationale de l'énergie (2026) pour 2030.
La provenance de cette électricité détermine l’essentiel des émissions : le
même centre émet bien moins sur un réseau hydroélectrique, nucléaire ou
éolien que sur un réseau au charbon ou au gaz
(Figure 13figure 13) (see also the What one use costs page, in the Critical issues with LLMs module) (voir aussi la page Ce que coûte une utilisation, dans le module Enjeux critiques des GML).
Figure 13. Le centre de traitement de données de Google à Eemshaven, aux Pays-Bas, parmi des éoliennes, avec une centrale électrique à l'arrière-plan, photographié le 6 janvier 2023. Photo : Wvdp, CC0, via Wikimedia Commons.
L’Agence internationale de l’énergie (2025, p. 14) prévoit que la croissance
sera couverte par plusieurs sources :
Les énergies renouvelables couvrent environ la moitié de la croissance
de la demande des centres de traitement de données, avec le stockage et le
reste du réseau.
Le gaz naturel ajoute environ 175 térawattheures par an d’ici 2035,
notamment aux États-Unis.
Le nucléaire en ajoute à peu près autant, notamment en Chine, au Japon
et aux États-Unis, les premiers petits réacteurs modulaires étant attendus
vers 2030.
Eau
Les centres de traitement de données utilisent de l’eau à deux endroits :
pour refroidir leurs serveurs sur place, et dans les centrales qui produisent
leur électricité. Deux mesures sont en usage, et elles donnent des chiffres
très différents :
Le prélèvement désigne toute l’eau puisée dans les rivières, les lacs ou
les nappes souterraines, y compris l’eau qui y est rendue ensuite.
La consommation désigne la part qui n’est pas rendue, surtout parce
qu’elle s’évapore (Li et al., 2025d).
Figure 14. L'eau prélevée et l'eau consommée, et où va l'eau que consomment les centres de traitement de données. Données : Agence internationale de l'énergie (2025, p. 242) ; les deux mesures telles que les définissent Li et al. (2025d).
L’Agence internationale de l’énergie (2025, p. 242) estime la consommation
d’eau de l’ensemble des centres de traitement de données à environ
560 milliards de litres par an
(Figure 14figure 14),
un chiffre qui pourrait à peu près doubler d’ici 2030. Environ deux tiers de
cette eau servent à produire leur électricité, un quart à les refroidir, et le
reste à fabriquer leurs puces. Un grand centre de 100 mégawatts aux
États-Unis consomme environ 2 millions de litres par jour, autant que
6 500 ménages.
Li et al. (2025d) prévoient que l’eau prélevée pour la seule IA, pour le
refroidissement et dans les centrales, pourrait atteindre de 4,2 à
6,6 milliards de mètres cubes en 2027, soit plus de quatre à six fois ce que
prélève le Danemark en un an.Une projection faite pour la première fois en 2023, dans la prépublication de la même étude.
Comparées à d’autres usages de l’eau, ces quantités sont faibles à l’échelle
d’un pays. En 2023, l’ensemble des centres de traitement de données des
États-Unis a consommé environ 66 milliards de litres sur place, contre plus
de 10 000 milliards de litres pour irriguer le maïs du pays (Masley,
2026b).Le chiffre de Masley pour les centres de traitement de données vient du rapport 2024 du Lawrence Berkeley National Laboratory, et ne compte que l’eau utilisée sur place, pas dans les centrales. Masley note que certaines de ses comparaisons entre types d’usage ne portent pas sur des choses équivalentes.
Air, bruit et territoire
Beaucoup de centres de traitement de données gardent des génératrices au
diesel en cas de panne, et certains des plus récents produisent leur propre
électricité sur place, surtout à partir du gaz. Le plus grand projet de ce
type jusqu’ici, au Tennessee, a fait fonctionner plus de 400 mégawatts de
turbines à gaz sur place en 2024 et 2025, et plus de 70 gigawatts de capacité
au gaz sur place sont en développement pour des centres de traitement de
données (International Energy Agency, 2026, p. 51). Brûler ce gaz et ce
diesel près des habitations ajoute à la pollution de l’air locale
(Figure 15figure 15).
Figure 15. Le toit d'un centre de traitement de données, avec des rangées d'appareils de refroidissement et, à gauche, des génératrices de secours, photographié le 23 novembre 2025. Photo : Rsparks3, CC0, via Wikimedia Commons.
Han et al. (2026) estiment que, dans un scénario de forte croissance, la
pollution de l’air due à l’électricité et aux génératrices de secours des
centres de traitement de données américains pourrait coûter plus de
20 milliards de dollars américains par an en santé publique d’ici 2028, et
que la charge par ménage dans les comtés les plus touchés atteint environ sept
fois la moyenne nationale.Une prépublication, acceptée par Communications of the ACM. L’estimation vient de COBRA, le modèle de dépistage de l’agence américaine de protection de l’environnement, et suppose que les génératrices de secours émettent 10 % de ce que leurs permis autorisent, alors que les données historiques montrent de 3 % à 12 %.
Un centre de traitement de données modifie aussi directement son
environnement. Les bâtiments sont grands, sans fenêtres et souvent regroupés
en campus, entourés de postes électriques et de nouvelles lignes de
transport, parfois sur des terres qui étaient des champs ou des bois. Leurs
équipements de refroidissement fonctionnent jour et nuit et s’entendent
depuis les maisons voisines.
Andy Masley, un auteur qui soutient que la plupart des objections locales aux
centres de traitement de données ne tiennent pas, reconnaît que la pollution
de l’air locale qu’ils causent est réelle, le cas le plus net étant Colossus,
de xAI, dans le sud de Memphis, alimenté par des turbines à gaz à côté de
quartiers déjà pollués. Il soutient cependant que l’estimation de Han et al.
se prête à une lecture qui en fait un tort national plus grand qu’il ne l’est
(Masley, 2026a).
Pourquoi ils suscitent des contestations
Un centre de traitement de données est la partie de l’IA à côté de laquelle
on peut se tenir. Une requête n’a pas d’adresse, mais un centre de traitement
de données a un emplacement, un permis, un conseil municipal qui statue à son
sujet et des voisins qui vivent avec. C’est donc là que le débat
environnemental sur l’IA devient de la politique locale. Masley (2025a)
retourne le même constat : le climat réagit aux émissions totales où qu’elles
se produisent, et regrouper le calcul dans des centres de traitement de
données consomme moins d’énergie que de le faire tourner sur les machines de
chacun, si bien qu’un bâtiment visible peut attirer plus d’attention que sa
part des émissions ne le justifie.
Des collectivités s’opposent à des projets de centres de traitement de
données, en raison de leur impact environnemental et de l’effet de leur
demande d’électricité sur les prix (International Energy Agency, 2026,
p. 10). Au seul deuxième trimestre de 2025, 20 projets aux États-Unis,
représentant un investissement estimé à 98 milliards de dollars américains,
ont été bloqués ou retardés (International Energy Agency, 2026,
p. 22).L’AIE tire ce décompte de Data Center Watch, un service commercial qui suit l’opposition locale. Son propre rapport pour avril à juin 2026 compte au moins 45 projets, d’une valeur de près de 68 milliards de dollars américains, bloqués ou retardés pendant ce trimestre, des collectivités qui adoptent des moratoires avant même qu’un promoteur ait fait une demande, et 30 assemblées législatives d’États américains qui examinent des projets de loi sur les centres de données (Data Center Watch, Q2 2026, consulté le 24 septembre 2026).
Les raisons avancées par les résidents sont surtout locales, par exemple :
la hausse des factures d’électricité ;
l’eau ;
le bruit ;
la valeur des propriétés et la perte d’espaces verts ;
l’environnement.Les thèmes communs relevés dans le premier rapport de Data Center Watch, portant sur mai 2024 à mars 2025 (Data Center Watch, consulté le 24 septembre 2026).
Tout le monde ne juge pas ces contestations justifiées. Masley voit dans ce
mouvement une réaction aux centres de traitement de données eux-mêmes et à ce
que les gens en pensent, et non une contestation déguisée de l’IA ou des
entreprises qui les construisent : dans les sondages qu’il cite, les centres
de données sont bien moins populaires que d’autres bâtiments construits par
les mêmes entreprises (Masley, 2026c). Parmi les reproches qui leur sont faits,
il en accepte quatre (Masley, 2026f) :
les centres de traitement de données augmenteront de façon notable les
émissions des États-Unis ;
les centres de xAI à Memphis ont ajouté de la pollution de l’air à des
quartiers déjà pollués ;
les centres construits juste à côté des habitations causent du bruit ;
dans certaines circonstances, ils peuvent faire augmenter quelque peu les
factures d’électricité.
Sources
Han, Y., Wu, Z., Li, P., Wierman, A., & Ren, S. (2026). Health-Informed Computing: Estimating and Addressing the Public Health Impact of Data Centers. arXiv preprint arXiv:2412.06288, version 4. https://arxiv.org/abs/2412.06288
Figure 16. Four ways of counting the cost of the same query, with an example of each, from Elsworth et al. (2025) and Mistral AI (2025).
The boundary changes the figure considerably. For the same median prompt,
Google’s figure is 0.10 watt-hours when only the active chips are counted,
in its most efficient data centres, and 0.24 when the host machines, the
idle capacity and the rest of the data centre are counted across its whole
fleet (Elsworth et al., 2025). Two figures computed differently therefore
cannot be set against each other.
Figure 17. The lifecycle table from Mistral's infographic, published with its assessment on 22 July 2025 (Mistral AI, 2025). The boxes of advice under the table are left out.
Efficiency moves
The energy of one query can fall sharply within a year, by a factor of 33
in the case Google reported (see also the Efficiency and rebound page, in the Critical issues with LLMs module) (voir aussi la page Efficacité et effet rebond, dans le module Enjeux critiques des GML).
A figure from a year ago can therefore overstate the current cost
substantially, and a number without a date is not usable.
Where a figure comes from
The sources of environmental figures for AI differ in what they can tell
you, and the table below sets out four kinds.
Source
Example
What to keep in mind
A provider’s own report
Mistral’s lifecycle assessment, prepared with a consultancy and ADEME, the French ecological transition agency, and reviewed by two other consultancies (Mistral AI, 2025)
The data are the provider’s own, and Mistral itself calls the study “a first approximation”
A provider’s research paper
Google’s measurement of its Gemini apps (Elsworth et al., 2025)
Detailed on method, but a preprint, written by the provider’s staff about the provider’s own service
Peer-reviewed research
Luccioni et al. (2024), who ran a thousand queries per dataset on each of 88 open models
Measured under controlled conditions and firmer, but narrower: it covers the models and tasks that were tested
A newspaper figure
a comparison with a household appliance or a bottle of water
Often derived from one of the three above, sometimes in several steps: trace it back to the measurement behind it
Four kinds of source for the environmental cost of AI, and what to keep in mind about each.
Sources
Elsworth, C., Huang, K., Patterson, D., Schneider, I., Sedivy, R., Goodman, S., Townsend, B., Ranganathan, P., Dean, J., Vahdat, A., Gomes, B., & Manyika, J. (2025). Measuring the environmental impact of delivering AI at Google Scale. arXiv preprint arXiv:2508.15734. https://doi.org/10.48550/arXiv.2508.15734
Luccioni, A. S., Jernite, Y., & Strubell, E. (2024). Power Hungry Processing: Watts Driving the Cost of AI Deployment?. Proceedings of the 2024 ACM Conference on Fairness, Accountability, and Transparency (FAccT '24). https://arxiv.org/abs/2311.16863
Les chiffres sur le coût environnemental de l’IA se contredisent souvent, et
la plupart de ces désaccords viennent de la façon dont ils ont été produits.
Figure 16. Quatre façons de compter le coût d'une même requête, avec un exemple pour chacune, d'après Elsworth et al. (2025) et Mistral AI (2025).
Le périmètre change le chiffre considérablement. Pour la même requête
médiane, le chiffre de Google est de 0,10 wattheure quand seules les puces
actives sont comptées, dans ses centres les plus efficaces, et de 0,24 quand
les machines hôtes, la capacité inactive et le reste du centre sont comptés
sur l’ensemble de son parc (Elsworth et al., 2025). Deux chiffres calculés
différemment ne peuvent donc pas être mis en regard l’un de l’autre.
Figure 17. Le tableau du cycle de vie tiré de l'infographie de Mistral, publiée avec son analyse le 22 juillet 2025 (Mistral AI, 2025). Les encadrés de conseils sous le tableau ne sont pas reproduits.
L’efficacité évolue
L’énergie d’une requête peut baisser fortement en un an, d’un facteur 33 dans
le cas rapporté par Google (see also the Efficiency and rebound page, in the Critical issues with LLMs module) (voir aussi la page Efficacité et effet rebond, dans le module Enjeux critiques des GML).
Un chiffre vieux d’un an peut donc nettement surestimer le coût actuel, et un
chiffre sans date n’est pas utilisable.
D’où vient un chiffre
Les sources de chiffres environnementaux sur l’IA ne peuvent pas vous
apprendre les mêmes choses ; le tableau ci-dessous en présente quatre types.
Source
Exemple
À garder en tête
Le rapport d’un fournisseur
L’analyse du cycle de vie de Mistral, préparée avec un cabinet de conseil et l’ADEME, l’Agence de la transition écologique, puis revue par deux autres cabinets (Mistral AI, 2025)
Les données sont celles du fournisseur, et Mistral qualifie lui-même l’étude de « first approximation » [ma traduction : « première approximation »]
L’article de recherche d’un fournisseur
La mesure de Google sur ses applications Gemini (Elsworth et al., 2025)
Détaillé sur la méthode, mais c’est une prépublication, écrite par le personnel du fournisseur sur le service du fournisseur
La recherche évaluée par les pairs
Luccioni et al. (2024), qui ont lancé un millier de requêtes par jeu de données sur chacun de 88 modèles ouverts
Mesurée dans des conditions contrôlées et plus solide, mais plus étroite : elle ne couvre que les modèles et les tâches testés
Un chiffre dans un journal
une comparaison avec un appareil ménager ou une bouteille d’eau
Souvent tiré de l’une des trois sources ci-dessus, parfois en plusieurs étapes : remontez jusqu’à la mesure qui le fonde
Quatre types de sources sur le coût environnemental de l'IA, et ce qu'il faut garder en tête pour chacune.
Sources
Elsworth, C., Huang, K., Patterson, D., Schneider, I., Sedivy, R., Goodman, S., Townsend, B., Ranganathan, P., Dean, J., Vahdat, A., Gomes, B., & Manyika, J. (2025). Measuring the environmental impact of delivering AI at Google Scale. arXiv preprint arXiv:2508.15734. https://doi.org/10.48550/arXiv.2508.15734
Luccioni, A. S., Jernite, Y., & Strubell, E. (2024). Power Hungry Processing: Watts Driving the Cost of AI Deployment?. Proceedings of the 2024 ACM Conference on Fairness, Accountability, and Transparency (FAccT '24). https://arxiv.org/abs/2311.16863
Asking whether your own use of a chat assistant harms the environment, and
asking whether the build-out of AI infrastructure harms it, are different
questions with different answers. The table below sets them side by side.
Your own use
The build-out of AI
The question
Does using a chat assistant harm the environment?
Does the expansion of AI’s infrastructure harm it?
How large
Small for plain text: about a gram of CO2 for a short answer
Large and growing: the electricity use of data centres is expected to roughly double by 2030
What changes it
The size of the model, the reasoning effort, the kind of output and how often you generate again
Investment, where data centres are built and on which grid, and the rules they have to follow
Over a year, the numbers stay small next to other things people do. Andy
Masley’s (2026e) online calculator puts a typical day of chatbot use, 27
prompts to three current models, at about 7.6 kilograms of CO2 a year: about as much as
a cotton T-shirt, a tenth of a year of daily coffee, and a small fraction of
a single long flight
(Figure 18figure 18).The calculator takes each model’s energy from EcoLogits, an open-source, peer-reviewed estimator (Rincé & Banse, 2025), puts it on the US grid, and includes the manufacture of the hardware but not training or image and video generation. Masley notes that the figures for Claude are based on guesses about how those models are built. He is an independent writer, funded by a grant from Coefficient Giving and writing from an effective altruist perspective, who argues that personal chatbot use has little climate impact. Captured 24 September 2026.
Figure 18. A year of typical chatbot use next to other sources of emissions, in Andy Masley's calculator, captured on 24 September 2026. The calculator is dedicated to the public domain.
Masley (2025b) adds an argument about scale: a small share of one person’s
emissions stays the same small share of the world’s however many people cut
it, so a change that barely affects your own footprint barely affects the
world’s either, and changes to the electricity grid do far more than changes
to what each person does.
The International Energy Agency’s figures give the scale of it:
Among the fastest-growing sources of emissions. The electricity used by
data centres emitted about 180 million tonnes of CO2 in 2024, and the agency
expects about 300 million by 2035, which would still be below 1.5 % of the
energy sector’s emissions (International Energy Agency, 2025, p. 18).
One driver of electricity demand among several. Data centres account
for about a tenth of the growth in the world’s electricity demand to 2030,
less than industrial motors, air conditioning or electric vehicles, but
their demand is concentrated in a few places (International Energy Agency,
2025, pp. 14, 38).
AI is also used to cut emissions in other sectors, for instance to forecast
the output of wind and solar power, locate faults on electricity grids, or run
buildings and factories more efficiently (International Energy Agency, 2025,
pp. 15–16). These are mostly uses of AI other than chatbots. The agency
estimates that the broad use of AI applications that exist today could cut
emissions by the equivalent of about 5 % of energy-related emissions in 2035 (International
Energy Agency, 2025, p. 18). That would be far more than data centres
emit, but far less than what is needed to address climate change. The agency
adds that the savings depend on overcoming barriers to adoption, that rebound
effects could undercut them, and that AI “is not a silver bullet”.
There are many good reasons to decline these tools. The environmental reason
is strongest for the heavy uses: generating video, running agents over many
steps, or using the largest model for
a task a small one would do.
Where you can choose, preferring providers that publish their figures also
helps, since only disclosure makes any of this measurable.
A search engine or a chatbot
For a question a search engine can answer, two things weigh on the choice
between searching and asking a chatbot:
A chatbot answer costs less than first estimated. An estimate made
in 2023 put one chatbot answer at about 3 watt-hours, some ten times
the 0.3 reported for a Google search (de Vries, 2023, p. 2192). The
figures companies published in 2025 are about a tenth of that: 0.24
watt-hours for Google’s median Gemini prompt and 0.34 for the average
ChatGPT query, and they are likely lower already (International Energy
Agency, 2026, p. 32).
A search may now generate text as well. Google, for instance, calls its
AI Overviews a core feature of Search that cannot be turned off; the Web
filter, chosen after a search, shows only the
links.From Google’s help page on AI Overviews (Google Search Help, read 24 September 2026).
A list of results still gives you the sources to check, which is a reason of
its own to search when the question is one of fact.
A small model several times, or a large one once
A smaller model costs less per answer, roughly in proportion to its size
(Mistral AI, 2025), but it may take several tries to give an answer you can
use, and each try is a full generation. Several tries on a model a tenth of
the size still cost less than one answer from the large model. The comparison
turns with reasoning: in the International Energy
Agency’s comparison, a medium-sized model with reasoning turned on used 7.6
watt-hours for one answer, where a larger model without it used 0.31
(International Energy Agency, 2026, p. 29) (see also the What one use costs page, in the Critical issues with LLMs module) (voir aussi la page Ce que coûte une utilisation, dans le module Enjeux critiques des GML).
Your own time counts as well: an answer you can use at the first try saves
the time spent reading and correcting the others.
Elsworth, C., Huang, K., Patterson, D., Schneider, I., Sedivy, R., Goodman, S., Townsend, B., Ranganathan, P., Dean, J., Vahdat, A., Gomes, B., & Manyika, J. (2025). Measuring the environmental impact of delivering AI at Google Scale. arXiv preprint arXiv:2508.15734. https://doi.org/10.48550/arXiv.2508.15734
Rincé, S., & Banse, A. (2025). EcoLogits: Evaluating the Environmental Impacts of Generative AI. Journal of Open Source Software, 10(111), 7471. https://doi.org/10.21105/joss.07471
Se demander si votre propre utilisation d’un assistant conversationnel nuit à
l’environnement, et se demander si l’expansion des infrastructures de l’IA lui
nuit, sont deux questions différentes, aux réponses différentes. Le tableau
ci-dessous les met côte à côte.
Votre propre utilisation
L’expansion de l’IA
La question
Utiliser un assistant conversationnel nuit-il à l’environnement ?
L’expansion des infrastructures de l’IA lui nuit-elle ?
L’ampleur
Faible pour du texte seul : environ un gramme de CO2 pour une courte réponse
Importante et en hausse : la consommation d’électricité des centres de traitement de données devrait à peu près doubler d’ici 2030
Ce qui la fait varier
La taille du modèle, l’effort de raisonnement, le type de sortie et la fréquence à laquelle vous relancez la génération
L’investissement, l’emplacement des centres et le réseau qui les alimente, et les règles qu’ils doivent suivre
Sur une année, les chiffres restent faibles à côté d’autres activités. Le
calculateur en ligne d’Andy Masley (2026e) estime une journée type
d’utilisation d’agents conversationnels, 27 requêtes à trois modèles actuels,
à environ 7,6 kilogrammes de CO2 par an : à peu près autant qu’un t-shirt en
coton, un dixième d’une année de café quotidien, et une petite fraction d’un
seul vol long-courrier
(Figure 18figure 18).Le calculateur tire l’énergie de chaque modèle d’EcoLogits, un estimateur libre évalué par les pairs (Rincé & Banse, 2025), la rapporte au réseau américain, et inclut la fabrication du matériel, mais pas l’entraînement ni la génération d’images et de vidéos. Masley note que les chiffres pour Claude reposent sur des hypothèses sur la conception de ces modèles. C’est un auteur indépendant, financé par une subvention de Coefficient Giving et qui écrit dans une perspective d’altruisme efficace ; il soutient que l’utilisation personnelle des agents conversationnels a peu d’impact sur le climat. Capture du 24 septembre 2026.
Figure 18. Une année d'utilisation typique d'agents conversationnels à côté d'autres sources d'émissions, dans le calculateur d'Andy Masley, capture du 24 septembre 2026. Le calculateur est versé dans le domaine public.
Masley (2025b) ajoute un argument d’échelle : une petite part des émissions
d’une personne reste la même petite part de celles du monde, quel que soit le
nombre de personnes qui la réduisent ; un changement qui touche à peine votre
propre empreinte touche donc à peine celle du monde, et les changements dans
le réseau électrique font bien plus que les changements dans ce que fait
chacun.
Les chiffres de l’Agence internationale de l’énergie en donnent l’ampleur :
Parmi les sources d’émissions qui croissent le plus vite. L’électricité
consommée par les centres de traitement de données a émis environ
180 millions de tonnes de CO2 en 2024, et l’agence en prévoit environ 300
millions d’ici 2035, ce qui resterait sous 1,5 % des émissions du secteur de
l’énergie (International Energy Agency, 2025, p. 18).
Une cause de la demande d’électricité parmi d’autres. Les centres de
traitement de données représentent environ un dixième de la croissance de la
demande mondiale d’électricité d’ici 2030, moins que les moteurs
industriels, la climatisation ou les véhicules électriques, mais leur
demande est concentrée en quelques endroits (International Energy Agency,
2025, pp. 14, 38).
L’IA sert aussi à réduire les émissions d’autres secteurs, par exemple pour
prévoir la production éolienne et solaire, localiser les pannes sur les
réseaux électriques, ou rendre les bâtiments et les usines plus efficaces
(International Energy Agency, 2025, pp. 15–16). Il s’agit surtout d’usages de
l’IA autres que les agents conversationnels. L’agence estime que l’adoption
générale d’applications d’IA qui existent déjà pourrait réduire les émissions
de l’équivalent d’environ 5 % des émissions liées à l’énergie en 2035
(International Energy Agency, 2025, p. 18). Ce serait bien plus que ce
qu’émettent les centres de traitement de données, mais bien moins que ce qu’il
faut pour faire face aux changements climatiques. L’agence ajoute que ces
économies dépendent de la levée d’obstacles à l’adoption, que des effets
rebond pourraient les réduire, et que l’IA « is not a silver bullet » [ma
traduction : « n’est pas une solution miracle »].
Il y a bien des bonnes raisons de refuser ces outils. La raison
environnementale est la plus forte pour les usages lourds : générer de la
vidéo, faire tourner des agents sur de nombreuses étapes, ou utiliser le plus
grand modèle pour une tâche qu’un petit ferait.
Quand vous avez le choix, privilégier les fournisseurs qui publient leurs
chiffres aide aussi, puisque seule la divulgation permet de mesurer quoi que ce
soit de tout cela.
Un moteur de recherche ou un agent conversationnel
Pour une question à laquelle un moteur de recherche peut répondre, deux
éléments pèsent sur le choix entre chercher et interroger un agent
conversationnel :
Une réponse d’agent conversationnel coûte moins qu’on ne l’estimait au
départ. Une estimation faite en 2023 situait une réponse d’agent
conversationnel à environ 3 wattheures, quelque dix fois les 0,3 rapportés
pour une recherche Google (de Vries, 2023, p. 2192). Les chiffres publiés
par les entreprises en 2025 en représentent environ un dixième : 0,24
wattheure pour la requête médiane de Gemini de Google et 0,34 pour la
requête moyenne de ChatGPT, et ils sont probablement déjà plus bas
(International Energy Agency, 2026, p. 32).
Une recherche peut désormais produire du texte, elle aussi. Google, par
exemple, présente ses aperçus IA (AI Overviews) comme une fonction de base
de la recherche qui ne peut pas être désactivée ; le filtre Web, choisi après
une recherche, n’affiche que les
liens.D’après la page d’aide de Google sur les AI Overviews (Aide Recherche Google, consultée le 24 septembre 2026).
Une liste de résultats vous donne toujours les sources à vérifier, ce qui est
en soi une raison de chercher quand la question porte sur un fait.
Un petit modèle plusieurs fois, ou un grand une seule fois
Un modèle plus petit coûte moins par réponse, à peu près en proportion de sa
taille (Mistral AI, 2025), mais il faut parfois plusieurs essais pour obtenir
une réponse utilisable, et chaque essai est une génération complète. Plusieurs
essais sur un modèle dix fois plus petit coûtent tout de même moins qu’une
réponse du grand modèle. La comparaison s’inverse avec le raisonnement : dans
la comparaison de l’Agence internationale de l’énergie, un modèle de taille
moyenne avec le raisonnement activé consommait 7,6 wattheures pour une
réponse, contre 0,31 pour un modèle plus grand sans raisonnement
(International Energy Agency, 2026,
p. 29) (see also the What one use costs page, in the Critical issues with LLMs module) (voir aussi la page Ce que coûte une utilisation, dans le module Enjeux critiques des GML). Votre
propre temps compte aussi : une réponse utilisable du premier coup vous
épargne le temps passé à lire et à corriger les autres.
Elsworth, C., Huang, K., Patterson, D., Schneider, I., Sedivy, R., Goodman, S., Townsend, B., Ranganathan, P., Dean, J., Vahdat, A., Gomes, B., & Manyika, J. (2025). Measuring the environmental impact of delivering AI at Google Scale. arXiv preprint arXiv:2508.15734. https://doi.org/10.48550/arXiv.2508.15734
Rincé, S., & Banse, A. (2025). EcoLogits: Evaluating the Environmental Impacts of Generative AI. Journal of Open Source Software, 10(111), 7471. https://doi.org/10.21105/joss.07471