Zero-shot and few-shot promptingRequêtes sans exemple et avec quelques exemples
TRA6008 OptionalFacultatif
Describing a task or showing it
You can describe a task in your prompt and let the model carry it out, which is called zero-shot prompting, or first show it a few examples of what you want, which is called few-shot prompting. With a single example, it is sometimes called one-shot prompting.
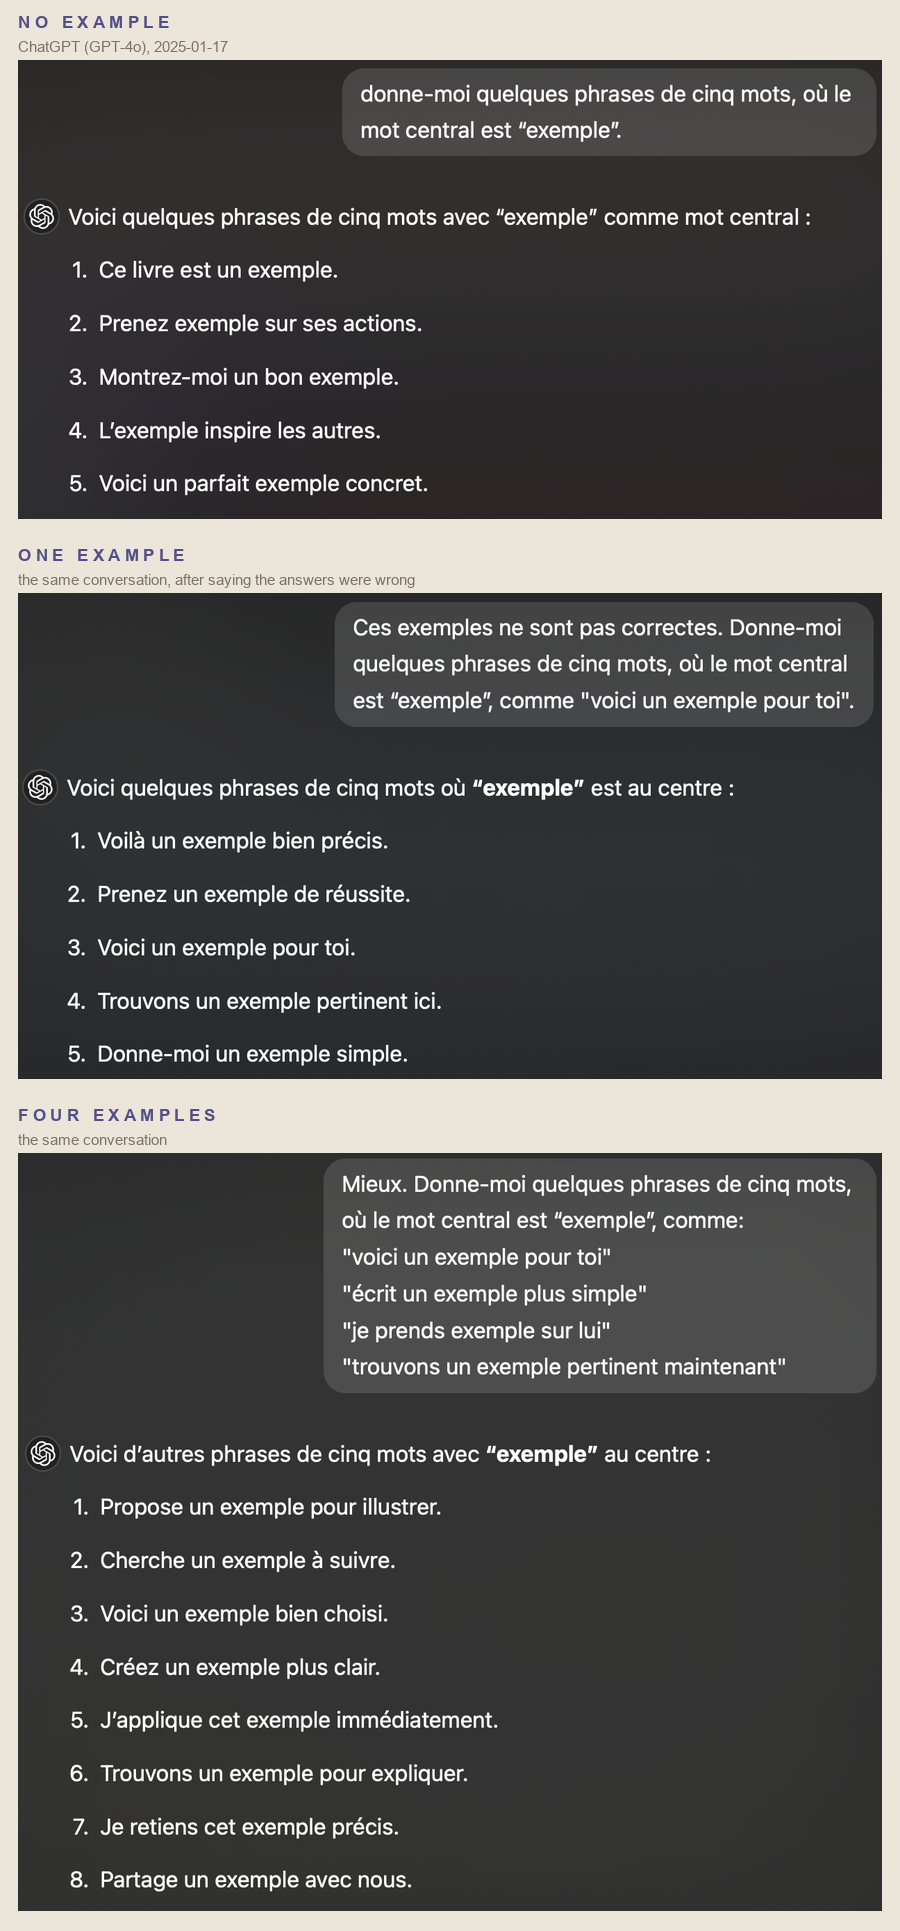
In Figure 3figure 3, ChatGPT is first asked, in French, for a few phrases of five words with exemple as the middle word. None of its five answers fits. In the same conversation, after being told that the answers were wrong and given one example, four of its five answers fit, although one simply repeats the example. After four examples, seven of its eight answers fit. Because everything happened in one conversation, part of the improvement may come from the correction rather than from the examples alone (see also the Giving examples page, in the Using LLMs module) (voir aussi la page Donner des exemples, dans le module Utiliser les GML).
What examples show the model
Examples show a model more than the answer to each case: what an input looks like, which answers are possible and what format an answer takes. With older, smaller models, these could matter more than whether the answers in the examples were right (Min et al., 2022), but larger models follow the answers in the examples more closely, so wrong examples are more likely to mislead them (Wei et al., 2023b; Shi et al., 2024).
Décrire une tâche ou la montrer
Vous pouvez décrire une tâche dans votre requête et laisser le modèle l’exécuter, ce qu’on appelle la formulation de requête sans exemple (angl. zero-shot prompting), ou lui montrer d’abord quelques exemples de ce que vous voulez, ce qu’on appelle la formulation de requête avec quelques exemples (angl. few-shot prompting). Avec un seul exemple, on parle parfois en anglais de one-shot prompting.
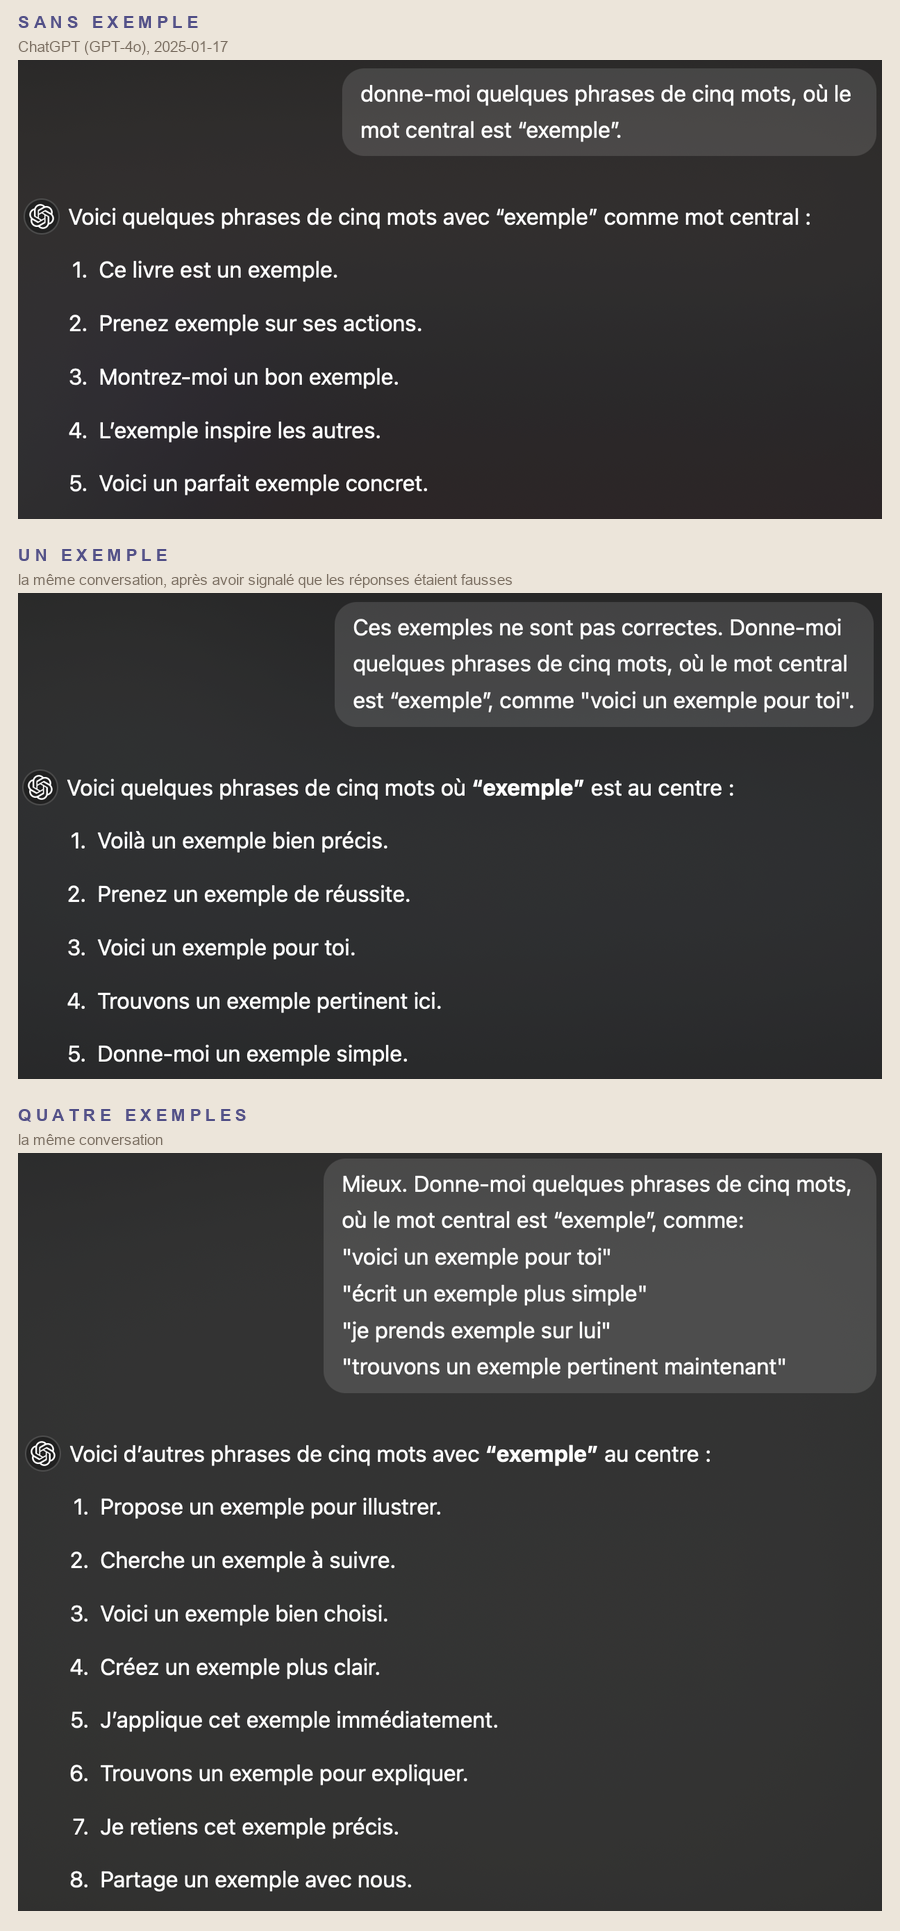
Dans la Figure 3figure 3, on demande d’abord à ChatGPT quelques phrases de cinq mots dont le mot central est exemple. Aucune de ses cinq réponses ne convient. Dans la même conversation, après s’être fait dire que les réponses étaient fausses et avoir reçu un exemple, il en donne cinq dont quatre conviennent, même si l’une se contente de répéter l’exemple. Après quatre exemples, sept de ses huit réponses conviennent. Comme tout s’est passé dans une seule conversation, une partie de l’amélioration peut venir de la correction plutôt que des seuls exemples (see also the Giving examples page, in the Using LLMs module) (voir aussi la page Donner des exemples, dans le module Utiliser les GML).
Ce que les exemples montrent au modèle
Les exemples montrent au modèle davantage que la réponse à chaque cas : à quoi ressemble une entrée, quelles réponses sont possibles et quelle forme prend une réponse. Avec des modèles plus anciens et plus petits, ces éléments pouvaient compter davantage que l’exactitude des réponses données en exemple (Min et coll., 2022), mais les modèles plus grands suivent de plus près les réponses des exemples, si bien que des exemples erronés risquent davantage de les induire en erreur (Wei et al., 2023b ; Shi et al., 2024).
Sources
- Brown, T. B., Mann, B., Ryder, N., Subbiah, M., Kaplan, J., Dhariwal, P., et al. (2020). Language Models are Few-Shot Learners. Advances in Neural Information Processing Systems 33 (NeurIPS 2020). https://proceedings.neurips.cc/paper/2020/hash/1457c0d6bfcb4967418bfb8ac142f64a-Abstract.html
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/
- Min, S., Lyu, X., Holtzman, A., Artetxe, M., Lewis, M., Hajishirzi, H., & Zettlemoyer, L. (2022). Rethinking the Role of Demonstrations: What Makes In-Context Learning Work?. Proceedings of the 2022 Conference on Empirical Methods in Natural Language Processing, 11048–11064. https://aclanthology.org/2022.emnlp-main.759/
- Shi, Z., Wei, J., Xu, Z., & Liang, Y. (2024). Why Larger Language Models Do In-context Learning Differently?. Proceedings of the 41st International Conference on Machine Learning (ICML 2024), PMLR 235, 44991–45013. https://proceedings.mlr.press/v235/shi24f.html
- Wei, J., Wei, J., Tay, Y., Tran, D., Webson, A., Lu, Y., et al. (2023b). Larger language models do in-context learning differently. Preprint, arXiv:2303.03846 (submitted to ICLR 2024). https://openreview.net/forum?id=DRGnEkbiQZ