Temperature, top-p and top-kTempérature, top-p et top-k
TRA6008 OptionalFacultatif
Changing the chance of being picked
An LLM large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. computes a probability for every possible next token, and a separate step then picks one of them, usually with an element of chance (see also the LLMs are non-deterministic page) (voir aussi la page Les GML ne sont pas déterministes). Developers can influence that step with a few settings. The best known is temperature, which usually appears in a developer interface as a slider from 0 to 1 or 2. Temperature does not change the probabilities the model computed; it changes the chance each token has of being picked from them. A low temperature makes the most likely tokens even more likely to be picked, and a high temperature evens out the differences between tokens (Figure 9figure 9).
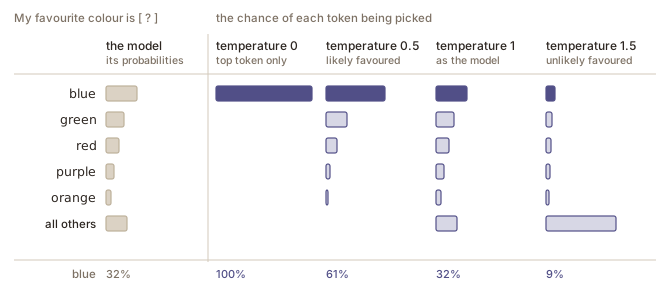
At a low temperature, the text is predictable and can become repetitive. At a high temperature, the less likely tokens are picked more often, including the thousands of tokens that were very unlikely to begin with, so the text can become incoherent.
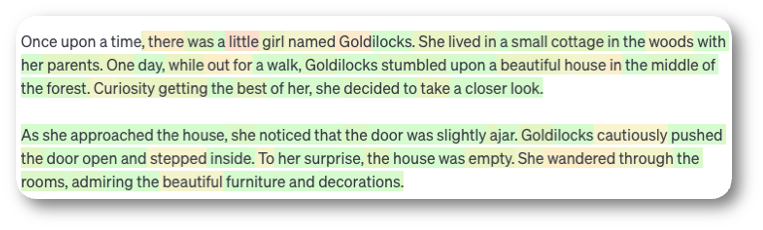
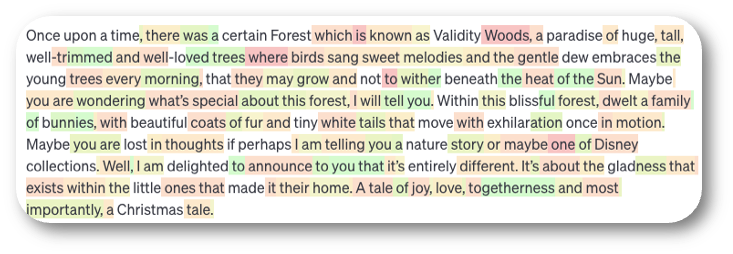
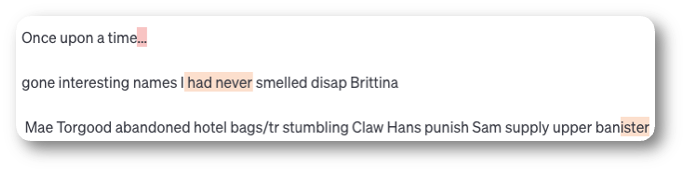
The screenshots below were taken in 2024 in OpenAI’s Playground, with gpt-3.5-turbo-instruct, an older model that OpenAI retires on 28 September 2026. The shading shows how probable each token was, from green (likely) to red (unlikely), and each shaded block is a token rather than a word.
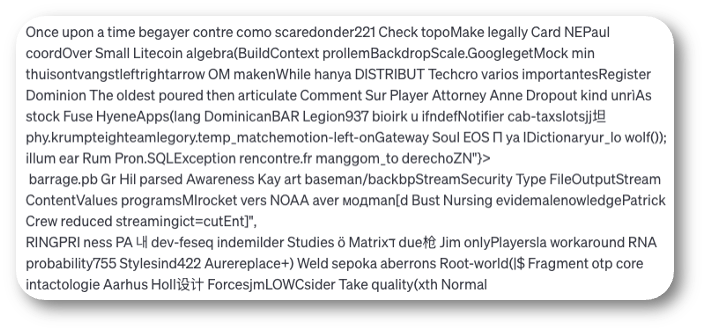
The same beginning, “Once upon a time”, continued at four temperatures shows the effect (Figure 10figure 10 to Figure 13figure 13). At temperature 0, the text follows a well-known fairy tale closely: a girl named Goldilocks finds an empty house in the woods. At temperature 1, it still has what a fairy tale is expected to have, a forest, a family of animals and “a tale of joy, love, togetherness”, but it no longer matches any existing story, and some of its wording is unexpected: this is what people tend to describe as more creative or original output. At 1.5 the text falls apart after a few words, and at 2 it is a string of unrelated fragments.
Limiting the candidates
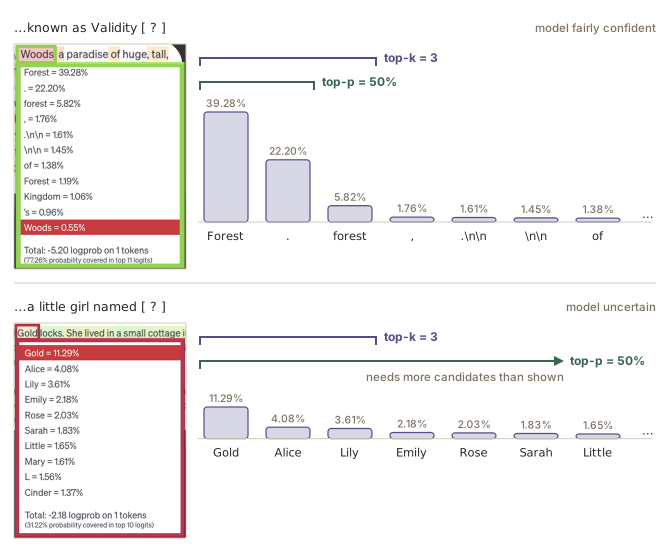
Two other settings leave the probabilities as they are and limit which tokens can be picked.
The difference is that top-p adapts to the situation. When the model is confident, a few tokens are enough to reach the threshold; when it is not, many tokens are needed. Top-k always keeps the same number of candidates (Figure 14figure 14).
| Setting | What it changes |
|---|---|
| Temperature | the chance of each token being picked |
| Top-p | how many candidates, by their combined probability |
| Top-k | how many candidates, by a fixed number |
Settings that are being withdrawn
These settings are mainly available to developers who reach a model through an API application programming interface (API)interface de programmation d'application (API) computinginformatique A standardized interface that allows software applications to communicate by sending requests and receiving responses, without needing to know how the other application works internally.Interface normalisée qui permet à des applications logicielles de communiquer en envoyant des demandes et en recevant des réponses, sans avoir à connaître le fonctionnement interne de l'autre application. ; chat interfaces generally do not show them. If you only use chatbots, you may never see them, but you can assume that the model behind a chatbot answers with a temperature above 0, so its answers are not deterministic deterministicdéterministe computinginformatique Describes a process, algorithm, or system that, under the same initial conditions and with the same input, always produces the same output.Se dit d'un processus, d'un algorithme ou d'un système qui, dans les mêmes conditions initiales et avec la même entrée, produit toujours la même sortie. (see also the LLMs are non-deterministic page) (voir aussi la page Les GML ne sont pas déterministes).
On their newest models, Anthropic and OpenAI no longer let developers change these settings through their APIs either. Google still allows it, but recommends keeping the temperature of its newest models at the default of 1.0: they are tuned for that setting, and a lower temperature can make them repeat themselves in loops or perform worse.Anthropic: temperature, top-p and top-k set to non-default values are rejected on Claude Sonnet 5 (Migrating to Claude Sonnet 5). Microsoft: GPT-6 Astra does not support custom temperature or top-p values (Azure OpenAI reasoning models). Google: keep Gemini 3 at its default temperature of 1.0 (Gemini 3 developer guide). All read 14 September 2026.
Modifier les chances d’être choisi
Un grand modèle de langue large language model (LLM)grand modèle de langue (GML) language modelsmodèles de langue A neural-network language model, usually based on the transformer architecture, that is trained on very large amounts of text and contains many learned parameters.Modèle de langue à réseau de neurones, habituellement fondé sur l'architecture des transformeurs, entraîné sur de très grandes quantités de texte et comptant de très nombreux paramètres appris. (GML) calcule une probabilité pour chaque jeton suivant possible, puis une étape distincte en choisit un, généralement avec une part de hasard (see also the LLMs are non-deterministic page) (voir aussi la page Les GML ne sont pas déterministes). Les développeurs peuvent agir sur cette étape au moyen de quelques réglages. Le plus connu est la température, qui se présente habituellement, dans une interface pour développeurs, sous la forme d’un curseur allant de 0 à 1 ou à 2. La température ne modifie pas les probabilités calculées par le modèle ; elle modifie les chances qu’a chaque jeton d’être choisi parmi elles. Une température basse rend les jetons les plus probables encore plus susceptibles d’être choisis, et une température élevée atténue les écarts entre les jetons (Figure 9figure 9).
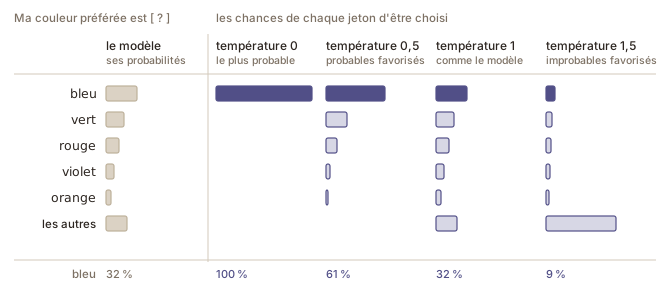
À une température basse, le texte est prévisible et peut devenir répétitif. À une température élevée, les jetons moins probables sont choisis plus souvent, y compris les milliers de jetons qui étaient très peu probables au départ, si bien que le texte peut devenir incohérent.
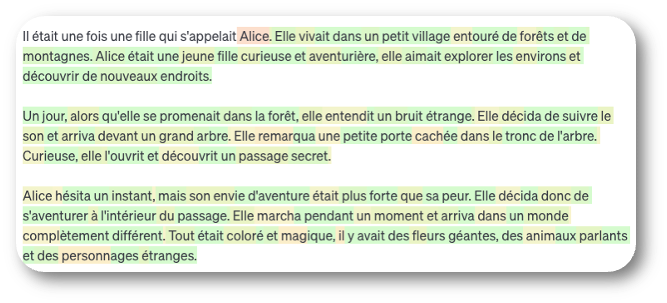
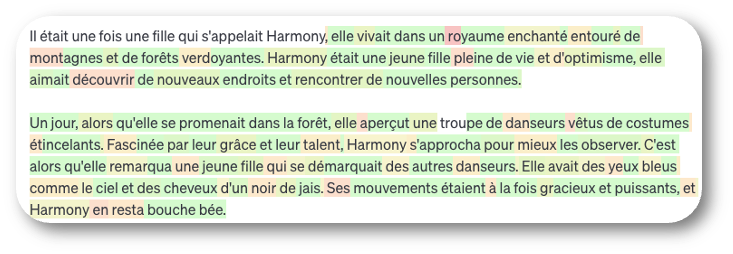
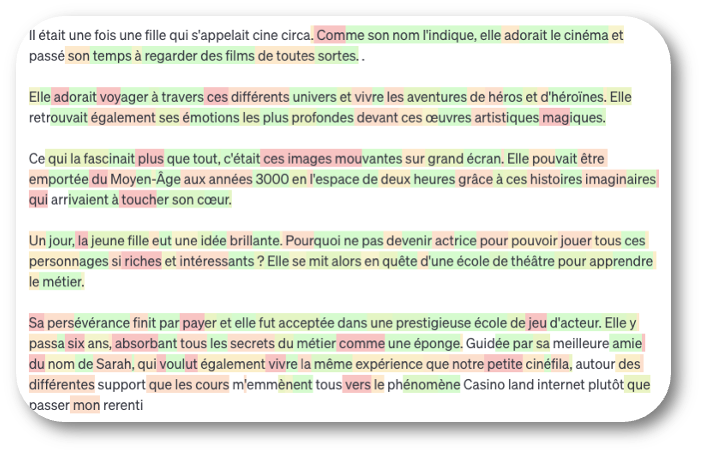
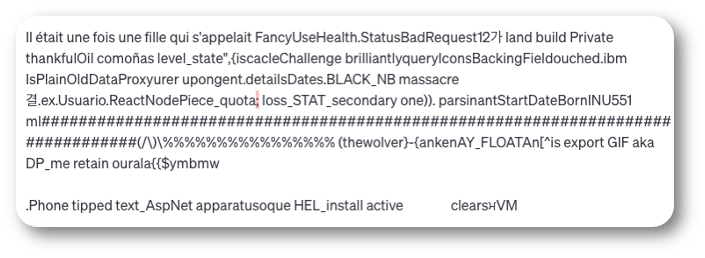
Les captures d’écran ci-dessous ont été prises en 2024 dans le Playground d’OpenAI, avec gpt-3.5-turbo-instruct, un ancien modèle qu’OpenAI retire le 28 septembre 2026. La couleur indique la probabilité de chaque jeton, du vert (probable) au rouge (peu probable), et chaque bloc coloré est un jeton plutôt qu’un mot.
Le même début, « Il était une fois une fille qui s’appelait », poursuivi à quatre températures, montre l’effet (Figure 15figure 15 à Figure 18figure 18). À une température de 0, le texte rappelle de près une histoire connue : une fille nommée Alice découvre une porte cachée dans le tronc d’un arbre, puis un monde magique. À 1, il garde ce qu’on attend d’un conte, un royaume enchanté, des forêts et une jeune fille qui part à la découverte, mais il ne correspond plus à aucune histoire existante, et certaines formulations sont inattendues : c’est ce qu’on a tendance à qualifier de production plus créative ou plus originale. À 1,5, le texte reste lisible un moment, puis se dégrade vers la fin, et à 2, il n’est plus qu’une suite de fragments sans lien.
Limiter les candidats
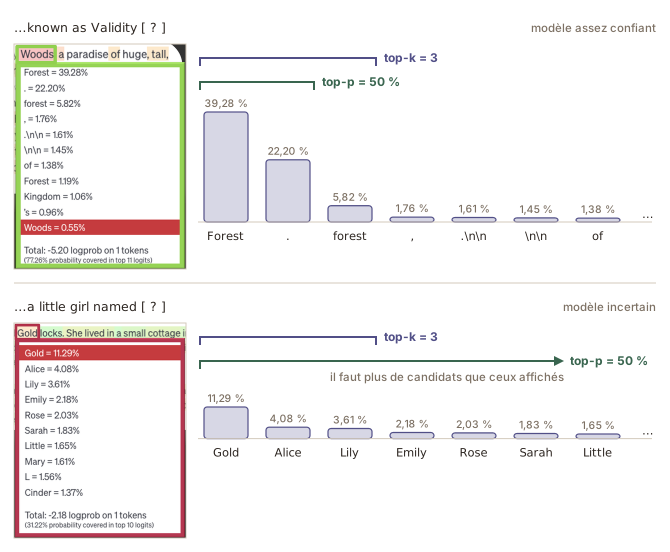
Deux autres réglages laissent les probabilités telles quelles et limitent les jetons qui peuvent être choisis.
La différence tient à ce que le top-p s’adapte à la situation. Quand le modèle est confiant, quelques jetons suffisent pour atteindre le seuil ; quand il ne l’est pas, il en faut beaucoup. Le top-k garde toujours le même nombre de candidats (Figure 14figure 14).
| Réglage | Ce qu’il modifie |
|---|---|
| Température | les chances qu’a chaque jeton d’être choisi |
| Top-p | le nombre de candidats, selon leur probabilité cumulée |
| Top-k | le nombre de candidats, selon un nombre fixe |
Des réglages en voie de disparition
Ces réglages sont surtout accessibles aux développeurs qui utilisent un modèle au moyen d’une interface de programmation d’application (API application programming interface (API)interface de programmation d'application (API) computinginformatique A standardized interface that allows software applications to communicate by sending requests and receiving responses, without needing to know how the other application works internally.Interface normalisée qui permet à des applications logicielles de communiquer en envoyant des demandes et en recevant des réponses, sans avoir à connaître le fonctionnement interne de l'autre application. ) ; les interfaces conversationnelles ne les affichent généralement pas. Si vous n’utilisez que des agents conversationnels, vous ne les verrez peut-être jamais, mais vous pouvez partir du principe que le modèle derrière un agent conversationnel répond avec une température supérieure à 0, et que ses réponses ne sont donc pas déterministes deterministicdéterministe computinginformatique Describes a process, algorithm, or system that, under the same initial conditions and with the same input, always produces the same output.Se dit d'un processus, d'un algorithme ou d'un système qui, dans les mêmes conditions initiales et avec la même entrée, produit toujours la même sortie. (see also the LLMs are non-deterministic page) (voir aussi la page Les GML ne sont pas déterministes).
Pour leurs modèles les plus récents, Anthropic et OpenAI ne permettent plus non plus aux développeurs de modifier ces réglages au moyen de leurs API. Google le permet encore, mais recommande de garder la température de ses modèles les plus récents à sa valeur par défaut de 1,0 : ces modèles sont conçus pour ce réglage, et une température plus basse peut les faire tourner en boucle ou dégrader leurs résultats.Anthropic : la température, le top-p et le top-k réglés à une valeur autre que celle par défaut sont refusés pour Claude Sonnet 5 (Migrating to Claude Sonnet 5). Microsoft : GPT-6 Astra n’accepte pas de valeurs personnalisées pour la température ou le top-p (Azure OpenAI reasoning models). Google : garder Gemini 3 à sa température par défaut de 1,0 (Gemini 3 developer guide). Pages consultées le 14 septembre 2026.
Sources
- Holtzman, A., Buys, J., Du, L., Forbes, M., & Choi, Y. (2020). The Curious Case of Neural Text Degeneration. International Conference on Learning Representations (ICLR 2020). https://openreview.net/forum?id=rygGQyrFvH
- Jurafsky, D., & Martin, J. H. (2026). Speech and Language Processing: An Introduction to Natural Language Processing, Computational Linguistics, and Speech Recognition with Language Models. Online draft, 3rd edition. https://web.stanford.edu/~jurafsky/slp3/